JavaScript框架库漏洞怎么做数量统计
详细讲解JavaScript框架与第三方库漏洞数量统计的完整方法,涵盖统计口径设定、单项目npm audit解析、多项目SCA批量扫描、上游开源情报库统计及避坑指南。
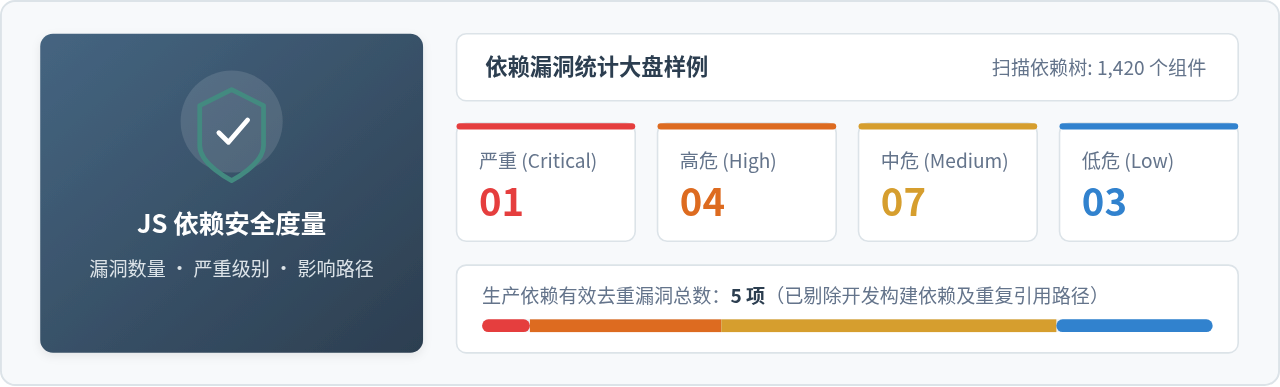
做 JavaScript 框架与组件库的漏洞数量统计,核心是确定统计口径、提取锁定文件中的真实依赖树、区分严重等级并完成跨路径去重。通常单项目可通过包管理器原生 audit 配合 JSON 管道完成,多项目或团队级场景则依托独立 SCA 扫描器与漏洞情报 API 实现结构化聚合。
一、明确统计口径与核算维度
在执行任何统计命令之前,必须先理清“漏洞数量”到底指代什么。在 npm、Yarn、pnpm 生态中,直接执行统计经常会产生几倍甚至几十倍的数值偏差,原因往往在于混淆了统计口径。
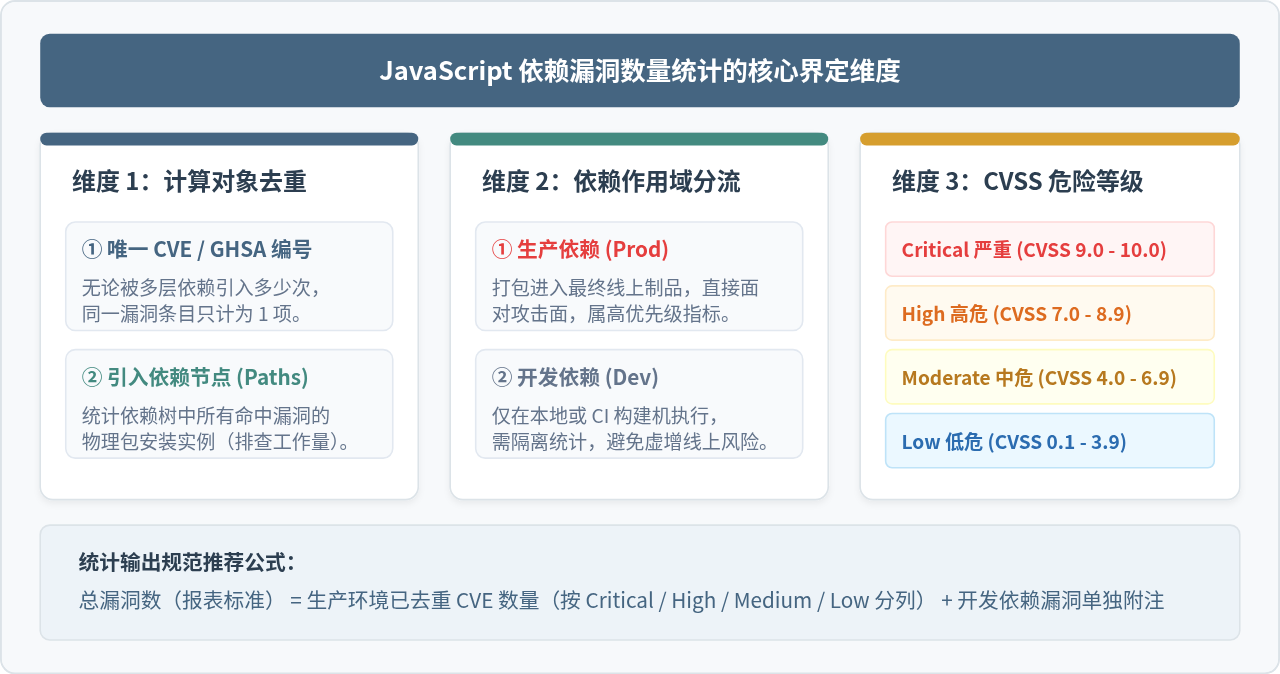
通常需要从以下三个核心维度确立统计标准:
- 唯一漏洞数(Unique CVE / GHSA)与依赖引入节点数(Instances):一个存在原型链污染漏洞的底层库(例如旧版
lodash或minimist),可能同时被项目中的 12 个中间件以深层依赖的形式引入。如果统计的是安全缺陷本身,其数量为 1;如果统计的是受污染的依赖包安装实例,数量则是 12。在汇报与审计时,需明确标注这是“CVE 缺陷总数”还是“漏洞影响节点数”。 - 生产依赖(Production)与开发依赖(Development):打包编译使用的构建工具(如
webpack-dev-server、babel插件、测试套件jest)中的高危漏洞,通常不会被打包进最终运行的客户端 bundle 中。统计数量时必须将生产运行态依赖(dependencies)与本地开发依赖(devDependencies)分流统计。 - CVSS 严重性等级划分:漏洞数量绝不能只看绝对总数,必须拆解为 Critical(严重)、High(高危)、Moderate/Medium(中危)和 Low(低危)。通常企业阻断发布策略只针对 Critical 与 High,而合规统计则要求全量记录。
二、单项目统计:利用包管理器原生 Audit 提取与解析
对于绝大多数 Node.js 或前端工程,首选的统计方式是直接调用项目现存包管理器的审计工具。这些工具直接比对 package-lock.json 或对应锁文件,能得到最精确的实际版本依赖树。
1. npm audit 的结构化输出
在项目根目录(存在 package.json 与 package-lock.json)中执行默认的 npm audit 会在终端打印格式化文本。用于自动化统计时,必须添加 --json 标志,并根据需求排除开发依赖:
# 统计所有依赖(包含开发依赖)
npm audit --json > audit-all.json

# 仅统计生产环境上线依赖(推荐作为核心安全指标)
npm audit --omit=dev --json > audit-prod.json
在生成的 JSON 文件底部,存在一个 metadata.vulnerabilities 节点,npm 会自动按等级完成统计汇总。其结构如下(以实际提取到的数据片段为例):
{
  "auditReportVersion": 2,
  "vulnerabilities": {
    "axios": {
      "name": "axios",
      "severity": "high",
      "isDirect": true,
      "via": [
        {
          "source": 1094593,
          "name": "axios",
          "dependency": "axios",
          "title": "Axios Cross-Site Request Forgery Vulnerability",
          "url": "https://github.com/advisories/GHSA-8hc4-vh64-cxmj",
          "severity": "high",
          "range": "<0.28.0"
        }
      ],
      "effects": [],
      "range": "<0.28.0",
      "nodes": ["node_modules/axios"],
      "fixAvailable": true
    }
  },
  "metadata": {
    "vulnerabilities": {
      "info": 0,
      "low": 1,
      "moderate": 3,
      "high": 2,
      "critical": 0,
      "total": 6
    },
    "dependencies": {
      "prod": 328,
      "dev": 894,
      "optional": 10,
      "peer": 0,
      "peerOptional": 0,
      "total": 1232
    }
  }
}
2. 使用命令行或脚本提取统计指标
若在 Linux/macOS 环境下,配合轻量命令行工具 jq 即可在一行内提取精确数字:
# 一行命令提取生产依赖各等级漏洞总数
npm audit --omit=dev --json | jq '.metadata.vulnerabilities'
输出示例:
{
  "info": 0,
  "low": 1,
  "moderate": 3,
  "high": 2,
  "critical": 0,
  "total": 6
}
如果需要深入统计到底是哪些库存在漏洞、是否有可用补丁,可以编写一个独立的 Node.js 统计解析脚本 count-vulns.js:
// count-vulns.js
const fs = require('fs');

function parseAudit(filePath) {
  const content = fs.readFileSync(filePath, 'utf-8');
  const data = JSON.parse(content);

  const meta = data.metadata ? data.metadata.vulnerabilities : {};
  console.log('=== 漏洞统计汇总概览 ===');
  console.log(`严重 (Critical): ${meta.critical || 0}`);
  console.log(`高危 (High):     ${meta.high || 0}`);
  console.log(`中危 (Moderate): ${meta.moderate || 0}`);
  console.log(`低危 (Low):      ${meta.low || 0}`);
  console.log(`总漏洞计数值:    ${meta.total || 0}`);
  console.log('------------------------');

  // 提取具体受影响的库及唯一安全公告数
  const vulns = data.vulnerabilities || {};
  const packageList = Object.keys(vulns);
  console.log(`受影响的独立组件库总数: ${packageList.length} 个`);

  packageList.forEach(pkgName => {
    const item = vulns[pkgName];
    const fixText = item.fixAvailable ? '有可用补丁' : '需手动排查升级';
    console.log(`- [${item.severity.toUpperCase()}] ${pkgName} (${item.range}) => ${fixText}`);
  });
}

parseAudit('./audit-prod.json');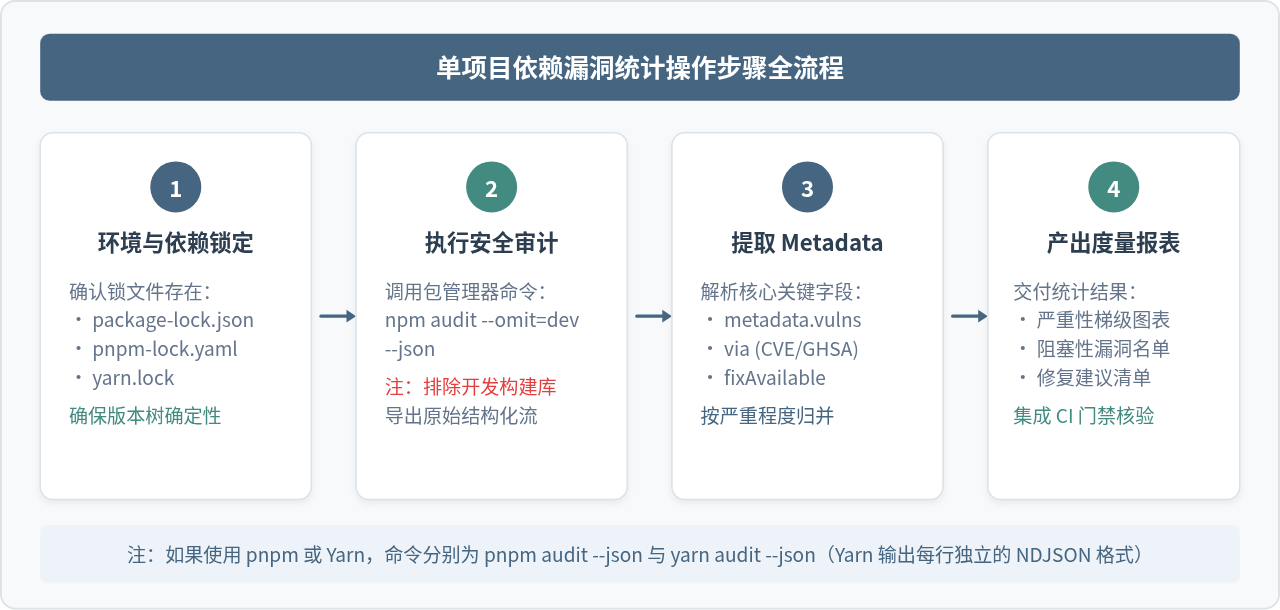
3. pnpm 与 Yarn 的统计差异
| 包管理器 | 标准执行命令 | 输出格式与统计要点 |
|---|---|---|
| npm (v7+) | npm audit --omit=dev --json |
单个完整 JSON 对象,根节点 metadata.vulnerabilities 直接提供等级与总数。 |
| pnpm | pnpm audit --prod --json |
标准 JSON,顶层通过 metadata.vulnerabilities 汇总,依赖硬链接结构解析极其迅速。 |
| Yarn (v1 Classic) | yarn audit --groups dependencies --json |
NDJSON(换行分隔的 JSON)。每行一个独立的事件对象,统计时需读取包含 "type":"auditSummary" 的最后一行获取 data.vulnerabilities。 |
三、企业级与多项目统计:利用独立 SCA 扫描器批量聚合
当需要对几十个微前端模块、多个独立 Node.js 后端仓库进行批量漏洞统计时,逐个进入容器运行包管理器命令维护成本较高。此时行业标准做法是引入独立的软件成分分析(SCA)工具。
1. 使用 OSV-Scanner 进行多仓库批量统计
Google 推出的 osv-scanner 是基于开源漏洞数据库(Open Source Vulnerabilities)的轻量 SCA 工具,可以直接读取锁文件而不依赖本地 Node.js 运行时。
# 递归扫描当前目录下所有 JavaScript 工程的 lockfile 并输出 JSON
osv-scanner scan -r --format=json ./all-projects > osv-results.json
osv-scanner 输出的数据天然以 唯一 CVE / GHSA 为维度,每个受影响的 package 会列出其匹配的所有 Advisory ID。通过以下 Node.js 聚合脚本即可跨项目汇总出漏洞清单:
// aggregate-osv.js
const fs = require('fs');

const raw = JSON.parse(fs.readFileSync('./osv-results.json', 'utf-8'));
const results = raw.results || [];

let totalVulnInstances = 0;
const uniqueAdvisories = new Set();
const severityCounts = { CRITICAL: 0, HIGH: 0, MEDIUM: 0, LOW: 0, UNKNOWN: 0 };

results.forEach(res => {
  (res.packages || []).forEach(pkg => {
    (pkg.vulnerabilities || []).forEach(vuln => {
      totalVulnInstances++;
      uniqueAdvisories.add(vuln.id);

      // 提取严重程度
      let sev = 'UNKNOWN';
      if (vuln.database_specific && vuln.database_specific.severity) {
        sev = vuln.database_specific.severity.toUpperCase();
      }
      if (severityCounts[sev] !== undefined) {
        severityCounts[sev]++;
      } else {
        severityCounts.UNKNOWN++;
      }
    });
  });
});

console.log('=== 多项目跨仓库聚合统计结果 ===');
console.log(`扫描包含的项目数量:     ${results.length} 个`);
console.log(`命中漏洞的依赖实例总数: ${totalVulnInstances} 处`);
console.log(`去重后的独立漏洞 (CVE): ${uniqueAdvisories.size} 项`);
console.log('等级分布:', severityCounts);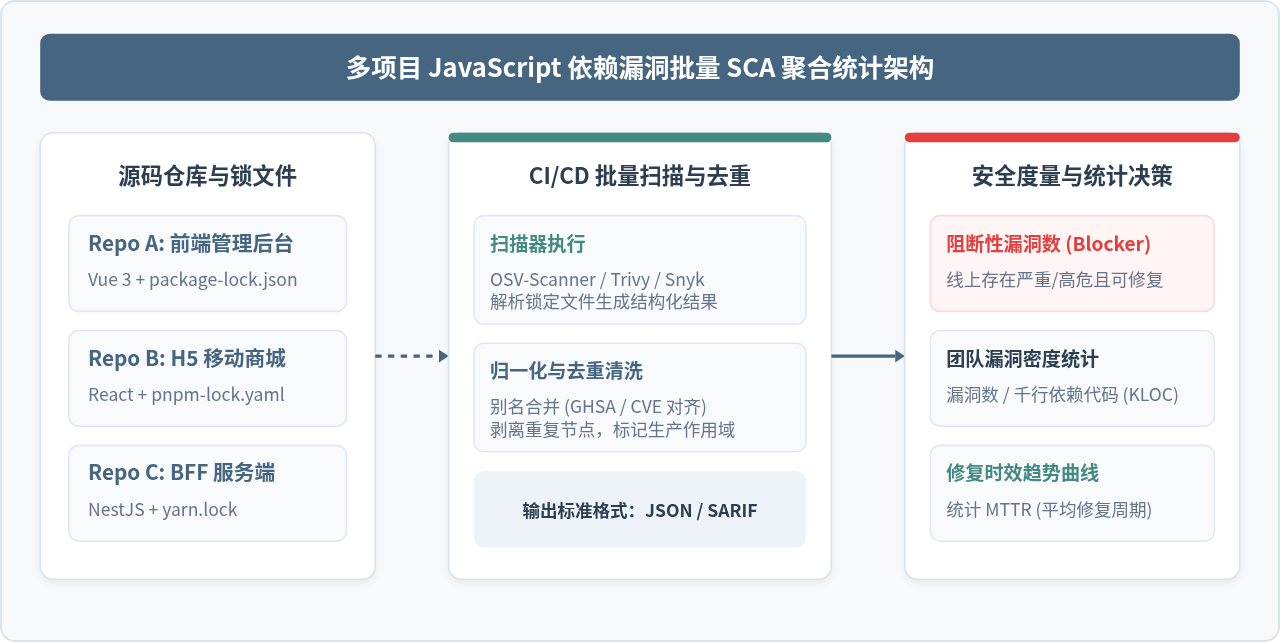
四、特定框架库本身的历史漏洞数量统计
如果需求不是统计“我的业务代码引用了多少漏洞”,而是做技术选型调研,比如:“Express、Koa、Fastify 历史上分别报出过多少个漏洞?”或“某前端框架近年来高危漏洞的发现频次如何?”,则应当直接查询上游公共漏洞情报库。
利用 OSV API 统计特定库的历史漏洞
Google OSV 提供免费、无认证限制的 REST API,可直接按生态(Ecosystem)和包名查询该库收录的所有安全公告。编写以下 Node.js 脚本即可统计任意 npm 库的漏洞总量与详细分布:
// query-package-vulns.js
// 运行环境: Node.js 18+ (原生支持 fetch)

async function queryPackageVulnerabilities(packageName) {
  const url = 'https://api.osv.dev/v1/query';
  const payload = {
    package: {
      name: packageName,
      ecosystem: 'npm'
    }
  };

  const response = await fetch(url, {
    method: 'POST',
    headers: { 'Content-Type': 'application/json' },
    body: JSON.stringify(payload)
  });

  const data = await response.json();
  const vulns = data.vulns || [];

  console.log(`\n=== 库 [${packageName}] 官方收录漏洞统计 ===`);
  console.log(`历史收录安全漏洞总数: ${vulns.length} 个`);

  // 按年份与严重等级统计
  const yearStats = {};
  vulns.forEach(v => {
    const pubYear = (v.published || '未知').slice(0, 4);
    yearStats[pubYear] = (yearStats[pubYear] || 0) + 1;
  });

  console.log('按年份发现数量分布:');
  Object.keys(yearStats).sort().forEach(year => {
    console.log(`  ${year}年: ${yearStats[year]} 个`);
  });
}

// 统计 Express 框架的历史漏洞数
queryPackageVulnerabilities('express');https://github.com/advisories)中筛选 Ecosystem 为 npm,输入库名查看统计数字。GitHub 与 OSV 数据实时互通,二者的统计口径均基于 GHSA 与 CVE 映射。
五、漏洞统计过程中的常见偏差与核验要点
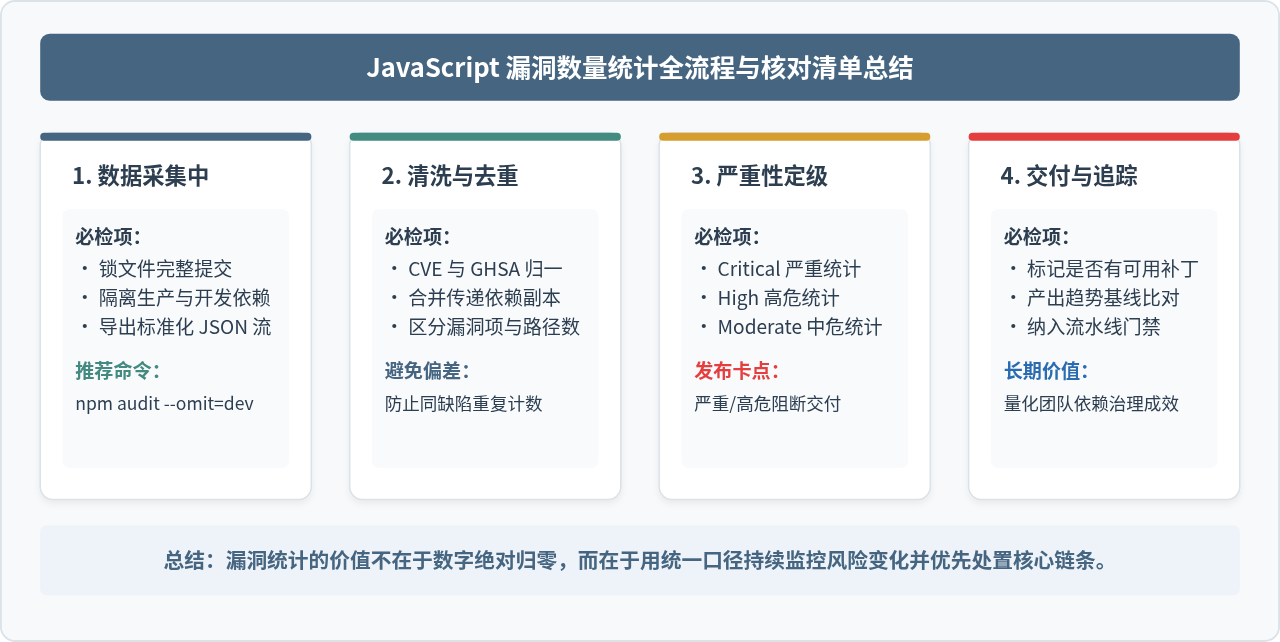
在实际统计实践中,经常会出现不同工具统计出来的数字差异巨大、开发团队对漏洞数量产生质疑的情况。产生偏差的核心原因有以下四点:
- 传递依赖深层嵌套导致的“虚高统计”:
例如项目中有 5 个不同的直接依赖项都依赖了
semver@5.7.0(存在 ReDoS 漏洞),未去重的工具会报出 5 个漏洞,而去重后的工具只计 1 个 CVE。核验做法:对外输出报表时必须同时呈现两个数字:“已识别漏洞项(CVE 条目数)”和“受影响依赖链路径(待修复节点数)”。 - CVE 编号与 GHSA 编号双重计数:
许多开源组件漏洞同时具备一个
CVE-XXXX-XXXXX编号和一个GHSA-xxxx-xxxx-xxxx编号。如果自己编写聚合正则时没有基于aliases字段做别名映射,很容易将同一个漏洞按两条分别计数。 - 开发构建依赖(DevDependencies)干扰生产评估:
很多新手直接执行
npm audit,看到 30 个高危漏洞惊慌失措,排查后发现 28 个来自开发阶段的打包加载器或代码检查工具。这类漏洞并不随着 Webpack / Vite 产物打入前端静态资源。统计生产安全水位时,务必加上--omit=dev过滤。 - 忽视“可修复性(Fix Available)”的区分: 统计数字中应明确标出“官方已出补丁可直接升级解决”与“官方尚未修复或已停止维护”的比例。如果一个框架库存在 3 个低危中危漏洞但无官方修复版本,盲目要求“漏洞清零”将导致业务阻断。
怎么用JS三元表达式简化if-else判断
2026-11-05 18:55:13
前端页面怎么实现JSON数据的高亮格式化展示
2026-11-05 18:12:52
js文件中async和defer属性的区别及加载顺序
2026-11-05 18:11:39
怎么使用 JavaScript import() 实现模块的条件加载
2026-11-05 14:44:45
前端防御XSS攻击:怎么防止恶意JS注入与CSP策略配置
2026-11-04 08:51:38