为什么选择Node.js:事件驱动与非阻塞I/O模型优势
深入解析Node.js核心架构优势:通过单线程事件循环与非阻塞I/O模型,阐述其如何破解高并发C10K难题、降低服务器内存与线程切换损耗,并提供完整的运作时序与选型指南。
构建高吞吐量网络服务时,系统最大的性能瓶颈往往不是 CPU 的运算速度,而是网络通信、数据库交互与磁盘读写中的 I/O 阻塞等待。Node.js 的核心价值在于:通过单线程事件驱动(Event-Driven)与底层非阻塞 I/O(Non-blocking I/O)相结合的架构,用极低的系统资源开销化解了经典的高并发 C10K 问题。本文将拆解 Node.js 的内部运行原理、底层支撑机制与时序流转,帮助开发者建立清晰的技术判断依据。
一、解决的核心问题:I/O 阻塞与高并发资源开销
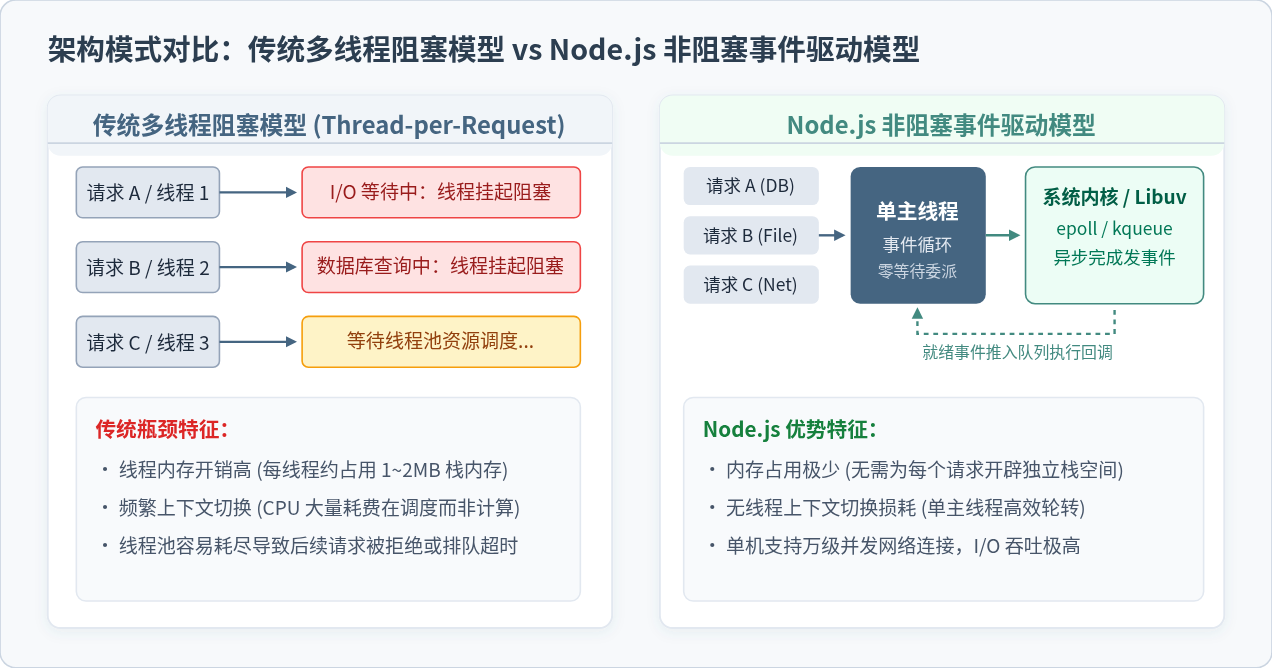
在传统的服务端运行环境(例如基于阻塞模型的多线程 Web 服务器)中,处理网络请求的基本单位通常是“每个连接分配一个独立线程”(Thread-per-Request)。当客户端发送一个请求查询数据库时,分配给该连接的线程会发起系统调用并挂起,等待数据库完成磁盘寻道、数据查询并回传网络包。在数据返回前,这枚线程完全处于空转阻塞状态。
这种模式在高并发场景下暴露出两个难以忽视的物理瓶颈:
- 内存资源迅速耗尽:操作系统中每个线程都需要分配专用的调用栈空间(通常为 1MB 至 2MB)。若维持 10,000 个并发阻塞连接,仅仅线程栈本身就会直接吞噬 10GB 到 20GB 的内存。
- CPU 上下文切换损耗剧烈:当几千个线程在就绪与阻塞状态之间频繁切换时,操作系统的调度器需要不断保存和恢复 CPU 寄存器状态、刷新指令流水线与 CPU 缓存,导致宝贵的 CPU 算力被空耗在调度管理上,而非真正执行业务逻辑。
Node.js 的设计思路从根本上改变了处理方式:主线程只负责快速调度与执行 JavaScript 代码,绝不在原地等待任何底层 I/O 结果。所有耗时的输入输出任务直接交由底层异步机制处理,主线程得以毫无阻碍地连续接纳源源不断的新连接。
二、核心机制解析:单线程如何撑起高并发
许多初学者对 Node.js 最大的困惑是:“JavaScript 既然运行在单线程上,为什么不会因为一次读取大文件或查询慢 SQL 把整个服务器卡死?”
理解这个问题的关键,在于认清 Node.js 运行时并非只有一个操作系统的线程:
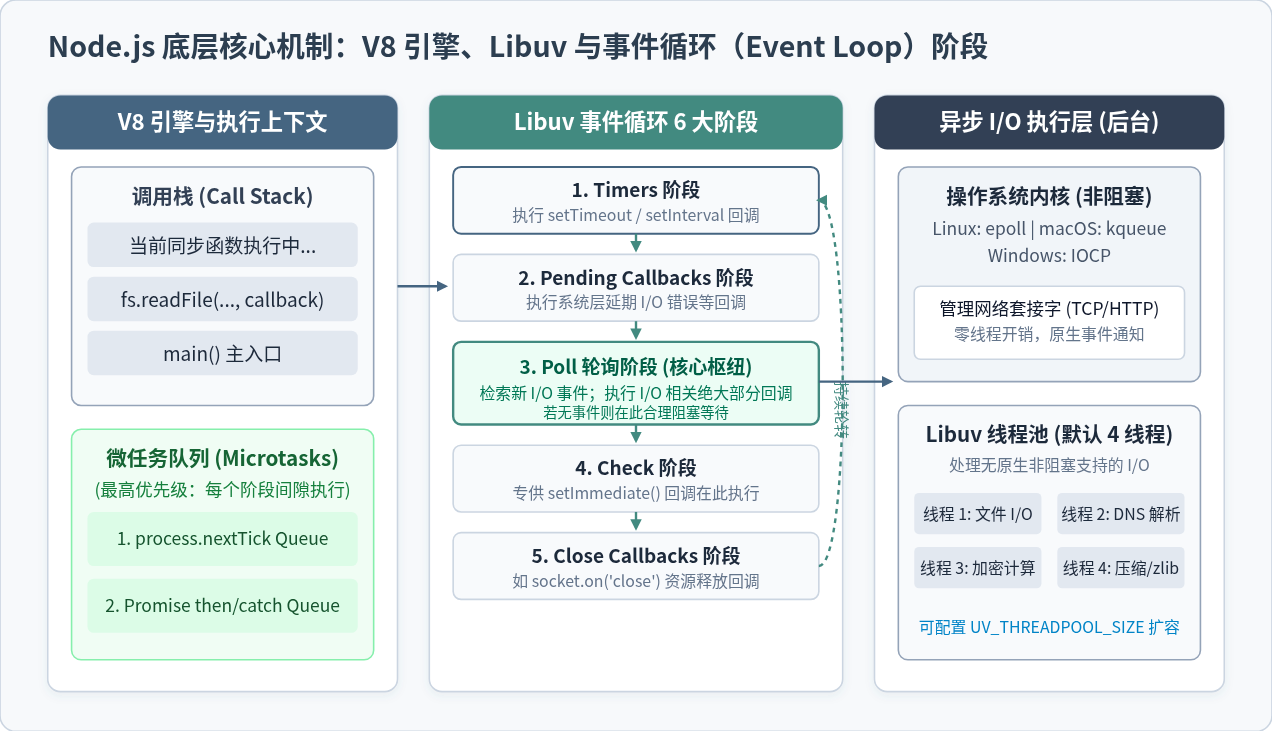
- 执行 JavaScript 代码的单主线程:由 Google V8 引擎托管,维护一个纯净的执行调用栈(Call Stack)。所有的函数调用、算术逻辑、闭包与对象分配都在这一个主线程里按次序执行。
- 底层多线程与系统内核抽象层(Libuv):Node.js 的核心支撑是 C 语言编写的高性能跨平台异步 I/O 库
Libuv。对于网络套接字(Socket),Libuv 会直接利用现代操作系统提供的多路复用系统调用(Linux 的epoll、macOS 的kqueue、Windows 的IOCP),在零额外线程开销下监听成千上万个连接的事件;对于操作系统层面缺乏原生非阻塞机制的文件系统与 DNS 解析,Libuv 在后台维护了一个独立的工作线程池(Worker Pool,默认 4 个线程)负责分担阻塞操作。
事件循环(Event Loop)的六大核心阶段
事件循环本质上是一个持续运行的 while(true) 状态机,负责在调用栈清空时,按严格定义的次序从任务队列中抓取回调函数压入栈中执行。完整的单次迭代(Tick)包含以下核心阶段:
- Timers 阶段:检查并执行已到达设定时限的
setTimeout()和setInterval()回调。 - Pending Callbacks 阶段:执行一些操作系统级别的延期 I/O 回调,例如 TCP 连接遇到
ECONNREFUSED错误。 - Idle, Prepare 阶段:仅供 Libuv 内部协调使用。
- Poll(轮询)阶段:事件循环的核心枢纽。计算本次应当阻塞等待的时间,检索新的 I/O 事件,并执行绝大多数与网络、文件读写相关的回调。
- Check 阶段:专用于执行
setImmediate()注册的回调函数。 - Close Callbacks 阶段:处理诸如
socket.on('close', ...)等连接释放的清理工作。
process.nextTick() 队列与 Promise 回调队列。微任务不属于事件循环的常规阶段,而是在每一个阶段结束切换、主调用栈刚刚清空的瞬间立即全部清空,其优先级最高。
三、代码对比:阻塞与非阻塞的具体执行差异
为了直观感受非阻塞 I/O 的特性,我们对比两种文件读取的代码实现:
1. 同步阻塞读取(严重影响并发性能)
const fs = require('fs');

console.log('1. 准备开始读取配置...');
// readFileSync 是同步系统调用,当前线程直接挂起,等待磁盘寻道与数据拷入内存
const data = fs.readFileSync('/path/to/large-data.json', 'utf8');
console.log('2. 读取完成,解析配置数据');
console.log('3. 准备处理客户端请求');执行时序与影响:在第 2 步未完成之前,整个 Node.js 进程处于停滞状态。若有其他用户在此期间向服务器发送 HTTP 请求,该请求无法得到任何握手响应,导致客户端请求排队或超时。
2. 异步非阻塞读取(高并发推荐写法)
const fs = require('fs').promises;

console.log('1. 准备发起异步文件读取...');
// readFile 将读取任务下沉委托至 Libuv 线程池,主线程立即继续向下执行
fs.readFile('/path/to/large-data.json', 'utf8')
  .then(content => {
    console.log('3. 异步回调触发:数据读取完毕,长度为', content.length);
  })
  .catch(err => {
    console.error('读取出错:', err.message);
  });

console.log('2. 主线程未受阻碍,正在处理其他新到达的客户端连接');
示例输出:
1. 准备发起异步文件读取...
2. 主线程未受阻碍,正在处理其他新到达的客户端连接
3. 异步回调触发:数据读取完毕,长度为 482910
可以看到,“2”在“3”之前打印。主线程在发出读取指令后毫不停顿,立刻腾出双手继续消费后续的任务,这正是 Node.js 维持高吞吐量的核心机制。
四、时序推导:一个异步 I/O 请求的五阶段完整生命周期
将视角聚焦到一个具体的异步网络或文件请求上,其在系统底层的流转经过五个紧密衔接的阶段:
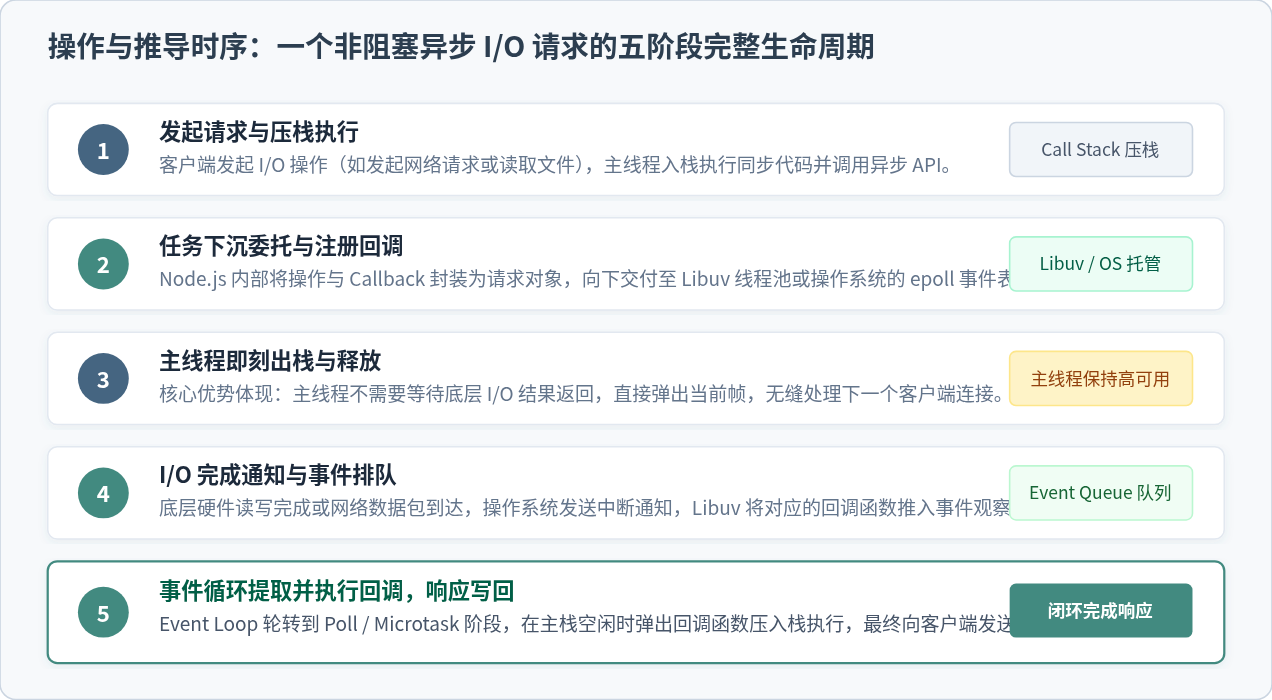
- 步骤 1:发起请求与压栈执行:JavaScript 代码调用异步 API(如
http.get或fs.readFile),V8 引擎将函数压入 Call Stack,解析入参和关联的回调函数。 - 步骤 2:任务下沉委托与注册回调:Node.js 原生 C++ 绑定层将该请求连同回调包装成一个请求对象(Req Object),挂载到 Libuv 的观察队列中。网络事件挂入操作系统的多路复用监听表,文件或加密操作投递给工作线程池。
- 步骤 3:主线程即刻出栈与释放:异步 API 立即返回,Call Stack 弹出该函数。主线程保持就绪,随时处理后续的同步代码或新到达的 HTTP 请求,完全不占用等待时间。
- 步骤 4:I/O 完成通知与事件排队:当数据准备完毕(操作系统完成 TCP 读入或磁盘读写完毕),系统通知 Libuv,Libuv 将之前保存的回调函数包装为事件,推入事件队列(Event Queue)。
- 步骤 5:事件循环出队回调与响应:事件循环运转到 Poll 阶段,确认 Call Stack 为空,将队列中的回调弹出并压入 Call Stack 执行,业务代码处理响应数据并向客户端输出。
五、技术选型决策与边界:何时选择 Node.js?
没有任何一种架构能适合所有场景。理解 Node.js 的优势所在,同样需要明确其架构模型带来的物理边界与限制。
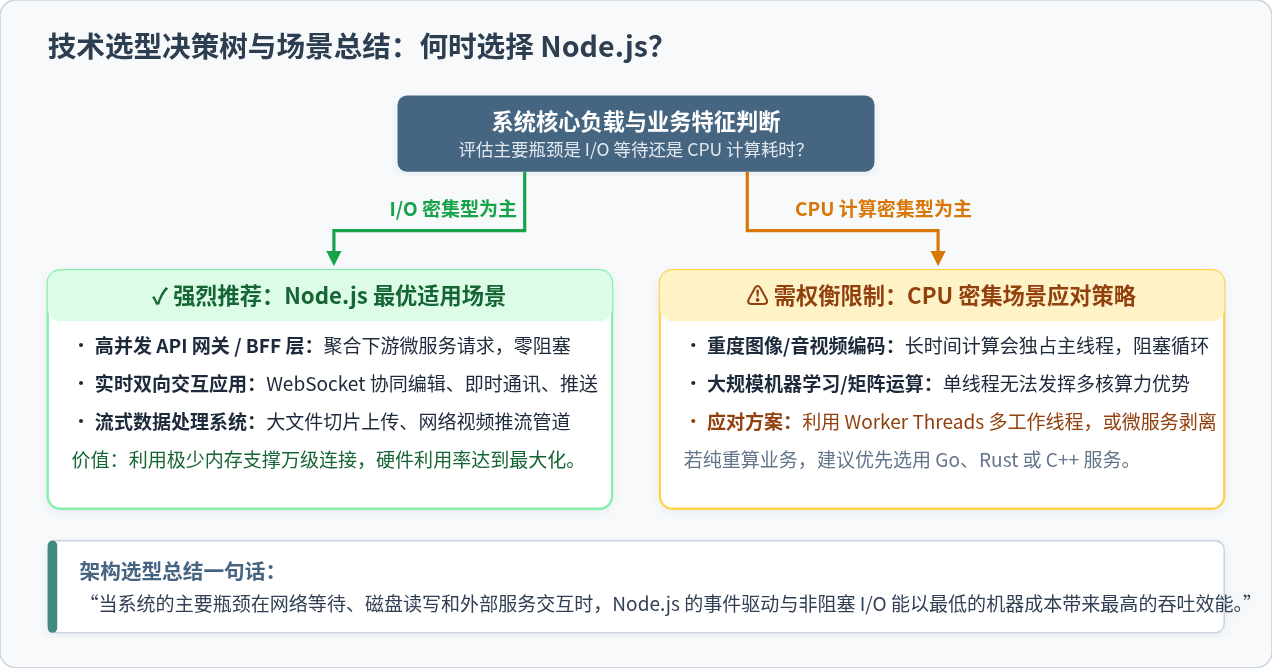
1. 极佳适用场景(I/O 密集型)
- BFF 层与 API 网关(Backend For Frontend):需要聚合数个下游微服务、组装 JSON 数据并返回前端。这种场景下 95% 以上的时间都是在等待网络 I/O,Node.js 能以极小资源开销获得高并发转发吞吐。
- 实时双向通信应用:利用 WebSocket 或 Server-Sent Events(SSE)构建的即时聊天、在线白板协同、物联网传感器数据采集平台。Node.js 能在数千长连接保持空闲监听时不耗损巨量内存。
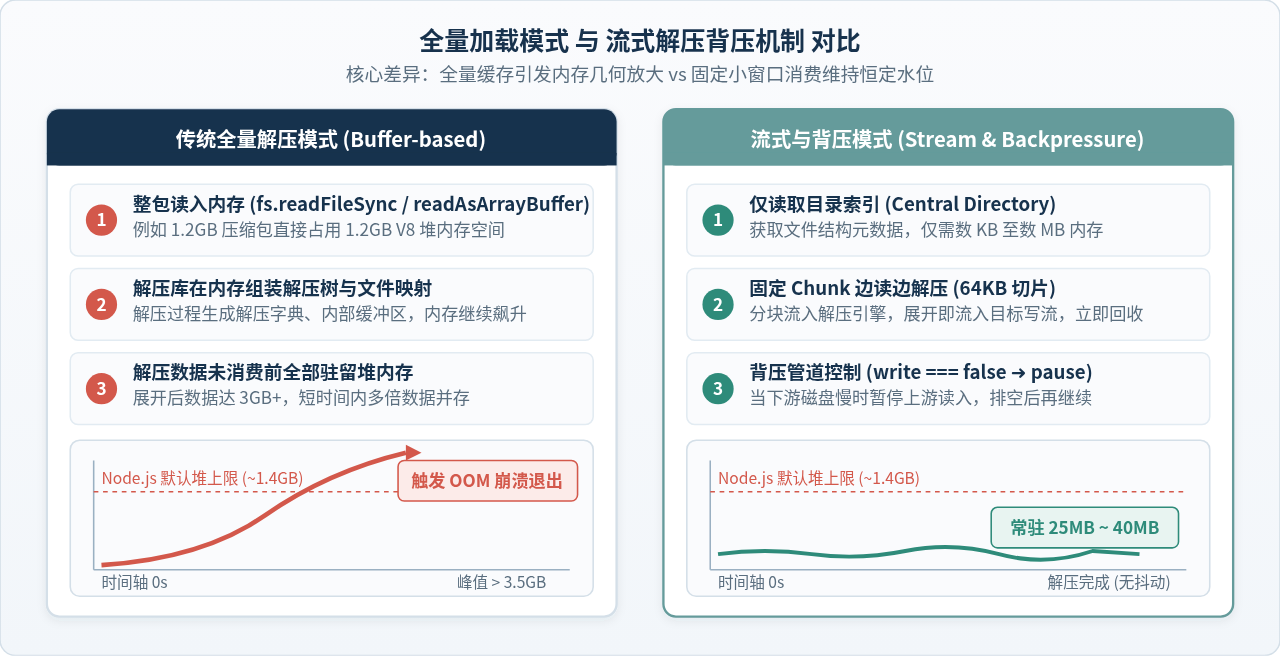
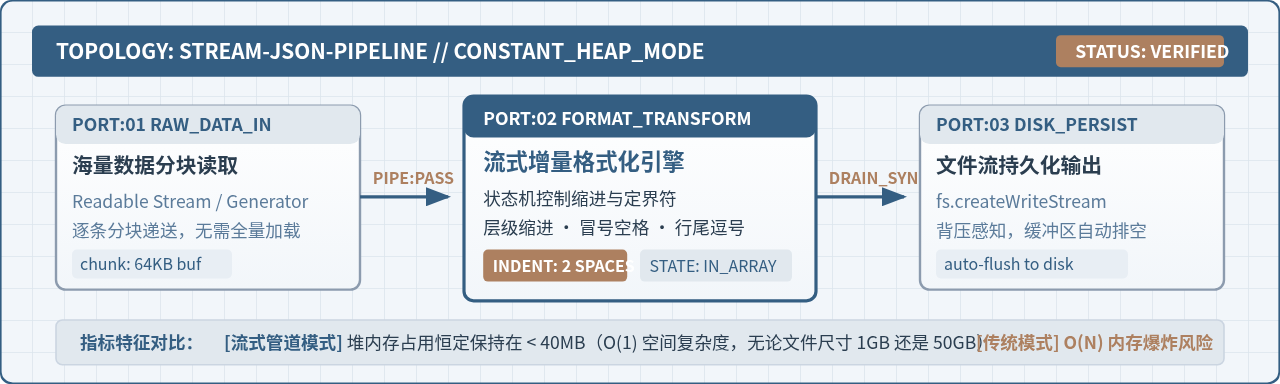
- 流式数据管道:借助 Node.js 原生的 Stream API,可以实现大文件分片边读边压缩、边下载边转存,内存占用稳定在几十兆以内。
2. 不适用或需谨慎处理的场景(CPU 密集型)
- 复杂音视频编解码与图像滤镜处理:如果一个请求需要在主线程持续进行 2 秒的密集矩阵计算,由于单线程特性,这 2 秒内整个进程的事件循环将被彻底冻结,期间到达的所有其他网络请求都无法得到响应。
- 大型科学计算或大规模密码哈希运算:单主线程无法自然利用服务器的多核心计算能力。
worker_threads 模块启动独立的工作线程分担计算,或通过 child_process 移交系统脚本,对于重算力系统,更建议将计算模块拆解为专门的 Go、Rust 或 C++ 独立微服务。
六、生产环境高并发关键避坑指南
掌握了事件驱动与非阻塞原理后,在编写生产代码时应严格遵守以下工程规范:
- 绝不使用同步阻塞 API:生产服务中严禁在 HTTP 处理链路上调用
fs.readFileSync、crypto.pbkdf2Sync等同步方法,必须使用对应的异步版本或基于 Promise 的 API。 - 当心隐蔽的同步重操作:执行
JSON.parse()解析超大 JSON 字符串(例如 100MB+),或者运行带有灾难性回溯(Catastrophic Backtracking)的正则表达式,都会无声无息地卡死主线程事件循环。 - 进程守护与多核利用:单进程崩溃可能导致该进程承载的所有连接被动中断。在多核服务器上部署时,应使用 Node.js 原生的
cluster模块或运维工具PM2启动与 CPU 核心数相匹配的多个实例,搭配 Nginx 进行反向代理与进程负载均衡。 - 合理调配 Libuv 线程池大小:若应用存在频繁的文件读写或密集加密验证,系统默认的 4 个工作线程可能成为瓶颈。可在启动命令前配置环境变量(例如
UV_THREADPOOL_SIZE=16 node app.js),以提升底层异步任务处理吞吐量。
为什么JS中不建议用eval解析JSON字符串
2026-11-12 12:37:49
JavaScript框架库漏洞该用原生还是引入库
2026-11-08 20:57:35
JavaScript框架库漏洞标准操作流程怎么定
2026-11-08 08:06:55
JavaScript框架库漏洞怎么写可读性更好
2026-11-07 16:07:58
JavaScript已禁用如何启用和传统写法哪个性能更好
2026-11-07 14:57:53