JavaScript框架库漏洞该用原生还是引入库
面对JavaScript框架库与三方依赖漏洞,团队应在原生重构与引入专精库之间做出理性抉择。本文从技术边界、安全面推演、决策模型与实操代码四个维度,深入解析如何根据场景选择最优解。
一、告警触发后的第一道分水岭:重构冲动与自研陷阱
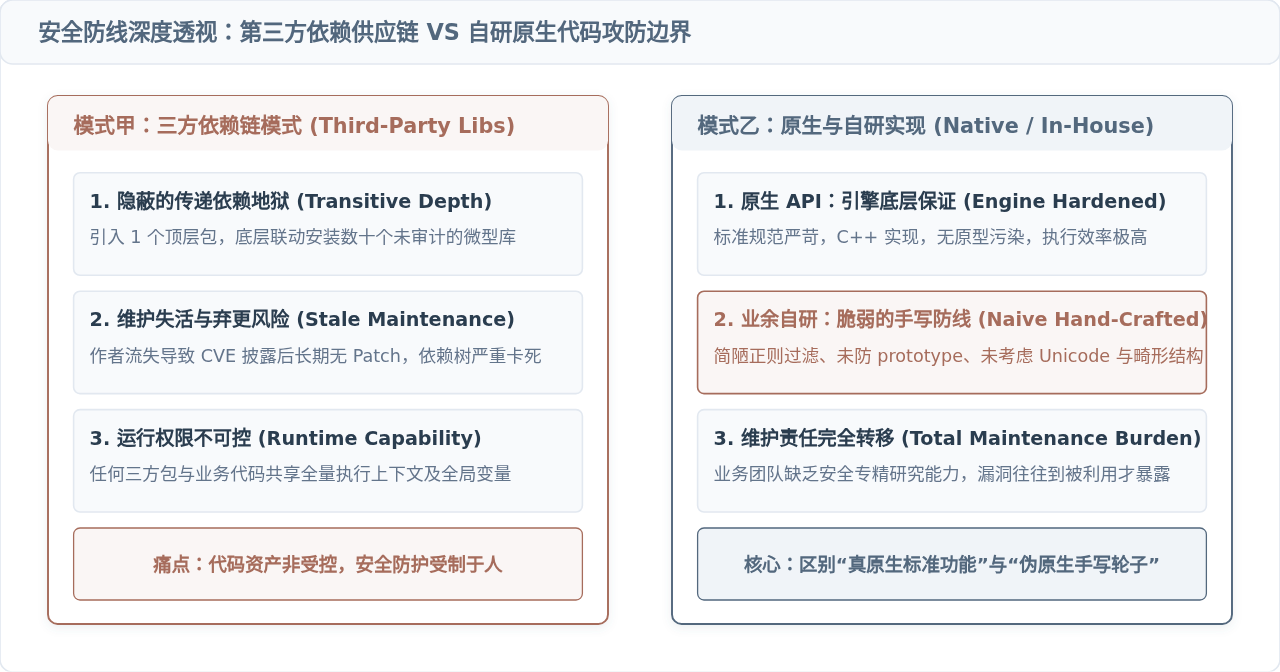
几乎每位工程维护者都经历过这样的时刻:在终端执行日常构建或推送代码时,CI/CD 管道因 npm audit 抛出红色的 High 或 Critical 警报而强行中断。提示往往指向一个深层嵌套的三方库——也许是某个已停更三年的小型对象合并工具暴露了原型污染(Prototype Pollution),或者是 URL 参数解析库在处理极端畸形字符串时会陷入灾难性回溯(ReDoS)。
面对这类安全通知,开发团队内部往往迅速分化为两种截然相反的声音。一种观点秉持极简主义:“三方库靠不住,几行代码就能搞定的东西为什么要装包?直接删掉依赖,用原生手写一个本地工具函数,依赖没了,漏洞自然就清零了。”另一种观点则习惯性地打开 npm 搜索:“看看哪个新包周下载量大、Issue 少,换一个装上就好。”
这两种极端的应对方式往往都是危险的。将存在漏洞的库随手替换为另一个未经验证的第三方包,实质上只是把定时炸弹从一个抽屉挪到了另一个抽屉,供应链的深层传递依赖并没有得到收敛;而盲目追求“无依赖”、试图用原生 JavaScript 手写一切,则常常滑入“自研安全盲区”——许多开发者误以为只要代码量少就没有漏洞,却不知那些被库封装起来的几十行看似冗余的代码,正是为了防御极端特例、字符集变形和原型链篡改而积累的防护堤坝。
二、处置决策步骤:从漏洞评估到方案落地
当出现漏洞预警时,切忌直接在编辑器中动手写代码或急于执行 npm uninstall。应当遵循一套由表及里的结构化研判步骤,明确界定问题本质后再选取对策。
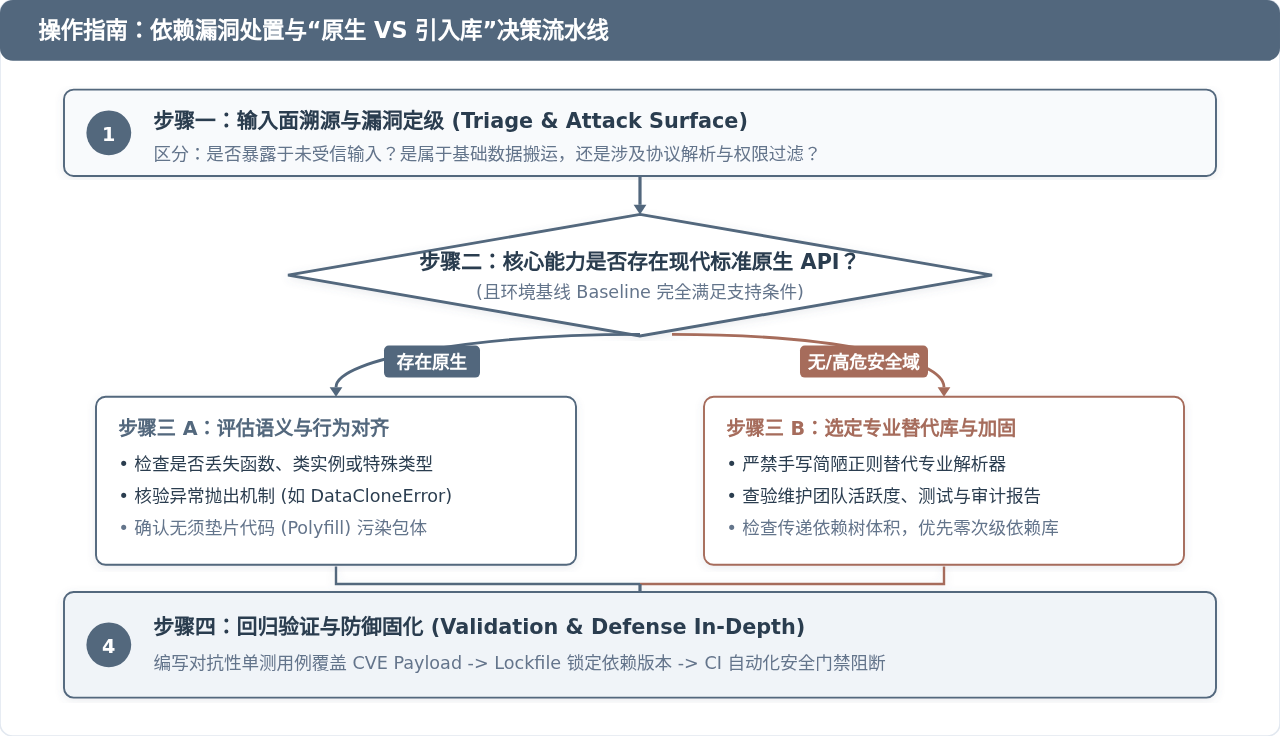
步骤一:解构漏洞性质与数据流动边界
首先排查该依赖在项目中的实际调用路径与数据来源。如果该库处理的输入完全来源于受信任的内部只读常量或构建期配置,攻击者无法在运行时注入恶意 Payload,那么该漏洞在当前环境下的实际可利用性(Exploitability)相对较低,为团队留出了从容评估的时间;反之,若该库直接接触用户提交的 URL 参数、POST 请求体、富文本或者第三方 Webhook,则属于必须立即处置的正面防线。
步骤二:核对当前运行时的原生规范支持度
许多十年前编写的工具库(如 left-pad、deep-extend、querystring)诞生的时代,JavaScript 标准库极度贫瘠。但现代 ECMAScript 及 Web 标准已经演进出了大量稳固的原生能力:
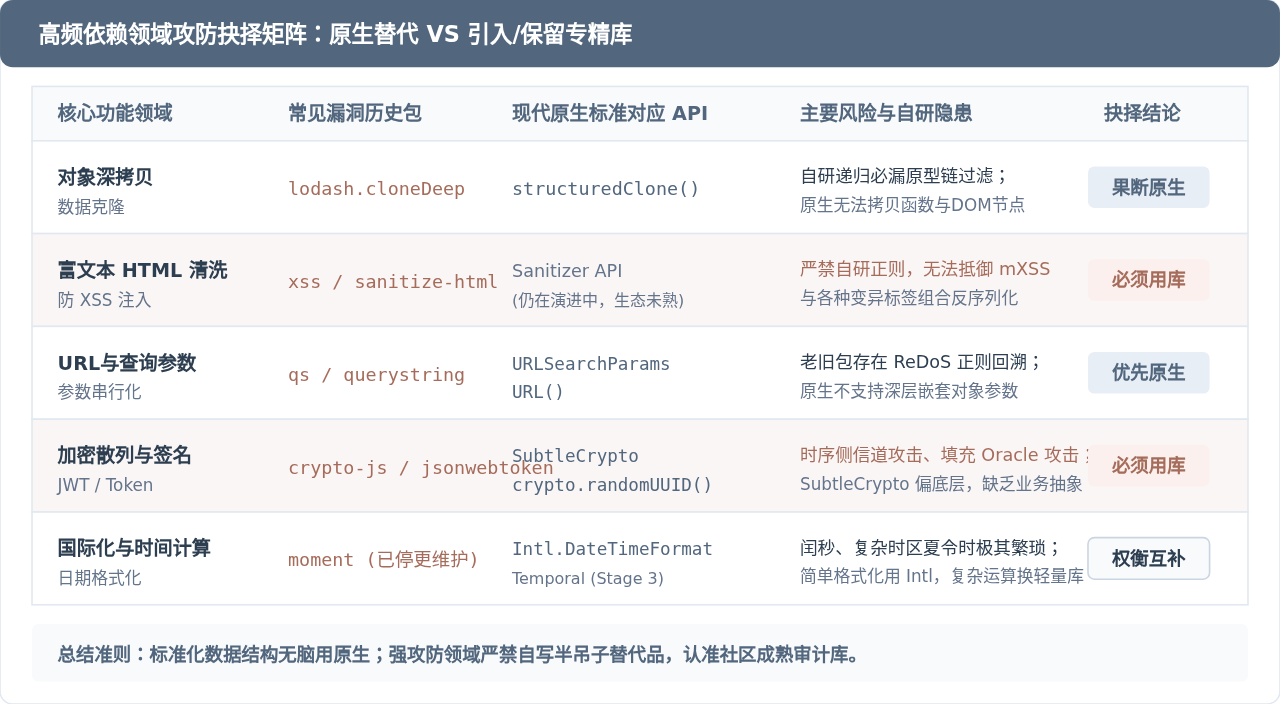
- 深拷贝场景:浏览器与 Node.js 17+ 已全面标配
structuredClone()。 - URL 与参数场景:
URL与URLSearchParams在全平台实现一致,且严格符合 WHATWG 规范。 - 随机数与通用唯一标识符:
crypto.randomUUID()完全避免了以往使用Math.random()或老旧 uuid 库带来的弱伪随机数隐患。 - 数组平铺与对象属性:
Array.prototype.flat()、Object.hasOwn()等均已入席标准。
若漏洞涉及的功能已成为正式纳入标准的原生 API,且项目的目标运行环境(Baseline)已完全覆盖该特性,那么用原生 API 替换第三方库就是收益最高、风险最低的选择。
步骤三:研判边缘用例与语义完备性
这一步是避免产生线上故障的关键。原生标准虽然安全高效,但其设计初衷遵循通用通用规范,与某些历史库的具体行为存在细微差异。以深拷贝为例:structuredClone 遵循 HTML 结构化克隆算法,它能完美处理循环引用、Date、RegExp、Map、Set 以及 TypedArray,但无法克隆函数、DOM 节点或保留原对象的原型链。如果原有业务严重依赖 lodash 对类实例方法的克隆,直接切换原生会导致抛出 DataCloneError 异常。必须核实业务是否依赖了这些特定边界。
步骤四:选型分流与安全回归闭环
若确认存在复杂的安全对抗逻辑(如富文本 XSS 过滤、JWT 非对称签名验签),则放弃任何自写逻辑的幻想,转向业界公认的专精安全库,并补齐自动化测试与持续审计。
三、典型场景实测与代码推演
为了让选择标准更加具象化,我们选取前端与 Node.js 开发中最常出现安全告警的两个典型场景进行技术推演。
场景 A:深拷贝与对象合并(以原型污染为例)—— 原生替代的绝对胜场
早年许多工具库在处理嵌套对象深拷贝或合并时,直接递归遍历对象键名,未对 __proto__、constructor、prototype 等特殊属性做拦截。黑客通过向输入 JSON 注入特殊键,即可修改全局 Object 原型,造成所有对象继承恶意属性,进而诱发远程代码执行或鉴权绕过。
// ❌ 脆弱的早期第三方库逻辑 / 粗糙自研实现(存在原型污染高危隐患)
function naiveDeepMerge(target, source) {
  for (const key in source) {
    if (typeof source[key] === 'object' && source[key] !== null) {
      if (!target[key]) target[key] = {};
      naiveDeepMerge(target[key], source[key]); // 危险:若 key 为 "__proto__",将直接篡改 Object.prototype
    } else {
      target[key] = source[key];
    }
  }
  return target;
}

// ✅ 现代原生解决方案:无须任何第三方库
// 浏览器与 Node.js 17+ 原生支持,底层由 V8 引擎 C++ 实现,对原型污染免疫
function secureDeepCopy(inputData) {
  // 原生算法严格遵循 HTML 结构化克隆规范,自动切断原型注入路径
  return structuredClone(inputData);
}
在深拷贝这类“纯数据结构操作”场景下,原生 API 无论在安全性、内存分配效率还是执行性能上均全方位碾压第三方库,此时淘汰第三方包是毫无争议的最佳实践。
场景 B:富文本与 HTML 清洗(以跨站脚本 XSS 为例)—— 必须依托专精库
与数据拷贝完全相反的领域是用户输入的 HTML 清洗。当项目使用的老旧 HTML 过滤库曝出 CVE 绕过漏洞时,绝不能产生“我自己写个正则表达式替换掉 <script> 标签”的念头。
现代浏览器 DOM 树的解析极其复杂,攻击者可以通过突变 XSS(Mutation XSS,简称 mXSS)、SVG/MathML 命名空间混乱、畸形属性嵌套(如 <img src=x onerror=alert(1)>、<a href="javascript:...">)轻易绕过任何朴素的自研正则表达式。
// ❌ 极其危险的自研正则过滤(千万不要使用此类“自研轮子”)
function dangerousNaiveSanitize(userInputHtml) {
  // 致命缺陷:无法防御畸形属性、事件监听、mXSS 及编码混淆
  return userInputHtml.replace(/<script[^<]*(?:(?<!<\/script>)<[^<]*)*<\/script>/gi, '');
}

// ✅ 正确抉择:引入长期维护、具备专职安全审计的专精库
import DOMPurify from 'dompurify';

function robustSanitize(userInputHtml) {
  // DOMPurify 内部构建独立的离线 DOM 树并执行深度白名单清洗,能有效抵御绝大多数浏览器特异性解析攻击
  return DOMPurify.sanitize(userInputHtml, {
    ALLOWED_TAGS: ['b', 'i', 'em', 'strong', 'a', 'p', 'code'],
    ALLOWED_ATTR: ['href', 'target']
  });
}
即便 Web 平台正在推进原生的 Sanitizer API,但在该标准彻底普及并获得各大浏览器长期攻防检验之前,像 DOMPurify 这样历经数万次模糊测试(Fuzz Testing)与全球白帽黑客审计的专业库,其安全壁垒是任何自研业务代码都无法比拟的。
四、长期治理原则:建立“原生筑底、专精筑墙”的依赖演进策略
工程架构没有一劳永逸的安全。解决当下的 CVE 仅仅是打了一块补丁,如果缺乏长期的依赖演进原则,项目迟早会在下一次 npm audit 中再度瘫痪。
1. 原生能力筑底:收敛供应链攻击面
在日常开发与代码审查中,团队应建立“Native First(原生优先)”的共识。每当准备安装一个仅提供单功能的小包时,先查阅 MDN 与 CanIUse。诸如 is-plain-object、pad-start、array-flatten 这类微型库,在当代应坚决使用语言内置特性。减少依赖树的总体节点数量,就是从根源上降低被攻击的概率。
2. 专精安全库筑墙:恪守专业边界
对于确实无法依靠简洁原生 API 解决的高危功能,要精选有专属安全响应团队(Security Policy)维护的项目(如由 Cure53 团队背书的 DOMPurify,由专业组织支持的 jose 库)。并且在引入时坚持“最小依赖原则”,优先选择无第三方次级依赖的独立包,避免“买一把锁却送来一整座未经验证的大楼”。
3. 自动化门禁闭环:锁定与主动巡检
将依赖治理融入开发流水线:
- 严格提交
package-lock.json或pnpm-lock.yaml,杜绝构建时浮动安装不受控的次级版本。 - 开启 Dependabot 或 Renovate 定期自动更新非破坏性补丁,将漏洞修复分摊到日常迭代中,避免积重难返。
- 在 CI/CD 中配置自动化安全检查阻断规则,对新引入的依赖自动评估许可证与已知漏洞。
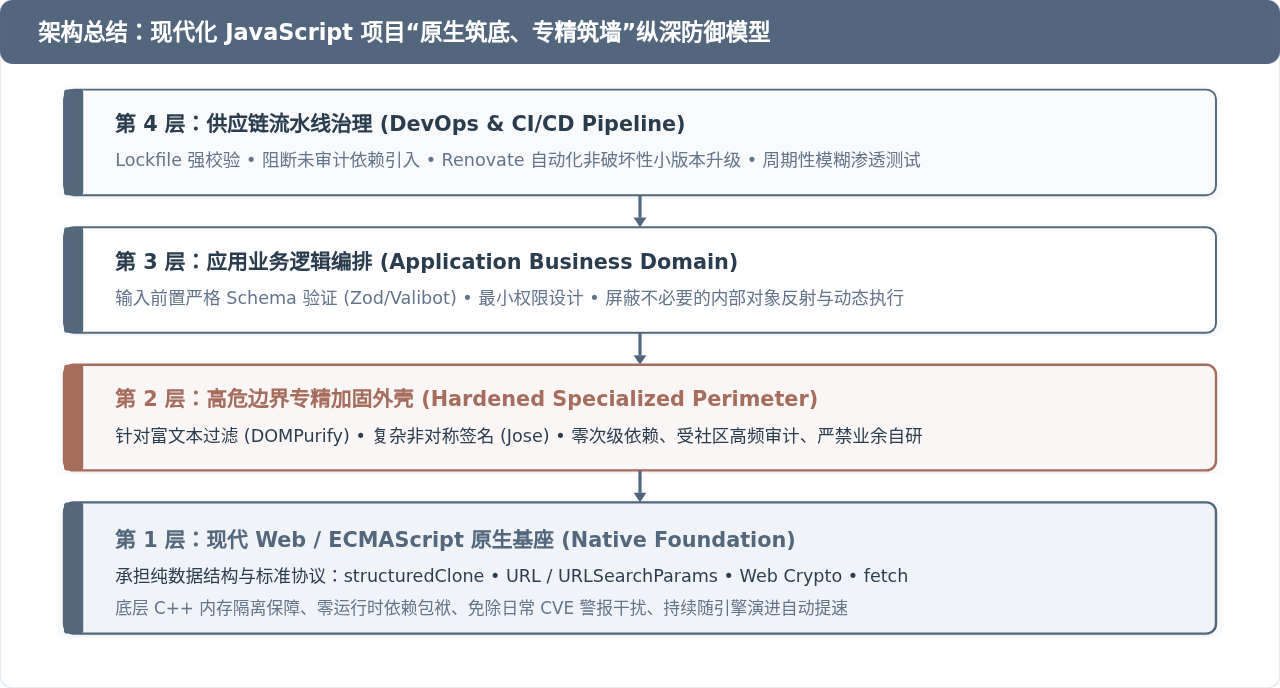
归根结底,“JavaScript 框架库漏洞该用原生还是引入库”从来不是一道二选一的阵营站队题。面对漏洞警报,最成熟的工程实践是用标准原生 API 剥除低价值的冗余依赖,同时用经受住实战检验的专精库筑牢高危安全边界。看清代码背后的安全责任边界,才能让项目既保持现代标准的轻盈,又具备抵御复杂威胁的韧性。
JavaScript框架库漏洞标准操作流程怎么定
2026-11-08 08:06:55
JavaScript框架库漏洞怎么写可读性更好
2026-11-07 16:07:58
JavaScript已禁用如何启用和传统写法哪个性能更好
2026-11-07 14:57:53
JavaScript禁用怎么解除怎么配合缓存使用
2026-11-07 11:02:20
JS混淆与加密有什么区别?前端源码保护的安全性边界分析
2026-11-05 23:30:58