优化CrewAI Agent效果的技巧:LLM选择与记忆机制设置
本文深入解析如何通过精准选择LLM模型、明确Agent职责边界以及合理配置记忆机制,来提升CrewAI Agent的执行准确性与效率。文章强调避免盲目堆砌配置,主张基于任务难度匹配模型能力,通过小规模对照实验验证效果,并利用可观察指标迭代优化执行参数与记忆策略,从而实现高效、可控的Agent工作流。
当Agent表现未达预期时,许多人的第一反应往往是更换更强大的模型或开启记忆功能。然而,若任务目标模糊或工具权限配置不当,即便模型再强大也可能导致执行路径偏离;而引入不相关的历史记忆反而可能干扰当前判断。优化CrewAI Agent的核心不在于堆砌配置项,而在于精准定位问题层级,并进行针对性调整。
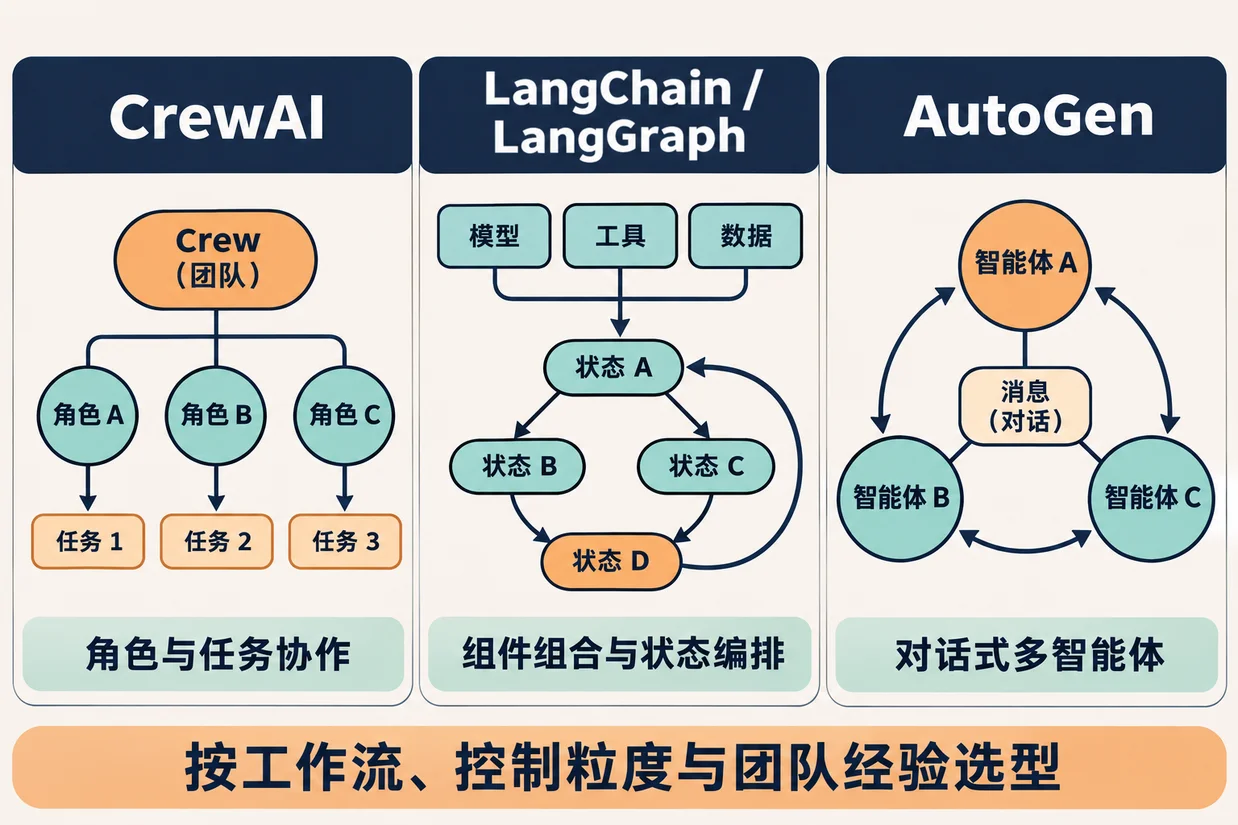
CrewAI Agent的表现由角色设定、目标导向、背景信息、模型能力、工具集及执行控制共同决定。其中,模型负责内容的理解与生成,工具界定其行动能力,而记忆与知识库则提供上下文支持。接下来,我们将从模型选型、执行边界划定及记忆机制配置三个维度,梳理一套更具实操性的调优方案。
模型选择要跟着任务难度走
对于信息抽取、分类或格式转换等边界清晰的任务,无需初始即选用高成本、低响应速度的顶级模型。建议先采用能满足指令遵循、输出格式规范及工具调用需求的模型打通流程,随后分析错误是否集中于复杂推理、长上下文处理或工具选择环节。仅当确认问题源于模型能力瓶颈时,升级模型才是有效解决方案。
针对需跨文档归纳、处理模糊目标或规划多步工具调用的复杂Agent,推理能力及工具调用的稳定性至关重要。同时,需综合考量上下文窗口大小、响应延迟、调用成本、供应商限额,以及模型对结构化输出或函数调用的支持情况。模型文档参数并不完全等同于实际任务表现,建议通过固定输入集和验收标准(如事实完整性、格式合规性、工具调用准确率及总成本)对候选模型进行对比测试,避免仅凭单次回答做出判断。
在CrewAI中,既可在Agent上直接指定llm,也可通过LLM对象集中配置模型及生成参数后复用。temperature参数控制输出随机性:在需要稳定抽取和严格遵循格式时,建议从较低值起步;若需措辞多样性或创意发散,则可小幅上调。需注意,该参数并非准确率调节器,即使设为零也无法保证事实绝对正确。此外,max_tokens限制生成长度,timeout控制超时时间,这些参数应依据任务输出需求与服务时限合理设定,避免盲目调大。
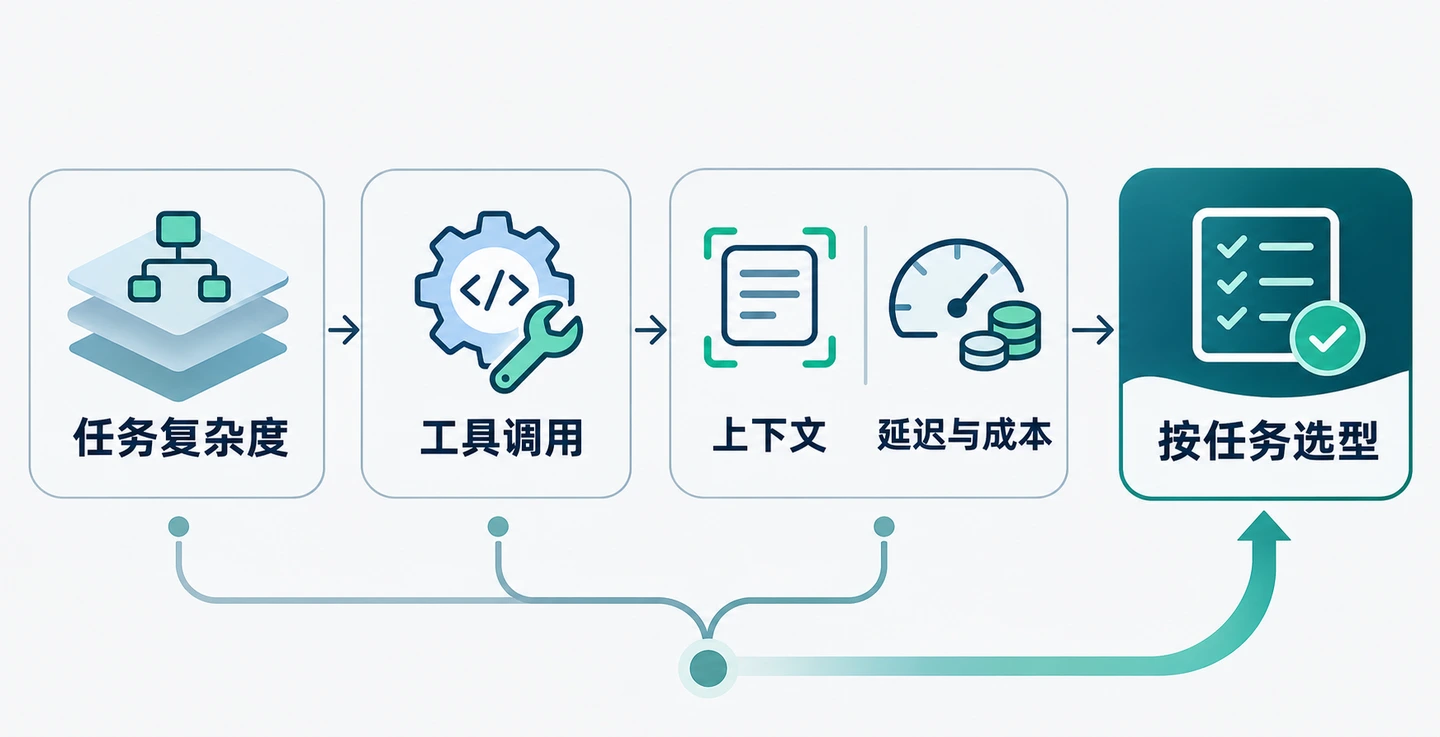
模型选择应结合任务能力与运行约束
一种实用的策略是将模型选择转化为小规模对照实验:准备若干代表性真实输入,运行同一Agent任务,记录质量、耗时、错误类型及费用。若低成本模型已满足验收标准,则无需在每个步骤都使用高阶模型;若仅特定复杂环节失败,可仅对该环节负责的Agent升级模型,而非整体提升。鉴于模型与能力清单更新频繁,配置前务必以所用CrewAI版本及模型供应商的最新文档为准。
先缩小Agent的职责,再调执行参数
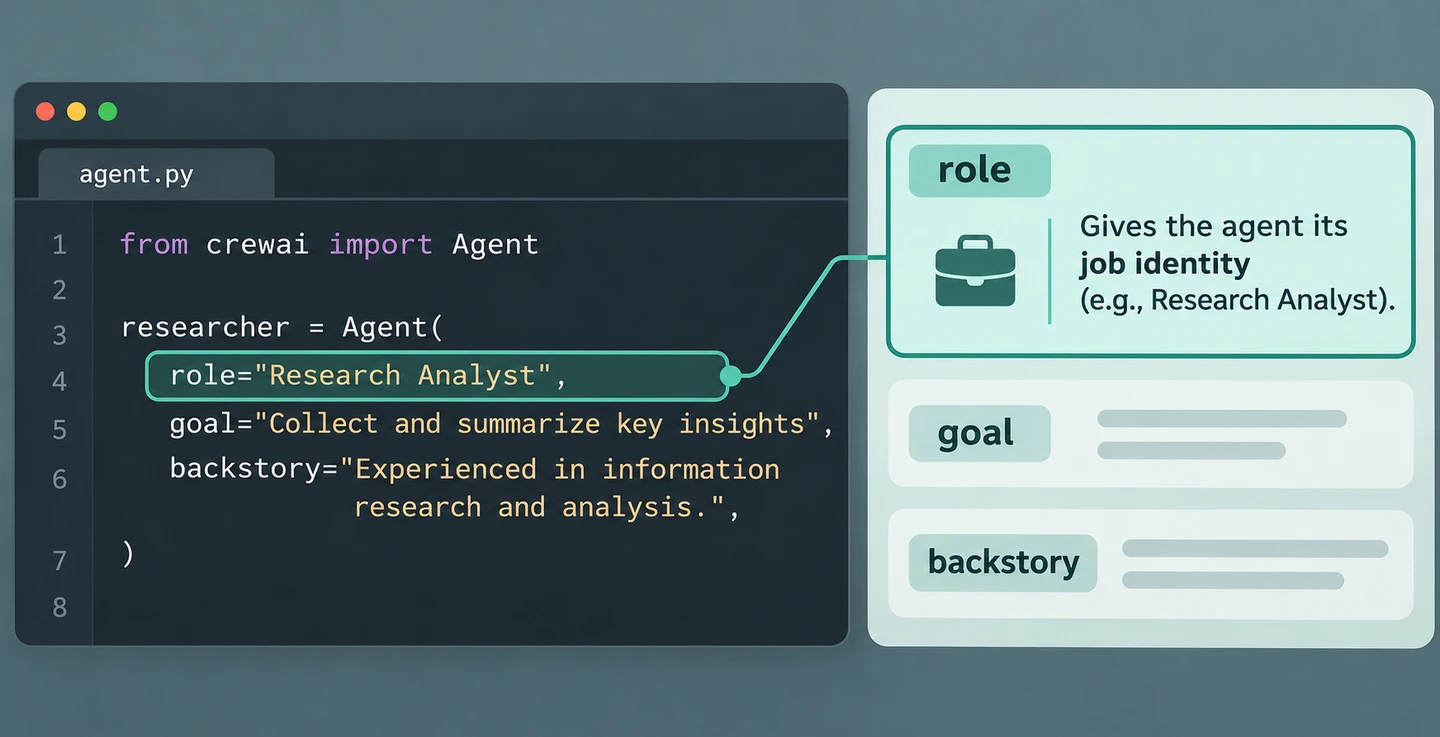
Agent的role、goal和backstory共同塑造其职责认知。相较于将其定义为“全能专家”,更有效的做法是明确其服务对象、输入类型及交付物。例如,研究Agent专责从资料中提取事实并标记不确定项,而写作Agent仅基于这些事实组织文本。角色边界越清晰,越有助于判断输出偏差是源于模型能力、任务描述还是工具限制。
工具分配也应遵循职责最小化原则。仅需查询资料的Agent不应具备文件写入或外部执行权限;涉及有副作用的工具时,应在任务设计中加入确认机制或约束条件。委派功能并非越多越好:仅当工作可明确拆分且子任务产出可被后续步骤验证时,才启用协作能力。让单个Agent同时承担规划、搜索、改写和校验等多重角色,往往会导致问题定位困难。
执行参数主要用于控制过程,无法自动提升答案质量。max_iter设定最大迭代次数,可有效限制无效循环;上限过低可能导致复杂任务过早终止,过高则增加调用成本与耗时。max_rpm用于控制请求频率,适合配合服务商限额使用。max_execution_time则为任务设定时长边界。建议每次仅调整一个参数,并记录完成率、迭代数及错误类型,以评估调整的有效性。
上下文管理直接影响长任务的表现。在当前Agent文档中,启用respect_context_window=True可在上下文接近模型限制时尝试总结,以确保持续执行;关闭该选项则可能在超限时停止任务。自动总结虽有助于长任务延续,但压缩过程可能遗漏精确细节。若任务必须保留原文中的数字、条款或代码,应将关键材料单独存入可检索的知识源,并在后续步骤按需读取,而非完全依赖对话历史。
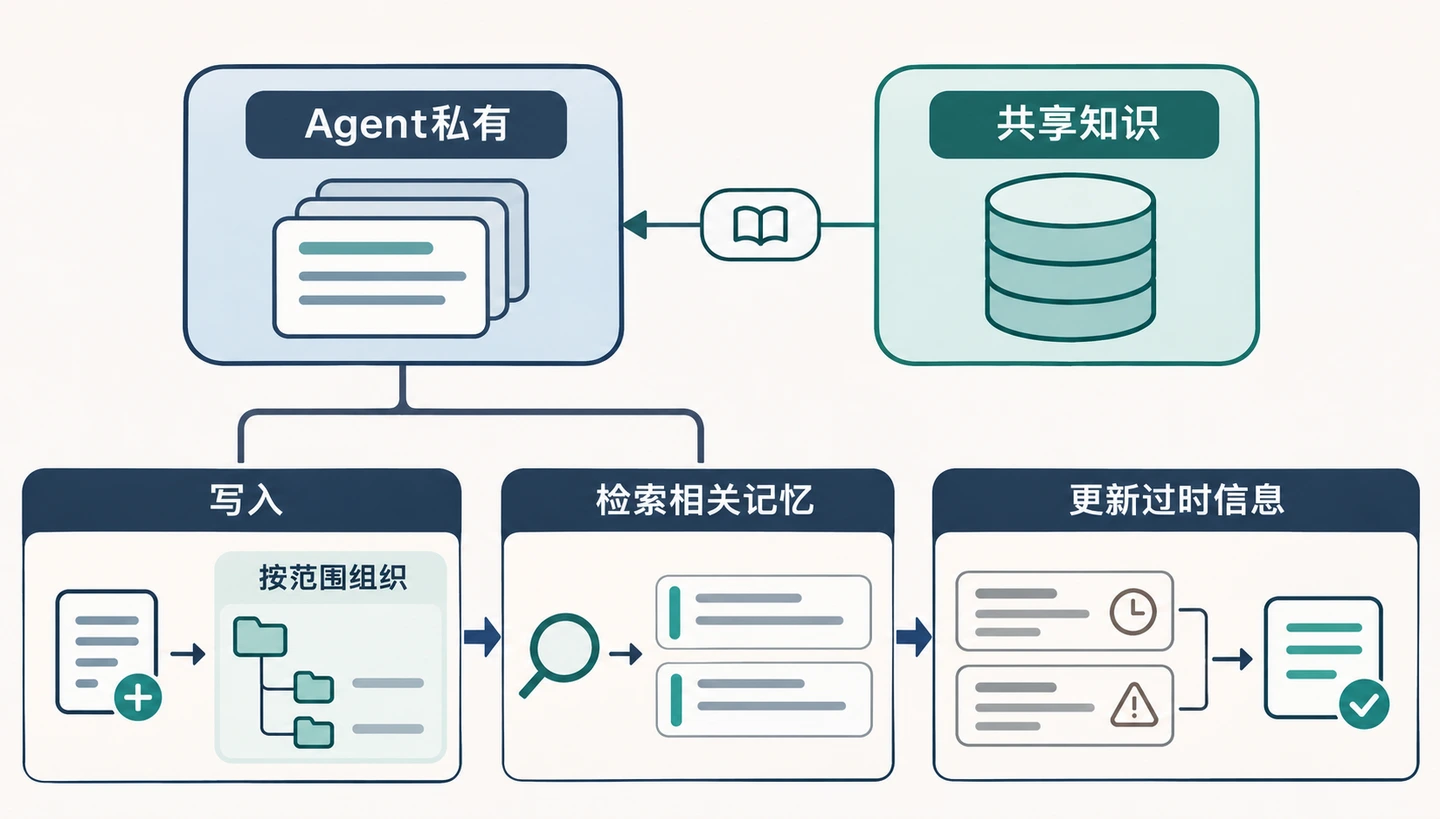
让记忆围绕范围和当前任务组织
记忆要保存能复用的信息
CrewAI的记忆机制随框架版本演进而变化。部分旧用法通过memory=True为Crew启用短期、长期及实体记忆;较新文档则提供统一的Memory接口,支持单独写入、检索及通过scope组织内容。因此,请先确认项目安装版本及对应文档,再选择相应API;避免混合不同版本的示例,也不要仅因参数可写入就假设数据已按预期保存。
记忆机制的适用性取决于信息是否需跨任务复用。用户偏好、项目约定及已确认决策通常值得保存;而一次性搜索结果、未核实猜测或快速过期的临时状态则需谨慎处理。建议从少量高价值事实开始,观察Agent在相关任务中能否正确召回,再逐步扩展。需注意,记忆并非知识库的替代品:若内容规模大、需精确引用或有明确权限隔离要求,仍应设计专门的知识检索与访问控制机制。
在统一Memory接口中,可通过scope将内容划分至不同范围,如按项目或Agent分支组织;不确定归属时可让系统推断,已知项目决策则可显式指定范围。检索时应围绕当前任务提出具体问题,避免将整个历史上下文塞入。对于跨项目共享信息,可限定只读范围,以降低Agent意外改写公共事实的风险。此外,记忆保存与检索可能调用配置的模型,涉及隐私或敏感内容时,需确认数据流向,并选择符合要求的模型与存储方式。
还需定期清理过期与冲突信息。项目决策变更后,应及时更新或删除旧记录;面对矛盾偏好,应保留可核验的最新事实,而非让模型自行猜测。若启用记忆后效果下降,可对比开关记忆前后的相同任务,检查召回内容的相关性、时效性及范围必要性,进而调整scope、检索条件或记忆模型。
用可观察的指标迭代配置
调优前,先固定一组代表性任务,并为每个任务定义可量化的结果标准,如必填字段、不可遗漏的事实、停止条件或补充信息请求时机。运行后记录模型、CrewAI版本、参数、工具调用、迭代次数、失败原因及耗时。这样即使某次改动未带来改善,也能明确回退项。需注意,日志可能包含提示词或任务数据,应根据隐私要求控制保留范围。
在调整配置前,先对问题进行归类:内容理解错误优先检查模型与上下文;工具选择错误或参数不当,检查工具描述、权限及任务边界;出现重复循环,检查目标可验证性及迭代上限;跨任务答非所问,则检查记忆内容、scope及检索结果。每次仅调整一个主要因素,并使用相同样本复跑,才能有效区分真正有效的改动与偶然波动。
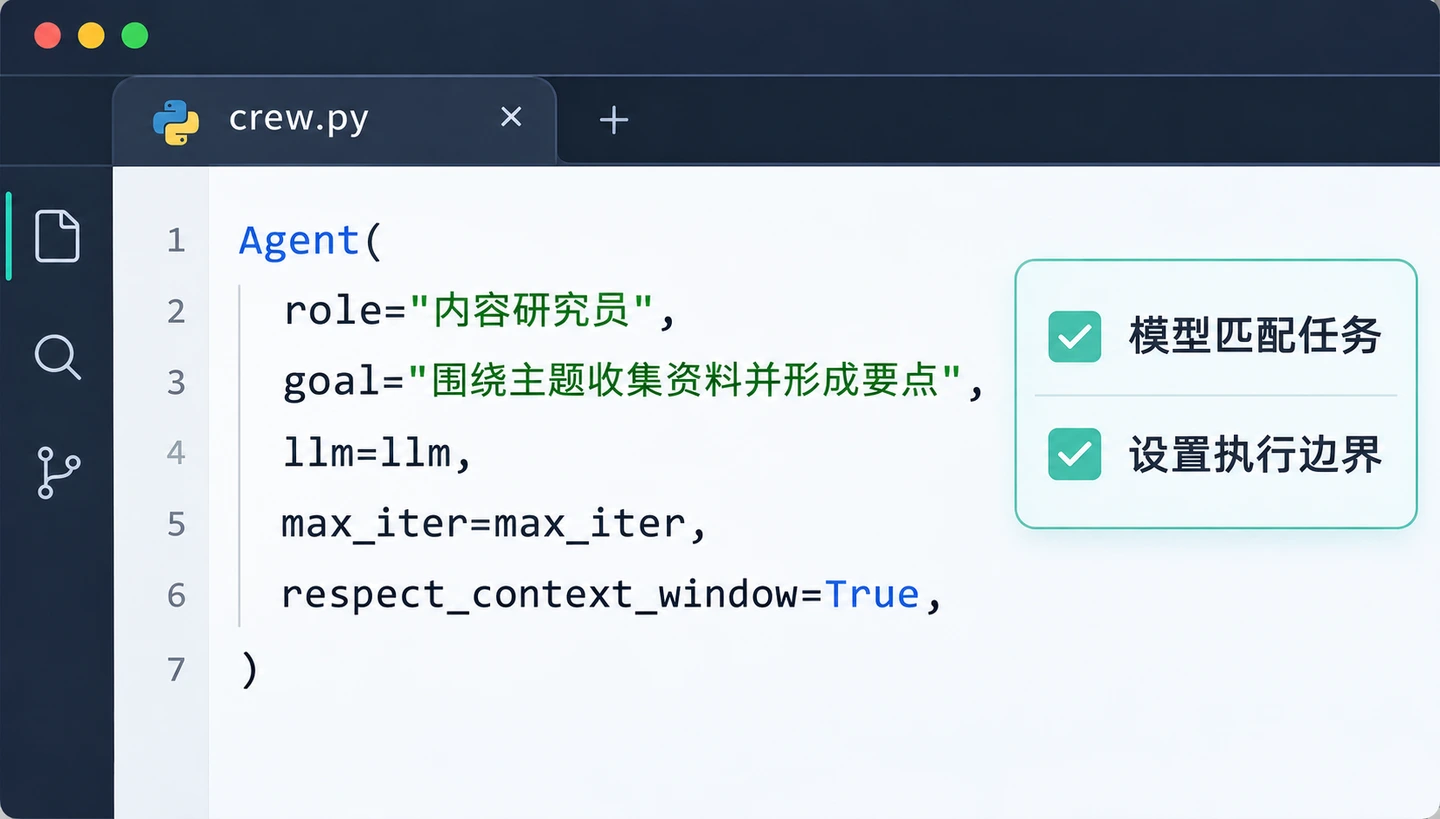
按Agent职责配置模型和执行边界
优化CrewAI Agent并非追求最强模型、最大记忆或最高迭代数,而是确保每个配置都对应明确需求。建议从清晰的角色目标和合适的模型入手,接着限制执行范围,最后仅为确实需要长期上下文的Agent启用可控记忆。通过固定版本、输入和验收标准,Agent的改进将更易复现,且在出现问题时能更快定位原因。
无需高配显卡:免费在线体验 Flux.1 绘画模型的网站推荐
2026-11-08 19:08:15
AI智能体与AI助手的技术架构对比:记忆机制、推理链与外部接口
2026-11-08 17:34:43
Google Veo 与 Sora、Runway Gen-3 对比:哪家 AI 视频工具更适合你
2026-11-07 18:40:39
Stable Diffusion负面提示词(Negative Prompt)常用模板与设置技巧
2026-11-07 14:40:24
开发者选型指南:DeepSeek和ChatGPT编程与逻辑推理能力对比
2026-11-07 12:51:56