JS混淆与加密有什么区别?前端源码保护的安全性边界分析
深入分析JavaScript混淆与加密的底层运行机制差异,探讨端侧代码可执行性与机密性的本质矛盾,梳理前端逆向攻击路径与安全防护的真实边界。
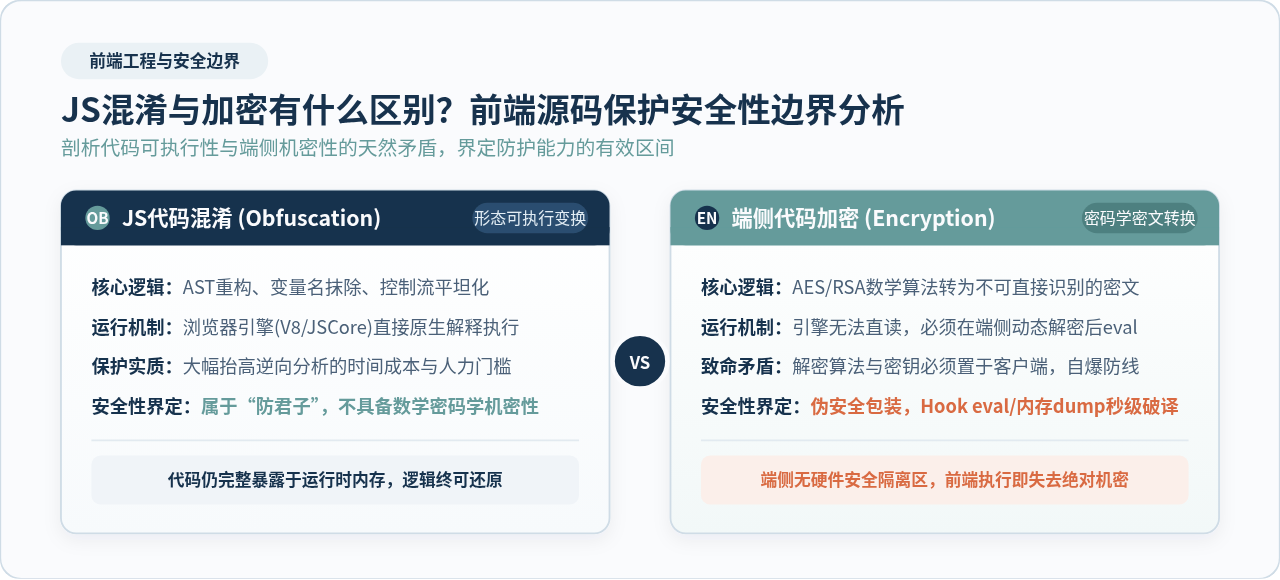
一、核心认知:混淆与加密的本质分水岭
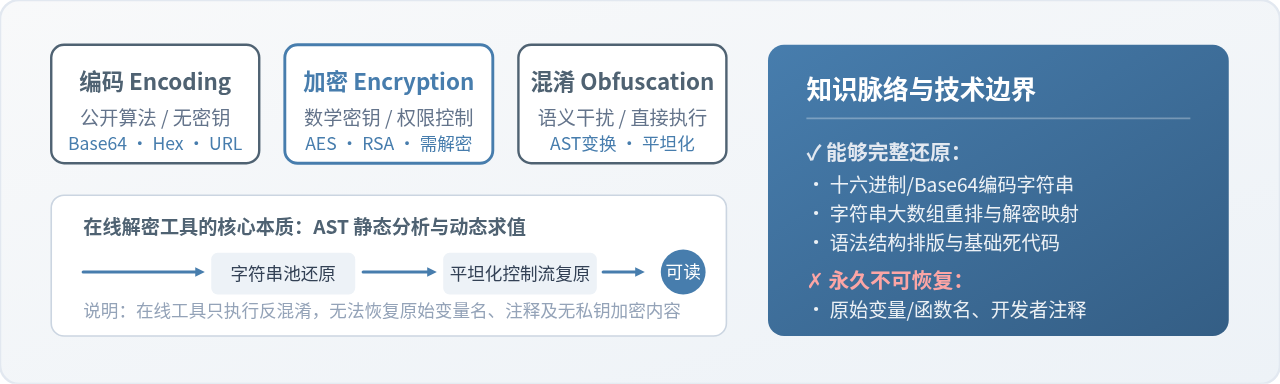
在讨论前端源码安全时,首先必须区分“混淆”(Obfuscation)与“加密”(Encryption)在计算机体系中所扮演的根本角色。
1. 什么是代码混淆(Obfuscation)
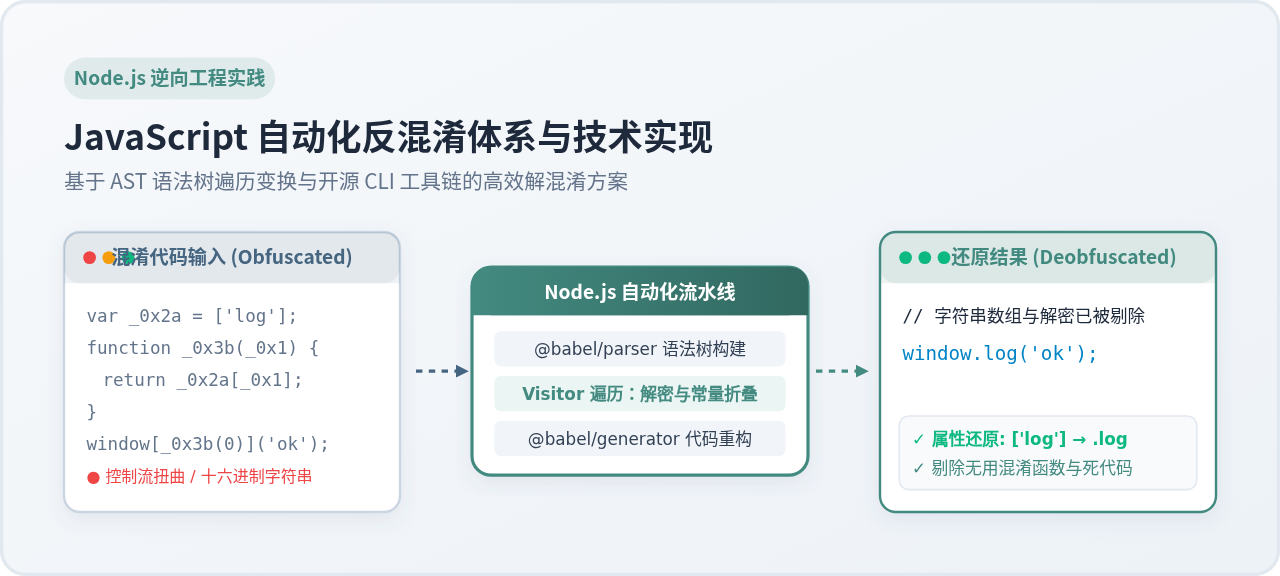
代码混淆是一种保留程序语义、仅改变表达形态的程序转换技术。混淆器通过对抽象语法树(AST)进行重构,将变量与函数名替换为无意义符号、将线性控制流平坦化为复杂的调度器、抽取字符串并编码、插入死代码分支等。
混淆后的代码在逻辑上与原始代码完全等价,输入相同的参数必然产生相同的输出。最关键的特征是:混淆后的代码本身依然是合法的 JavaScript 源代码,浏览器的 V8 或 JavaScriptCore 引擎无需任何外部解密插件或前置解密步骤,即可直接对其进行词法分析、语法分析并编译执行。
2. 什么是数据/代码加密(Encryption)
加密则是基于现代密码学(如对称加密 AES、ChaCha20 或非对称加密 RSA、ECC),使用特定的密钥和数学运算将明文转换为不可读的无规则密文。
未经解密的密文是纯粹的二进制字节流或 Base64 字符串,任何 JavaScript 引擎都无法直接识别或运行未解密的密文。如果要在浏览器中运行一段所谓的“加密脚本”,就必须在客户端环境中附带解密程序(Loader)和解密密钥,在内存中完成解密操作并重新生成代码字符串。
只要一段代码需要在不受信任的客户端(浏览器、手机端)上被解释执行,客户端就必须掌握执行所需的一切要素——包括代码的完整指令和运行上下文。由于用户对本地宿主拥有绝对控制权,一旦密钥与密文同时交由客户端管理,密码学上的机密性便宣告瓦解。
二、运行机制对比:代码在浏览器中的真实生命周期
通过跟踪代码从构建打包、网络下发到浏览器引擎加载的完整流水线,我们可以直观发现为什么混淆是实用的工程手段,而“前端加密”往往是伪命题。
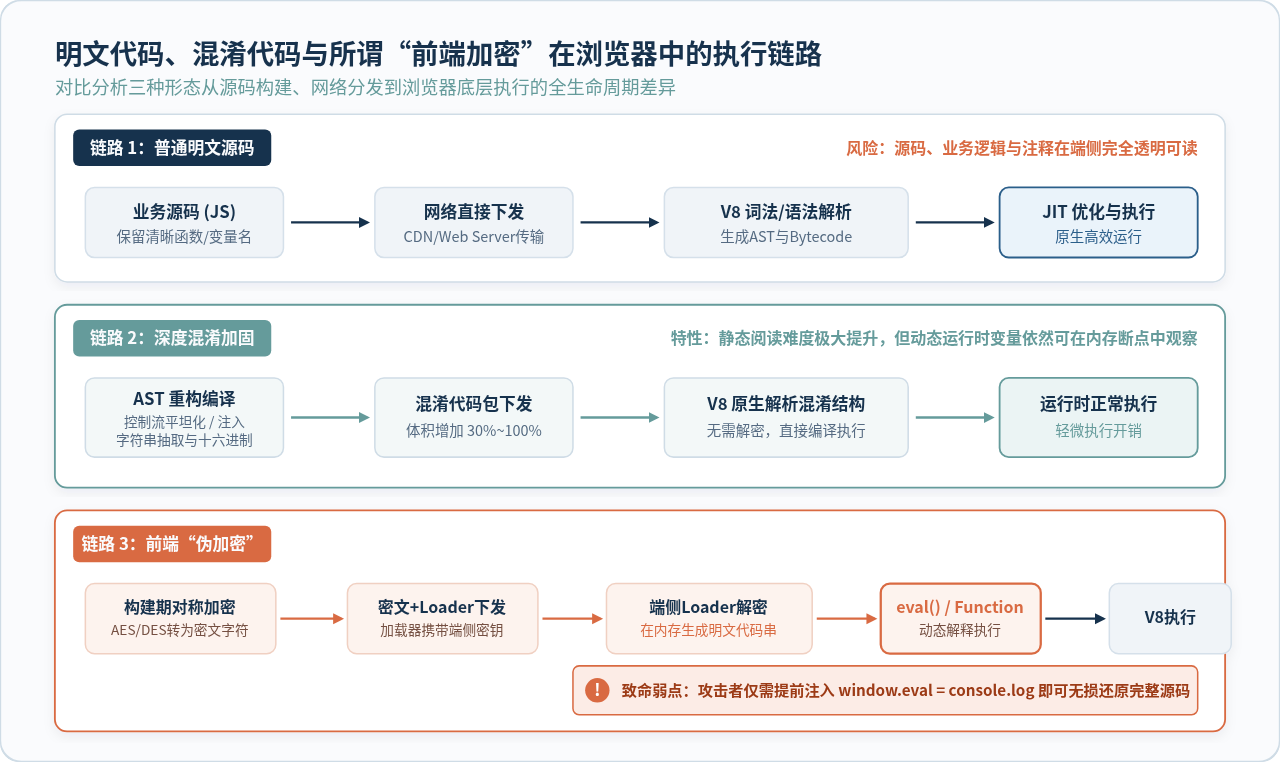
1. 混淆代码的执行链路
如链路 2 所示,混淆发生在构建打包阶段(如 Webpack / Vite 流水线中)。混淆器吐出的代码直接交付给 CDN。当浏览器下载后,V8 引擎直接将混淆后的代码输入解析器,生成字节码并交由 JIT 编译器优化执行。混淆代码不会增加动态解密的内存开销,执行流程原生平顺,尽管控制流复杂会带来轻微的 CPU 计算损耗,但整体依然是高效的原生运行。
2. 所谓“前端加密”的伪命题与瞬时脱壳
某些第三方“JS加密”工具宣称可以像保护桌面可执行文件加壳一样,对前端代码进行“不可逆高强度加密”。但如链路 3 所示,其底层运作机制实质是:
- 构建期使用 AES/RC4 将代码明文加密为字符串。
- 在网页中下发一个包含解密算法与密钥的轻量 Loader 脚本。
- Loader 在客户端执行解密函数,在内存中拼装出代码明文字符串。
- 调用
eval(decryptedCode)或new Function(decryptedCode)()动态执行。
这种模式在逆向工程师面前几乎没有防御效果。攻击者根本无需去研究复杂的密码学算法或找寻解密密钥,只需利用浏览器开放的宿主控制权,在页面最顶部注入一行针对执行入口的 Hook 脚本:
// 攻击者仅需提前注入的一行简单脱壳代码
const _realEval = window.eval;
window.eval = function(code) {
  console.log("==== 捕获动态解密出的完整明文代码 ====");
  console.log(code); // 内存中的明文无所遁形,可直接另存为本地文件
  return _realEval.apply(this, arguments);
};
不仅 eval 会暴露,new Function 或动态插入 <script> 标签也同样能被原生 Proxy 轻松截获。由此可见,“端侧加密”不仅牺牲了运行性能(动态解析无法享受 V8 编译预热),而且只要执行点暴露,壳层就会瞬间被剥离。
三、典型前端混淆加固手段实战剖析
既然端侧无法依赖密码学加密,生产环境中常用的代码保护手段主要依赖深度混淆与二进制加固。以下是目前业界最为成熟的几项技术解析:
1. 基础压缩混淆(Identifier Munging)
代表工具为 Terser、esbuild。它属于生产构建的标配步骤,主要任务是去除空白、注释,并将长变量名缩短为单字符(如 userData 变成 a)。这种处理仅能防止源代码的直接白盒泄露,但代码的嵌套结构、控制流分支与常量字符串依然完整保留,逆向分析门槛极低。
2. 深度控制流混淆(AST 变换加固)
以广泛应用的开源工具 javascript-obfuscator 为例,其核心加固维度包括:
- 字符串抽取与动态位移(String Array & Encoding): 将代码中所有的文本字面量(URL、方法名、参数键名)提取到一个全局数组中,对内容进行 Base64 或十六进制编码,并通过自执行函数进行乱序轮转,访问时通过解密包装函数动态索引。
-
控制流平坦化(Control Flow Flattening):
将原本顺序执行的
if-else或循环结构切分为若干基本代码块,放入一个庞大的switch-case分发器中,使用一个动态计算的状态机变量驱动执行跳转,彻底打乱原有的代码层级关系。 - 死代码注入(Dead Code Injection): 在关键业务周围随机注入大量永远不会执行或不改变状态的假分支,迷惑反编译工具与静态分析器。
-
反调试防御(Anti-Debugging):
在代码中植入定时触发的
debugger循环,或监听控制台对象的toString调用,一旦开发者工具打开,就会触发卡顿或无限断点。
// 经过深度控制流混淆后的典型代码结构示意
const _0x4a1b = ['log', 'bXlTZWNyZXQ=', 'split'];
(function(_0xarr, _0xnum) {
  // 动态移位轮转数组
  const _0xrot = function(_0xidx) {
    while (--_0xidx) { _0xarr.push(_0xarr.shift()); }
  };
  _0xrot(++_0xnum);
}(_0x4a1b, 0x1a3));

// 控制流平坦化分发器
const _state = '3|1|2|0'.split('|');
let _idx = 0;
while (true) {
  switch (_state[_idx++]) {
    case '0': return result;
    case '1': result += 0x2a; continue;
    case '2': result *= 0x2; continue;
    case '3': let result = 0; continue;
  }
  break;
}
3. WebAssembly(Wasm)二进制加固
将核心计算逻辑(如加解密算法、音视频处理、复杂校验规则)使用 C/C++、Rust 或 Go 编写,并编译为 .wasm 二进制字节码在浏览器中运行。
WebAssembly 并非加密,它依然可以在浏览器中直接实例化运行,但它将攻击者的逆向工作从“阅读混淆的 JavaScript 脚本”转移到了“逆向二进制汇编指令(Wasm Bytecode)”,逆向者需要使用 IDA Pro、Ghidra 等逆向分析软件重新梳理内存堆栈模型,大幅提高了逆向门槛。
四、逆向者的破译路径:前端源码保护的攻击链推导
为了准确界定防御能力的边界,我们必须以攻击者的视角推导逆向工程的完整推进过程。
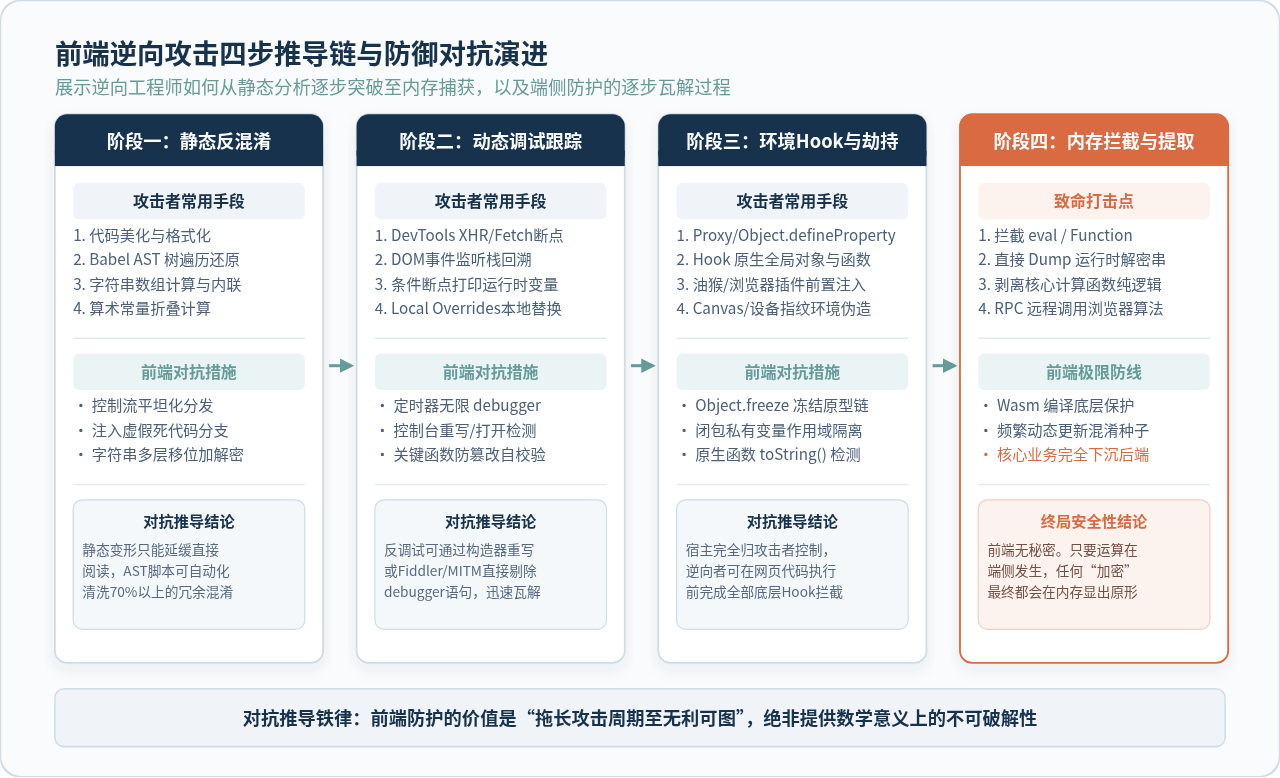
逆向分析通常不会去硬读混淆后的源码,而是遵循以下递进式推导链路:
-
静态反混淆清洗:
逆向人员编写基于 Babel 的 AST 脚本,遍历语法树完成自动常量折叠(如将
0x1 + 0x2直接计算为3)、将字符串解密函数执行并将结果直接写回调用处,并对单分支分发器进行展开。这一步通常能在几分钟内清洗掉 70% 的表面混淆干扰。 -
动态调试与阻断消除:
通过 Chrome DevTools 设置 XHR/Fetch 断点,在网络发送请求的那一刻直接暂停脚本,顺着调用栈回溯定位签名计算函数。对于页面植入的无限
debugger,逆向者可以使用 Fiddler/Charles 本地替换脚本,或者在控制台重写Function.prototype.constructor将其静默屏蔽。 -
运行时环境 Hook 与劫持:
通过浏览器插件或油猴脚本,逆向者在页面加载之初注入
Proxy对象,监听全局变量的读写、截获加密函数入参和返回值,甚至伪造 Canvas、WebGL 指纹来骗取风控模块信任。 - 内存抓取与纯算法剥离: 逆向的终极目标通常不是看懂整段代码,而是“拿来主义”。逆向者只要剥离出负责计算 Token 的纯函数,或者通过 RPC(如通过 WebSocket 与本地 Node.js 脚本联动)直接调用浏览器内的加密函数,就能实现自动化无感调用,无需读懂任何控制流。
五、前端源码保护的安全性边界界定
通过前文的执行链路与攻击链推导,我们可以对前端源码保护的安全性边界给出一个清晰的定义:
前端源码保护的真正价值在于战术性地大幅提升单次攻击的时间与精力成本,使得非专业攻击者和通用型自动化爬虫望而却步,或者迫使专业逆向人员的破解成本远高于其潜在收益。它不能、也绝无法提供理论上不可破解的绝对机密性。
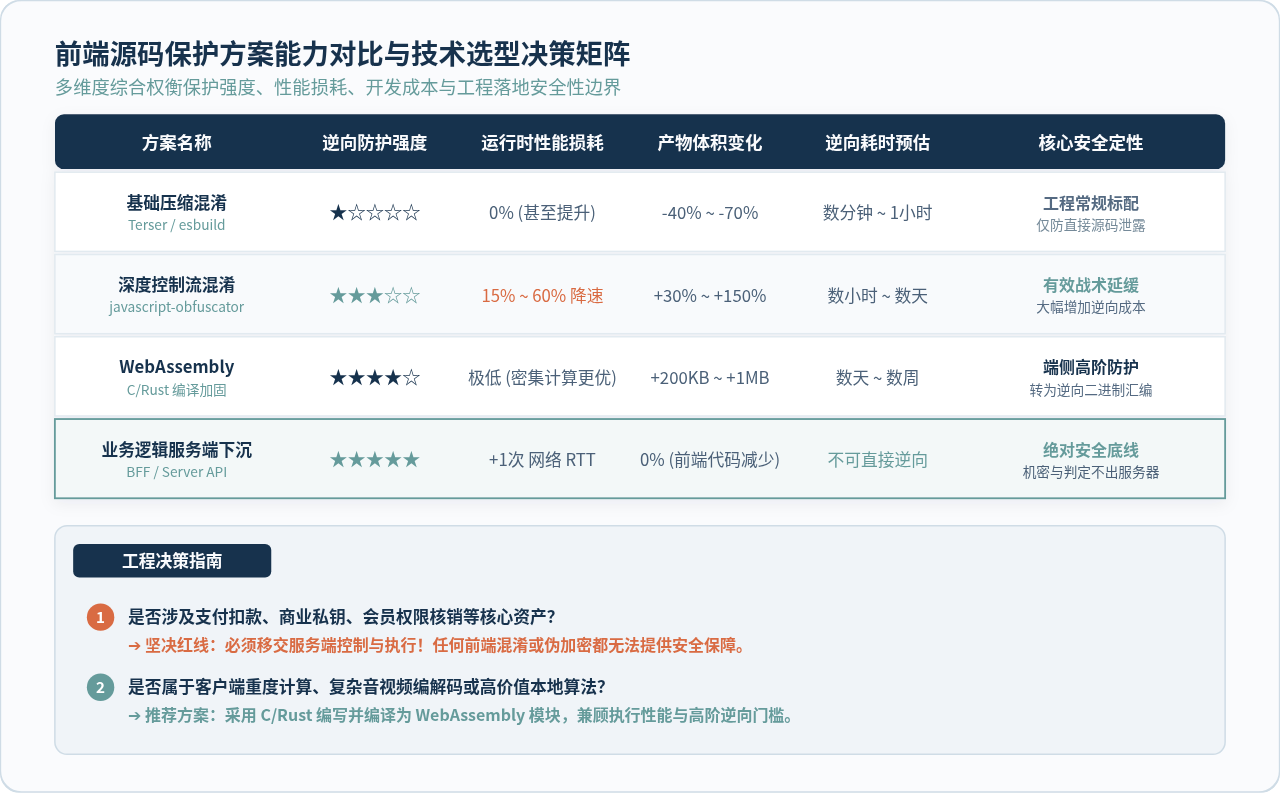
1. 绝对不可逾越的红线(严禁放置于前端的资产)
任何寄希望于通过“混淆”或“伪加密”来掩盖以下敏感信息的设计,都是严重的安全架构缺陷:
- 云服务与第三方高权限密钥:如 AWS AccessKey、阿里云 OSS Secret、微信支付商户私钥。任何编译在前端的密钥,逆向人员只需搜索字符串或监控网络调用便能在几分钟内提取。
- 最终业务决策与鉴权:如“用户是否拥有 VIP 权限”、“优惠券折扣最终金额计算”。端侧的判定可以被逆向者通过一行断点赋值随意篡改。
- 数据库账密与内部管理接口:不得直接在前端拼接 SQL 或调用无权限校验的管理 API。
2. 适合在前端进行的防御策略(延缓区)
- 防范低成本自动化爬虫抓取公开商业数据。
- 对敏感输入(如登录密码)进行传输前哈希或公钥加密(防止网络中间人窃听明文)。
- 设备环境指纹采集与行为异常特征上报(配合后端风控决策)。
- 对抗低级脚本外挂与自动化表单提交。
六、落地实践:现代前端系统的纵深防御体系
在实际生产架构中,单靠任何一项前端防御手段都无法抵御攻击。建立安全体系的正确思路是:以服务端为安全信任根基,前端防护作为战术前哨,构建多层联动机制。
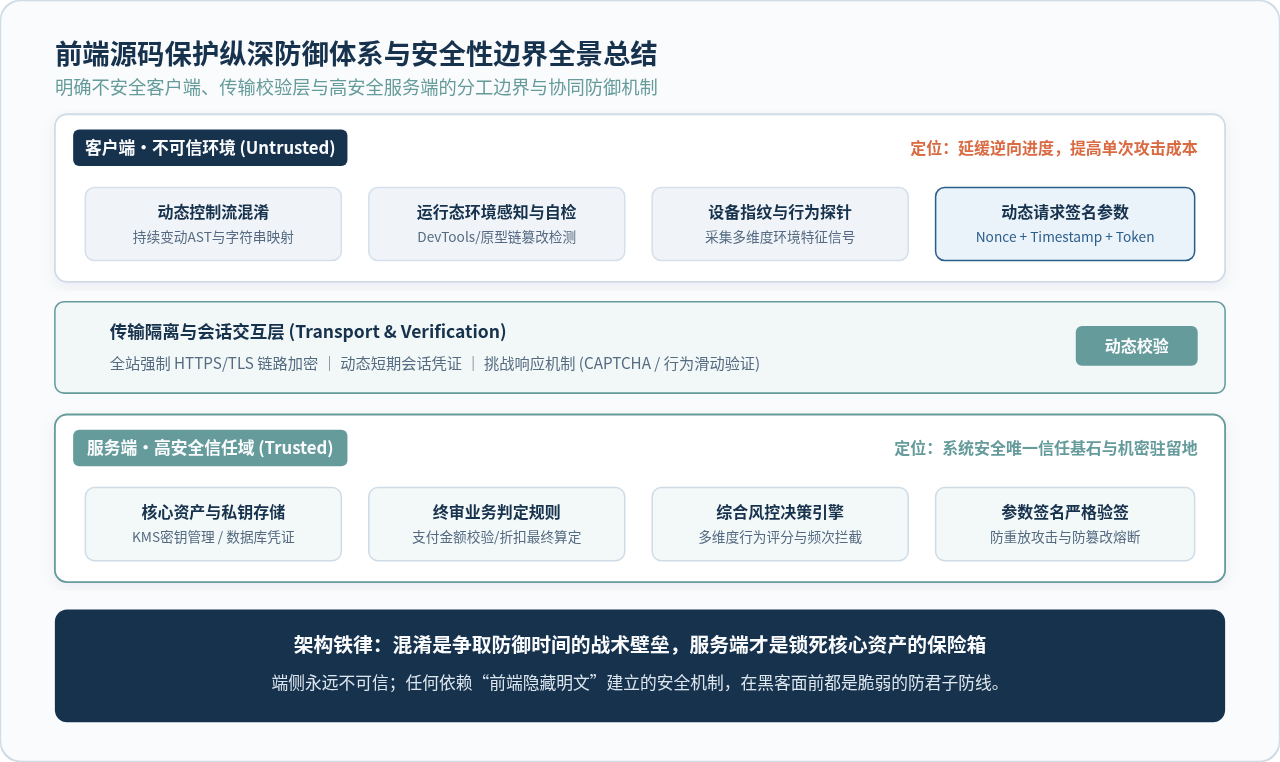
1. 核心业务逻辑与权限终审服务端下沉
真正的安全资产必须完全封锁在服务端。前端仅作为交互渲染层与状态展示层。例如,电商结算页面可以在前端预估计算折扣展示给用户,但最终订单生成时,后端必须完全基于数据库中的商品价格、活动规则重新计算应付金额,绝不可直接采纳前端上传的 price 字段。
2. 动态参数签名与重放攻击防护机制
为了防止接口被脚本脱离浏览器直接批量调用,业界成熟的方案是采用动态参数签名 + 一次性挑战。以下是一个标准防御签名的实现思路:
// 前端请求签名生成逻辑示例 (配合深度混淆使用)
async function buildSecureHeaders(payload, sessionToken) {
  const timestamp = Date.now();
  const nonce = crypto.randomUUID().replaceAll('-', '');

  // 将参数按字典序拼接:timestamp + nonce + payloadString + sessionToken
  const rawString = `${timestamp}_${nonce}_${JSON.stringify(payload)}_${sessionToken}`;

  // 计算 HMAC-SHA256 签名 (签名算法可放在 Wasm 中或使用动态种子混淆)
  const signature = await calcHMACSignature(rawString);

  return {
    'X-Client-Timestamp': timestamp,
    'X-Client-Nonce': nonce,
    'X-Client-Signature': signature
  };
}
服务端收到请求后进行三重检验:
- 时效性校验:检查
Timestamp与服务器时间偏差是否在合理窗口(如 ±30 秒)内。 - 唯一性防重放:利用 Redis 记录并判断
Nonce是否已存在,防止相同报文被重放攻击。 - 签名一致性:服务端依据用户当前 Session 的通信密钥重新计算签名,如果不一致则立刻拒绝服务。
3. CI/CD 流水线中的动态混淆策略
固定的混淆代码容易被逆向人员写好自动化脚本一劳永逸地破解。在构建流水线中,每次发布部署时都应当随机生成混淆种子(Seed)、动态轮换混淆字典和字符串数组索引。这样即使攻击者今天逆向梳理了某套逻辑,明天更新发布后其自动化逆向规则便会失效,迫使其逆向维护成本呈指数级上升。
4. 挑战式人机验证(CAPTCHA)与行为风控分流
不要让前端单独承担防御重任。将前端采集到的设备指纹、鼠标移动轨迹、页面驻留时长等信号通过混淆上报给后端风控引擎。当风控引擎识别到请求特征异常时,不要直接硬编码拦截,而是下发动态滑动验证码或短信息验证。只有通过挑战的用户才能获取短暂有效的访问凭证。
七、常见认知误区与排查自查清单
| 常见认知误区 | 底层事实与安全隐患 | 正规工程应对建议 |
|---|---|---|
| 误区 1:把代码用 AES 加密,在端侧解密执行就很安全 | 密钥和密文同时交由客户端管理,属于典型的“伪加密”。攻击者 Hook 原生 eval 或 Function 即可秒级捕获全部明文。 |
放弃前端动态解密壳模式。直接采用深度 AST 控制流混淆,或针对复杂计算使用 WebAssembly 提升逆向成本。 |
| 误区 2:只要用了商业混淆加壳,接口参数就不需要校验了 | 混淆无法阻止黑客抓包。攻击者甚至无需逆向代码,只需通过重放请求或参数篡改即可发起攻击。 | 永远不要信任客户端提交的数据。服务端必须强制执行参数合法性校验、权限鉴权与业务数据复算。 |
| 误区 3:代码编译成了 WebAssembly,黑客就完全没办法了 | Wasm 二进制虽然去除了高级语言语义,但依然能被反汇编成 WAT 文本或导入 IDA Pro 进行控制流逆向。 | Wasm 应作为提升计算密集型模块逆向成本的工具,涉及商业核心机密依然需要下沉到服务端处理。 |
| 误区 4:反调试定时器能彻底封死 DevTools | 逆向者可以通过拦截构造函数、修改控制台代理或使用自动化逆向环境直接抹掉 debugger 代码。 | 反调试仅用于拖延初级分析者的步调,切忌将其作为系统安全的核心防线。 |
JS节流在搜索框和滚动事件中的应用示例
2026-11-05 22:45:00
解决 Konva.js 常见报错:坐标系统混淆与内存泄漏排查
2026-11-05 22:35:28
怎么逆向分析网站请求中的JS加密参数
2026-11-05 21:34:25
JS 单例模式会导致内存泄漏吗?闭包引用陷阱与排查方法
2026-11-05 17:29:14
JS reduce实战:数组去重、扁平化与分组统计
2026-11-05 13:05:36