JS格式化HTML代码出现标签嵌套错乱怎么修复
深入分析JavaScript格式化HTML代码时出现标签嵌套错位、缩进阶梯式右移、兄弟节点被吞入内部的根本原因,提供包含Void空标签与状态机分词的零依赖修复方案及生产级AST解析指南。
<tag> 都当成需要配对闭合的容器标签,完全忽略了 HTML5 规范中的空元素(Void Elements)以及属性内部合法的特殊符号。要从根本上修复这个缺陷,必须在格式化逻辑中引入空标签判定表与状态栈机制,或者直接切换至基于抽象语法树(AST)的分词解析工具。
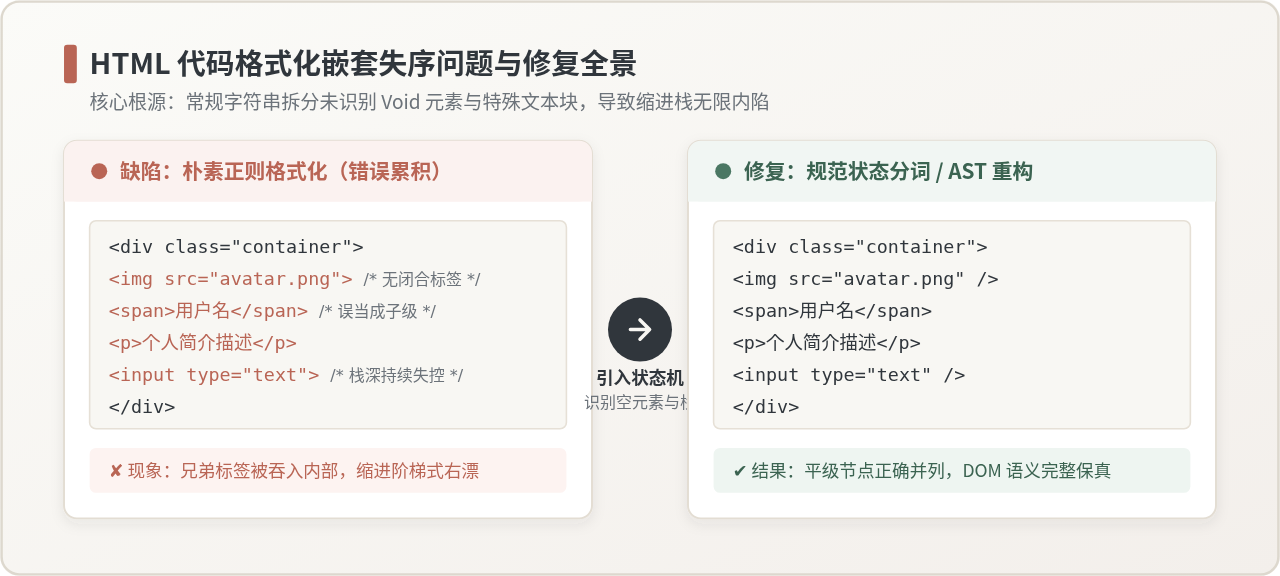
一、故障表现:典型的嵌套错乱长什么样
编写前端代码生成器、在线富文本编辑器或调试工具时,开发者常倾向于用两三行简易的正则表达式来“美化”HTML 字符串。然而,在处理包含图片、表单控件或复杂属性的代码片段时,输出结果往往会出现不可接受的语义崩塌。
最典型的错乱场景如下所示,输入一段原本结构平级的语义化 HTML 代码:
<!-- 原始输入:img 与 span、input 为平级兄弟节点 -->
<div class="user-card">
  <img src="avatar.jpg" alt="用户头像">
  <span>张三</span>
  <input type="text" name="nickname" value="默认昵称">
  <button>保存</button>
</div>
经过粗糙的格式化算法处理后,输出的代码却变成了层层嵌套的“楼梯式”缩进:
<!-- 常见错误格式化结果:发生阶梯式深度泄露 -->
<div class="user-card">
  <img src="avatar.jpg" alt="用户头像">
    <span>张三</span>
      <input type="text" name="nickname" value="默认昵称">
        <button>保存</button>
</div>
在上述错误结果中,<span> 被当成了 <img> 的子节点,而 <input> 又被缩进到 <span> 内部。若该格式化输出被传给代码展示区或二次渲染引擎,阅读者和代码检查器都会直接判定 HTML 存在语法嵌套逻辑错误。
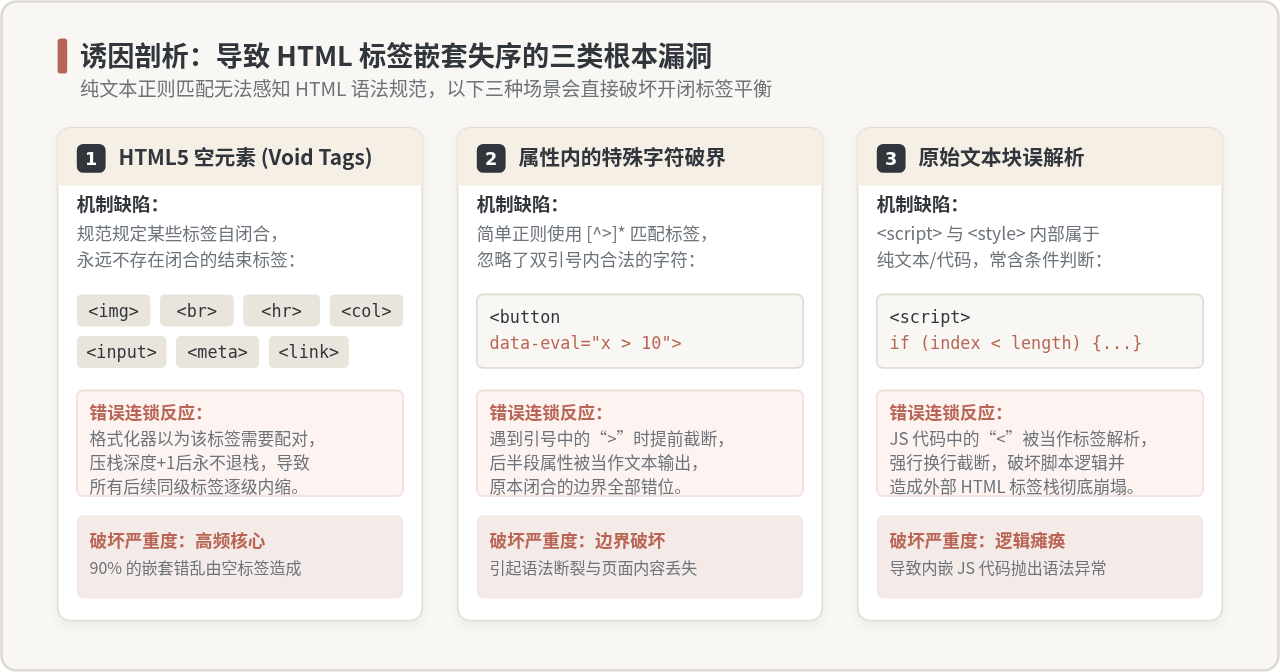
二、根因剖析:为什么简单正则替换必然引发嵌套崩溃
许多开发者使用如下所示的经典简易正则算法来计算标签缩进深度:
// 存在典型嵌套缺陷的朴素格式化代码(反面教材)
function badFormatHTML(html) {
  let indent = 0;
  return html
    .replace(/>\s*</g, '>\n<') // 标签间强行换行
    .split('\n')
    .map(line => {
      if (line.match(/^<\//)) {
        indent = Math.max(0, indent - 1); // 闭合标签减小缩进
      }
      const pad = '  '.repeat(indent);
      if (line.match(/^<[^/]/) && !line.endsWith('/>')) {
        indent++; // 只要是开标签且不以 /> 结尾,就盲目增加缩进
      }
      return pad + line;
    })
    .join('\n');
}
这段代码表面上符合逻辑,但在面对现实网页代码时必然全面溃败,原因集中在以下三个致命盲区:
1. HTML5 规范规定的“空元素”(Void Elements)
HTML5 严格定义了一批 Void Elements,包括 <area>、<base>、<br>、<col>、<embed>、<hr>、<img>、<input>、<link>、<meta>、<param>、<source>、<track>、<wbr>。
根据 HTML 规范,这些标签在 HTML 语法中不仅不需要配对的闭合标签(如 </img>),而且在规范的 HTML5 源码中即便不写斜杠 /> 也是完全合法的。上述简易正则因未见到 />,便误以为当前开启了一个新的容器,直接执行了 indent++。因为该标签永远不会出现闭合标签来执行 indent--,导致后续所有平级兄弟标签的基准层级永久性陷落在该节点之下。
2. 属性值中的特殊字符拦截
很多属性值中完全合法地包含 > 或 < 符号。例如在自定义数据属性中保存判断条件 <div data-rule="count > 5">,或者在行内绑定的 JSON、模板表达式中存在富文本字符。单纯依靠 /[^>]*/ 匹配开闭标签时,正则引擎在遇到双引号内的第一个 > 时就会提前闭合标签,将属性字符串腰斩,后面的文本则被当作孤立的文本或非法标签,彻底破坏了栈的平衡。
3. 原始文本块(Raw Text Elements)与脚本代码
<script>、<style>、<pre> 和 <textarea> 内部属于特殊容器。在 <script> 内部,JavaScript 代码中极易出现 for (let i = 0; i < len; i++) 等小于号逻辑。如果不将这些块作为特殊上下文隔离,盲目正则替换就会把代码中的 < len; 识别为 HTML 标签,从而引发严重的文本断裂和语法解析错误。
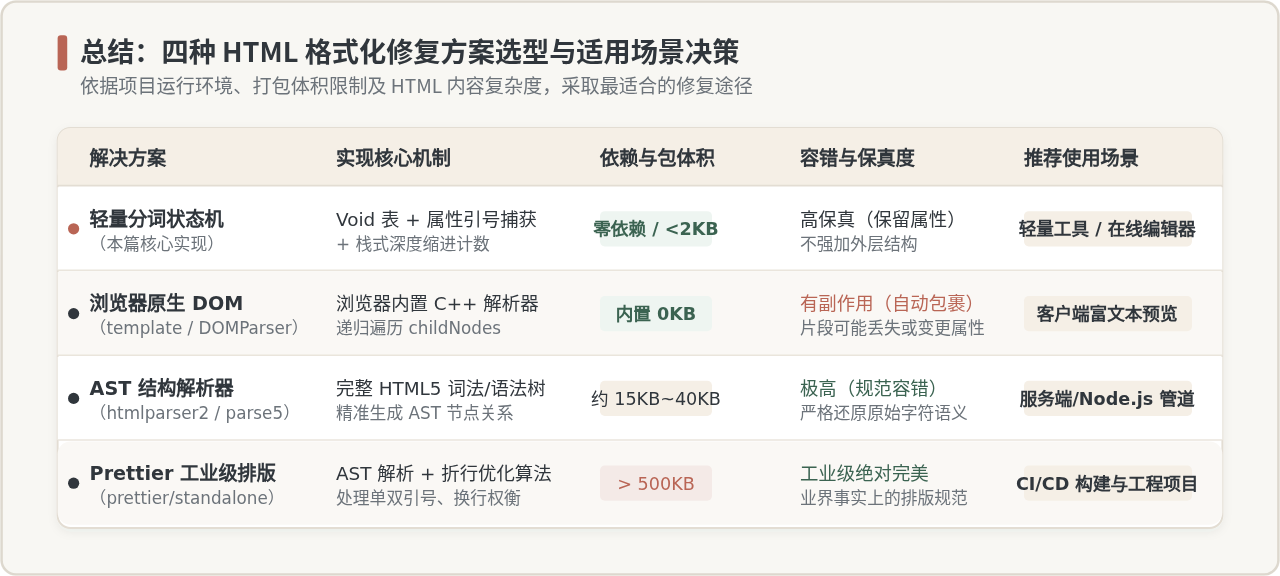
new DOMParser().parseFromString(html, 'text/html') 来先解析再递归格式化。需要注意的是:如果输入的是一个 HTML 局部片段(如仅包含 <tr><td>内容</td></tr>),浏览器会自动将其包裹在 <html><head></head><body><table><tbody> 之中,并在提取 innerHTML 时强行补全外层结构,甚至会滤除某些非规范属性,造成代码语义被动篡改。
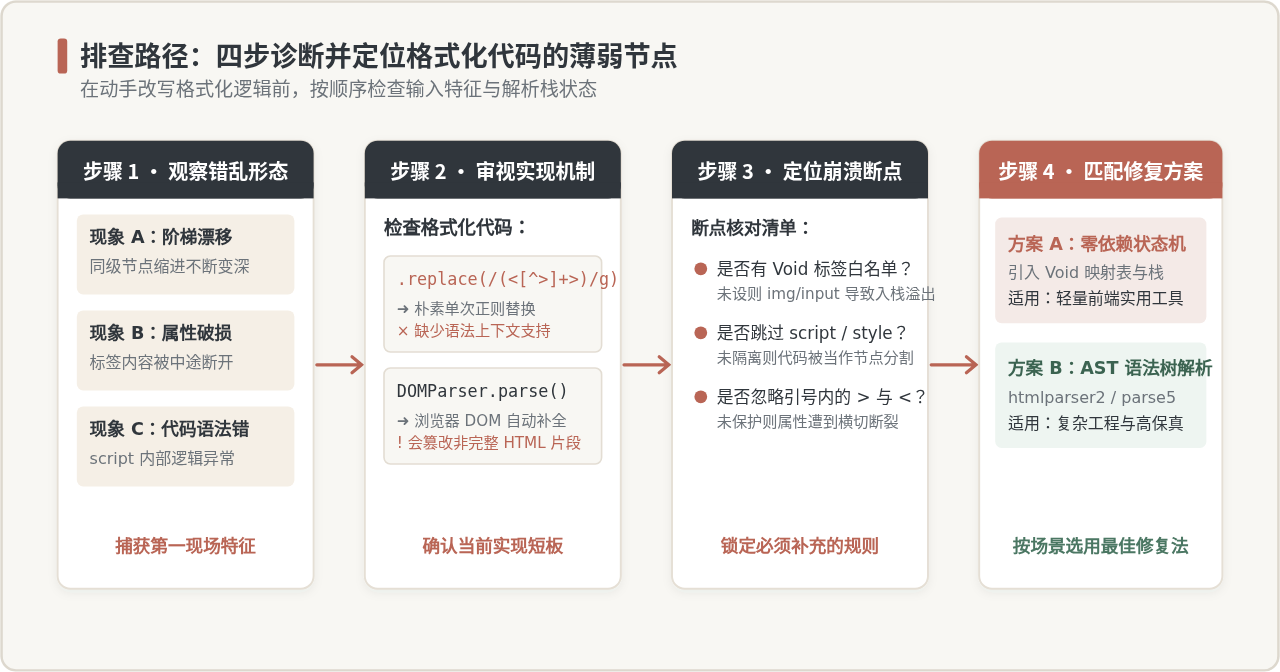
三、诊断步骤:4步准确定位你的格式化缺陷
当发现现有工程或脚本中的 HTML 代码格式化输出出现排版异常时,可依照以下流程精准定位:
- 步骤一:检查错乱起点处的标签类型。 向上追溯格式化错位发生的第一行。如果该行上方紧邻着
<img>、<input>、<br>或<meta>,则 100% 是空元素缺失闭合标记引发的缩进累积。 - 步骤二:检查是否存在复杂属性。 检查前序标签中是否包含带引号的属性(如
placeholder="<请输入>"或data-options='{"a" > 1}')。如果标签在属性处被断行分割,说明正则没有处理引号内的界定符。 - 步骤三:检查内联脚本与样式。 如果错乱发生在包含
<script>或<style>的页面,查看其中的小于号、大于号是否被错误地注入了换行或空格缩进。 - 步骤四:确认运行环境限制。 确认代码运行在纯浏览器前端、Node.js 服务端,还是轻量无依赖的 Web Worker。运行环境将直接决定你是应当手写状态分词,还是引入成熟的 AST 库。
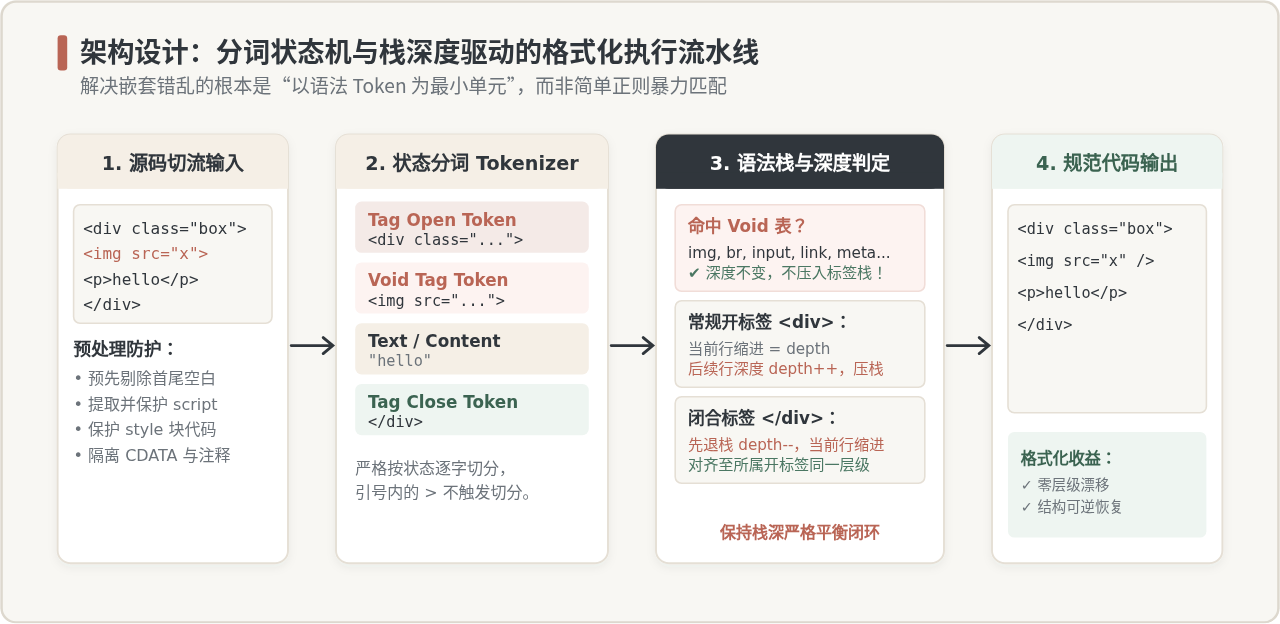
四、修复方案一:手写轻量级分词格式化器(零依赖)
如果你在轻量级前端网页、油猴脚本、无打包工具的纯原生环境中使用,不能引入庞大的第三方 npm 模块,可以通过构建状态感知分词器(Tokenizer)与标签栈(Tag Stack)来彻底解决嵌套错乱。
以下是可直接在任何现代 JavaScript 运行时中执行的完整修复实现:
/**
 * 健壮的轻量级 HTML 格式化器(修复空标签与引号截断)
 * @param {string} html 需要格式化的原始 HTML 字符串
 * @param {string} tab 缩进字符,默认为 2 个空格
 * @return {string} 格式化后的标准 HTML 字符串
 */
function formatHTML(html, tab = '  ') {
  if (!html || typeof html !== 'string') return '';

  // 1. 严格定义 HTML5 Void Elements(不接受子元素、绝不闭合的标签集合)
  const VOID_ELEMENTS = new Set([
    'area', 'base', 'br', 'col', 'embed', 'hr', 'img', 'input',
    'link', 'meta', 'param', 'source', 'track', 'wbr'
  ]);

  // 2. 隔离并保护 <script> 与 <style> 内部内容,防止条件语句中的 < / > 破坏标签栈
  const protectedBlocks = [];
  let sanitizedHTML = html.replace(/<(script|style)[^>]*>([\s\S]*?)<\/>/gi, (match) => {
    protectedBlocks.push(match);
    return `___HTML_PROTECTED_BLOCK_${protectedBlocks.length - 1}___`;
  });

  // 3. 保护 HTML 注释
  sanitizedHTML = sanitizedHTML.replace(/<!--[\s\S]*?-->/g, (match) => {
    protectedBlocks.push(match);
    return `___HTML_PROTECTED_BLOCK_${protectedBlocks.length - 1}___`;
  });

  // 4. 正确拆分 HTML Tokens(安全捕获属性内的引号,不提前被属性值中的 > 截断)
  // 匹配:<!DOCTYPE...> | 闭合标签 </tag> | 开标签 <tag attrs...> | 文本内容
  const tokenRegex = /(<!\w+[^>]*>|<\/[a-zA-Z0-9:-]+>|<[a-zA-Z0-9:-]+(?:\s+[^"'>=\s]+(?:=(?:"[^"]*"|'[^']*'|[^\s"'>]+))?)*\s*\/?>|[^<]+)/g;

  const tokens = [];
  let match;
  while ((match = tokenRegex.exec(sanitizedHTML)) !== null) {
    const val = match[0].trim();
    if (val) tokens.push(val);
  }

  // 5. 遍历 Token 并根据语法状态管理缩进深度
  let indentLevel = 0;
  const resultLines = [];

  for (let i = 0; i < tokens.length; i++) {
    const token = tokens[i];

    // 检查是否为被保护的脚本、样式或注释块占位符
    if (token.startsWith('___HTML_PROTECTED_BLOCK_')) {
      const index = parseInt(token.replace(/\D/g, ''), 10);
      resultLines.push(tab.repeat(indentLevel) + protectedBlocks[index]);
      continue;
    }

    // 判定闭合标签:</tagName>
    if (token.startsWith('</')) {
      indentLevel = Math.max(0, indentLevel - 1);
      resultLines.push(tab.repeat(indentLevel) + token);
      continue;
    }

    // 判定开标签:<tagName ...>
    if (token.startsWith('<') && !token.startsWith('<!')) {
      // 提取标签名(转小写以统一比对)
      const tagNameMatch = token.match(/^<([a-zA-Z0-9:-]+)/);
      const tagName = tagNameMatch ? tagNameMatch[1].toLowerCase() : '';

      const isSelfClosing = token.endsWith('/>');
      const isVoidTag = VOID_ELEMENTS.has(tagName);

      // 输出当前行
      resultLines.push(tab.repeat(indentLevel) + token);

      // 仅当既不是 Void 元素,又不是自闭合标签时,才增加后续缩进深度
      if (!isSelfClosing && !isVoidTag) {
        indentLevel++;
      }
      continue;
    }

    // DOCTYPE 声明或文本节点
    resultLines.push(tab.repeat(indentLevel) + token);
  }

  return resultLines.join('\n');
}
该实现的核心改进在于:
- 建立规范的 Void 元素检索表:当检测到
<img>、<input>等单标签时,判定为不可包含子节点,绝不递增indentLevel,彻底切断右移累加链。 - 属性引号安全保护:采用
=(?:"[^"]*"|'[^']*'|[^\s"'>]+)严密处理属性,属性内的>不会被提前截断。 - 脚本与注释上下文隔离:在分词前先抽取
<script>、<style>并使用唯一占位符替换,排版完成后再原样回填,防止 JS 代码中的运算符破坏 HTML 语义结构。
五、修复方案二:生产级 AST 语法树解析方案
在现代工程化项目(如 Vite、Webpack、Node.js 后端服务或大型前端框架)中,如果需要处理复杂的容错、属性折行和极其严格的代码格式化,建议直接借助成熟的 HTML 语法解析器。
1. Node.js 环境使用 htmlparser2
htmlparser2 是业界速度最快、兼容性极佳的流式 HTML 解析器。它本身具备完整的状态机,可以精准区分开标签、闭标签、空元素和文本节点:
// npm install htmlparser2
import { Parser } from "htmlparser2";

export function formatWithParser(rawHtml, tab = "  ") {
  const VOID_TAGS = new Set([
    "area", "base", "br", "col", "embed", "hr", "img", "input",
    "link", "meta", "param", "source", "track", "wbr"
  ]);

  let depth = 0;
  const output = [];

  const parser = new Parser({
    onopentag(name, attribs) {
      const isVoid = VOID_TAGS.has(name.toLowerCase());
      const attrsStr = Object.entries(attribs)
        .map(([k, v]) => ` ${k}="${v}"`)
        .join("");

      const tagStr = isVoid ? `<${name}${attrsStr} />` : `<${name}${attrsStr}>`;
      output.push(tab.repeat(depth) + tagStr);

      if (!isVoid) depth++;
    },
    ontext(text) {
      const cleanText = text.trim();
      if (cleanText) {
        output.push(tab.repeat(depth) + cleanText);
      }
    },
    onclosetag(name, isImplied) {
      const isVoid = VOID_TAGS.has(name.toLowerCase());
      if (!isVoid && !isImplied) {
        depth = Math.max(0, depth - 1);
        output.push(tab.repeat(depth) + `</${name}>`);
      }
    }
  }, { decodeEntities: true, recognizeSelfClosing: true });

  parser.write(rawHtml);
  parser.end();
  return output.join("\n");
}
2. 使用工业级 Prettier(网页与构建流通用)
如果你的项目目标是对代码质量有严格要求(如集成在在线 IDE 或代码高亮编辑器中),可以使用 prettier/standalone。Prettier 会构造完整的抽象语法树,并依据行宽阈值(printWidth)智能计算最优换行方案:
import prettier from "prettier/standalone";
import parserHtml from "prettier/plugins/html";

export async function prettyHTML(html) {
  return await prettier.format(html, {
    parser: "html",
    plugins: [parserHtml],
    tabWidth: 2,
    useTabs: false,
    printWidth: 80,
    htmlWhitespaceSensitivity: "css"
  });
}
六、方案对比与验证测试
针对不同的业务体量和打包要求,各修复方案的权衡指标如下表所示:
| 方案 | 代码体积 | 环境依赖 | 对 Void 标签支持 | 嵌套准确率 | 适用典型场景 |
|---|---|---|---|---|---|
| 轻量分词状态机 | < 2 KB | 无(纯原生 JS) | 通过 Set 查找表完整支持 | 99%(满足绝大部分场景) | 无外部打包的前端应用、控制台工具 |
| htmlparser2 | ~30 KB | npm 包(Node/Browser) | 原生 AST 事件驱动支持 | 99.9%(符合 HTML 规范) | 服务端渲染(SSR)、静态站点生成器 |
| Prettier | > 500 KB | npm 包 + 插件 | 完整工程级支持 | 100%(工业级最高精度) | 代码编辑器、CI/CD 格式化校验 |
如何验证修复是否成功
在完成代码修复后,使用包含下列“极易触发嵌套错位”的高危测试用例进行验证:
// 关键验收测试用例集合
const testCases = [
  // 1. 连续多个不同类型的 Void 标签并列
  `<div><meta charset="utf-8"><link rel="stylesheet" href="a.css"><h1>标题</h1></div>`,

  // 2. 表单控件与自闭合图像混合
  `<form><img src="x.png"><input type="text"><br><button>提交</button></form>`,

  // 3. 属性中包含大于小于号
  `<span data-eval="count > 10" title="<重要说明>">文本</span>`,

  // 4. 包含内联脚本逻辑
  `<div><script>if (a < b && b > 0) console.log("<div>");</script><p>后置段落</p></div>`
];

testCases.forEach((tc, idx) => {
  console.log(`--- 测试用例 ${idx + 1} ---`);
  console.log(formatHTML(tc));
});
验收标准:检查输出结果中,同属于 <form> 子级的 <img>、<input>、<button> 必须具有完全相同的缩进空格数;同时 <script> 内的代码必须保持完整,其后的 <p> 段落必须与 <script> 平级对齐,未发生意外内嵌。一旦上述用例均能稳定通过,即表明 HTML 标签嵌套错乱问题已得到彻底解决。
javascript下载安装手机版怎么导出成表格文件
2026-11-08 21:31:54
Windsurf编辑器高级设置:插件推荐与快捷键定制
2026-11-07 15:17:19
JS 用位运算判断整数的原理与风险
2026-11-06 19:10:47
React怎么封装Slate.js富文本编辑器并开发自定义插件
2026-11-05 19:03:25
JS字符串转整数:parseInt与Number的区别及适用场景
2026-11-05 18:41:01