JavaScript框架库漏洞怎么正确处理中文字符
本文针对全栈JavaScript框架与开源库中常见的中文编码漏洞,深入分析畸形URI解码崩溃、Unicode等价性走样绕过、UTF-16代理对截断损坏等风险根源,系统梳理从边界解码、规范化、现代正则校验到安全输出的标准处理流水线与实战代码。
\p{Script=Han})与字形簇截断,并在输出端落实严格的上下文安全编码。
一、为什么中文字符会在 JavaScript 框架中诱发漏洞
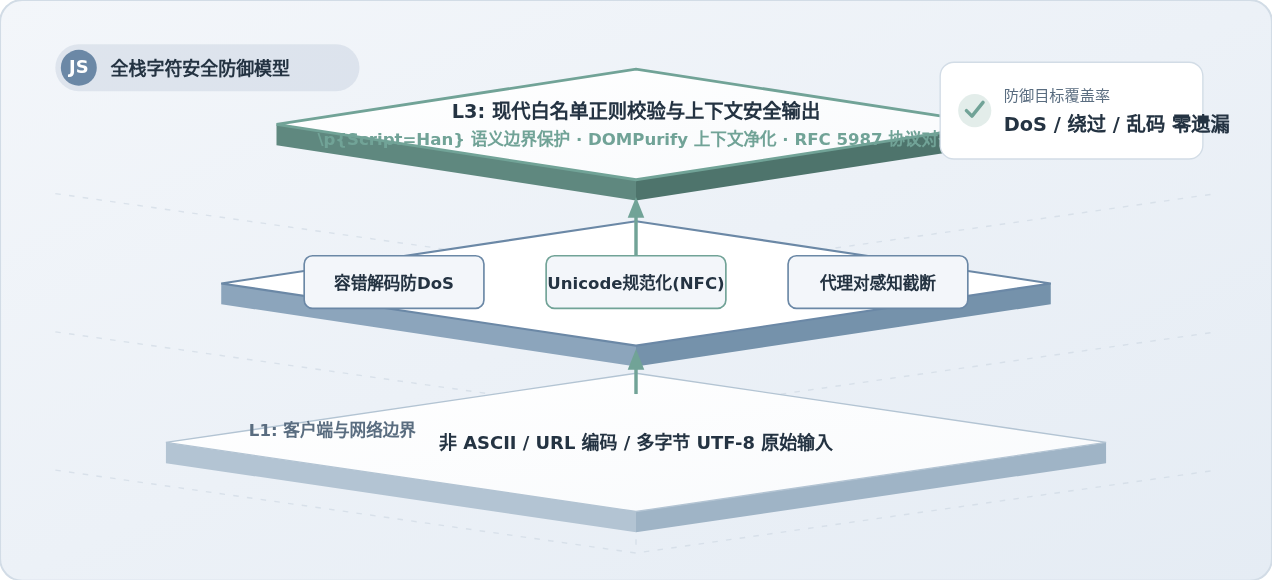
JavaScript 语言原生以 UTF-16 作为内部字符编码模型,而网络传输、HTTP 协议头与底层数据库广泛采用 UTF-8 编码。当开发者在 Express、Koa、Next.js 或各类前后端开源类库中处理非 ASCII 字符时,如果直接套用针对英文环境编写的传统过滤逻辑,就会在多字节转换、字符切片和字符集规范化过程中产生安全缝隙。
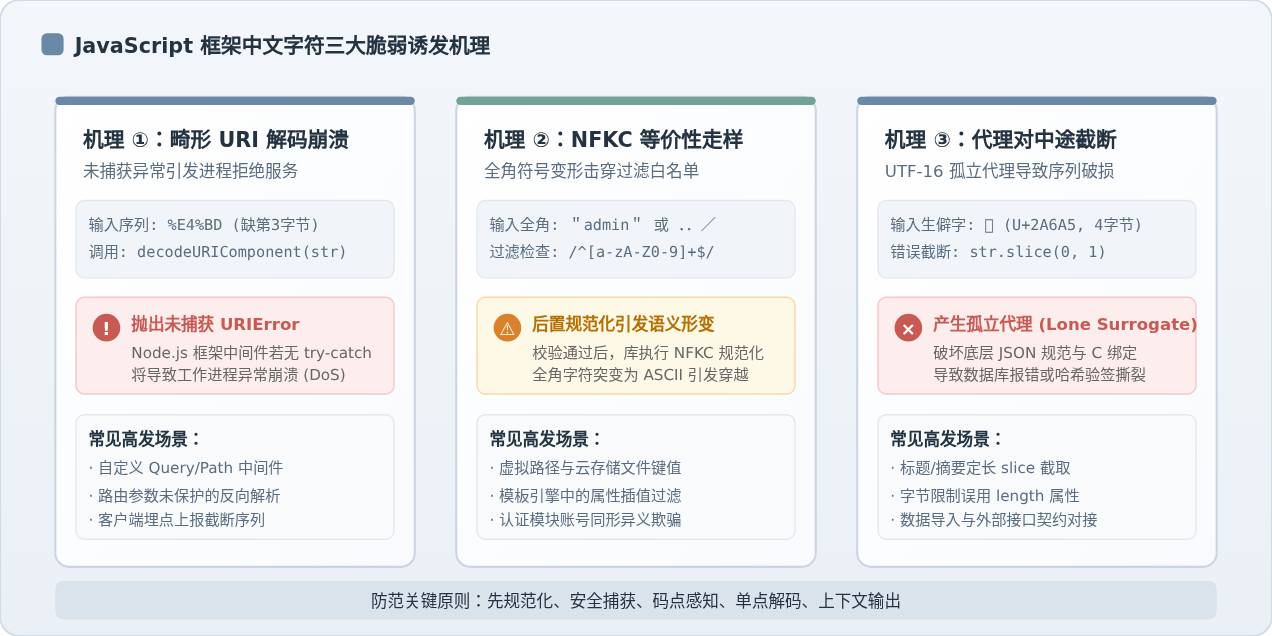
1. 畸形百分号编码引发 URIError 拒绝服务(DoS)
在 UTF-8 编码下,一个标准中文汉字通常占用 3 个字节(例如“中”字的十六进制序列为 %E4%B8%AD)。如果在网络传输截断、前端未正确编码或攻击者故意发送不完整序列(如 %E4%B8 缺少尾随字节)时,原生 JavaScript 的 decodeURIComponent() 会直接抛出无法自动恢复的 URIError: URI malformed 异常。
如果中间件或路由解析器在调用该函数时未包裹错误捕获机制,该未捕获异常将沿着调用栈一路向上传播,直接导致 Node.js 单线程工作进程崩溃退出。若黑客持续并发发送畸形多字节片段,即可使整套 Web 服务瘫痪。
2. Unicode 等价性与 NFKC 规范化走样绕过
Unicode 允许同一字符存在多种等价编码形式。例如中文全角标点、全角英文字符(如全角斜杠 / U+FF0F、全角点 . U+FF0E、全角双引号 " U+FF02)。
部分框架安全中间件为了防范路径穿越或 SQL/NoSQL 注入,首先基于 ASCII 字符正则(例如 /\.\./ 或 /[/'"]/)过滤输入;然而在后续业务逻辑或底层数据库驱动中,为了消除字符样式差异,调用了 str.normalize('NFKC')(兼容性规范化)。此时,全角 ../ 会被直接映射蜕变为标准 ASCII 的 ../,从而使原本通过了白名单校验的参数在后端突变为高危穿越路径。
3. UTF-16 代理对(Surrogate Pairs)截断与孤立代理
JavaScript 字符串的 .length 属性返回的是 UTF-16 代码单元(Code Units)的数量,而非视觉可见字符数或 Unicode 码点数。常规常用汉字(基本多语言平面 BMP)占用 1 个代码单元(length=1);但生僻汉字(如 CJK 扩展区汉字“𪚥”U+2A6A5、“𬌗”U+2C317)以及部分中文异体字位于辅助平面,由一对高位代理(High Surrogate: 0xD800~0xDBFF)和低位代理(Low Surrogate: 0xDC00~0xDFFF)组成,其 length 为 2。
如果业务代码使用 str.slice(0, 10) 或 str.substring() 进行标题、备注或用户名的定长截断,一旦切分点恰好落在代理对中间,就会产生半个残缺的“孤立代理字符(Lone Surrogate)”。孤立代理不仅在前端渲染为乱码菱形符号(),在旧版 Node.js 或特定 JSON 解析器中更会引发序列化异常,甚至击穿底层 C++ 扩展插件的内存边界。
二、中文字符安全防御的 5 步标准操作流线
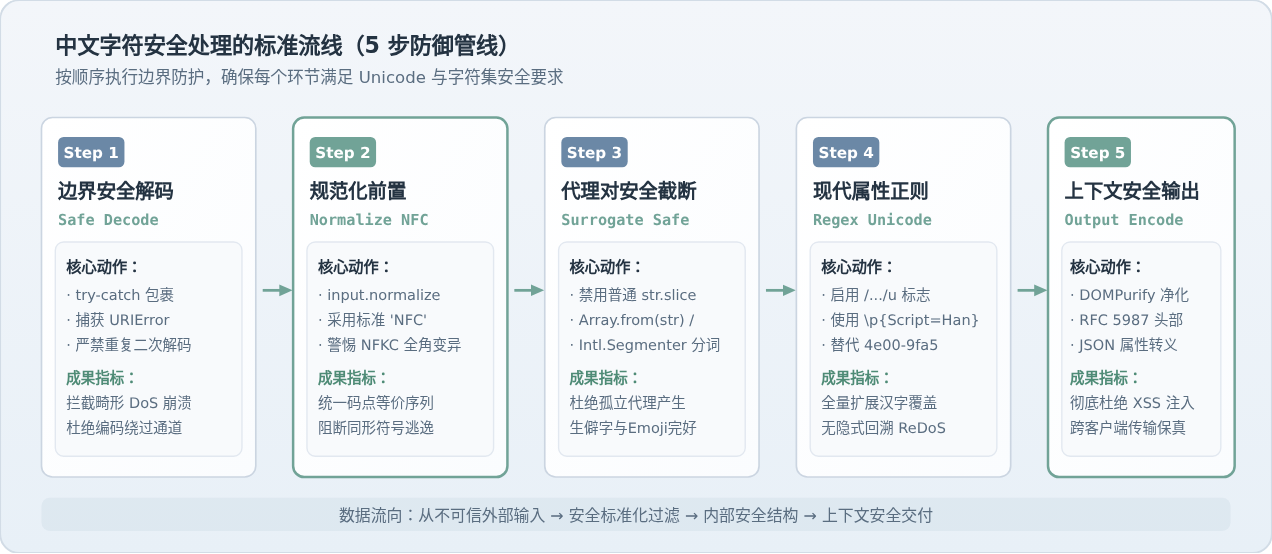
要在全栈 JavaScript 框架中稳健防御中文字符引发的漏洞,必须建立一套标准化的数据入参防护管道。该流水线遵循“边界单次解码 → 规范化前置 → 代理对感知截断 → 现代属性校验 → 上下文安全输出”的操作次序。
步骤 1:边界安全捕获与容错解码(Safe Decoding)
在任何路由参数、查询字符串(Query)或表单内容进入核心业务逻辑前,必须在边界处进行安全解码包装,防止畸形编码引发 URIError 拒绝服务攻击,同时坚决避免不同中间件之间发生“二次解码(Double Decoding)”。
/**
 * 安全的 URI 解码包装器:杜绝 URIError 导致的进程崩溃
 * @param {string} input 待解码字符串
 * @param {string} fallback 解码失败时的安全回退默认值
 * @returns {string} 解码后的安全字符串
 */
function safeDecodeURIComponent(input, fallback = '') {
  if (typeof input !== 'string') return '';
  try {
    // 单次严格解码
    return decodeURIComponent(input);
  } catch (err) {
    // 捕获畸形百分号编码,记录安全告警并降级
    console.warn('[Security] 捕获到畸形编码输入,已安全阻断:', input);
    return fallback;
  }
}decodeURIComponent,攻击者即可通过 %252e%252e%252f 构造二次解码绕过。必须在系统架构中明确规定:全链路只在最外层网关或入参解析中间件处执行一次权威解码。
步骤 2:前置 Unicode 规范化(Normalize Before Validate)
安全领域的核心准则为:“永远先规范化,后执行白名单校验”。必须确保进入校验逻辑的字符串与最终落库、执行比对的字符串是完全相同的内存表示。
对于常规中文字符串(如用户昵称、评论正文),推荐采用 NFC(标准正规化形式 C,Canonical Composition)。NFC 能将组合字符(基字符 + 独立注音标点)合并为单一预组字符,统一 macOS(默认倾向 NFD 组合字)与 Windows/Linux 之间文件名及汉字的异构问题。
/**
* 字符串输入预处理:执行标准 NFC 规范化并剔除隐蔽控制字符
* @param {string} str 原始输入
* @returns {string} 规范化后的安全文本
*/
function normalizeChineseInput(str) {
if (!str) return '';
// 1. 统一正规化为 NFC
let normalized = str.normalize('NFC');
// 2. 剥离用于同形异义欺骗的零宽字符(Zero-width space、Joiner等)
// 包含: (零宽空格), (零宽非连接符), (零宽连接符), (BOM头)
normalized = normalized.replace(/[\u200B-\u200D\uFEFF]/g, '');
return normalized;
}NFKC 会将全角字符(如 <、>、/、.)强制转换为半角 ASCII 字符。如果你的业务后续需要解析文件路径或执行命令,切勿对可能包含路径或指令的参数直接执行 NFKC,否则全角符号会在通过非 ASCII 正则校验后突变成危险字符。
步骤 3:基于码点与字形簇感知的分词与截断
在限制中文文本长度时,绝不能直接使用 str.slice(0, max)。必须依据应用场景区分“视觉字符数(码点数)”与“底层 UTF-8 存储字节数”。
/**
 * 安全截取中文字符串:基于 Unicode 码点遍历,确保绝不破坏代理对
 * @param {string} str 规范化后的输入字符串
 * @param {number} maxCodePoints 最大允许码点数
 * @returns {string} 截取后的完整字符串
 */
function safeSliceByCodePoint(str, maxCodePoints) {
  if (!str) return '';
  // Array.from 或扩展运算符按 Unicode 码点(Code Point)迭代,而非 UTF-16 单元
  const codePoints = Array.from(str);
  if (codePoints.length <= maxCodePoints) {
    return str;
  }
  return codePoints.slice(0, maxCodePoints).join('');
}

/**
 * 计算字符串真实的 UTF-8 字节长度(匹配数据库 VARCHAR/TEXT 字节上限)
 * @param {string} str 输入字符串
 * @returns {number} 实际占用的 UTF-8 字节数
 */
function getUtf8ByteLength(str) {
  return new TextEncoder().encode(str).length;
}
步骤 4:启用现代正则脚本属性类 \p{Script=Han}
许多老旧教程推荐使用 [\u4e00-\u9fa5] 匹配汉字,但该范围是二十年前 Unicode 4.0 时代的产物,遗漏了包含数十万字形的海量 CJK 扩展汉字(如生僻字、古籍字、人名地名特有字)。这不仅导致合法用户无法正常输入,还常因开发者被迫放宽校验规则而引入安全漏洞。
现代 JavaScript(ES2018+)原生支持带有 u 标志位的 Unicode 属性转义字符 \p{Script=Han},能完整覆盖所有合规汉字。
// ❌ 脆弱写法:无法匹配生僻字,且遗漏中文标点,易被误判
// const oldRegex = /^[\u4e00-\u9fa5]+$/;

// ✅ 推荐标准写法:使用现代 Unicode 属性转义类并启用 'u' 标志
// 允许中文汉字、全角/中文标点符号、常规数字与常用空格
const CHINESE_TEXT_PATTERN = /^[\p{Script=Han}\p{Punctuation}\sA-Za-z0-9]+$/u;

function validateChineseContent(input) {
  const clean = normalizeChineseInput(input);
  return CHINESE_TEXT_PATTERN.test(clean);
}
步骤 5:跨层交付时的上下文安全转义与协议对齐
中文字符在渲染至 HTML 视图、嵌入 URL、放入 JSON 数据体或作为 HTTP 响应头交付时,必须遵循各上下文的安全规范:
- DOM/HTML 富文本渲染:必须使用成熟的 AST 级净化库(如
DOMPurify),对富文本中的中文属性与特殊标记进行净化,禁止直接使用innerHTML或 Vue 的v-html拼接未经处理的内容。 - 文件下载响应头(Content-Disposition):若包含中文文件名,必须遵循 RFC 5987 标准,同时输出 ASCII 安全回退名与编码后的
filename*=UTF-8''...格式,防止浏览器将中文字符截断或解析为 Header 注入。
三、脆弱处理模式与防御模式对照
为了直观展现各技术环节的代码演进,下表与对照图列出了全栈开发中高频出现的脆弱处理方式与标准的防御模式。
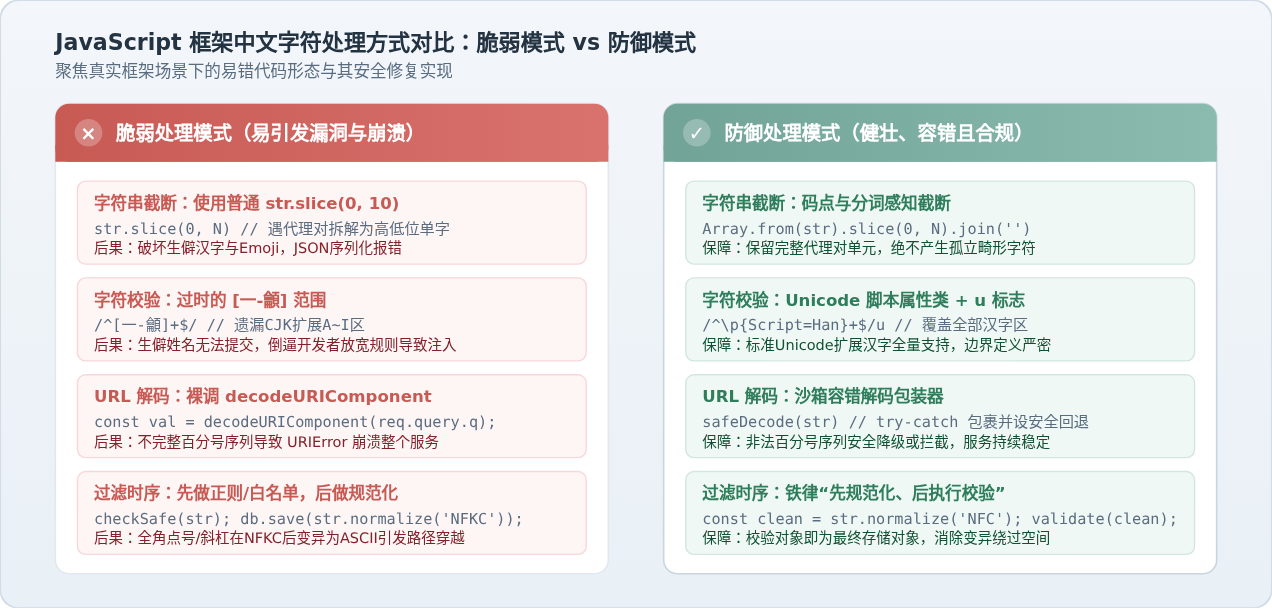
| 处理维度 | 脆弱处理模式(易引发漏洞) | 防御处理模式(健壮且安全) | 安全收益 |
|---|---|---|---|
| URL 解码 | 直接调用 decodeURIComponent(q) |
沙箱包裹 try-catch 捕获 URIError 异常 |
杜绝畸形百分号编码引发单线程 DoS 崩溃 |
| 字符串截断 | 单元截断 str.slice(0, 20) |
码点感知 Array.from(str).slice(0, 20).join('') |
防止截断代理对产生孤立代理字符破坏 JSON |
| 中文正则匹配 | 过时区间 [\u4e00-\u9fa5] |
脚本属性 /^[\p{Script=Han}]+$/u |
全量覆盖 CJK 扩展区生僻汉字,避免误杀与逻辑绕过 |
| 过滤规范化时序 | 后置规范化 先正则白名单过滤,后执行 NFKC |
前置规范化 str.normalize('NFC') 后再做正则校验 |
彻底消除全角符号在后置规范化时变异为 ASCII 穿越符 |
| 文件下载文件名 | 直接拼接 filename="报表.xlsx" |
RFC 5987 filename*=UTF-8''%E6%8A%A5... |
跨浏览器无乱码且阻断 HTTP 响应头注入(CRLF) |
四、典型场景实战修复方案
场景 1:文件上传与下载中的中文路径穿越与乱码
在文件上传场景中,用户提交的文件名可能包含中文,攻击者常用全角斜杠(/)或带编码的换行符尝试绕过目录限制。在下载场景中,中文文件名若直接放入响应头极易乱码或被篡改。
import path from 'path';

// ✅ 文件上传安全处理:提取纯文件名并规范化
export function sanitizeUploadFilename(rawFilename) {
  if (!rawFilename) return 'file_attachment';

  // 1. NFC 规范化
  let safeName = rawFilename.normalize('NFC');

  // 2. 剥离可能存在的全角/半角路径穿越符号
  safeName = safeName.replace(/[\/\\::*??""''<>|]/g, '_');

  // 3. 限制基础路径仅提取基名
  safeName = path.basename(safeName);

  // 4. 控制 UTF-8 真实字节长度不超过 200 字节(留出扩展名裕量)
  const ext = path.extname(safeName);
  const base = path.basename(safeName, ext);
  const truncatedBase = Array.from(base).slice(0, 50).join('');

  return `${truncatedBase}${ext}`;
}

// ✅ 文件下载安全响应头:符合 RFC 5987 国际化标准
export function setContentDisposition(res, chineseFilename) {
  // 过滤控制字符与换行符,防范 CRLF Header 注入
  const cleanName = chineseFilename.replace(/[\r\n\0]/g, '');
  const encodedName = encodeURIComponent(cleanName);

  // 提供 ASCII fallback 与 UTF-8 完整版本
  res.setHeader(
    'Content-Disposition',
    `attachment; filename="download"; filename*=UTF-8''${encodedName}`
  );
}
场景 2:API 签名验证中的 Unicode 形式不一致
在移动端与 Web 端调用同一 Node.js 接口时,macOS/iOS 发送的带有重音或复合符号的中文字符串往往默认为 NFD 形式,而 Windows/Android 默认为 NFC 形式。尽管两者在屏幕上显示完全相同,但底层字节不同。如果不做规范化直接计算 HMAC 签名,会导致接口签名偶发校验失败。
import crypto from 'crypto';

/**
 * 跨平台 API 验签预处理:对参与签名的中文字段执行统一 NFC 规范化
 */
export function buildCanonicalSignString(params) {
  const keys = Object.keys(params).sort();
  const pairs = keys.map(key => {
    let val = params[key];
    if (typeof val === 'string') {
      // 必须统一为 NFC 格式
      val = val.normalize('NFC');
    }
    return `${key}=${val}`;
  });

  return pairs.join('&');
}
五、测试验证方法与全栈自查清单
为了验证系统在处理中文字符时是否具备充足的健壮性,建议在单元测试与 CI/CD 阶段加入针对中文字符特性的模糊测试用例(Fuzzing Test)。
1. 关键测试用例矩阵
- 畸形百分号测试:发送
%E4、%E4%BD、%u4e00等不完整或废弃格式,验证框架中间件是否抛出未捕获URIError,响应码应为规范的400 Bad Request。 - 辅助平面生僻汉字测试:发送包含扩展区汉字(如“𪚥”、“𬌗”)及四字节图文字符的文本,验证定长截取逻辑是否产生
,校验 JSON 输出格式是否合法。 - 全角符号变异测试:发送
../etc/passwd,验证通过参数校验后是否在后续任何调用中被意外转换为路径穿越。 - 不可见字符黑名单绕过测试:在敏感词(如“管理员”)中插入
(零宽空格),验证安全审查机制是否能正确剔除并拦截。
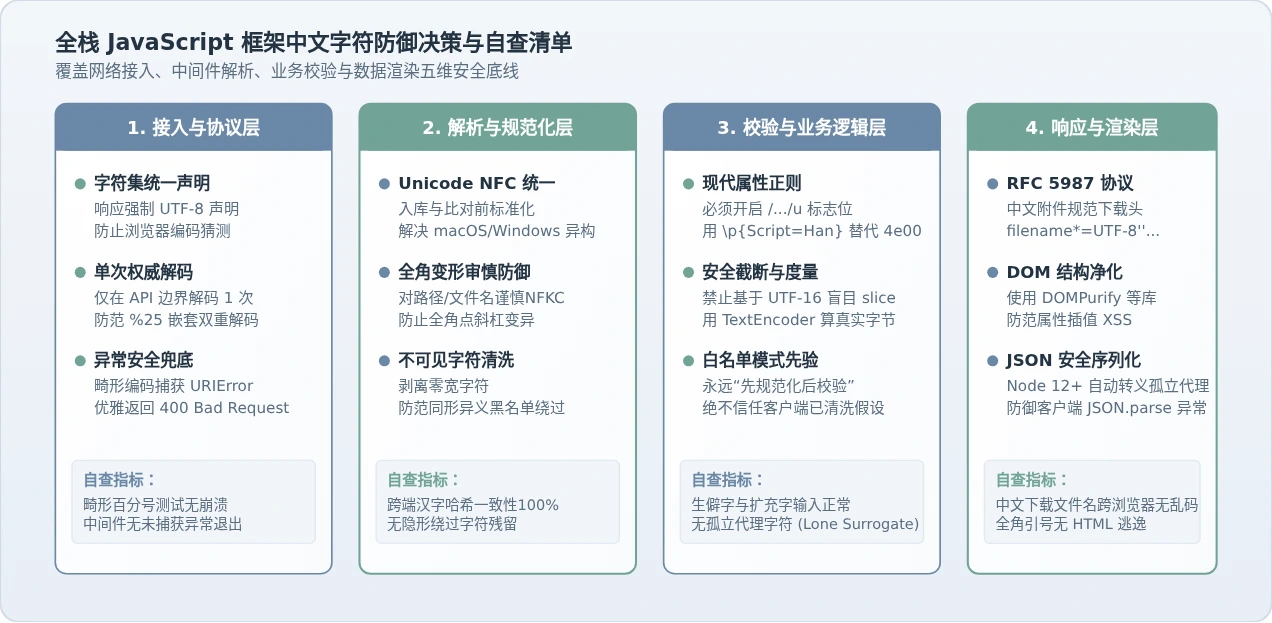
2. 上线前安全自查清单
- 协议层:所有 HTML/JSON 接口的
Content-Type明确指定charset=utf-8,杜绝浏览器回退到 GBK 导致的编码解析混淆。 - 中间件层:所有调用
decodeURIComponent的位置均包裹try-catch,全局错误拦截器正确捕获URIError。 - 逻辑层:凡需入库、比较或哈希签名的字符串,入参首道关卡统一调用
str.normalize('NFC')。 - 校验层:废除
[\u4e00-\u9fa5],全面迁移为/^[\p{Script=Han}...]+$/u现代正则语法。 - 截断层:禁止在包含非 ASCII 文本的变量上使用普通
str.slice(),全面采用Array.from(str)码点截取,使用TextEncoder计算真实数据库字节容量。
javascript下载安装手机版的效果怎么量化评估
2026-11-08 12:34:32
JavaScript框架库漏洞引入第三方库的成本值不值
2026-11-08 09:40:26
JS数组查找性能对比:find、some与includes该选谁
2026-11-05 17:48:00
怎么优化 React 应用性能?避免不必要的重渲染
2026-11-05 12:43:40
怎么利用 Nuxt.js useHead 优化 SEO 与元数据管理
2026-11-05 10:37:58