怎么利用 Nuxt.js useHead 优化 SEO 与元数据管理
深入讲解如何利用 Nuxt.js 中的 useHead 组合式 API 优化前端 SEO 与元数据管理。涵盖全局与页面级配置、响应式数据绑定、Open Graph 与 JSON-LD 结构化数据注入及常见避坑技巧。
在基于 Nuxt.js(Nuxt 3)构建现代 Web 应用时,优化搜索引擎表现(SEO)的核心在于让服务端渲染(SSR)直接输出准确且语义完整的 HTML <head> 标签。Nuxt 3 提供了 useHead 组合式 API,它基于底层的 Unhead 引擎构建,负责集中编排页面的 <title>、<meta>、<link>、规范网址(Canonical URL)以及结构化数据(JSON-LD)。本文将详细梳理从全局基线配置、页面动态数据绑定到高级社交卡片和结构化数据的完整落地方法,帮助读者建立稳定、可维护且避免标签污染的元数据管理体系。
一、Nuxt 3 元数据管理体系与渲染机制
理解 useHead 的工作方式,首先需要明确 Nuxt 3 是如何处理服务端渲染与客户端跳转过程中的标头信息的。在传统的单页应用(SPA)中,页面标题和 Meta 标签往往依赖客户端执行 JavaScript 动态修改 document.title,这会导致多数未运行完整 JS 运行时的爬虫抓取到空白或初始模板内容。而 Nuxt 3 采用了全生命周期的标头管理机制。
Nuxt 3 的元数据管理划分为三个主要层级,各层级之间通过优先级继承与合并:
- 全局配置层(
nuxt.config.ts):定义站点的默认语言、默认标题模板(Title Template)、通用图标(Favicon)及字符集。 - 布局层(
layouts/*.vue):在不同的页面框架中注入通用布局相关的元信息。 - 页面与组件层(
pages/*.vue或子组件):调用useHead或useSeoMeta注入与当前动态内容紧密相关的标题、描述、关键字及社交标签。
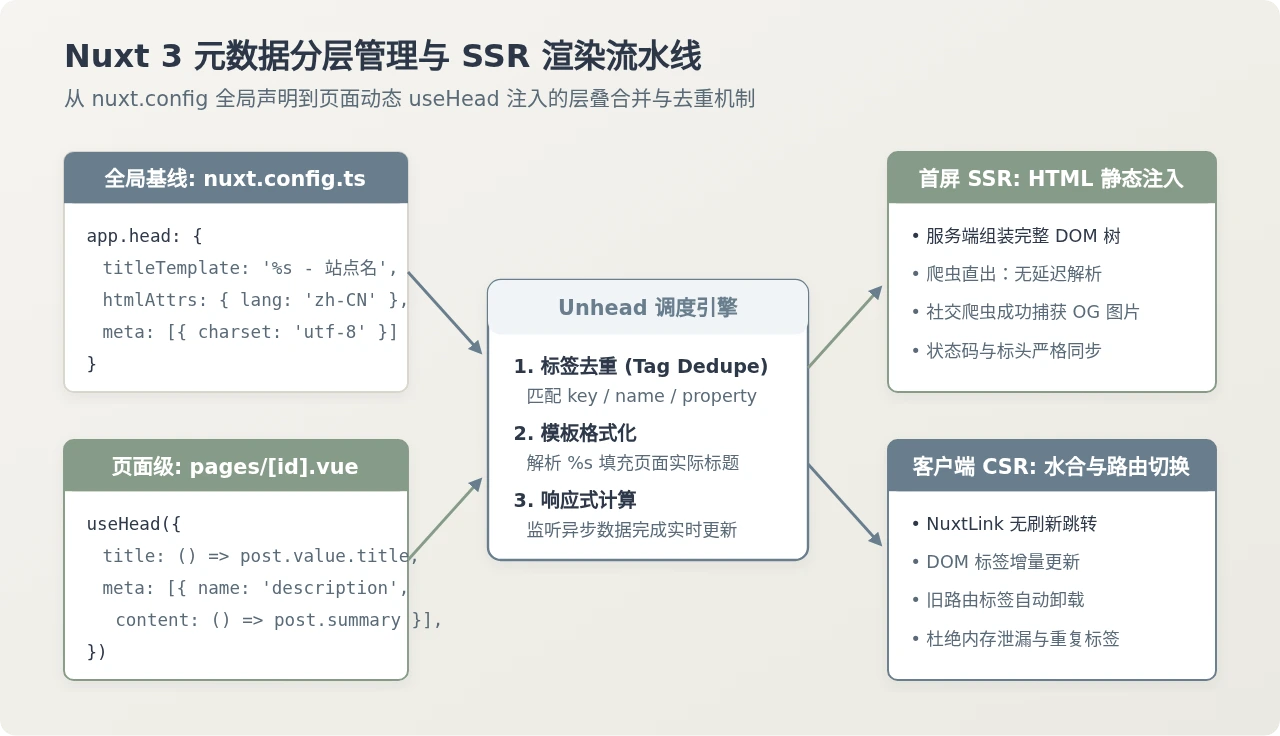
在 SSR 执行阶段,Nuxt 会在服务器环境中执行页面的 setup 逻辑,将 useHead 收集的所有标签转化为静态的 HTML 字符串直接塞入输出的 <head> 区域;当用户在浏览器内点击 <NuxtLink> 进行客户端导航时,Unhead 会自动比对当前路由与上一路由的元数据差异,以微小的 DOM 操作动态替换或卸载对应的 Meta 节点,确保客户端与服务端保持完全一致的行为。
二、核心机制对比:全局静态配置 vs 动态组合式 API
在实际开发中,很多开发者容易混淆 nuxt.config.ts 中的 app.head 与页面中的 useHead()。为了构建清晰的架构,需要在一致的场景下对比两者的核心差异:
| 对比维度 | 全局静态配置 (app.head) | 动态组合式 API (useHead / useSeoMeta) |
|---|---|---|
| 作用范围 | 整站所有页面生效,充当全局基础兜底 | 仅在当前组件/页面生命周期内生效 |
| 数据源特征 | 仅能访问构建期静态数据或固定环境变量 | 可读取异步 API 数据、Route 参数与 Pinia 状态 |
| 响应式支持 | 不支持,不可绑定 Vue 响应式变量(Ref/Reactive) | 原生支持 Getter 函数与 Computed 属性,随状态变化自动同步 |
| 去重处理机制 | 预设静态节点,容易被页面级同名 key 覆盖 | 基于 key 或 name 机制主动覆写全局同名标签 |
| 典型使用场景 | 网站字符集、站点名称前缀/后缀、公共 CSS/Favicon | 文章标题、详情页描述、商品图片 OG 标签、规范网址 |
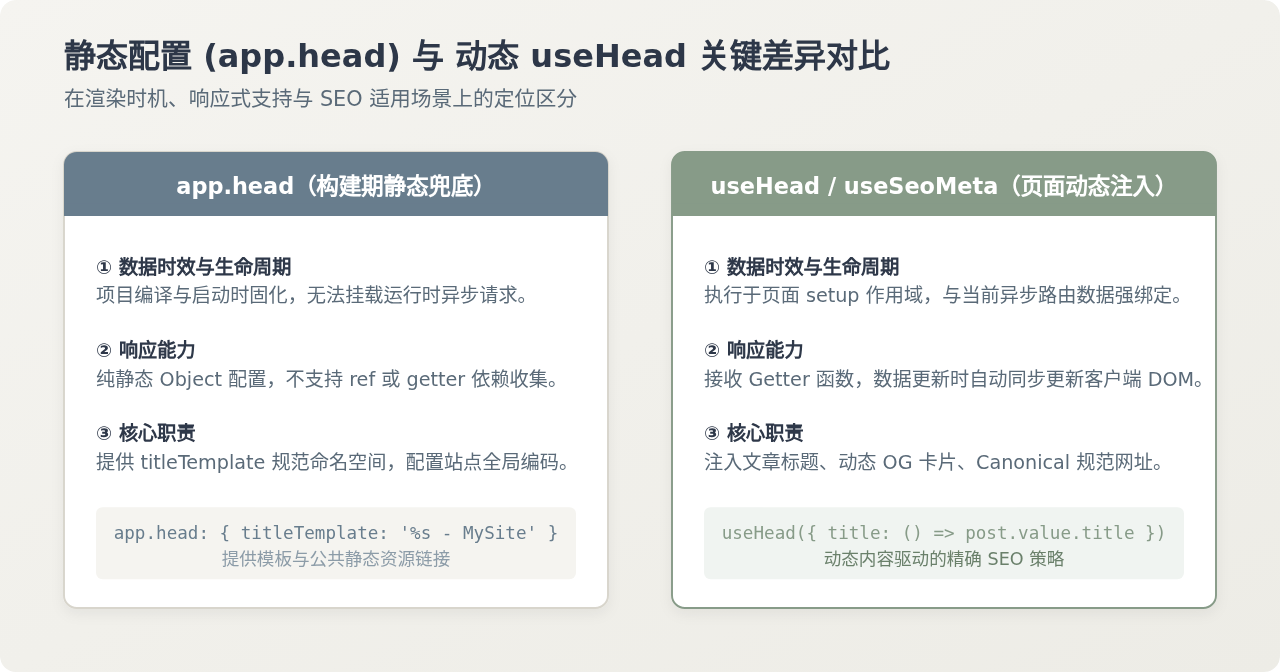
理解这种差异的根本原因在于:搜索引擎爬虫评判的是单个独立 URL 的内容契合度,而非全站通用的默认文字。如果在商品或文章详情页仅依赖全局配置,爬虫抓取到的将永远是静态的站点兜底标题,造成严重的 SEO 页面同质化惩罚。因此,必须将全局配置作为基线,页面级 useHead 作为核心业务实现。
三、操作步骤:基于 useHead 优化 SEO 的五步闭环
在 Nuxt 3 页面中实施 SEO 优化,推荐遵循“基线规范、异步抓取、响应式注入、社交增强、服务端验证”五个具体步骤。
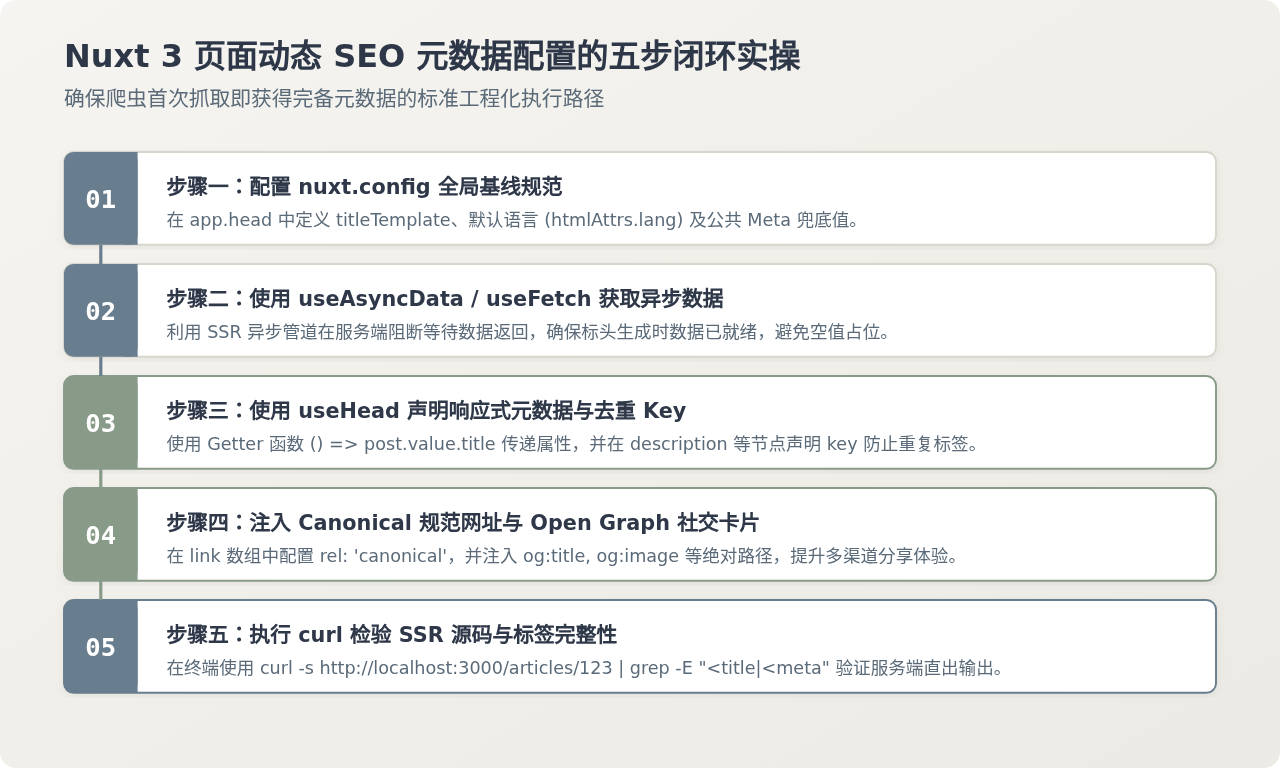
步骤一:在 nuxt.config.ts 中定义全局基线
全局配置的核心在于设定 titleTemplate。利用 %s 占位符,可以在子页面只需声明纯页面名称时,自动拼接上品牌后缀,保证全站标题结构高度统一。
// nuxt.config.ts
export default defineNuxtConfig({
  app: {
    head: {
      // %s 会被子页面的 title 替换
      titleTemplate: '%s - 技术文档知识库',
      title: '首页',
      htmlAttrs: {
        lang: 'zh-CN'
      },
      meta: [
        { charset: 'utf-8' },
        { name: 'viewport', content: 'width=device-width, initial-scale=1' },
        { name: 'format-detection', content: 'telephone=no' },
        // 全局默认兜底描述
        { key: 'description', name: 'description', content: '专注于现代 Web 技术与工程化实践的知识库。' }
      ],
      link: [
        { rel: 'icon', type: 'image/x-icon', href: '/favicon.ico' }
      ]
    }
  }
})
步骤二与三:页面动态数据拉取与 useHead 响应式绑定
在动态路由页面(例如 pages/posts/[id].vue)中,通过 useFetch 或 useAsyncData 获取内容。需要特别注意的是:传递给 useHead 的动态属性必须使用 Getter 函数(箭头函数)包裹,或者传入 computed 计算属性。若直接传递原始值(如 post.value?.title),在 SSR 初始化尚未完成响应式赋值时,useHead 只会读取到 undefined 且无法在数据返回后重新计算。
<script setup lang="ts">
// pages/posts/[id].vue
interface Post {
  id: string
  title: string
  summary: string
  keywords: string[]
  coverImage: string
  publishedAt: string
}

const route = useRoute()
const config = useRuntimeConfig()

// 1. 异步获取详情数据(在 SSR 期间阻断直到数据就绪)
const { data: post, error } = await useFetch<Post>(`/api/posts/${route.params.id}`)

// 错误边界处理
if (error.value || !post.value) {
  throw createError({ statusCode: 404, statusMessage: '文章不存在或已下架', fatal: true })
}

// 2. 动态注入 SEO 元数据
useHead({
  // 匹配全局 titleTemplate: "Nuxt 3 useHead 深度指南 - 技术文档知识库"
  title: () => post.value?.title,
  meta: [
    {
      // 关键:提供 key: 'description',确保覆盖全局兜底的同名 meta,避免重复存在
      key: 'description',
      name: 'description',
      content: () => post.value?.summary
    },
    {
      key: 'keywords',
      name: 'keywords',
      content: () => post.value?.keywords?.join(',')
    },
    // Open Graph 社交卡片
    {
      property: 'og:title',
      content: () => post.value?.title
    },
    {
      property: 'og:description',
      content: () => post.value?.summary
    },
    {
      property: 'og:image',
      // 注意:SEO 图片必须使用带域名的绝对 URL
      content: () => `${config.public.siteUrl}${post.value?.coverImage}`
    },
    {
      property: 'og:type',
      content: 'article'
    }
  ],
  link: [
    // 注入规范网址(Canonical Link),避免多参数引起的重复内容惩罚
    {
      rel: 'canonical',
      href: () => `${config.public.siteUrl}/posts/${route.params.id}`
    }
  ]
})
</script>

<template>
  <article v-if="post">
    <h1>{{ post.title }}</h1>
    <p>{{ post.summary }}</p>
  </article>
</template>关键规则:在 meta 数组中添加带有特定意义的属性(如 description、keywords)时,一定要显式定义 key: 'description'。因为 Unhead 默认仅对 title 实施单一实例替换,对于 meta 标签,只有显式指定相同 key 时,当前页面的配置才会完整覆盖父级(或全局)的对应标签;否则,输出的 HTML 中将同时存在两个 description,对搜索引擎造成干扰。
步骤四:注入 JSON-LD 结构化数据
现代搜索引擎(尤其是 Google 和百度搜索)对 Schema.org 的结构化数据(JSON-LD)依赖极高。借助结构化数据,搜索引擎可以呈现富搜索结果(Rich Snippets),如文章作者、发布时间、面包屑导航以及 FAQ。在 useHead 中注入 JSON-LD 可以通过 script 选项实现:
// 在 useHead 中追加结构化数据
useHead({
  script: [
    {
      type: 'application/ld+json',
      children: computed(() => JSON.stringify({
        '@context': 'https://schema.org',
        '@type': 'TechArticle',
        headline: post.value?.title,
        description: post.value?.summary,
        image: `${config.public.siteUrl}${post.value?.coverImage}`,
        datePublished: post.value?.publishedAt,
        author: {
          '@type': 'Person',
          name: '前端工程师'
        },
        publisher: {
          '@type': 'Organization',
          name: '技术文档知识库',
          logo: {
            '@type': 'ImageObject',
            url: `${config.public.siteUrl}/logo.png`
          }
        }
      }))
    }
  ]
})
步骤五:结果验证与检查
完成编码后,不能仅在 Chrome 浏览器中右键“检查元素”来判断 SEO 是否生效。因为浏览器 DevTools 的 Elements 面板展示的是 DOM 树当前内存状态(即使由客户端 JS 渲染也会显示)。正确的验证方法是:
- 使用终端发送 HTTP 请求检查原始响应体:
# 检查返回的 HTML 源码中是否已经包含服务端注入的 title 和 meta curl -s http://localhost:3000/posts/101 | grep -E "<title|<meta name=\"description\"|rel=\"canonical\"" - 在浏览器中右键点击“查看网页源代码”(快捷键
Ctrl+U/Cmd+Option+U),搜索关键标签是否存在。 - 在浏览器禁用 JavaScript 后重新刷新页面,确认页面标题与主要 Meta 标签是否完好保留。
四、useHead 与 useSeoMeta 的选型协同
Nuxt 3 在后续演进中引入了 useSeoMeta 组合式 API。部分开发者产生困惑:useHead 是否已经被替代?实际上,两者是面向不同维度的互补工具,其差异与搭配策略如下:
useSeoMeta的优势:纯扁平化对象、自带强类型校验。它直接为title、description、ogTitle、twitterCard等 100 多个标准 SEO 字段提供了驼峰命名属性,无需再手动书写{ property: 'og:title', content: ... }这样冗长的数组嵌套对象,在编译期即可拦截拼写错误。useHead的不可替代性:useSeoMeta只负责处理标准的 Meta 标签,而useHead负责整个<head>容器。诸如<link rel="canonical">、<html lang="...">属性设置、<script type="application/ld+json">结构化数据,依然必须使用useHead。
// 最佳协作实践:组合使用 useSeoMeta 与 useHead
<script setup lang="ts">
// 使用 useSeoMeta 处理标准 SEO 字段,类型提示极佳
useSeoMeta({
  title: () => post.value?.title,
  description: () => post.value?.summary,
  ogTitle: () => post.value?.title,
  ogDescription: () => post.value?.summary,
  ogImage: () => `${config.public.siteUrl}${post.value?.coverImage}`,
  twitterCard: 'summary_large_image'
})

// 使用 useHead 处理非 Meta 资源(Canonical 网址与结构化数据)
useHead({
  link: [
    { rel: 'canonical', href: () => `${config.public.siteUrl}/posts/${post.value?.id}` }
  ],
  script: [
    { type: 'application/ld+json', children: () => schemaJson.value }
  ]
})
</script>
五、最佳实践与排查避坑清单
在长期维护大型 Nuxt 3 项目时,以下四类问题最易导致 SEO 表现降级或服务器内存异常:
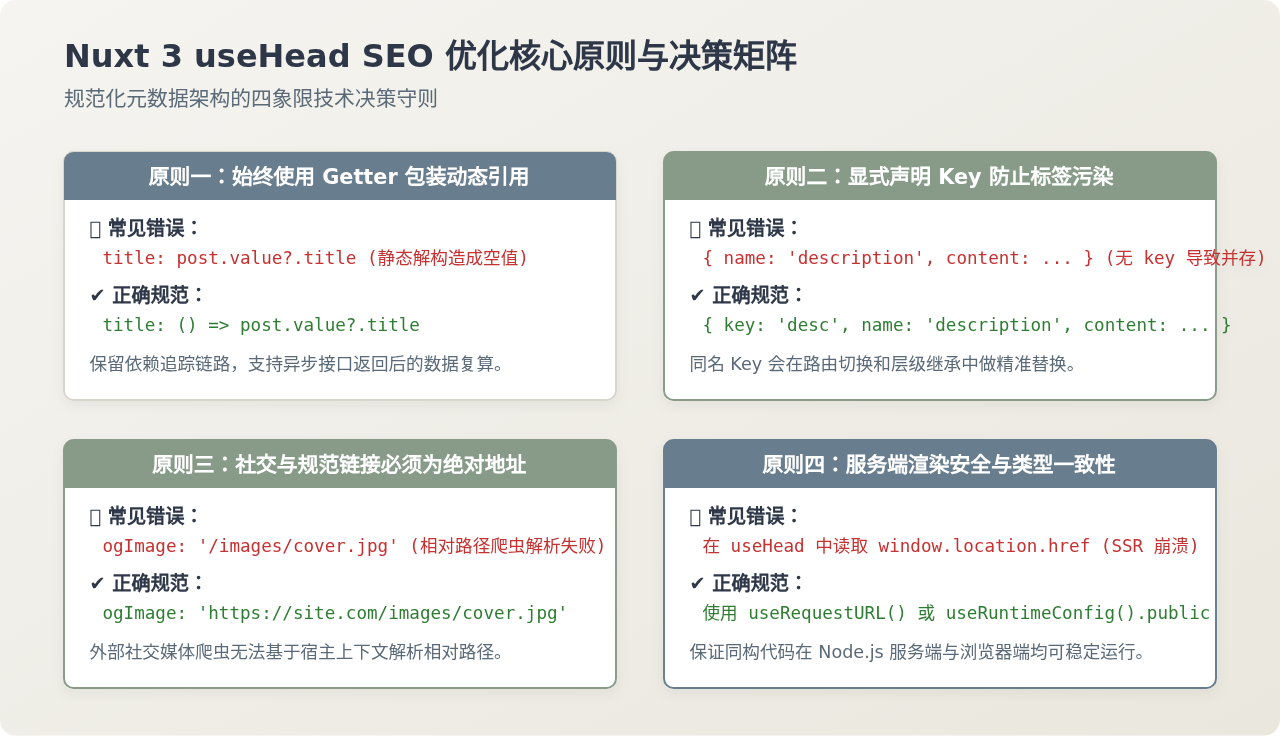
1. 警惕 SSR 环境下的 window / document 访问
在配置 Canonical URL 或 og:url 时,开发者有时会误写 window.location.href。在 Nuxt 3 的 SSR 阶段,代码运行于 Node.js 运行时,根本不存在 window 全局对象,这会直接抛出 ReferenceError: window is not defined 导致页面 500 崩溃。应改用 Nuxt 提供的 useRequestURL() 组合式函数安全获取当前请求的完整 URL:
const url = useRequestURL()

useHead({
  link: [
    { rel: 'canonical', href: () => url.href }
  ]
})
2. 避免在 onMounted 中调用 useHead
onMounted 钩子函数仅在客户端浏览器完成 DOM 挂载后才会执行,服务端渲染阶段会完全跳过 onMounted。如果将 useHead 写在 onMounted 内部,服务端输出的初始 HTML 中将没有任何页面专属的 SEO 标头,直接丧失 SSR 的 SEO 价值。useHead 必须直接处于 <script setup> 的顶层作用域中执行。
3. 标题模板中避免双重后缀
如果在 nuxt.config.ts 中配置了 titleTemplate: '%s - 我的博客',子页面中的 useHead({ title: '文章名 - 我的博客' }) 会被拼接为 文章名 - 我的博客 - 我的博客。解决办法是在子页面仅传入纯净的页面标题:title: '文章名';若个别特殊页面(如独立活动专题页)需要完全自定义且禁用模板,可传入空模板或函数:
// 针对当前页面禁用全局 titleTemplate
useHead({
  title: '双十一特惠专题大促',
  titleTemplate: null // 覆盖全局模板,直接输出纯标题
})
六、总结
在 Nuxt.js 中优化 SEO 与元数据管理,关键在于理清 app.head 全局基线与 useHead / useSeoMeta 页面动态注入的分工。通过在服务端请求生命周期内绑定响应式 Getter,辅以明确的 key 去重机制与结构化数据注入,可以确保搜索引擎爬虫在首屏即抓取到完整、准确且规范的标头信息,为整站的自然搜索排名与社交化分发打下坚实的工程基础。
怎么优化 React 应用性能?避免不必要的重渲染
2026-11-05 12:43:40
JS混淆常见手段解析:字符串加密与控制流平坦化还原思路
2026-11-04 19:07:42
JavaScript能在浏览器中直接获取MAC地址吗
2026-11-03 20:34:17
JavaScript策略模式:用对象映射替代if-else分支
2026-11-03 19:46:11
使用import()动态导入实现JS模块按需重载
2026-11-03 19:44:58