Nuxt.js 数据获取指南:useFetch 与服务端预取最佳实践
深入解析 Nuxt 3 中 useFetch 的底层运行机制、双端注水原理与核心参数配置,提供服务端预取、Payload 瘦身、响应式监听与常见避坑的最佳工程实践。
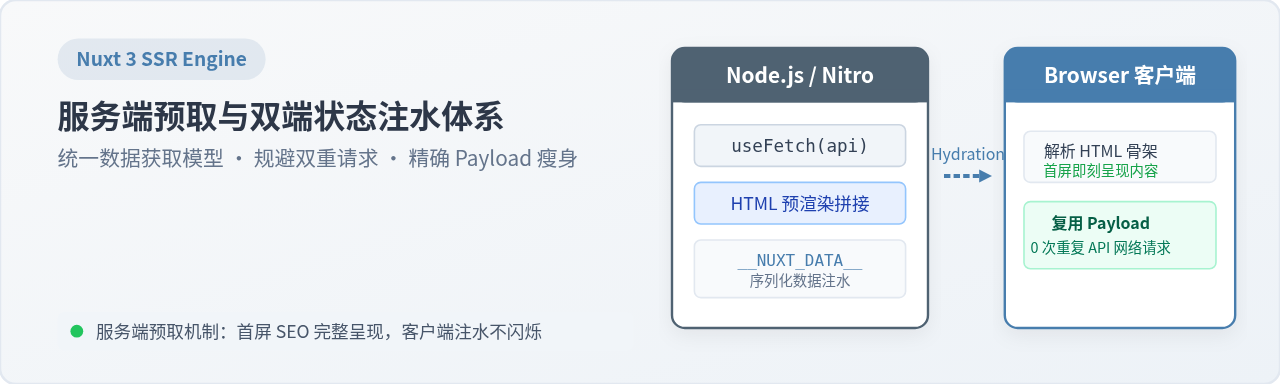
useFetch 是 Nuxt 3 内置的核心组合式 API,它并非简单的 fetch 语法糖,而是封装了 useAsyncData 与底层跨环境请求器 $fetch 的状态管理利器。本文将深入拆解其双端执行逻辑、参数编排步骤与生产级避坑实践。
一、useFetch 运行原理:为何服务端渲染需要预取?
传统的单页面应用(SPA)在浏览器加载空白 HTML 与 JavaScript 脚本后,由客户端在 onMounted 周期中发起 Ajax 请求拉取数据。这种模式存在两项天然弊端:搜索引擎爬虫无法抓取异步加载的内容,且用户必须经历“白屏加载中”的等待延迟。
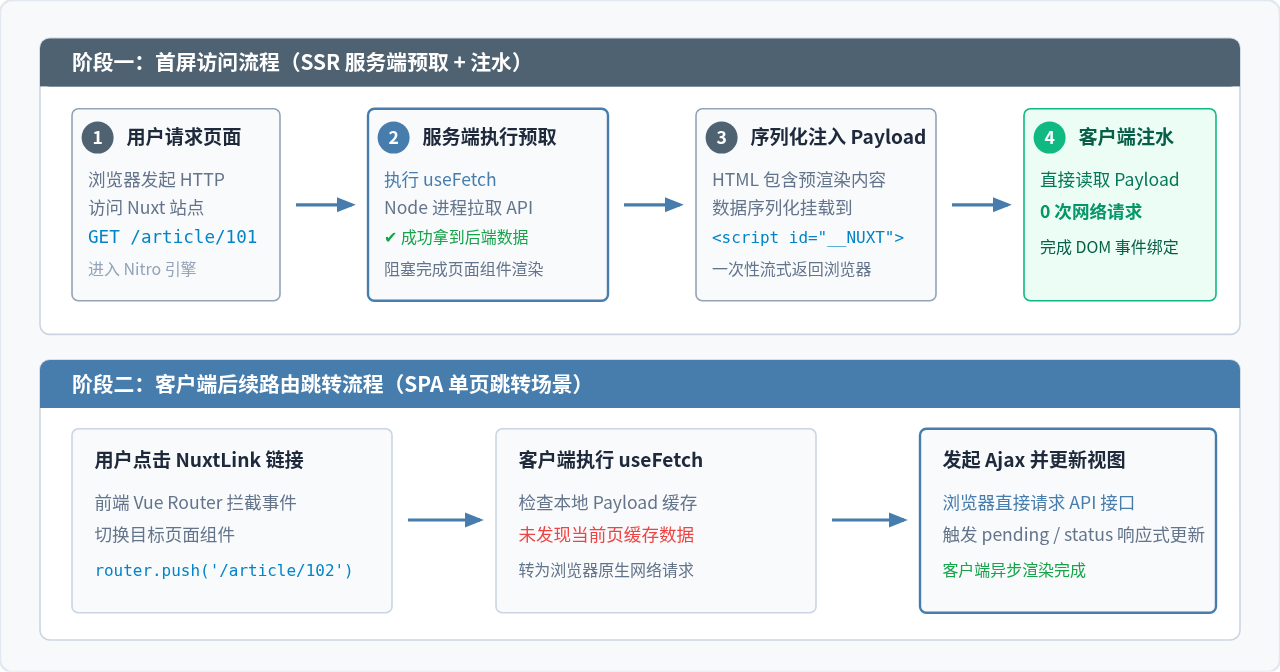
在 Nuxt 3 的 SSR 模式下,组件在服务端启动阶段即开始执行初始化逻辑。如果直接使用未经包装的常规 HTTP 库发起请求,由于浏览器接收到 HTML 并执行客户端脚本时同样会重新走一遍组件逻辑,将不可避免地导致双重请求(Double Fetching):一次发生在 Node.js 服务器,一次发生在用户浏览器。
useFetch 彻底解决了这一问题。它通过将数据挂载在全局唯一的 key 标识下,在服务端预取成功后将结果序列化存入 Nuxt 运行时载荷(payload.data)。当浏览器加载页面时,客户端 useFetch 会优先拦截并检查 payload.data 是否存在该 key 的缓存数据,直接读取内存结果,跳过重复的网络 I/O。
二、useFetch 核心配置与标准使用步骤
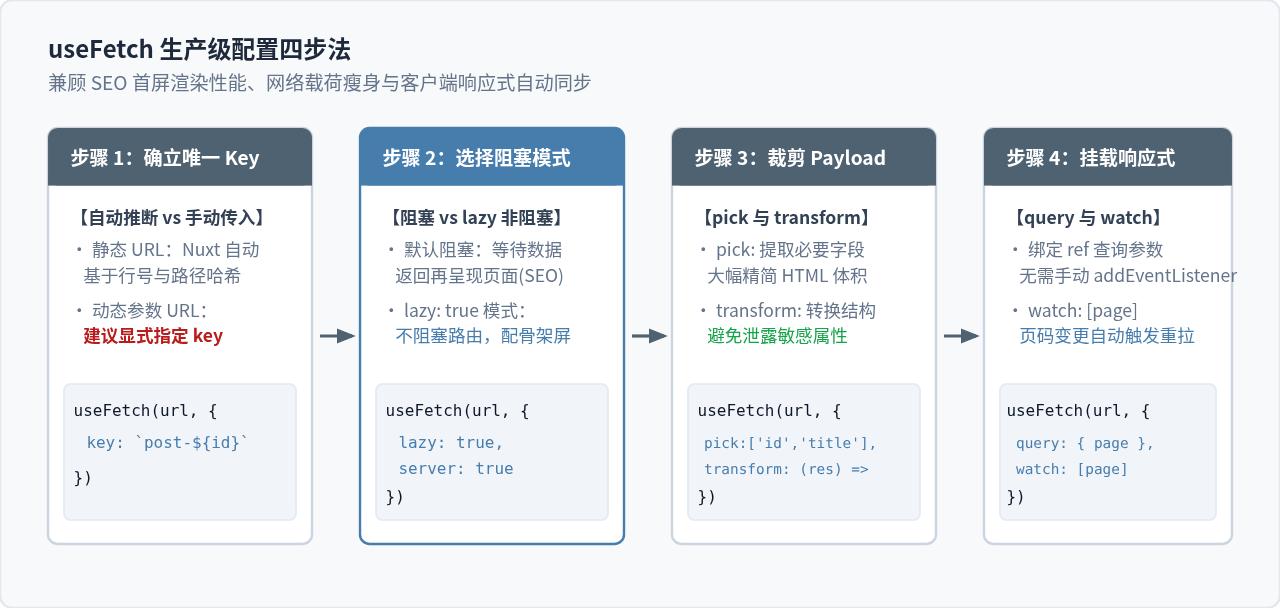
在 Nuxt 3 页面或组件的 <script setup> 中,获取数据最推荐的形式是直接调用 useFetch。编写一个稳定、高效的数据获取模块,需要按照如下 4 个步骤进行参数编排。
完整代码示例:分页文章列表获取
下面是一个在 Nuxt 3 页面中获取分页文章列表的完整单文件组件示例,演示了 Key 绑定、响应式查询参数联动以及加载状态解构:
<!-- pages/posts.vue -->
<script setup lang="ts">
interface Post {
  id: number
  title: string
  excerpt: string
  author: string
}

interface PostResponse {
  list: Post[]
  total: number
}

// 1. 定义响应式参数
const route = useRoute()
const currentPage = ref(Number(route.query.page) || 1)

// 2. 使用 useFetch 获取数据
const {
  data: postsData,
  pending,
  error,
  refresh
} = await useFetch<PostResponse>('/api/v1/posts', {
  // 显式指定缓存 key,确保不同页码的缓存独立隔离
  key: `posts-page-${currentPage.value}`,
  // 传递响应式 query,参数更新时底层自动生成新请求
  query: {
    page: currentPage,
    limit: 10
  },
  // 裁剪字段:只向下游下发 UI 实际绑定的属性,减小 HTML 体积
  pick: ['list', 'total'],
  // 监听页码响应式变量变化
  watch: [currentPage],
  // 请求失败时的默认兜底空数据
  default: () => ({ list: [], total: 0 })
})
</script>

<template>
  <main class="post-container">
    <div v-if="pending" class="loading-skeleton">正在加载文章列表...</div>
    <div v-else-if="error" class="error-message">
      获取数据失败:{{ error.message }}
      <button @click="() => refresh()">重试</button>
    </div>
    <ul v-else>
      <li v-for="item in postsData?.list" :key="item.id">
        <h3>{{ item.title }}</h3>
        <p>{{ item.excerpt }}</p>
      </li>
    </ul>
  </main>
</template>
三、API 选型与分工:useFetch、useAsyncData 与 $fetch
Nuxt 3 提供了三个极其相似的数据获取相关工具:useFetch、useAsyncData 和 $fetch。很多初学者经常感到混淆,在不合适的场景随意套用,导致状态丢失或服务端报错。
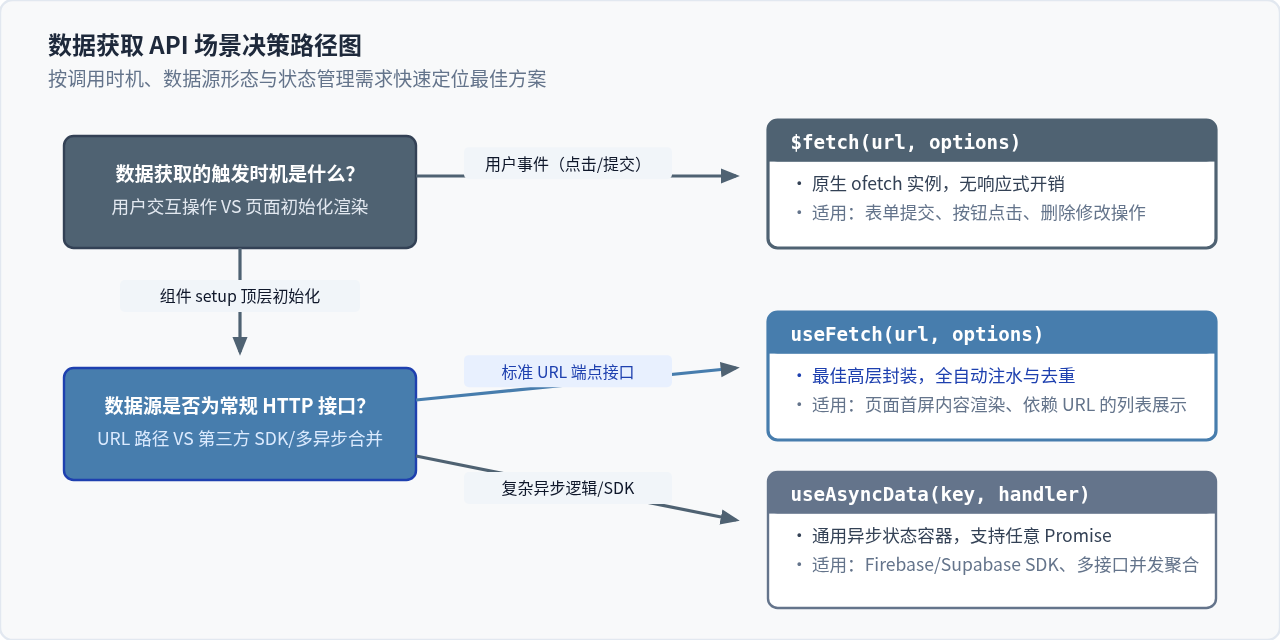
| 特性 / API | useFetch | useAsyncData | $fetch |
|---|---|---|---|
| 调用场景 | 组件 setup 顶层(页面首屏数据) | 组件 setup 顶层(复杂异步数据源) | 事件回调函数(点击、提交等) |
| 返回值类型 | 响应式对象(data, pending, error) |
响应式对象(data, pending, error) |
原始 Promise<T> 结果 |
| SSR Payload 注水 | 自动注水,避免双端重复请求 | 自动注水,需显式声明 Key | 无(若在 setup 中直接执行将导致双端请求) |
| 底层实质 | useAsyncData(key, () => $fetch(...)) |
Nuxt 核心异步状态桥梁 | 基于 ofetch 的跨端轻量 HTTP 客户端 |
四、常见陷阱与避坑指南
在 Nuxt 3 实际项目中,由于对 Composition API 和双端生命周期的理解偏差,开发者经常踩入以下四大高频陷阱:
1. 严禁在事件监听器或生命周期钩子中调用 useFetch
useFetch 是一个组合式 API,必须在 Vue 组件的 setup() 同步阶段调用,以便 Nuxt 将其注入当前实例的上下文并收集依赖。切勿在 @click、onMounted 或异步回调中调用 useFetch。
错误写法:const onSubmit = async () => { await useFetch('/api/save') }
这样调用会导致 Nuxt 无法追踪组件上下文,出现 Nuxt instance is unavailable 错误或内存泄漏。
正确解法:在事件处理或非同步 setup 环境中,始终直接使用 $fetch('/api/save', { method: 'POST' })。
2. 忽略动态 Key 导致路由切换时数据串号
当在 pages/article/[id].vue 等动态路由页面中使用 useFetch 时,Nuxt 会根据当前代码的位置生成一个静态 Hash 作为默认 Key。如果用户从 /article/1 导航至 /article/2,由于组件被复用且 Key 相同,useFetch 会错误命中先前的 Payload 缓存,导致页面展示上一篇文章的内容。
规避方案:对于动态路由或依赖外部参数的请求,必须通过字符串模板将动态唯一标识传入 key 配置,例如:key: `article-${route.params.id}`。
3. 未做 Payload 瘦身导致 HTML 膨胀与敏感信息泄露
在 SSR 阶段,后端接口返回的整个对象都会被完整序列化,以 JSON 格式内联到 HTML 的 <script id="__NUXT_DATA__"> 标签中。如果接口返回了包含 50 个冗余字段或包含用户邮箱、手机号等敏感信息的大对象,会导致生成的 HTML 体积剧增,同时带来严重的数据安全风险。
规避方案:
合理使用 pick 与 transform 属性。
pick: ['id', 'title', 'cover']:只挑选模板渲染所需的字段注入 Payload;transform: (data) => data.map(item => ({ id: item.id, name: item.name })):在服务端对原始数据执行清洗重组后再入库。
4. 服务端 Cookie 与认证信息丢失
当 Nuxt 服务端(Node.js 环境)向内部 API 网关发起请求时,它本质上是一个独立的 HTTP 客户端,默认不会自动携带浏览器传递过来的 Cookie 或 Authorization 请求头。这会导致在 SSR 阶段直接返回 401 未授权错误。
规避方案:
使用 useRequestHeaders 将当前客户端请求头透传给服务端接口:
// 在 setup 中获取当前请求携带的 Cookie 并转发给后端
const headers = useRequestHeaders(['cookie', 'authorization'])

const { data: userProfile } = await useFetch('/api/user/profile', {
  headers
})
五、服务端预取最佳实践与工程化规范
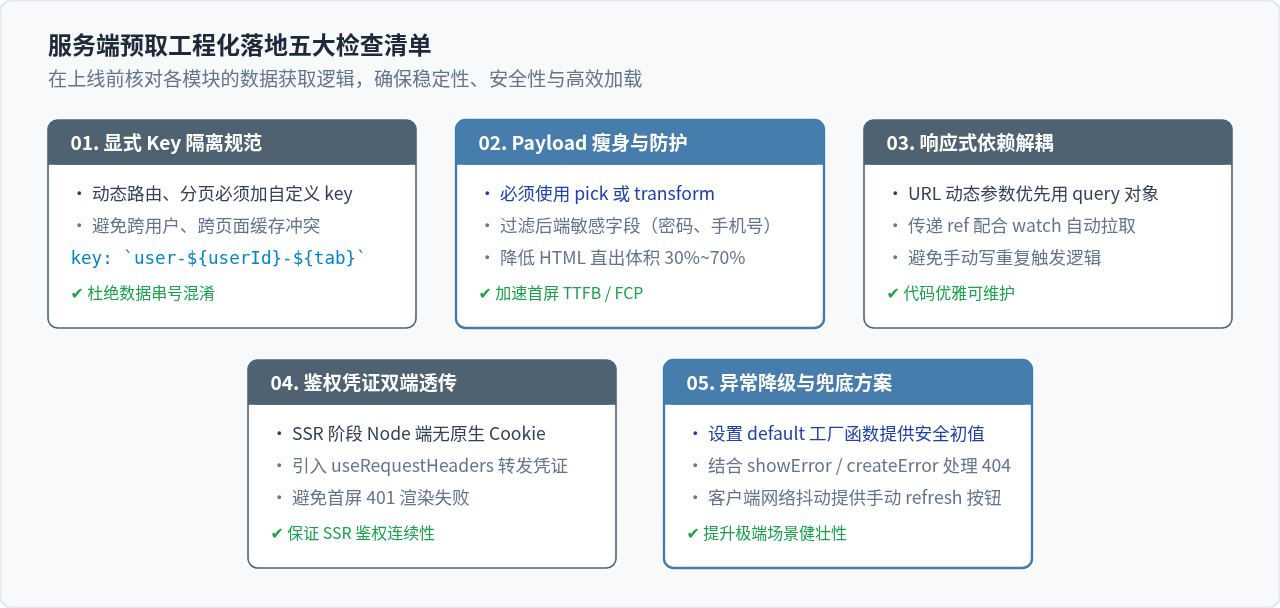
为了在复杂项目中保持高可维护性与极致的用户体验,建议团队落地以下五项核心工程规范:
组合式 API 业务封装范式
为了避免在每个页面中重复编写相似的 useFetch 样板代码,推荐将通用业务逻辑抽离为自定义 Composable 函数:
// composables/useArticleApi.ts
export const useArticleDetail = (articleId: Ref<string | number>) => {
  const headers = useRequestHeaders(['cookie'])

  return useFetch(() => `/api/articles/${articleId.value}`, {
    key: `article-detail-${articleId.value}`,
    headers,
    pick: ['id', 'title', 'content', 'updatedAt'],
    watch: [articleId],
    onResponseError({ response }) {
      if (response.status === 404) {
        throw createError({ statusCode: 404, statusMessage: '文章不存在', fatal: true })
      }
    }
  })
}
在页面组件中,只需简单一行调用即可获得具备完整 SSR 预取、类型推导、自动刷新与异常处理能力的数据响应:
<script setup>
const route = useRoute()
const articleId = computed(() => route.params.id as string)
const { data: article, pending } = await useArticleDetail(articleId)
</script>
对于非首屏关键内容(例如文章底部的相关推荐、点赞列表或评论区),不应阻塞服务端渲染的整体交付时间。可以使用 lazy: true(或直接使用 useLazyFetch),让 Node.js 优先渲染正文骨架并飞速响应浏览器,次要模块则在客户端激活后异步补齐,从而大幅缩短首字节到达时间(TTFB)。
JS reduce实战:数组去重、扁平化与分组统计
2026-11-05 13:05:36
JS代码怎么在线压缩?新手操作指南与工具推荐
2026-11-04 18:07:25
fflate 与 pako.js 性能对比:JS 解压库怎么选
2026-11-03 22:54:05
JS DOM查询性能优化:缓存引用与减少重排重绘
2026-11-03 22:48:27
在线运行JavaScript代码时的沙箱限制与跨域问题
2026-11-03 22:29:33