

JS截取字符串前几位时长度超过原字符串怎么办
在JavaScript中截取字符串前几位时,如果指定长度超过原字符串长度,原生方法不会报错,而是安全返回完整原串。本文深入讲解底层的边界保护机制,并根据不同业务需求提供定长补齐、严格校验及Emoji多字节字符安全截取的完整解决方案。
slice(0, n) 或 substring(0, n))截取前 n 位时,即使 n 大于原字符串长度,程序既不会抛出异常,也不会产生空字符填充。JavaScript 引擎会自动将截取终点限制在原字符串的最大长度处,并安全返回完整的原字符串。后续如何处理完全取决于具体业务目标:若仅需截取现有内容可直接使用;若必须对齐固定字符宽度可配合 padEnd() 补齐;若数据不足属于非法输入则需显式判断长度并拦截。
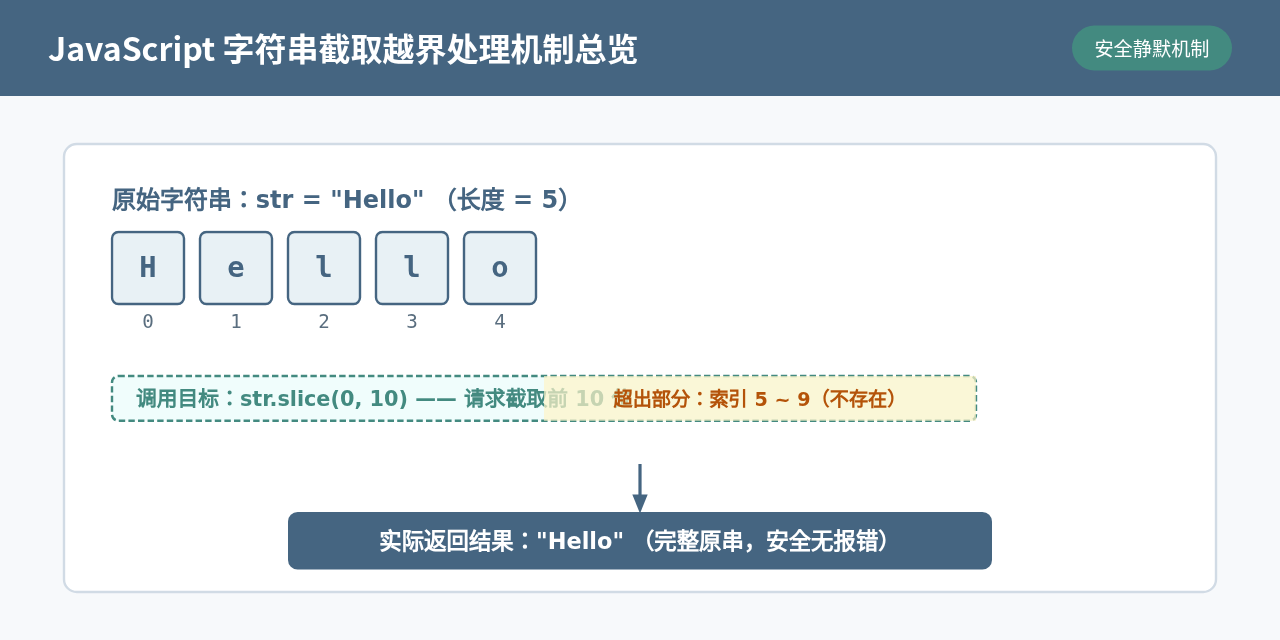
一、原生行为:为什么 JS 不会报错,返回值是什么
在许多编译型语言(例如 Java 的 String.substring)中,如果传入的结束索引大于字符串长度,程序会直接抛出索引越界异常(StringIndexOutOfBoundsException)。很多刚接触 JavaScript 的开发者因此会担心:如果调用 str.slice(0, 8) 时字符串实际只有 3 个字符,程序会不会报错或者返回 undefined?
答案是完全不会。在 ECMAScript 语言规范中,字符串提取方法(包括 String.prototype.slice 和 String.prototype.substring)均包含严格的边界收敛(Clamping)逻辑。
const text = "Vue"; // length 为 3

// 尝试截取前 10 位
const res1 = text.slice(0, 10);
console.log(res1);        // 输出: "Vue"
console.log(res1.length); // 输出: 3

// 使用 substring 同样表现一致
const res2 = text.substring(0, 10);
console.log(res2);        // 输出: "Vue"
从规范层面看,当引擎执行 slice(start, end) 时,第二参数 end 会被隐式转换并限制在 [0, str.length] 范围之间。如果传入的数值大于 str.length,引擎会自动将终点重置为 str.length。因此,截取范围实际等价于 slice(0, str.length),结果即为原字符串自身副本。
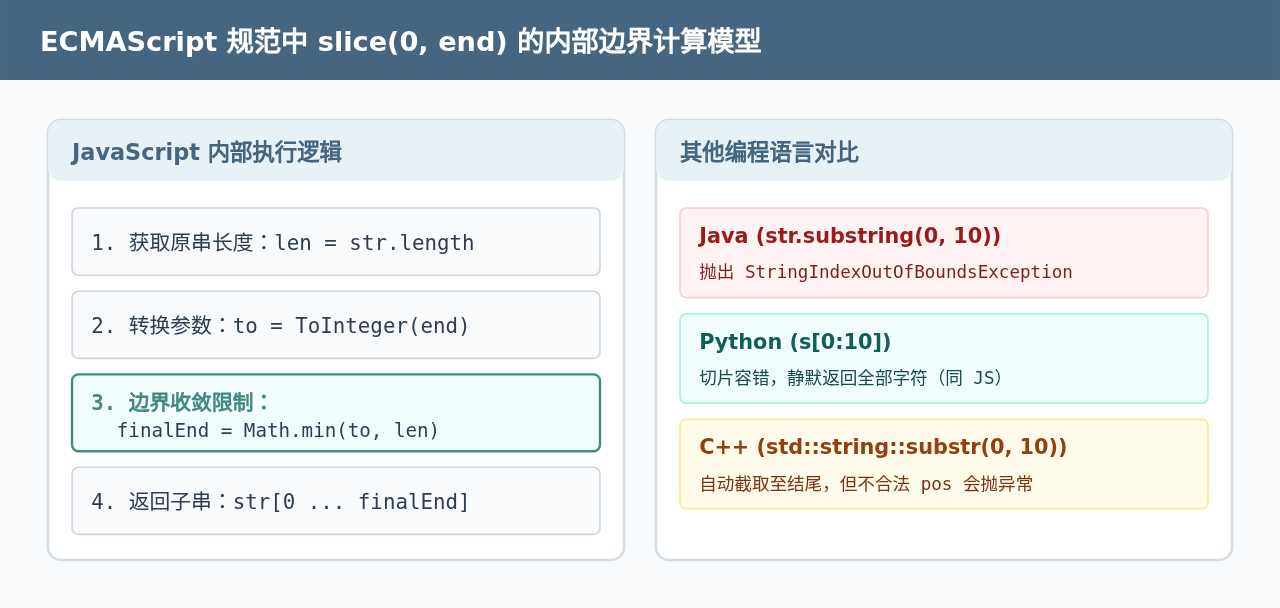
二、根据业务诉求选择具体处理策略
虽然 JS 原生不会抛出异常,但在工程开发中,“长度不足”往往对应着不同的业务意图。盲目依赖原生默认返回可能引发非预期的展示或接口传参问题。常见诉求可分为以下四种:
策略一:允许不足,只截取已有部分(直接保留)
这种场景最常见于前台界面文字展示,例如文章摘要、列表卡片预览等。要求最多展示 N 个字,如果原字数不足 N 则全部展示。
做法:直接使用 str.slice(0, n) 即可。但必须做好非空防御,避免变量为 null 或 undefined 导致调用报错:
function safeTruncate(str, maxLen) {
  // 使用可选链与空值合并运算符进行安全兜底
  return (str ?? "").slice(0, maxLen);
}

console.log(safeTruncate("React", 10)); // 输出: "React"
console.log(safeTruncate(null, 5));    // 输出: ""
策略二:必须达到固定长度,不足时自动填充补齐
常见于生成固定长度的编码、工单流水号、财务对齐格式或控制台表格打印。要求最终输出字符串的长度必须严格等于 N。
做法:使用 ES2017 引入的 String.prototype.padEnd() 方法。当原串长度小于目标长度时,用指定字符补齐到目标长度;若原串本身超过则先截断:
function truncateAndPad(str, targetLen, padChar = " ") {
  const base = (str ?? "").slice(0, targetLen);
  return base.padEnd(targetLen, padChar);
}

// 截取前 8 位,不足则用下划线补足
console.log(truncateAndPad("ORDER", 8, "_")); // 输出: "ORDER___" (严格为8位)
console.log(truncateAndPad("ORDER998877", 8)); // 输出: "ORDER998"
策略三:长度不足属于脏数据,需严格拦截或报警
常见于解析有特定协议格式的数据(如身份证号前 6 位地址码、银行卡 BIN 码、固定协议报文)。若原字符串长度连要求位数都无法满足,说明上游传输错误或用户输入缺失,此时绝不能当成正常数据放行。
做法:在截取前显式校验 str.length < n,根据系统设计选择抛出异常或返回特定标记:
function extractStrictCode(str, requiredLen) {
  if (typeof str !== "string") {
    throw new TypeError("输入参数必须是字符串");
  }
  if (str.length < requiredLen) {
    throw new Error(`数据长度不足: 期望至少 ${requiredLen} 位,实际仅 ${str.length} 位`);
  }
  return str.slice(0, requiredLen);
}

try {
  extractStrictCode("1101", 6);
} catch (err) {
  console.error(err.message); // 输出: 数据长度不足: 期望至少 6 位,实际仅 4 位
}
策略四:包含表情(Emoji)或生僻字的长度与截取问题
JavaScript 字符串基于 UTF-16 编码单元(Code Units)。很多表情符号(如 "😊"、"🚀")或生僻字在内部由 2 个甚至更多编码单元组成。如果一个字符串只有 "😊",其 length 实际为 2。直接按编码单元截取可能会切断代理对(Surrogate Pair),产生 \uD83D 乱码孤立码位。
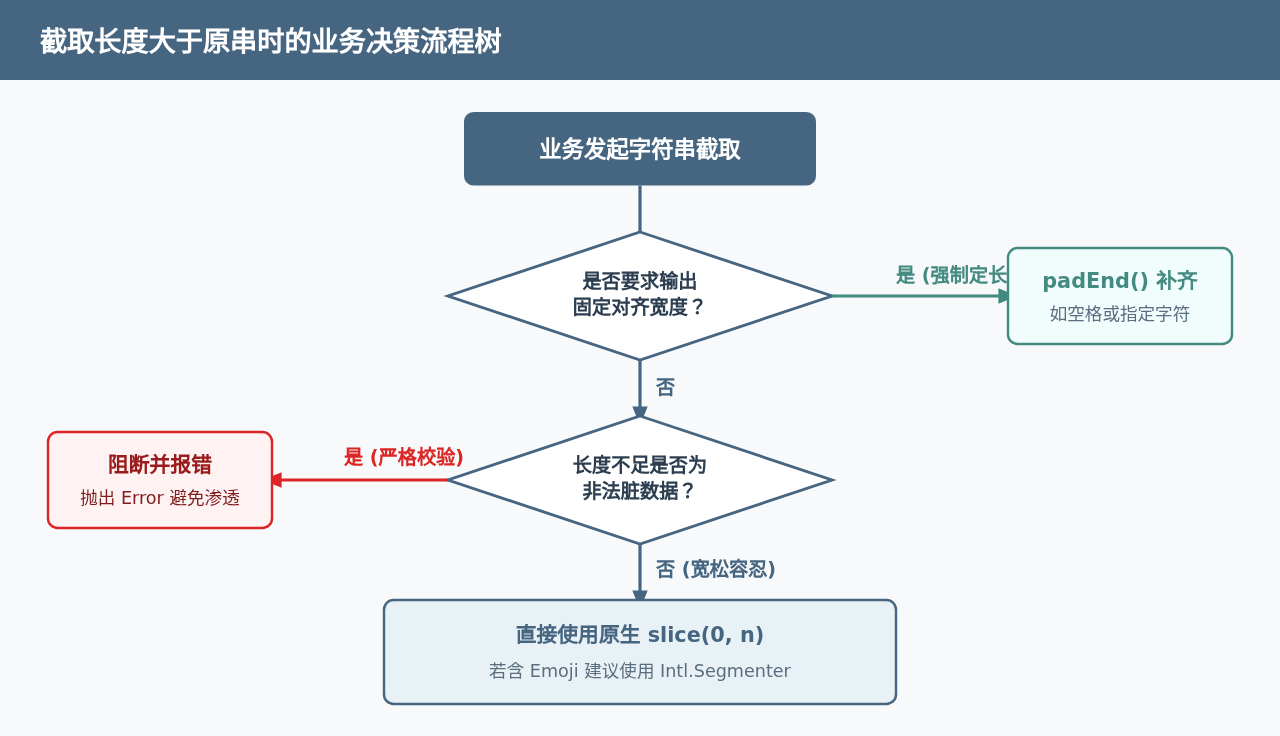
三、通用封装:兼顾补齐、越界与特殊字符的实现步骤
在实际企业级项目中,通常需要一个统一的工具函数来兼顾多种截取策略。实现时可遵循以下四个清晰的处理步骤:
- 第一步(参数归一化与非空防御):对输入值进行空值校验,将
null、undefined转换为安全空串,或将数字转为字符串。 - 第二步(真实字符分割):利用现代 JavaScript 的
Intl.Segmenter或解构语法[...str],按人类视觉感知的“字形簇”(Grapheme Cluster)进行切分,防止切断 Emoji。 - 第三步(长度边界判断与分流):判断字符总数与期望长度
n的关系,依据传入的配置参数决定是直接截断、抛错还是补足占位符。 - 第四步(结果封装与返回):输出符合预期长度与格式的字符串结果。
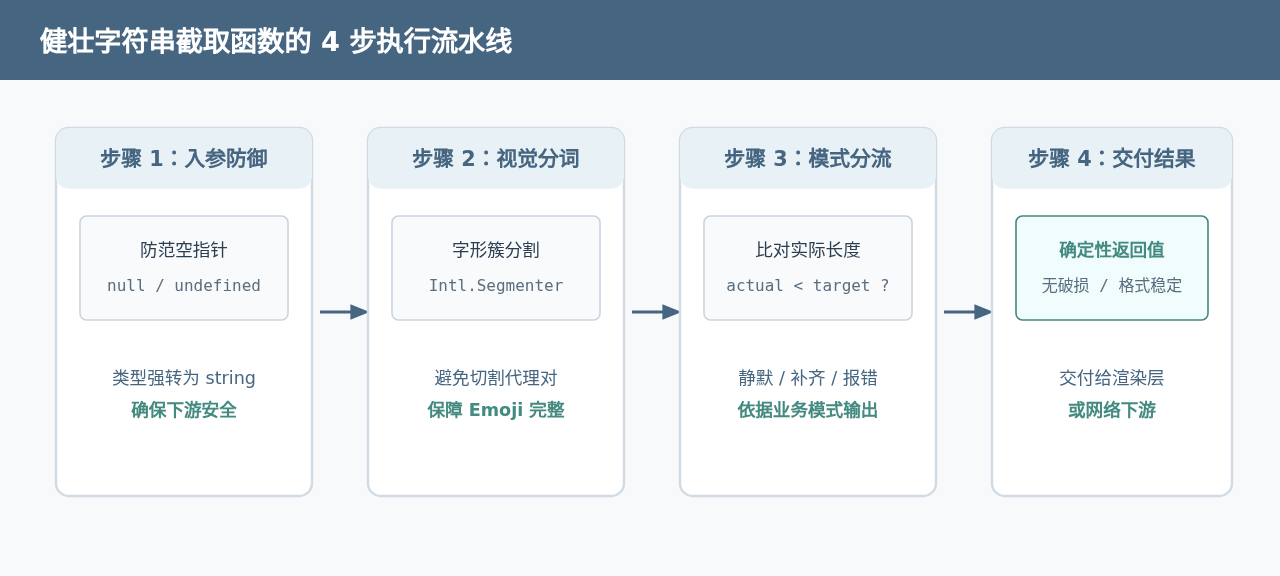
下面是一个经过完整封装的示例代码,读者可直接在项目中使用:
/**
 * 健壮的截取工具函数
 * @param {string} input - 待截取字符串
 * @param {number} count - 截取字数
 * @param {Object} options - 配置项
 * @param {string} [options.padChar] - 若指定且长度不足,用此字符补齐;不指定则不补齐
 * @param {boolean} [options.strict=false] - 是否开启严格模式,长度不足时报错
 */
function sliceLeadingChars(input, count, options = {}) {
  const { padChar, strict = false } = options;
  const raw = input == null ? "" : String(input);

  // 使用 Intl.Segmenter 安全拆分视觉字形簇
  let chars;
  if (typeof Intl !== "undefined" && Intl.Segmenter) {
    const segmenter = new Intl.Segmenter("zh-CN", { granularity: "grapheme" });
    chars = Array.from(segmenter.segment(raw), s => s.segment);
  } else {
    chars = Array.from(raw);
  }

  const actualLen = chars.length;

  // 严格模式拦截
  if (strict && actualLen < count) {
    throw new RangeError(`字符串长度为 ${actualLen},小于要求的 ${count} 位`);
  }

  // 基础截取(字符簇已安全)
  const sliced = chars.slice(0, count).join("");

  // 若需要补齐则补足到指定长度
  if (padChar !== undefined && actualLen < count) {
    const deficit = count - actualLen;
    return sliced + padChar.repeat(deficit);
  }

  return sliced;
}

// 测试示例 1:普通字符串超长截取(默认宽松返回)
console.log(sliceLeadingChars("前端技术", 10));
// 输出: "前端技术"

// 测试示例 2:含有 Emoji 的字符串截取前 2 位
console.log(sliceLeadingChars("🎯💡🚀🔥", 2));
// 输出: "🎯💡" (不会切断表情码位)

// 测试示例 3:不足时对齐补足
console.log(sliceLeadingChars("VIP", 6, { padChar: "*" }));
// 输出: "VIP***"
四、极易踩坑的细节与注意事项
substr()早期代码中常有人使用
str.substr(0, n)。需要注意,substr 已被 ECMAScript 官方规范声明为附录废弃特性(Deprecated),虽然现代浏览器出于兼容性仍支持,但在某些严格执行环境或未来引擎版本中可能会引起隐患。请统一使用 slice() 或 substring()。
null 与 undefined 引起的运行时崩溃调用
str.slice(0, 5) 本身是绝对安全的,但安全的前提是 str 必须是一个字符串实例。若数据源自异步接口且未做初始化,str 可能会是 null 或 undefined,此时执行 .slice() 会触发致命的 TypeError: Cannot read properties of null。在调用截取前,请务必使用 (str || "").slice(...) 或 str?.slice(...) 进行防御。
像家庭表情(👨👩👧👦)是由多个独立 Emoji 与零宽连接符(
\u200D)组合而成的。如果只用 Array.from() 截取,仍然可能会切分复合表情。如果业务中对 Emoji 完整性要求极高,应优先使用标准的 Intl.Segmenter。
五、各策略方案对比与选型总结
为了便于在不同业务场景中快速做出技术选型,各方案的关键属性与适用条件如下表所示:
| 方案类型 | 典型实现 | 超长时表现 | 性能开销 | 推荐使用场景 |
|---|---|---|---|---|
| 原生直接截取 | str.slice(0, n) |
直接返回全量原串 | 极低(纳秒级) | UI文本摘要、字数上限限制、标签截断 |
| 定长填充补齐 | str.padEnd(n, char) |
用指定字符补足至目标长度 | 极低 | 打印报表排版、格式化定长单号、对齐输出 |
| 严格断言校验 | if (str.length < n) throw |
中断执行,抛出异常 | 极低 | 身份证号、银行卡号、协议定长帧解析 |
| 字符簇感知截取 | Intl.Segmenter |
安全切分视觉字形 | 低(微秒级) | 用户自定义昵称、社交评论、含表情富文本 |
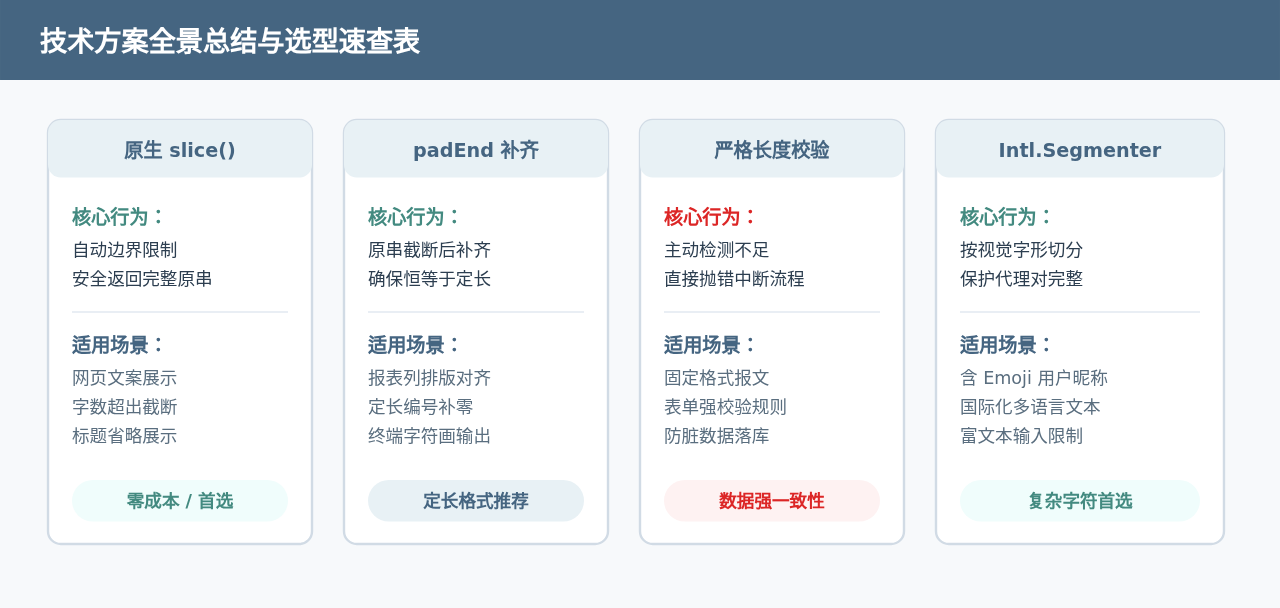
综上所述,当在 JavaScript 中截取字符串前几位且长度超过原字符串时,语言本身提供了极度安全的容错保证。开发者无需担心越界崩溃,只需结合业务是“允许按原样展示”、“需要定长填充”还是“必须报错阻断”,选择最贴合实际需求的实现方案即可。
JavaScript闭包与类(Class)的区别及适用场景对比
2026-11-05 15:48:57
JavaScript入门要学ES6吗?let与箭头函数等新特性解析
2026-11-05 14:49:16
JavaScript 8种数据类型详解:基本类型与引用类型的区别
2026-11-05 14:25:15
怎么在JavaScript中使用async/await优化Ajax异步流程
2026-11-05 13:56:15
JavaScript replace回调函数实现动态正则替换逻辑
2026-11-05 13:52:13







