解决JavaScript递归导致的栈溢出错误(Maximum call stack size exceeded)
深入解析JavaScript中“RangeError: Maximum call stack size exceeded”报错的核心机理,排查死递归与深度超标原因,并提供基线修复、循环显式栈、蹦床函数和异步事件分块四大实用解决方案及验证方法。
RangeError: Maximum call stack size exceeded。解决这一错误的核心路径非常明确:首先排查并修补缺失或无效的递归基准条件;若业务数据天然具有超深层级,则需要将函数调用栈的压力转移至堆内存中——常用的工程手段包括基于循环与显式数组的迭代改写、蹦床函数(Trampoline)以及基于微任务的异步分批调度。
一、认识错误:调用栈如何被“吃满”
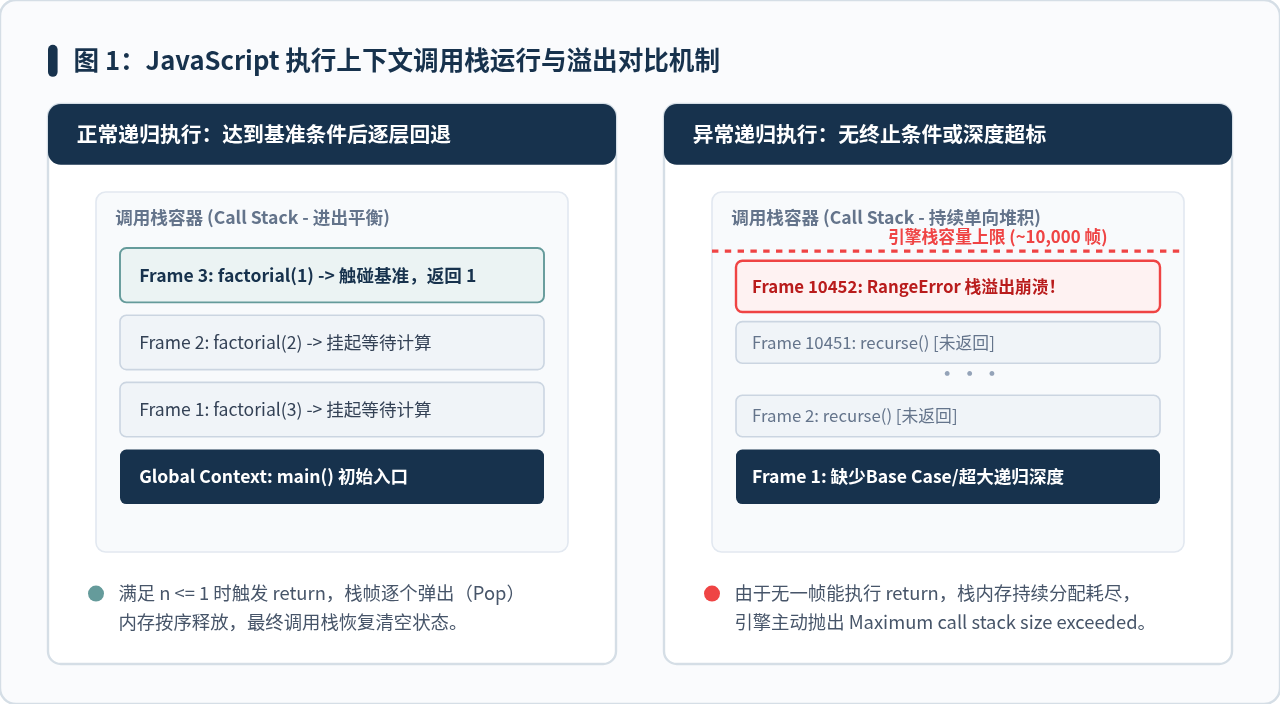
JavaScript 是一门单线程语言,其代码的执行严重依赖于执行上下文调用栈(Call Stack)。每当一个函数被调用时,JavaScript 引擎都会为其分配一个独立的“栈帧”(Stack Frame),用于保存该函数的参数、局部变量以及返回地址。当函数执行完成并遇到 return 语句后,该栈帧才会从调用栈顶部弹出(Pop)并释放。
在常规的非递归代码中,函数的入栈与出栈交替发生,栈的深度通常维持在几层到几十层之间。然而在递归调用中,外层函数在等待内层函数的返回结果,自身无法退出,因此栈帧只能持续单向堆叠。
不同 JavaScript 引擎(如 Chrome 与 Node.js 搭载的 V8、Safari 的 JavaScriptCore 等)对调用栈的最大深度和内存大小均有硬性配额。在 V8 引擎中,调用栈的深度上限通常在 10,000 层左右(根据每帧所携带的局部变量数量和闭包大小略有浮动)。一旦嵌套的函数调用超过这一硬性阈值,引擎为了防止宿主进程彻底崩溃,会主动熔断并抛出 RangeError: Maximum call stack size exceeded。
二、根因定位:为什么会出现递归栈溢出?
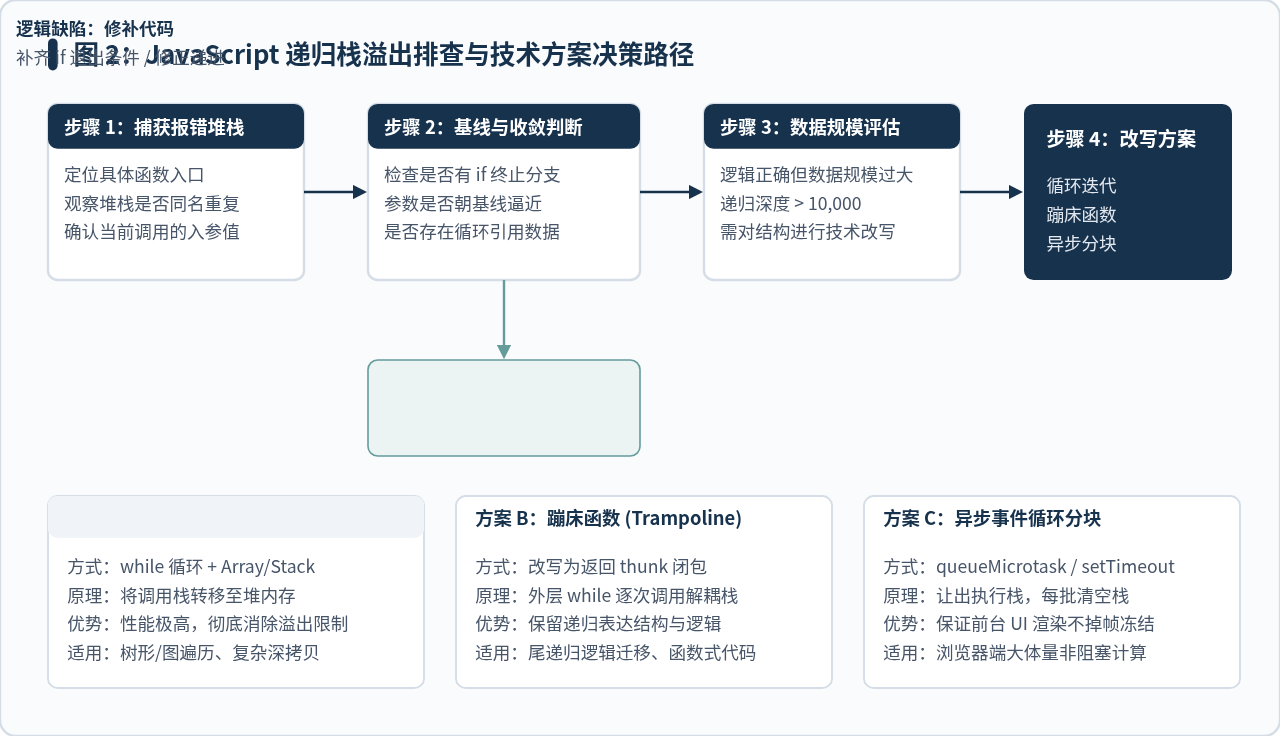
排查 Maximum call stack size exceeded 时,通常遵循“先检查逻辑缺陷,再评估数据规模”的原则。实际开发中导致该错误的原因主要分为以下三类:
1. 缺少基线条件(Base Case)或基线永远无法命中
这是初学者和粗心编码中最普遍的死循环递归。例如计算阶乘或斐波那契数列时,忘记写退出 if 分支,或者由于类型不匹配(如字符串与数字严格比较)导致退出条件永远返回 false。
// 错误示例:缺少终止条件,进入无限递归
function countDown(n) {
  console.log(n);
  // 缺少 if (n <= 0) return;
  countDown(n - 1);
}
countDown(5); // 迅速抛出 Maximum call stack size exceeded
2. 递归参数步进方向错误,偏离基准目标
虽然代码中编写了终止判断,但每次递归调用传递的参数并没有向终止条件靠近,甚至反向远离。例如原本应该递减 n - 1,错误写成了 n + 1;或者处理图结构、相互引用的对象时,没有记录访问历史导致在闭环节点间反复调用。
3. 业务数据深度确实超出了调用栈承载上限
递归逻辑、步进方向和终止条件完全正确,但待处理的数据集规模庞大。例如处理一个嵌套深度达到 20,000 层的树形组织架构、大型 DOM 树或者超长单向链表。这种情况下,算法逻辑无懈可击,但 JavaScript 引擎有限的栈空间无法容纳,必须从架构上进行解耦。
三、核心解决方案与代码重构
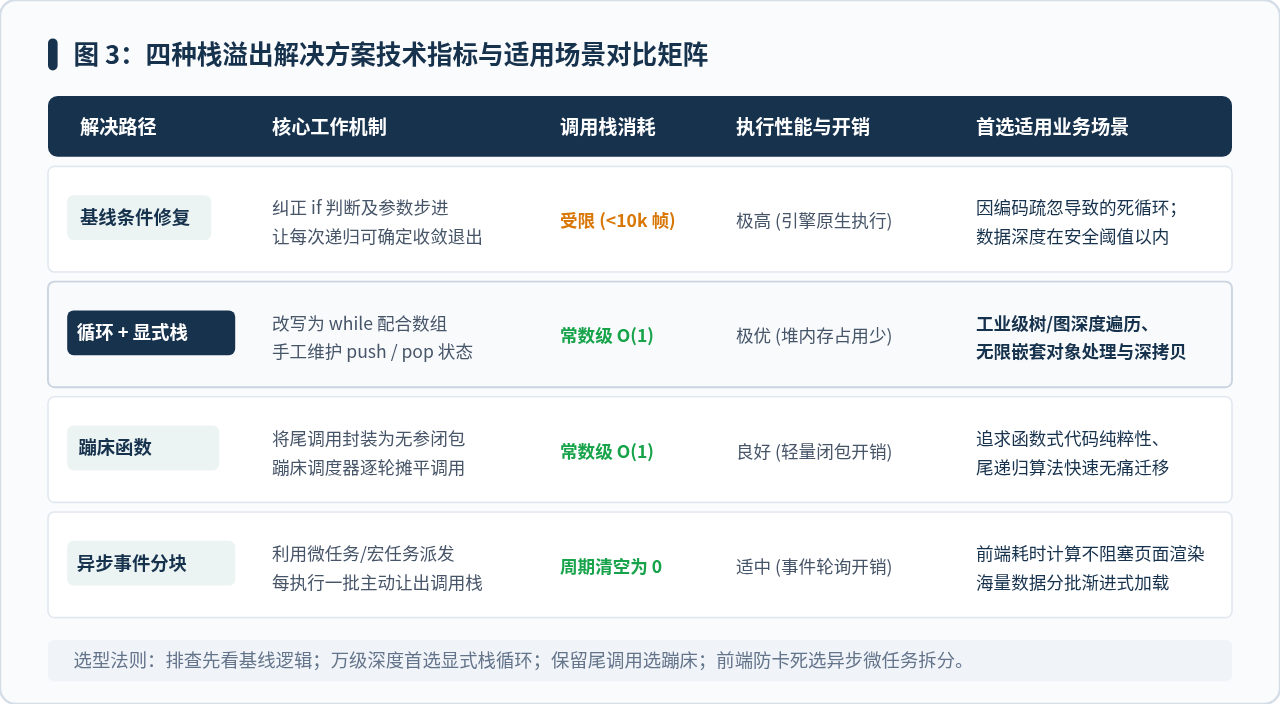
根据排查得出的结论,针对不同的诱发原因,我们可以采用对应的修复策略。以下是业界主流且验证充分的四种解决方法。
方案一:修补基准条件与循环引用保护(逻辑层修复)
如果问题源于编码失误,首要任务是在函数入口设立稳固的“前置守卫”。对于树形或对象深拷贝递归,必须使用 WeakSet 或 Set 缓存已访问对象,识别并阻断循环引用。
// 修复后:严格的基线判断与循环引用防范
function safeDeepClone(target, visited = new WeakSet()) {
  // 1. 严格基线条件:非对象或 null 直接返回
  if (target === null || typeof target !== 'object') {
    return target;
  }

  // 2. 防范循环引用导致的无底线死递归
  if (visited.has(target)) {
    return target; // 发现环引用,安全熔断
  }
  visited.add(target);

  const copy = Array.isArray(target) ? [] : {};
  for (const key of Object.keys(target)) {
    copy[key] = safeDeepClone(target[key], visited);
  }
  return copy;
}
方案二:将递归重构为循环 + 显式数组栈(推荐工业级首选)
当数据深度超出调用栈配额时,最有效且性能最高的改造方式是:使用 JavaScript 普通数组充当数据栈,在堆内存中模拟调用栈的行为。因为现代计算机的堆内存(通常以 GB 计算)远大于调用栈(仅 1~2 MB)。
以深度优先遍历或树节点求和为例,对比前后的代码实现:
// 【改造前】:传统递归写法(遇到超深树必定爆栈)
function sumTreeRecursive(node) {
  if (!node) return 0;
  let leftSum = node.left ? sumTreeRecursive(node.left) : 0;
  let rightSum = node.right ? sumTreeRecursive(node.right) : 0;
  return node.value + leftSum + rightSum;
}

// 【改造后】:循环 + 显式数组栈(轻松应对 100 万节点深度)
function sumTreeIterative(root) {
  if (!root) return 0;
  let total = 0;
  // 将执行控制权转移到堆内存中的数组
  const stack = [root];

  while (stack.length > 0) {
    const current = stack.pop();
    total += current.value;

    // 先入后出,子节点依次推入显式栈中
    if (current.right) stack.push(current.right);
    if (current.left) stack.push(current.left);
  }

  return total;
}sumTreeIterative 本身),内部只有简单的数组 push 和 pop 操作。调用栈深度恒定为 1,彻底消除了 RangeError 的可能。
方案三:使用蹦床函数(Trampoline Pattern)
部分开发者偏好函数式编程的清晰表达,或者希望尽量少改动算法的递归书写结构。虽然 ECMAScript 规范定义了尾调用优化(Tail Call Optimization, TCO),但绝大部分现代浏览器引擎(除 Safari 外)和 Node.js 均默认未开启 TCO。
蹦床函数通过将递归调用包装为“返回一个无参闭包函数(Thunk)”,在外层使用 while 循环反复调用该闭包,从而将深层调用拉平成连续的单层执行。
// 通用蹦床调度器
function trampoline(fn) {
  return function (...args) {
    let result = fn(...args);
    // 只要返回值依然是可执行函数,就持续在单层栈中解开它
    while (typeof result === 'function') {
      result = result();
    }
    return result;
  };
}

// 将大数累加改写为返回 thunk 的形式
function accumulate(n, acc = 0) {
  if (n <= 0) return acc;
  // 关键:不直接调用 accumulate,而是返回一个延迟执行的箭头函数
  return () => accumulate(n - 1, acc + n);
}

// 使用蹦床执行 100,000 次计算,调用栈深度始终为 1
const safeAccumulate = trampoline(accumulate);
console.log(safeAccumulate(100000)); // 正常输出 5000050000,绝不爆栈
方案四:基于微任务 / 宏任务的异步分批调度
在浏览器或前端页面中,如果一次性用同步大循环处理数万层递归,即便避免了栈溢出,长任务也会直接霸占 JavaScript 线程,导致页面出现卡顿、掉帧甚至无响应警告。
此时可以利用事件循环机制,每递归一定次数(如 500 次)时,通过 queueMicrotask、setTimeout(..., 0) 或 requestAnimationFrame 将下一轮调用放入事件队列,主动让出当前的调用栈和主线程控制权。
// 异步分块递归:兼顾栈空间清空与页面帧率响应
async function processDeepArrayAsync(list, index = 0, chunkSize = 500) {
  if (index >= list.length) return;

  const limit = Math.min(index + chunkSize, list.length);
  for (let i = index; i < limit; i++) {
    // 执行具体的业务处理
    list[i].processed = true;
  }

  // 每处理一批数据,让渡调用栈并清空栈帧
  await new Promise(resolve => setTimeout(resolve, 0));

  // 启动下一批处理,此时栈已彻底清空
  return processDeepArrayAsync(list, limit, chunkSize);
}
四、验证与验收:确认问题已彻底解决
修复完成后,不能仅仅以“当前几条测试用例不报错”为标准,必须通过严苛的边界和压力测试来确认系统韧性。
1. 构建超深链表/递归压力测试用例
在单元测试中,手工构造一个层级达到 100,000 的深层链表或树结构,验证重构后的函数是否能够稳定运行通过:
// 压力测试辅助脚本
function runStackStressTest() {
  console.log('开始构建 100,000 层深链表...');
  let head = { value: 1, next: null };
  let current = head;
  for (let i = 2; i <= 100000; i++) {
    current.next = { value: i, next: null };
    current = current.next;
  }

  console.log('执行迭代处理...');
  let sum = 0;
  let pointer = head;
  while (pointer) {
    sum += pointer.value;
    pointer = pointer.next;
  }

  console.log('验收通过!计算结果:', sum);
}
runStackStressTest();
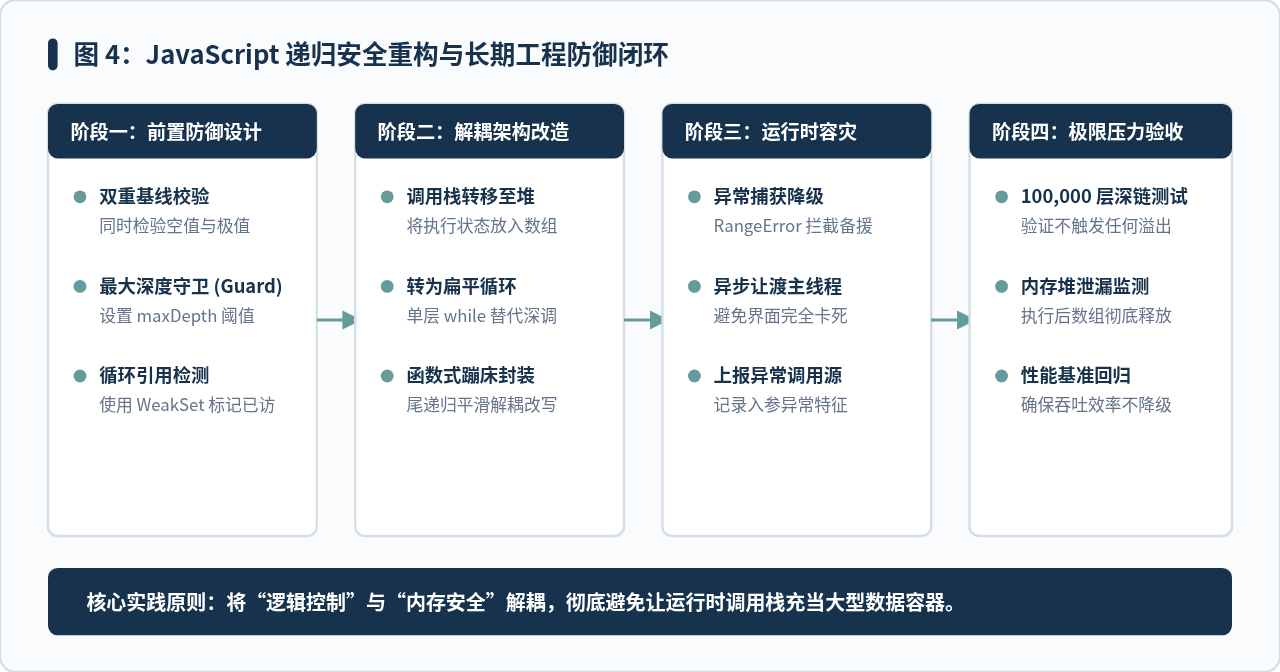
2. 建立深度防卫守护(Max Depth Guard)
如果业务中必须保留某些轻量级递归,建议在函数签名中引入显式的 depth 计数器以及 maxDepth 阈值保护,一旦由于异常数据进入失控分支,主动抛出带有明确业务上下文的提示,而非放任引擎报出模糊的栈溢出:
function treeWalkWithGuard(node, depth = 0, maxDepth = 1000) {
  if (!node) return;
  if (depth > maxDepth) {
    throw new Error(`[安全熔断] 数据嵌套深度超过最大安全阈值 (${maxDepth})`);
  }

  // 递归遍历子节点
  if (node.children) {
    for (const child of node.children) {
      treeWalkWithGuard(child, depth + 1, maxDepth);
    }
  }
}
五、总结与编码备忘
面对 Maximum call stack size exceeded,切忌盲目通过尝试增加运行时的调用栈内存(如 Node.js 的 --stack-size 参数)来掩盖问题。这一参数不仅在浏览器环境中无法干预,而且只是延缓了崩溃时机,并未从根本上解决空间复杂度过高的问题。
- 第一准则:先看基线与收敛条件。大多数偶发爆栈都是未满足退出条件或出现闭环对象引起的。
- 首选方案:对数据层级无法预估的深度遍历,优先采用
while循环结合数组显式栈,直接消除调用栈开销。 - 函数式方案:希望维持递归函数签名的逻辑结构时,使用蹦床函数(Trampoline)进行扁平化包装。
- 体验保障:前端大数据批处理需配合异步事件切片,清空栈帧的同时保障界面流畅。
JS拖拽排序后怎么保存顺序?前端数据同步与后端交互示例
2026-11-05 23:46:31
JS读取Excel出现中文乱码怎么解决
2026-11-05 22:02:33
使用async/await处理JavaScript GET请求的异步响应
2026-11-05 20:22:10
JS类型判断方法对比:typeof、instanceof与toString
2026-11-05 20:20:56
JS语法错误会阻止加载吗?区分SyntaxError与资源加载失败
2026-11-05 16:08:46