JS读取Excel出现中文乱码怎么解决
针对JavaScript在前端读取Excel文件(.csv、.xlsx、.xls)时出现的各类中文乱码问题,深入剖析字符集编码冲突与二进制解析机制,提供基于FileReader、TextDecoder与SheetJS的标准解决方案与完整代码范例。
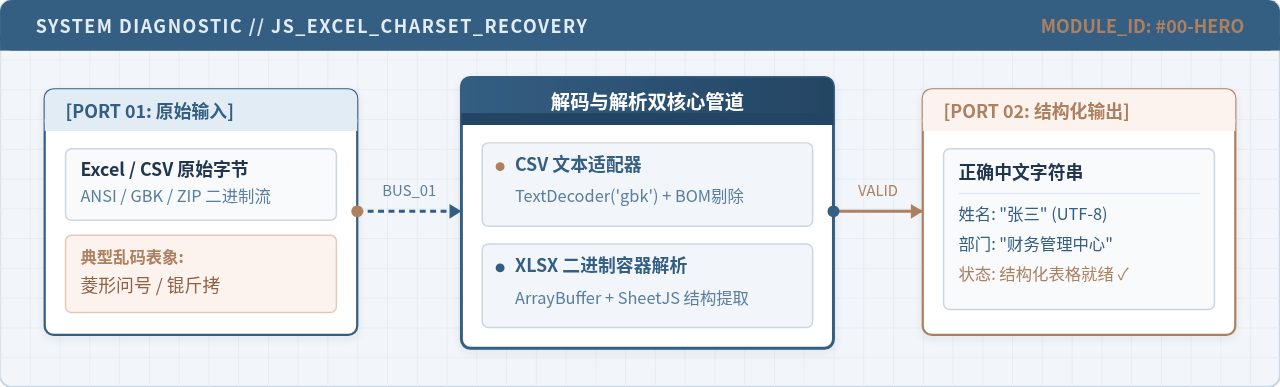
.csv 文件当作普通文本读取时字符编码不匹配(Windows 下 Excel 默认保存的 CSV 通常为 ANSI/GBK 编码,而前端默认以 UTF-8 解码);二是对 .xlsx 或 .xls 复合二进制工作簿误用了纯文本读取 API(例如 FileReader.readAsText),导致二进制压缩包字节流被强行转换为乱码字符。解决路径十分明确:区分文件真实格式,CSV 文件指定 'GBK' 或通过 TextDecoder 动态解码并剥离 BOM 头,XLSX 文件则必须通过 FileReader.readAsArrayBuffer 读取原始二进制字节并交由 SheetJS 等专业解析库处理。
一、乱码根源诊断:为什么 JS 读 Excel 会变乱码?
在排查乱码前,必须先理清所谓的“Excel 文件”在底层存在两种截然不同的物理形态:
-
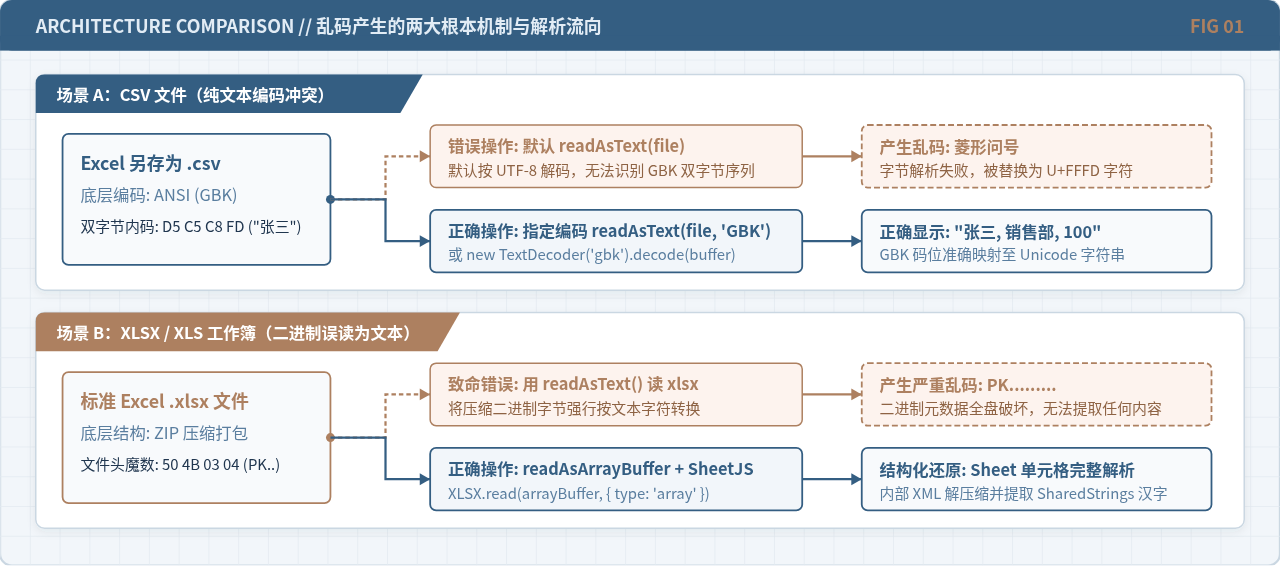
CSV 纯文本表格(.csv):虽然双击会默认由 Microsoft Excel 打开,但它本质上是纯文本文件,使用逗号分隔数据。在中文 Windows 环境下,通过 Excel 另存为 CSV 时,软件默认采用的是操作系统的本地编码(即 ANSI / Windows-936 / GBK),其存储的中文字符占两个字节(例如汉字“张”编码为十六进制
D5 C5)。而现代浏览器中的FileReader.readAsText(file)若不传第二个参数,默认强制使用 UTF-8 规则进行解码。UTF-8 判定该字节序列不符合多字节 UTF-8 编码规则,直接将其标记为非法字节,替换为 Unicode 替换字符(U+FFFD),表现为满屏的黑色菱形问号,或在二次转码中退化为“锟斤拷”。 -
现代工作簿(.xlsx)与旧版工作簿(.xls):
.xlsx文件的本质是一个经过 ZIP 算法压缩的 XML 文件包(OpenXML 标准),其文件头部前四个字节固定为50 4B 03 04(即 ASCII 字符PK..)。如果开发者直接对其调用FileReader.readAsText(),浏览器会把这批纯粹的压缩二进制数据当成文本尝试解码,结果必然是输出一段以PK....开头的混乱乱码,不仅汉字全无,任何单元格结构也彻底丢失。
二、场景一:读取 CSV 格式 Excel 乱码的解决方法
如果上传的是 .csv 文件,出现中文乱码是因为字符集解码器选错。解决此问题有以下三种具体做法。
方法 1:为 FileReader.readAsText 指定 GBK / GB18030 编码
FileReader.prototype.readAsText() 方法接受第二个可选参数 encoding。当明确知道用户来自中文 Windows 环境时,将其显式设置为 'GBK' 或兼容性更广的 'GB18030' 即可直接解决乱码:
function readCsvFileGbk(file) {
  const reader = new FileReader();

  reader.onload = function(e) {
    const text = e.target.result;
    // 此时 text 中的中文字符已正确映射为 JavaScript 内部的 Unicode 字符串
    console.log("解析出的正常文本内容:", text);
  };

  // 关键点:第二个参数必须指定为 'GBK' 或 'gb18030',切勿留空
  reader.readAsText(file, 'GB18030');
}GB18030 是国家强制标准编码,向下兼容 GBK 和 GB2312,不仅包含了常用汉字,还收录了藏、蒙、维等少数民族文字及冷僻姓名汉字。因此在指定中文编码时,传入 'GB18030' 比 'GBK' 具备更好的防御性。
方法 2:使用 readAsArrayBuffer + TextDecoder 自适应处理
现实场景中,用户的 CSV 文件可能是 Windows 导出的 GBK 编码,也可能是 Mac 或外部导出的标准 UTF-8 编码。为了实现一套代码自动兼容,应采用 readAsArrayBuffer 先读取原始字节流,通过检测文件开头的 BOM 标志(0xEF 0xBB 0xBF)来判断是 UTF-8 还是 GBK,再利用原生 TextDecoder 进行解码:
function readCsvAdaptive(file) {
  const reader = new FileReader();

  reader.onload = function(e) {
    const buffer = e.target.result;
    const bytes = new Uint8Array(buffer);

    // 1. 检测是否带有 UTF-8 的 BOM 头 (0xEF, 0xBB, 0xBF)
    const hasUtf8Bom = bytes[0] === 0xEF && bytes[1] === 0xBB && bytes[2] === 0xBF;

    let decodedString = "";
    if (hasUtf8Bom) {
      // 若有 BOM 标记,使用 utf-8 解码
      const decoder = new TextDecoder('utf-8');
      decodedString = decoder.decode(bytes);
    } else {
      // 无 BOM 标记且出现中文乱码,优先采用 GB18030 解码
      try {
        // 开启 fatal: true 可探测是否为严格合法的 UTF-8
        const utf8Decoder = new TextDecoder('utf-8', { fatal: true });
        decodedString = utf8Decoder.decode(bytes);
      } catch (err) {
        // 若非合法 UTF-8,平滑回退至 GB18030
        const gbkDecoder = new TextDecoder('gb18030');
        decodedString = gbkDecoder.decode(bytes);
      }
    }

    // 2. 清洗可能存在的 BOM 首字符()
    decodedString = decodedString.replace(/^/, '');
    console.log("自适应解码结果:", decodedString);
  };

  reader.readAsArrayBuffer(file);
}
方法 3:剔除 BOM 隐形乱码字符()
部分 CSV 文件虽然汉字能正常看到,但在通过属性名读取对象时(如 item["姓名"])却返回 undefined。这是因为文件首部带有 UTF-8 字节序标记 BOM(),它虽然在屏幕上是不可见的零宽字符,但会粘连在第一列的列名上变成 姓名。因此在解析任何 CSV 第一行表头时,必须执行:
const sanitizedContent = rawCsvText.replace(/^/, '');三、场景二:读取 XLSX / XLS 格式工作簿乱码的解决方法
.xlsx 绝不能使用 readAsText(),任何字符集参数都无法拯救二进制 zip 包。读取 .xlsx 必须走**二进制读取 + 工作簿解构**流程。社区中最成熟的工业标准库是 SheetJS(又称 xlsx)。
1. 正确引入与核心配置
在 HTML 中引入官方库(或通过 npm 安装 npm install xlsx):
<!-- 生产环境引入 xlsx 核心库 -->
<script src="https://cdn.sheetjs.com/xlsx-latest/package/dist/xlsx.full.min.js"></script>
2. 使用 readAsArrayBuffer 进行正确解析
前端通过 FileReader.prototype.readAsArrayBuffer 获取文件底层原始字节数组,然后传给 XLSX.read,并显式指定 type: 'array'。此流程下,SheetJS 会自动解开 ZIP 压缩包,解析内部的 sharedStrings.xml 字符串池,绝不会产生乱码:
function readExcelWorkbook(file) {
  const reader = new FileReader();

  reader.onload = function(e) {
    const arrayBuffer = e.target.result;

    // 必须传入 type: 'array' 告知库传入的是 ArrayBuffer 二进制内存块
    const workbook = XLSX.read(arrayBuffer, {
      type: 'array',
      cellDates: true  // 顺便将日期数字转为 Date 对象
    });

    // 提取第一个工作表
    const firstSheetName = workbook.SheetNames[0];
    const worksheet = workbook.Sheets[firstSheetName];

    // 将单元格转化为标准 JSON 数组,中文表头与内容均完美保留
    const jsonData = XLSX.utils.sheet_to_json(worksheet, { defval: "" });
    console.log("解析出的工作表数据:", jsonData);
  };

  reader.readAsArrayBuffer(file);
}.xls 二进制文件(BIFF8 格式),如果解析出来中文有少量偏僻乱码,需确保使用的是包含代码页支持的 xlsx.full.min.js,并在选项中附加 codepage: 936。精简版 xlsx.mini.min.js 默认不带 codepage 映射表。
四、系统化排查与决策流程
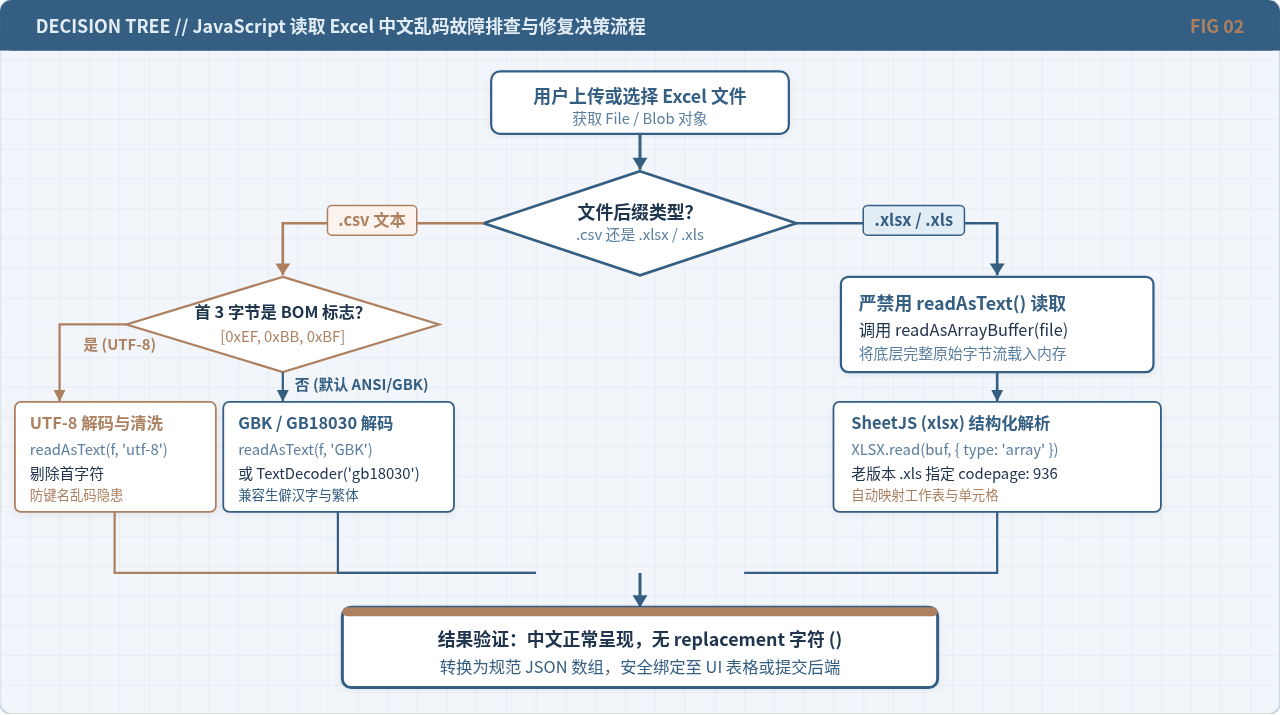
当遇到 Excel 乱码问题时,切忌盲目更换 API。应遵循下方的技术决策树,先判断容器类型(纯文本还是压缩二进制),再确定字符编码或解析管道:
五、完整工程实现:通用 Excel / CSV 无乱码解析组件
将上述逻辑封装为一个兼顾 .xlsx、.xls 和 .csv 的统一读取函数,前端调用方只需传入 File 对象,即可直接获得无乱码的 JSON 数组。
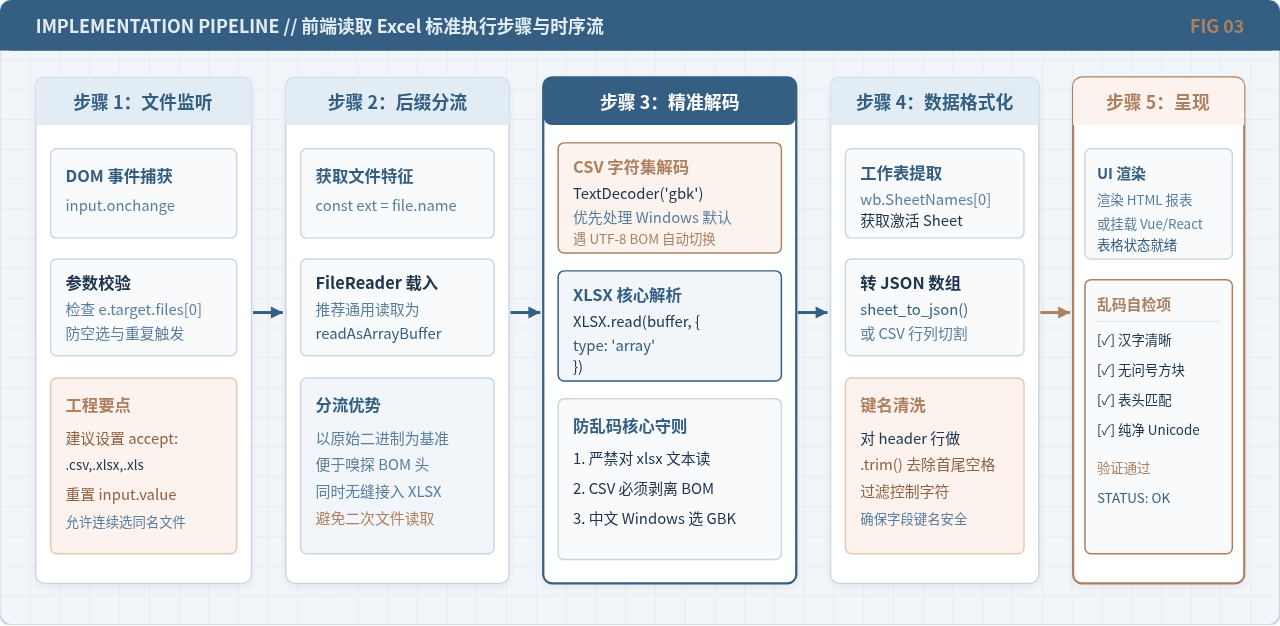
/**
 * 通用 Excel 读取工具:支持 xlsx, xls, csv,全面防御中文乱码
 * @param {File} file 用户选择的文件对象
 * @returns {Promise<Array<Object>>} 解析后的 JSON 数据行
 */
async function parseExcelFile(file) {
  if (!file) throw new Error("未选择有效文件");

  const fileName = file.name.toLowerCase();
  const arrayBuffer = await file.arrayBuffer();

  // 场景 1:如果是 CSV 文本文件
  if (fileName.endsWith('.csv')) {
    const bytes = new Uint8Array(arrayBuffer);
    let text = "";

    // 优先按 UTF-8 严格模式尝试解码
    try {
      const utf8Decoder = new TextDecoder('utf-8', { fatal: true });
      text = utf8Decoder.decode(bytes);
    } catch (e) {
      // 捕获到非法 UTF-8 字节序列(Windows 导出的 ANSI/GBK),回退至 GB18030
      const gbkDecoder = new TextDecoder('gb18030');
      text = gbkDecoder.decode(bytes);
    }

    // 剔除首行开头的 UTF-8 BOM 字符
    text = text.replace(/^/, '');

    // 利用 SheetJS 或自建正则将 CSV 纯文本转换为结构化工作表
    const csvWorkbook = XLSX.read(text, { type: 'string' });
    const firstSheet = csvWorkbook.Sheets[csvWorkbook.SheetNames[0]];
    return XLSX.utils.sheet_to_json(firstSheet, { defval: "" });
  }

  // 场景 2:如果是 .xlsx 或 .xls 二进制工作簿
  if (fileName.endsWith('.xlsx') || fileName.endsWith('.xls')) {
    const workbook = XLSX.read(arrayBuffer, {
      type: 'array',
      codepage: 936, // 补齐中文代码页映射
      cellDates: true
    });

    const firstSheet = workbook.Sheets[workbook.SheetNames[0]];
    return XLSX.utils.sheet_to_json(firstSheet, { defval: "" });
  }

  throw new Error("不支持的文件格式,仅支持 .csv, .xlsx, .xls");
}
六、验证方法与常见避坑要点
-
如何检验乱码是否彻底修复?
不仅要肉眼观察页面上的文字,还应在控制台打印
Object.keys(row[0])。检查首个字段键名是否带有多余的空宽字符,字符串长度是否与汉字数量一致。 -
避免二次导出引发“乱码循环”:
如果在前端生成 CSV 供用户下载,记得在写入字节流的开头显式加入 UTF-8 BOM
(例如new Blob(['' + csvString], { type: 'text/csv;charset=utf-8;' }))。否则 Windows Excel 再次双击打开该文件时,依然会因为缺少 BOM 标记而误用 ANSI 打开,导致用户看到乱码。 -
Node.js 服务端环境适配:
若在 Node.js 环境下使用
fs.readFileSync(path)读取,若文件为 GBK 编码的 CSV,不可直接.toString('utf-8'),应配合iconv-lite库进行iconv.decode(buffer, 'gbk')解码。
七、全场景速查与总结
为了便于日常开发随时检索,将不同格式 Excel 文件的乱码表现、根本原因与对应技术参数整理如下表与速查卡片中:
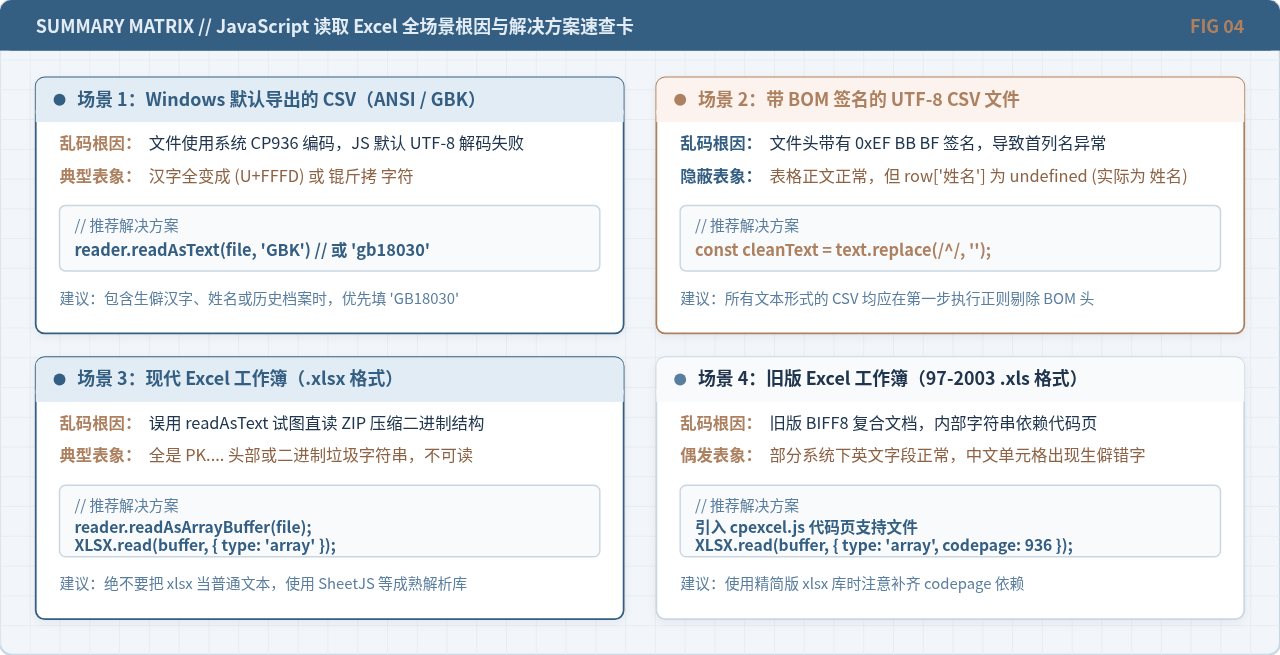
| 文件类型 | 默认底层编码 | 典型乱码表现 | 关键解决 API / 方法 | 核心配置项 |
|---|---|---|---|---|
| Windows CSV | ANSI (GBK / CP936) | 汉字变成 |
readAsText(file, 'GB18030') |
编码指定为 'GB18030' 或 'GBK' |
| UTF-8 带 BOM CSV | UTF-8 + 3字节文件头 | 首列表头读取 undefined |
正则清除字符串开头 BOM | text.replace(/^/, '') |
| Excel 2007+ (.xlsx) | ZIP 压缩容器 (OpenXML) | 乱码以 PK.... 开头 |
readAsArrayBuffer + SheetJS |
XLSX.read(buf, { type: 'array' }) |
| Excel 97-2003 (.xls) | BIFF8 二进制复合文档 | 个别中文单元格内容缺失/乱码 | 引入 full 版 SheetJS | 配置项附带 codepage: 936 |
使用async/await处理JavaScript GET请求的异步响应
2026-11-05 20:22:10
JS类型判断方法对比:typeof、instanceof与toString
2026-11-05 20:20:56
JS语法错误会阻止加载吗?区分SyntaxError与资源加载失败
2026-11-05 16:08:46
JavaScript常见SyntaxError语法错误排查与修复方法
2026-11-05 13:58:44
JS中slice、substring和substr截取字符串的区别
2026-11-05 13:43:47