

为什么JS的trim()无法去除某些空格
深入解析JavaScript中String.prototype.trim()无法去除零宽空格、控制字符及内部空格的技术原理,提供精准的Unicode排查诊断方法与实战清洗方案。
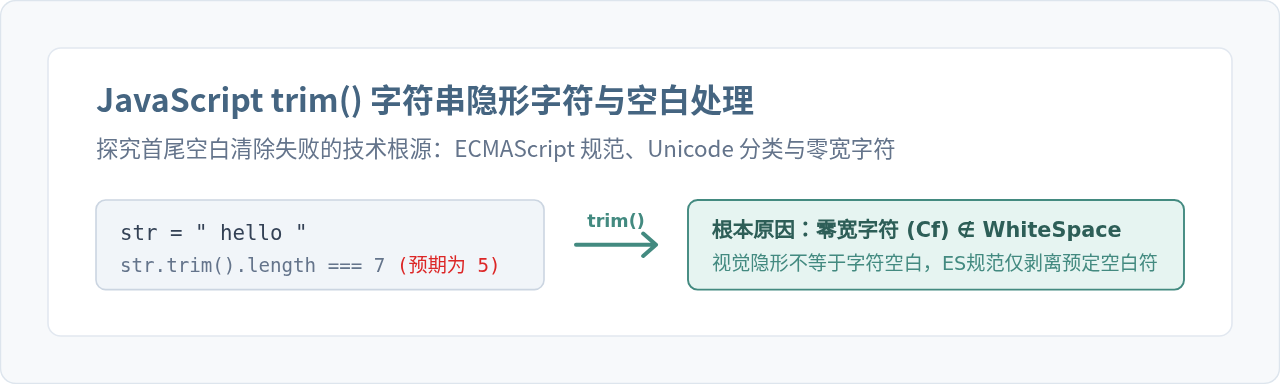
在 JavaScript 中调用 String.prototype.trim() 的核心目的,通常是去除用户输入或外部数据首尾的空白。但在实际开发中,常常会遇到“明明执行了 trim(),字符串打印出来依然带有空白,或者 length 属性依然大于预期”的诡异现象。导致这一问题的根本原因在于:trim() 仅能剥离 ECMAScript 规范明确规定的 WhiteSpace(空白符)与 LineTerminator(行终止符);而日常开发中看起来像空格的字符,大量属于 Unicode 规范中的“格式控制字符(如零宽空格 U+200B)”或不可见控制符,亦或是存在于字符串内部而非首尾。
一、现象重现:看起来是空格,为什么 trim() 视而不见?
在用户注册表单、富文本复制、Excel 数据导入以及网页防爬水印场景中,最容易遇到不可见字符干扰。例如下面这段可以直接在浏览器控制台执行的代码:
// 模拟从外部富文本或复制来源中获取到的字符串
// 开头包含一个零宽空格 (\u200B) 和两个普通半角空格
const rawInput = "\u200B  admin  \u200B";

const result = rawInput.trim();

console.log(result.length);          // 输出: 7 (预期应为 5)
console.log(result === "admin");     // 输出: false
console.log(result.charCodeAt(0));   // 输出: 8203 (十六进制 0x200B)
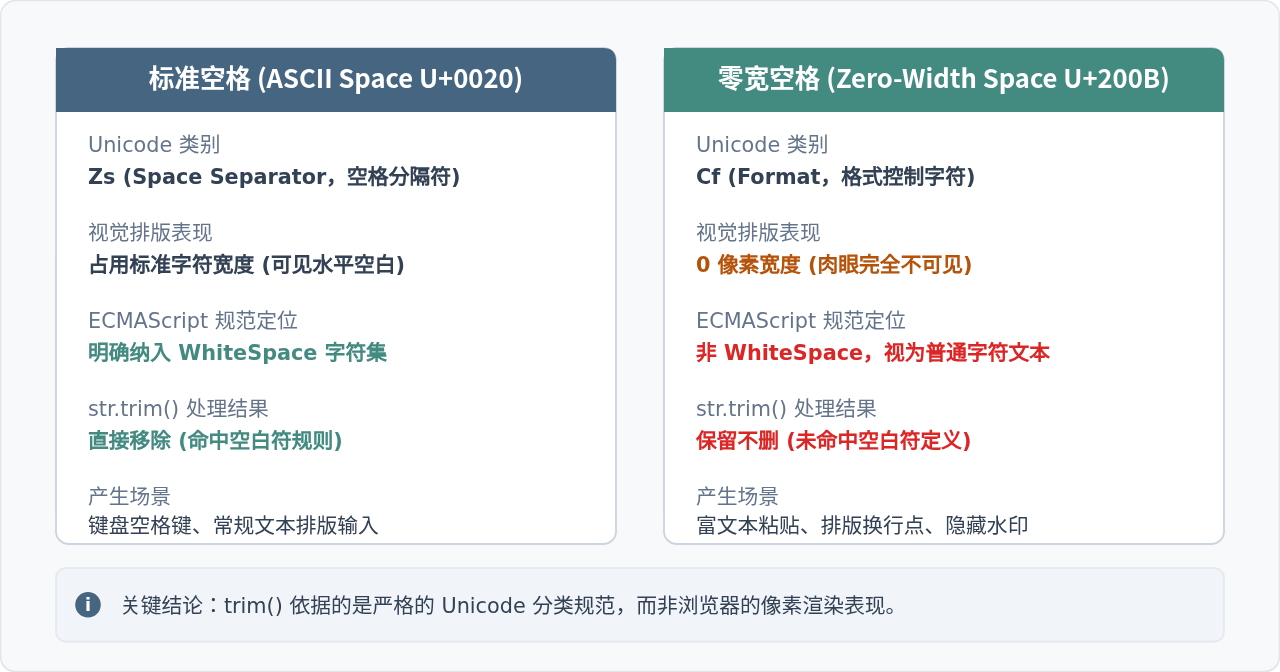
可以看到,两端的标准半角空格确实被 trim() 正确移除了,但位于最外层的 \u200B 却完好无损地保留在字符串中。在视觉渲染上,浏览器将该字符的排版宽度渲染为 0 像素,导致肉眼看起来没有任何文字,开发者误以为它是“删不掉的空格”,但实际上它在内存中依然占据完整的字符位置。
二、规范底层剖析:trim() 到底能删什么,不能删什么?
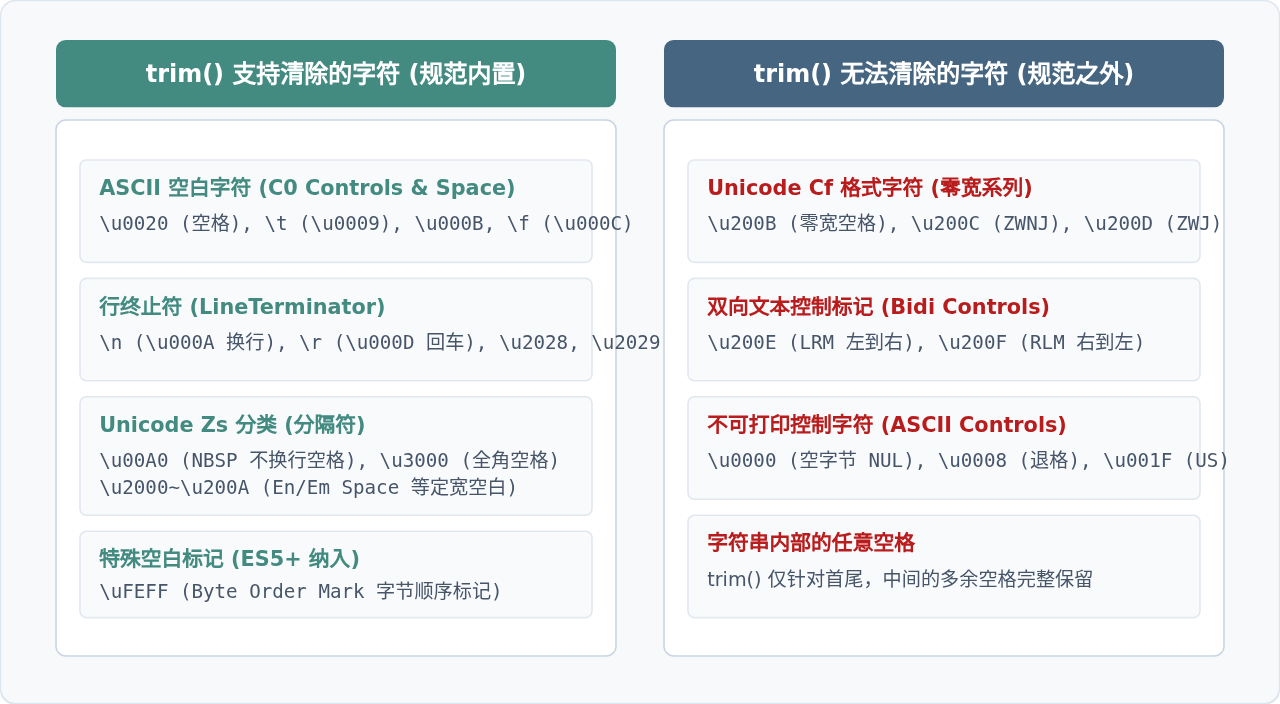
要彻底解决这个问题,需要从 ECMAScript 规范对 trim() 的定义说起。根据规范,trim() 在执行时会从字符串首尾扫描并剔除所有属于以下两类集合的字符:
- WhiteSpace 字符集:包括 ASCII 空格 (
\u0020)、水平制表符 Tab (\u0009)、垂直制表符 (\u000B)、换页符 (\u000C)、不间断空格 NBSP (\u00A0)、字节顺序标记 BOM (\uFEFF),以及所有 Unicode 通用分类为Zs(Space_Separator) 的字符(例如中文全角空格\u3000、En Space\u2002、Em Space\u2003等)。 - LineTerminator 字符集:包括换行符
\n(\u000A)、回车符\r(\u000D)、行分隔符 (\u2028) 以及段分隔符 (\u2029)。
除了上述集合之外的所有字符,trim() 均视其为正式的有效文本内容,绝不会予以清除。无法被去除的常见“伪空格”主要分为以下三类:
1. 零宽格式字符(Unicode Cf 类别)
零宽字符属于“格式字符(Format)”,主要用于排版引擎在特定语言中的连字或断行提示。最常见的包括:
\u200B(Zero Width Space,零宽空格):最普遍的隐形字符,广泛用于前端富文本编辑器定位光标、微信文章防爬标记以及长单词断行。\u200C(Zero Width Non-Joiner,零宽不连字) 与\u200D(Zero Width Joiner,零宽连字):常见于 Emoji 组合与复杂排版脚本中。\u2060(Word Joiner,词连接符):用于阻止自动换行。
2. 低位控制字符与双向文本控制符
例如 C 语言字符串末尾残留的空字符 \u0000 (NUL)、退格键 \u0008 (BS),或者用于阿拉伯语等双向排版的标记 \u200E (LRM)、\u200F (RLM)。它们在控制台或网页上同样不显示可见字形,但分类上均不属于 Zs 或 WhiteSpace。
3. 字符串内部的空白
trim() 仅修剪首尾(Leading & Trailing)。若字符串中间存在多个连续空格、制表符或换行符,例如 "hello world",执行 trim() 后中间的空白依然原封不动。
三、异常排查:如何让“幽灵空格”无所遁形?
当遇到 trim() 处理后字符串依然无法通过校验、或者两个看似相同的字符串 === 比对为 false 时,切忌凭肉眼盲猜。可以通过以下三项具体的排查手段定位隐藏字符:
方法 1:利用 JSON.stringify 显形
在浏览器的 DevTools 控制台直接打印序列化结果,常见不可打印字符与 Unicode 转义符会直接暴露:
const testStr = "\u200B hello";
console.log(JSON.stringify(testStr));
// 示例输出: ""\u200b hello""
方法 2:展开十六进制 Unicode 码位
使用 ES6 的扩展运算符与 codePointAt(),遍历字符串中的每一个字符并输出其实际十六进制编码:
function inspectChars(str) {
return [...str].map(function(char) {
return {
char: char,
codePoint: 'U+' + char.codePointAt(0).toString(16).toUpperCase().padStart(4, '0')
};
});
}
console.log(inspectChars("\u200Bhi"));
// 示例输出:
// [
// { char: '', codePoint: 'U+200B' },
// { char: 'h', codePoint: 'U+0068' },
// { char: 'i', codePoint: 'U+0069' }
// ]方法 3:URL 百分号编码透视
调用 encodeURIComponent(),零宽字符会被转换为特定的 UTF-8 字节序。例如 \u200B 会明确转为 %E2%80%8B:
console.log(encodeURIComponent("\u200B")); // 示例输出: "%E2%80%8B"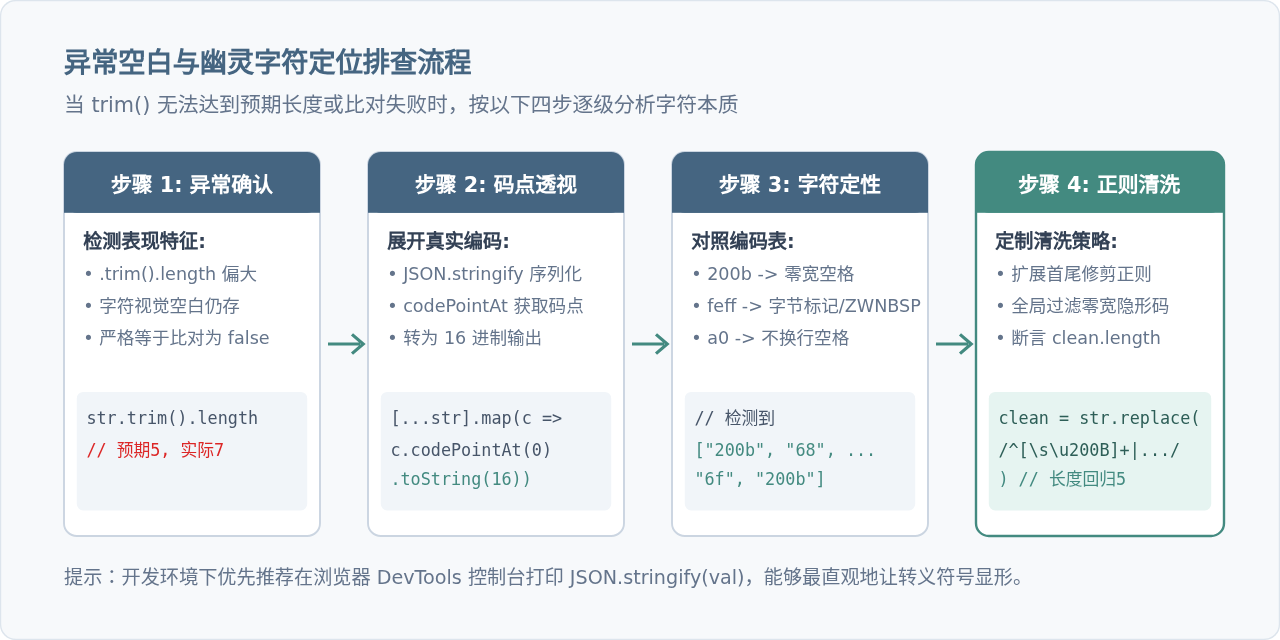
四、解决方案:从针对性修剪到深度净化
针对不同的业务准确性与容错需求,可以采用以下四种标准解决方案:
方案 1:兼容零宽字符的首尾增强修剪(推荐首选)
如果业务目标仍是“去除首尾的空白”,但需要同时剔除零宽字符与 BOM 标记,只需使用正则扩展首尾匹配集合:
/**
 * 强化版 trim:移除首尾的所有标准空白以及零宽字符、BOM
 */
function robustTrim(str) {
  if (typeof str !== 'string') return '';
  return str.replace(/^[\s\u200B-\u200D\uFEFF]+|[\s\u200B-\u200D\uFEFF]+$/g, '');
}

// 验证
const test = "\u200B  hello world  \u200B";
const cleaned = robustTrim(test);
console.log(cleaned);         // 示例输出: "hello world"
console.log(cleaned.length);  // 示例输出: 11 (精准去除首尾全部异常字符)
方案 2:利用 ES2018+ Unicode Property Escapes 现代化修剪
在现代 JavaScript 环境(Node.js 10+、所有主流现代浏览器)中,可以借助正则的 Unicode 属性转义 \p{...} 自动匹配所有空白与默认可忽略码点:
function modernTrim(str) {
  if (typeof str !== 'string') return '';
  // 匹配所有 Unicode 空白字符以及可忽略控制字符
  return str.replace(/^[\p{White_Space}\p{Default_Ignorable_Code_Point}]+|[\p{White_Space}\p{Default_Ignorable_Code_Point}]+$/gu, '');
}
方案 3:全局清除文本内所有零宽隐形垃圾字符
在用户输入订单号、身份证号、银行卡号或密码等严格不允许存在任何隐藏格式字符的场景中,应全局过滤掉文本中的幽灵字符:
function stripInvisibleChars(str) {
  if (typeof str !== 'string') return '';
  // 过滤常见的零宽与格式标记
  return str.replace(/[\u200B-\u200D\uFEFF\u2060]/g, '');
}
方案 4:规整化中间多余空格
若需要将文章标题或搜索词中间连续出现的多个空格、制表符规整为单个标准空格:
function normalizeInnerSpaces(str) {
  if (typeof str !== 'string') return '';
  return str.trim().replace(/\s+/g, ' ');
}

console.log(normalizeInnerSpaces("   JavaScript    进阶    技巧   "));
// 示例输出: "JavaScript 进阶 技巧"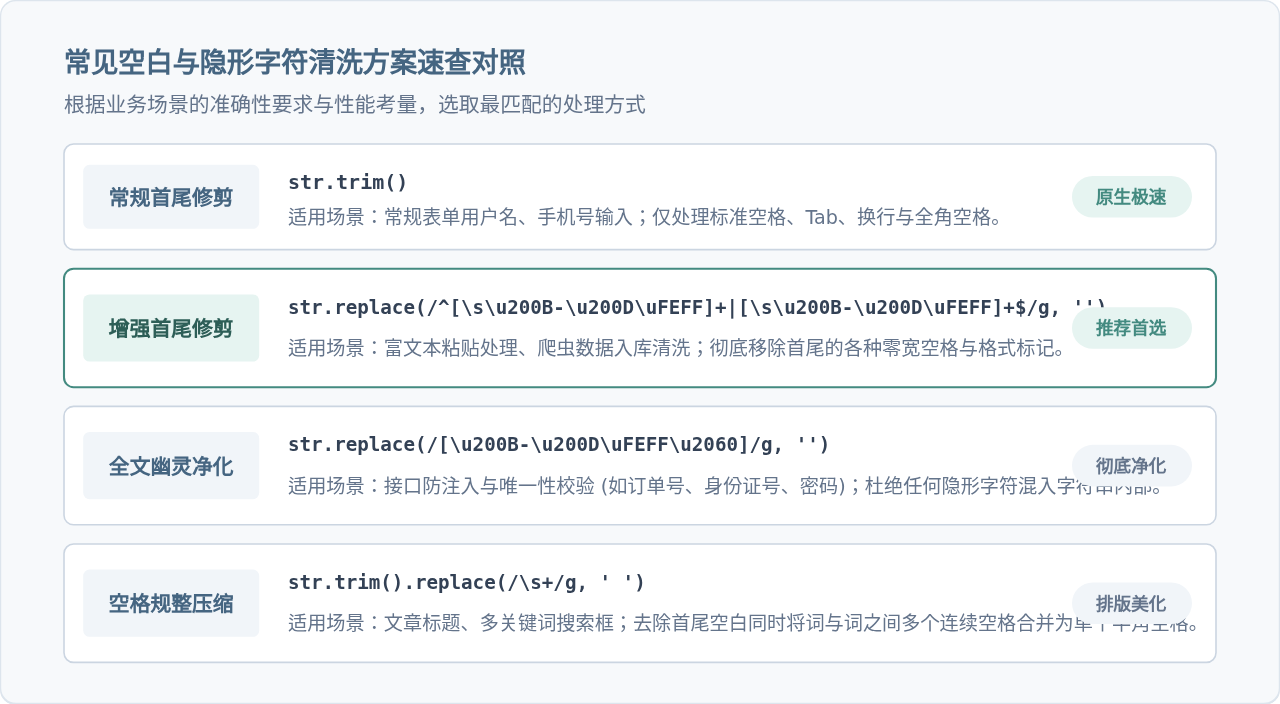
五、工程实践注意事项
在数据持久化和关键接口交互中,前端与后端应建立统一的字符清洗过滤规范。
- 富文本粘贴监听:在富文本编辑器或输入框监听
paste事件时,优先从e.clipboardData.getData('text/plain')提取内容,并统一经过robustTrim()处理后再插入 DOM。 - 前后端双重防线:前端处理仅提升用户体验,后端(如 Node.js、Java、Go 接口)在落库与检索前必须对入参同样做去零宽字符处理,避免数据库因唯一索引包含
\u200B导致查重失效。 - 避免滥杀有益字符:若项目涉及波斯语、阿拉伯语等双向排版文本,或包含复杂的组合 Emoji(如家庭、职业旗帜等),请勿全局盲目剔除
\u200C(ZWNJ) 与\u200D(ZWJ),应仅在首尾针对性修剪。
综上所述,trim() 无法去除某些“空格”并不是 JavaScript 运行时的 Bug,而是严格遵循 ECMAScript 规范与 Unicode 标准的分词机制。遇到异常长度或比对失败时,通过十六进制码点透视还原字符真相,并采用匹配业务场景的正则修剪策略,即可彻底解决不可见字符的干扰。
ES6模块化中js文件怎么用import和export交互
2026-11-05 17:00:48
JS读取本地文件时报错或无响应的常见原因
2026-11-05 16:32:31
let、const与var的区别:JavaScript变量声明最佳实践
2026-11-05 14:16:38
JS中直接定义静态二维数组的字面量写法
2026-11-05 14:16:08
JS 怎么查找字符串中所有匹配项的位置
2026-11-05 14:15:53







