

JS 怎么查找字符串中所有匹配项的位置
详细讲解在 JavaScript 中查找字符串中所有匹配项位置的方法,包括 String.prototype.matchAll()、RegExp.prototype.exec() 以及 indexOf() 循环,分析各方法的适用场景与边界陷阱。
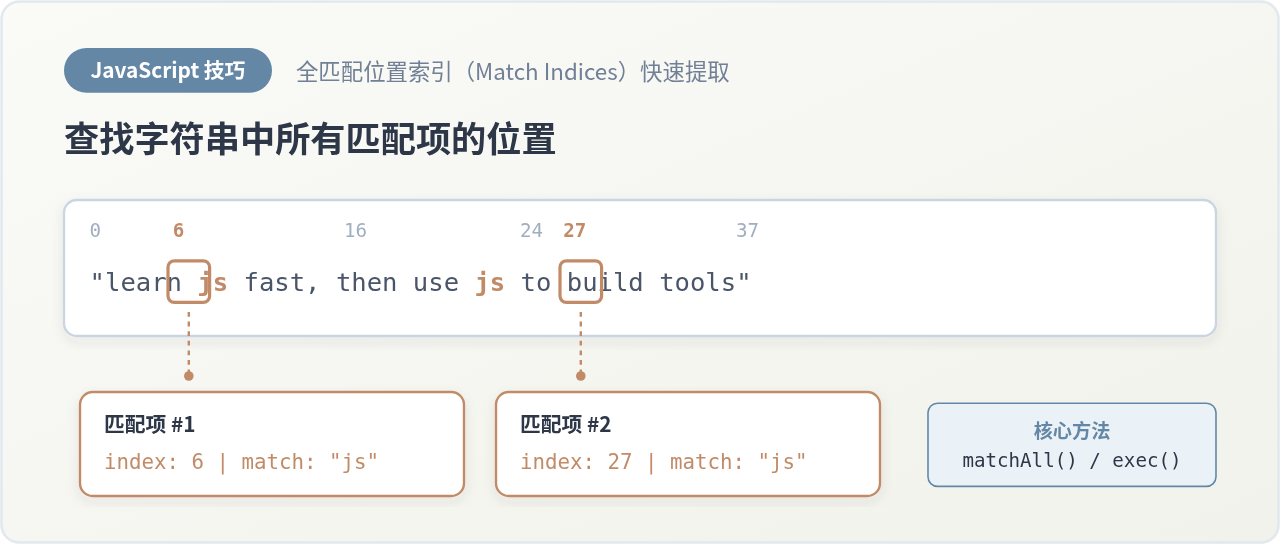
index)。如果使用正则表达式,最简练的现代标准方法是调用 String.prototype.matchAll() 并读取每个结果对象的 index;若需兼容低版本浏览器,则在 while 循环中重复调用 RegExp.prototype.exec();若匹配目标是固定子字符串,使用带位移指针的 indexOf() 循环效率最高且无需处理正则转义。
一、现代标准做法:String.prototype.matchAll()
自 ECMAScript 2020(ES11)起,JavaScript 原生引入了 matchAll() 方法。它是解决“查找所有匹配项及其详细信息(包括位置与捕获组)”的官方推荐标准。与传统的 str.match(/.../g) 仅返回匹配文字数组不同,matchAll() 会返回一个包含完整匹配元数据的迭代器。
1. 完整实现代码
function findAllMatchesWithMatchAll(str, regex) {
  // 必须确保正则携带全局标志 /g
  const globalRegex = regex.global ? regex : new RegExp(regex.source, regex.flags + 'g');
  const results = [];

  for (const match of str.matchAll(globalRegex)) {
    results.push({
      match: match[0],           // 匹配到的具体子串内容
      index: match.index,        // 匹配项在原字符串中的起始位置(0-based)
      length: match[0].length    // 匹配子串长度
    });
  }

  return results;
}

// 示例用法
const content = "learn js, master js, build js apps";
const pattern = /js/g;
const positions = findAllMatchesWithMatchAll(content, pattern);
console.log(positions);
// 示例输出:
// [
//   { match: 'js', index: 6, length: 2 },
//   { match: 'js', index: 17, length: 2 },
//   { match: 'js', index: 27, length: 2 }
// ]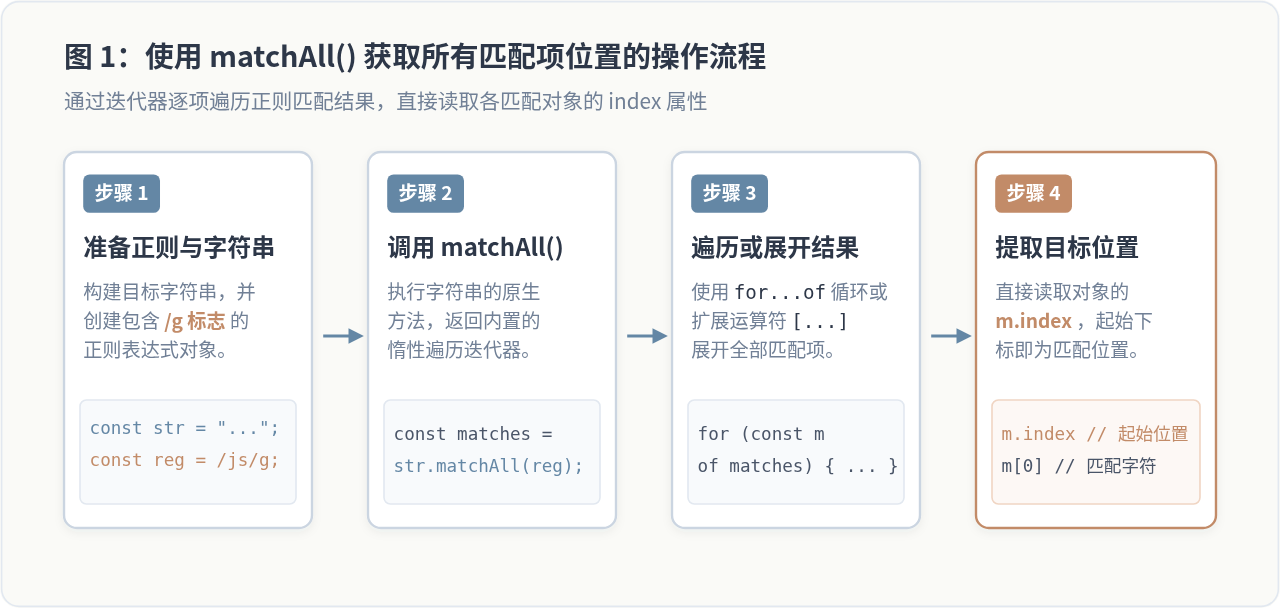
在上面的代码中,str.matchAll(globalRegex) 返回一个迭代器。通过 for...of 循环,每次迭代出来的 match 对象并不是普通字符串,而是与单次 RegExp.exec() 结构一致的丰富数组,其中自带 index 属性,直接表示当前匹配项在源字符串中对应的起始字符下标。
二、经典兼容方案:RegExp.prototype.exec() 循环
在需要兼容老旧环境(如旧版 Node.js 或较早的移动端 WebView)时,RegExp.prototype.exec() 是最经典的通用方案。当正则表达式带有 g 标志时,正则实例对象会内部保留一个名为 lastIndex 的状态属性,记录下一次检索的起始位置。
1. 完整实现代码
function findAllMatchesWithExec(str, regex) {
  // 强制确保携带 g 标志,防止死循环
  const flags = regex.flags.includes('g') ? regex.flags : regex.flags + 'g';
  const safeRegex = new RegExp(regex.source, flags);

  const results = [];
  let match = null;

  while ((match = safeRegex.exec(str)) !== null) {
    results.push({
      match: match[0],
      index: match.index,
      lastIndex: safeRegex.lastIndex
    });

    // 处理零宽匹配避免死循环(如 ^, $, (?=...))
    if (match[0].length === 0) {
      safeRegex.lastIndex++;
    }
  }

  return results;
}

// 示例用法
const text = "cat and cat and cat";
const list = findAllMatchesWithExec(text, /cat/g);
console.log(list);
// 示例输出:
// [
//   { match: 'cat', index: 0, lastIndex: 3 },
//   { match: 'cat', index: 8, lastIndex: 11 },
//   { match: 'cat', index: 16, lastIndex: 19 }
// ]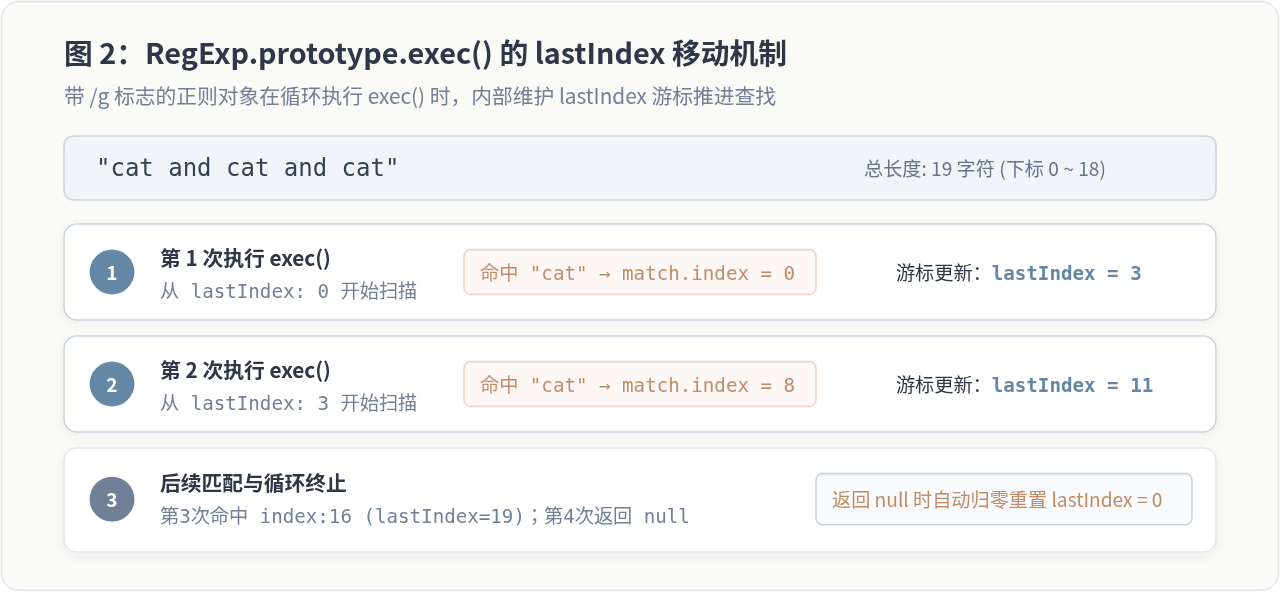
图 2 展示了 exec() 循环的底层运作机制:每次成功匹配后,引擎将 safeRegex.lastIndex 自动推进到当前匹配子串的末尾。下一次调用时,引擎从 lastIndex 位置继续向后搜索,直到搜索完成返回 null,此时 lastIndex 自动归零。
三、纯子串查找:indexOf() 循环方案
如果查找的目标只是普通的固定字符串(例如查找文章中所有关键词 "javascript" 或符号 "//" 的位置),而不是包含通配符或数字范围的复杂模式,使用 String.prototype.indexOf() 是运行开销最低、代码最直白的选择。
1. 完整实现代码
function findAllIndicesOfSubstring(str, target) {
  if (!target || target.length === 0) return [];

  const indices = [];
  let startIndex = 0;

  while ((startIndex = str.indexOf(target, startIndex)) !== -1) {
    indices.push(startIndex);
    // 递增偏移量:跳过已匹配子串的长度,继续向后查找
    startIndex += target.length;
  }

  return indices;
}

// 示例用法
const doc = "apple pie, apple tart, big apple";
const keyword = "apple";
console.log(findAllIndicesOfSubstring(doc, keyword));
// 示例输出:[0, 11, 27]
与正则方式相比,indexOf() 的优势非常鲜明:它不需要创建正则表达式对象,无需解析 DFA/NFA 状态机,性能通常比正则快数倍。更为关键的是,当检索的目标包含正则表达式保留字符(如 .、*、?、$、( 等)时,indexOf() 能够将其作为纯字符原样查找,完全免除了繁琐的正则转义步骤。
四、方案决策与技术选型
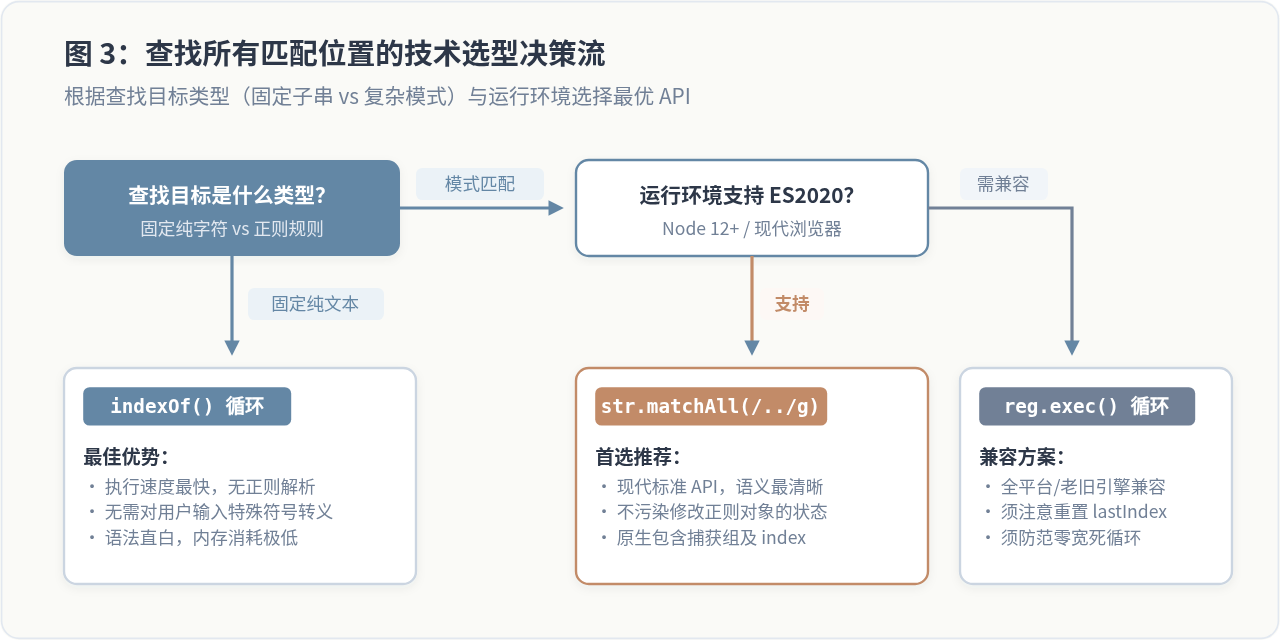
面对不同的业务需求,选择哪种方案取决于“检索目标的性质”以及“项目的运行时环境支持度”。
| 对比维度 | String.prototype.matchAll() | RegExp.prototype.exec() 循环 | String.prototype.indexOf() 循环 |
|---|---|---|---|
| 目标类型 | 正则表达式(支持通配、正则模式) | 正则表达式(支持通配、正则模式) | 固定子字符串(纯文本) |
| 捕获组支持 | 完整支持(自带数组及命名捕获组) | 完整支持(逐次返回) | 不支持 |
| 外部正则污染 | 无副作用(内部复制状态) | 会修改入参正则对象的 lastIndex |
不涉及正则表达式对象 |
| 特殊字符转义 | 需要手动对特殊字符进行转义 | 需要手动对特殊字符进行转义 | 无需转义,直接匹配字面量 |
| 兼容性 | 现代环境(Chrome 73+、Node 12+) | 全部环境(ES3 及以上所有引擎) | 全部环境(原生内置标准方法) |
五、常见陷阱与注意事项
调用
str.matchAll(regex) 时,如果传入的正则表达式没有携带全局标志 g,JavaScript 会立即抛出类型错误(TypeError: String.prototype.matchAll called with a non-global RegExp argument)。若正则来自外部动态生成,务必先检查 regex.global 标志。
当正则表达式可以匹配空字符串时(例如
/\b/g、/(?=a)/g 或带 * 的模式),匹配到的子串长度为 0。此时 exec() 每次执行后 lastIndex 并不会自动递增,导致 while 循环永远卡在同一位置造成浏览器或 Node 进程假死。必须在循环体内检查 if (match[0].length === 0) regex.lastIndex++ 手动前移指针。
JavaScript 中的
index 是基于 UTF-16 代码单元(Code Unit)计算的,而不是视觉上的字形(Grapheme Cluster)。像 "😀" 这类占用两个代码单元的 Emoji,其 length 为 2。如果字符串中包含生僻汉字或 Emoji 表情,在根据 index 截取字符串或计算相对偏移时,建议使用带 u 标志的正则或结合 Intl.Segmenter 进行精细化字符分词。
六、总结
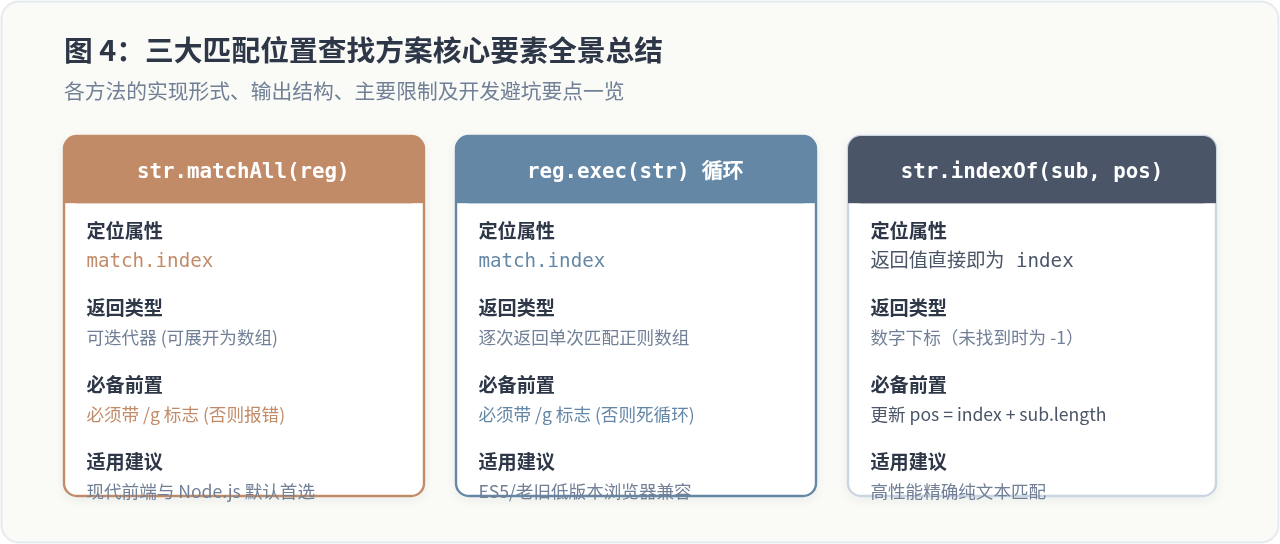
查找字符串中所有匹配项位置是文本高亮、编辑器标记和内容过滤的基础操作。在日常现代开发中,优先使用语义清晰、无状态污染的 str.matchAll(/pattern/g);对于大文本下的纯子串检索,使用 str.indexOf() 配合自增游标能够获得最好的执行效率与安全性。
ES6模块化中js文件怎么用import和export交互
2026-11-05 17:00:48
JS读取本地文件时报错或无响应的常见原因
2026-11-05 16:32:31
let、const与var的区别:JavaScript变量声明最佳实践
2026-11-05 14:16:38
JS中直接定义静态二维数组的字面量写法
2026-11-05 14:16:08
JavaScript新手常犯的编码错误与最佳实践指南
2026-11-04 22:12:38







