

Node.js中生成唯一标识符的最佳实践
系统讲解Node.js中生成唯一标识符的最佳实践,深入对比内置crypto.randomUUID()、RFC 9562标准的UUID v7、Nano ID与ULID的技术实现、底层字节结构、密码学安全及数据库B-Tree索引写入性能。
Math.random() 拼接时间戳,或不加思索地全盘使用 UUID v4。本文将系统梳理 Node.js 内置的 crypto.randomUUID()、全新的 RFC 9562 标准 UUID v7、紧凑型 Nano ID 以及时间有序的 ULID,结合底层二进制结构与 B-Tree 索引性能机理,为你的工程实践提供明确的选型与落地指南。
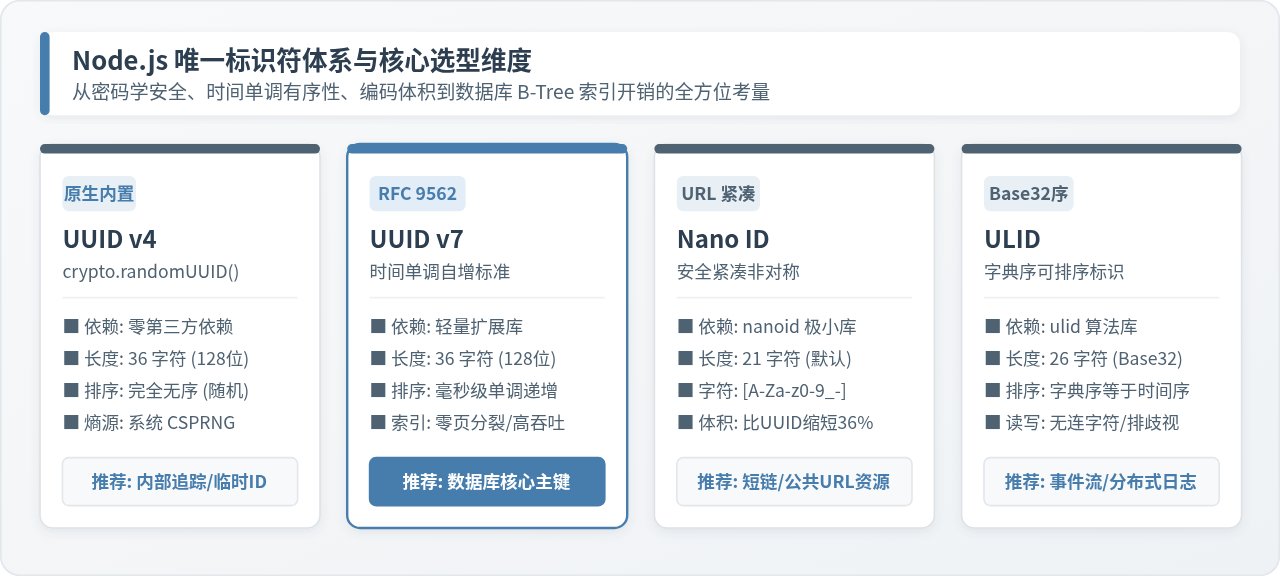
一、为什么坚决不能用 Math.random() 拼接时间戳?
在很多早期教程或原型代码中,常能见到类似 Date.now().toString(36) + Math.random().toString(36).substring(2) 的写法。这种做法在实际生产环境中存在致命的安全漏洞与碰撞风险。
根本原因在于,JavaScript 引擎(如 V8)中的 Math.random() 采用的是 xorshift128+ 伪随机数算法(PRNG)。它并不是密码学安全的伪随机数生成器(CSPRNG)。只要攻击者收集到该实例生成的若干个连续输出,就能推断出随机数发生器的内部内部状态种子,从而精准预测后续生成的全部标识符。如果此类 ID 用于重置密码令牌、订单号或会话标识,将导致越权与仿冒攻击。
此外,在高并发服务或分布式部署环境下,Date.now() 仅提供毫秒级精度。当多个 Node.js 进程(或容器实例)在同一毫秒内处理突发流量时,时间戳完全重合;而 Math.random() 截取后的随机熵通常不足 40 位,根据生日悖论(Birthday Paradox),高频写入时极易发生物理主键碰撞,导致数据库抛出唯一约束冲突异常。
/dev/urandom 或 Windows CryptoAPI)。在 Node.js 中,必须使用 node:crypto 模块或基于该模块封装的合规工具库。
二、原生首选:Node.js 内置 crypto.randomUUID()
如果你使用的是 Node.js 14.17.0+ 或 16.0.0+(以及目前所有主流 LTS 版本),Node.js 已经原生内置了 crypto.randomUUID() 方法。从 Node.js 19 开始,该方法还在全局作用域 globalThis.crypto 下完整支持,完全对齐 Web Crypto API 标准。
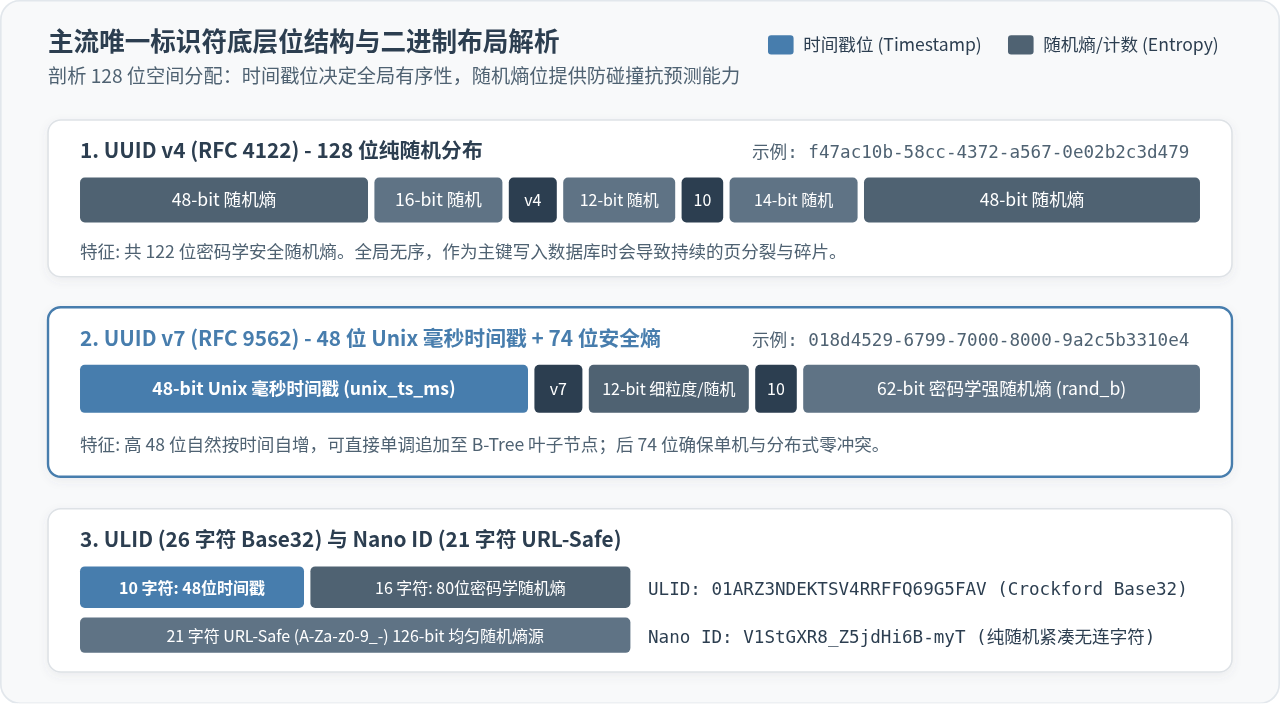
crypto.randomUUID() 生成符合 RFC 4122 标准的 UUID v4(版本 4,完全基于随机数)。其总长度为 128 位(16 字节),去除固定的 4 位版本号与 2 位变体位后,拥有高达 122 位的安全随机熵。
1. 基础用法与代码示例
// 引入 Node.js 内置 crypto 模块
import { randomUUID } from 'node:crypto';

// 生成标准的 36 字符 UUID v4 (包含 4 个连字符)
const traceId = randomUUID();
console.log(traceId);2. 原生优势与适用边界
- 零外部依赖:不需要在
package.json中引入第三方的uuidnpm 库,不仅减小了node_modules体积与打包耗时,更规避了潜在的供应链安全风险。 - 极速 C++ 绑定:该方法直接在 Node.js 底层 C++ 层通过 OpenSSL 的
RAND_bytes抽取系统熵,并直接格式化为字符串,性能大幅优于在 JS 堆内存中频繁创建 Uint8Array 并循环拼接十六进制。 - 核心场景:极其适合作为服务间调用的链路追踪 ID(Trace ID / Request ID)、无状态任务作业 ID、短生命周期的会话令牌。
然而,UUID v4 的致命弱点在于其全局离散性与完全无序性。如果你将它直接作为 MySQL InnoDB 或 PostgreSQL 关系型数据库的聚簇索引主键,在数据量达到数百万级后,写入吞吐量将出现悬崖式下跌。
三、数据库主键新宠:时间有序的 UUID v7 (RFC 9562)
针对 UUID v4 在数据库存储中的性能瓶颈,互联网工程任务组(IETF)在 2024 年正式发布了 RFC 9562,推出了新一代 UUID 标准,其中最核心的演进就是 UUID v7。
UUID v7 在保持 128 位长度和经典 8-4-4-4-12 字符串格式完全兼容的前提下,将高 48 位设计为 Unix Epoch 毫秒时间戳,中间包含 4 位版本标识(固定为 7)以及 12 位亚毫秒增量/随机数,最后 64 位包含 2 位变体位与 62 位密码学安全随机熵。
1. 在 Node.js 中生成 UUID v7
在 Node.js 中,你可以通过标准的 uuid 库(v10+ 已正式原生支持 v7)或极轻量的 uuidv7 库快速生成:
// 安装支持 RFC 9562 的现代库: npm install uuid
import { v7 as uuidv7 } from 'uuid';

// 生成具有时间单调有序性的 UUID v7
const primaryKey1 = uuidv7();
const primaryKey2 = uuidv7();

console.log('Record 1:', primaryKey1);
console.log('Record 2:', primaryKey2);2. 原生零依赖手写 UUID v7 产生器
如果你希望在项目中完全不引入外部依赖,仅基于 Node.js 内置 node:crypto 模块,也可以用几十行原生代码实现高标准的 UUID v7 构造:
import { randomBytes } from 'node:crypto';

/**
 * 原生实现符合 RFC 9562 的 UUID v7 生成器
 */
export function generateUUIDv7(): string {
  const value = randomBytes(16);
  const now = Date.now();

  // 将 48 位 Unix 毫秒时间戳写入前 6 个字节
  value.writeUIntBE(Math.floor(now / 0x100000000), 0, 2);
  value.writeUIntBE(now % 0x100000000, 2, 4);

  // 设置版本号为 7 (二进制 0111xxxx -> 第 6 字节高 4 位)
  value[6] = (value[6] & 0x0f) | 0x70;
  // 设置变体为 RFC 4122/9562 (二进制 10xxxxxx -> 第 8 字节高 2 位)
  value[8] = (value[8] & 0x3f) | 0x80;

  // 格式化为标准 8-4-4-4-12 十六进制字符串
  const hex = value.toString('hex');
  return `${hex.slice(0, 8)}-${hex.slice(8, 12)}-${hex.slice(12, 16)}-${hex.slice(16, 20)}-${hex.slice(20, 32)}`;
}
四、数据库索引性能:随机 ID vs 有序 ID 对 B-Tree 的冲击
为了真正理解为什么 UUID v7 和 ULID 是数据库主键的最佳实践,我们必须探究存储引擎底层的 B+Tree 聚簇索引组织形式。
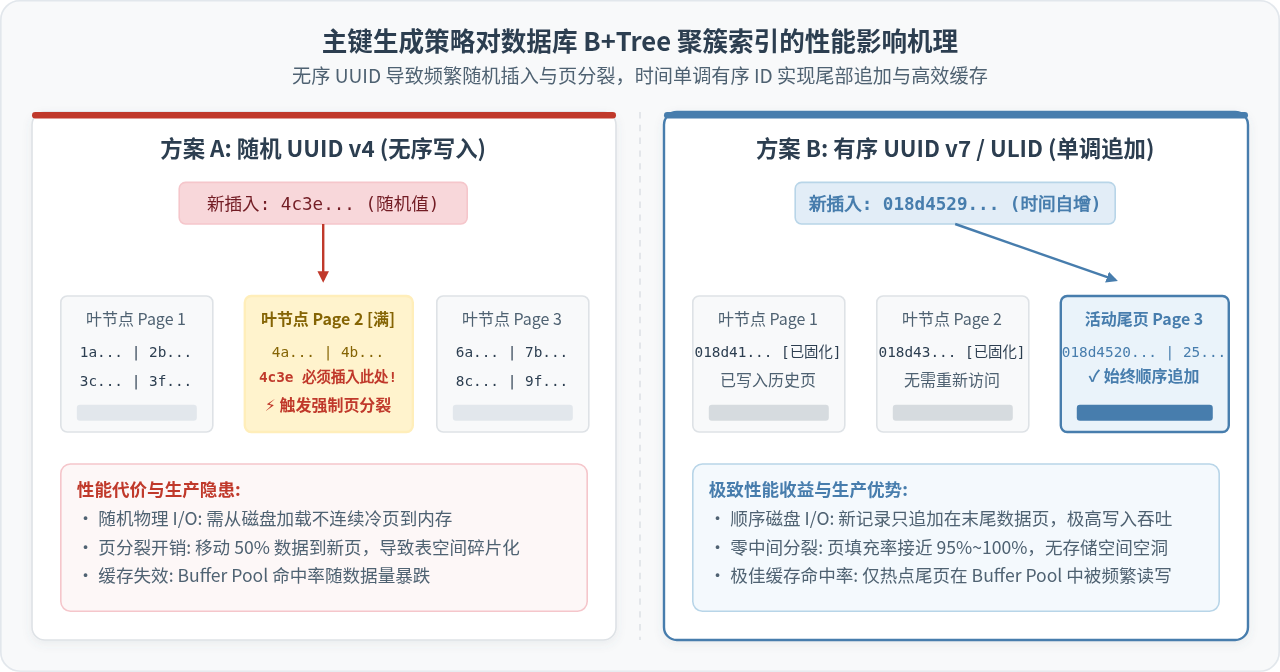
主流关系型数据库(如 MySQL InnoDB)通常采用聚簇索引(Clustered Index)组织主键,所有行记录都存放在 B+Tree 的叶子节点物理页(Page,默认 16KB)中,且叶子节点内部按主键大小严格顺序排列。
- 使用 UUID v4 的悲剧:因为其取值完全随机,新生成的每一条记录的主键都在整个键空间内离散分布。数据库无法预测它将被插入到哪一个物理页。当目标物理页已经写满时,InnoDB 必须执行昂贵的页分裂(Page Split)操作——分配一个全新的数据页,并将原页中约 50% 的数据迁移到新页,同时调整父节点的指针。这不仅导致大量的磁盘随机读写,使页填充率下降至 50% 甚至更低(产生大量表空间碎片),更会因为工作集超出内存而使 InnoDB Buffer Pool 频繁换页,写入吞吐量直线暴跌。
- 使用 UUID v7 / ULID 的优势:由于高位是单调递增的时间戳,新插入的记录永远紧随其后,被直接追加到当前 B+Tree 最右侧的活跃数据页尾部。这种顺序追加写入(Sequential Write)机制消除了中间页分裂,物理页填充率可以达到 95% 以上,且只需要将当前最新的热点数据页常驻缓存,大幅解放了磁盘 I/O 资源。
五、URL 与网络紧凑场景:Nano ID 与 ULID
标准 UUID(无论是 v4 还是 v7)都有一个历史包袱:由于采用十六进制编码并带有 4 个连字符,其字符串形式固定占用 36 个字符。如果需要将其放在 URL 查询参数、短链接路径或高吞吐的 JSON API 响应中,体积就会显得偏大且排版不够整洁。
1. 轻量而坚固的 Nano ID
Nano ID 是现代前端与 Node.js 社区极度流行的唯一标识符库。它默认仅使用 21 个字符,采用 URL 安全的字符集(A-Za-z0-9_-),在网络传输和 URL 路径中无需做任何转义。
- 体积优势:默认 21 字符拥有 126 位随机熵,抗碰撞能力与 UUID v4 相当,但传输体积比 36 字符的 UUID 缩短了整整 36%。
- 极速与零依赖:核心代码体积仅 130 字节左右,底层同样依赖 Node.js 系统的
crypto.randomFillSync,随机性非常稳健。 - 可自定义字典:允许开发者按需定制字符集与长度(例如在生成兑换码、验证码时排除易混淆的
0, O, I, l)。
// 安装依赖: npm install nanoid
import { nanoid, customAlphabet } from 'nanoid';

// 默认 21 字符 URL-Safe ID
const fileShareId = nanoid();
console.log('Share ID:', fileShareId);

// 自定义纯大写数字字典,长度 10 (适用于订单展示号或兑换码)
const generateOrderCode = customAlphabet('346789ABCDEFGHJKLMNPQRTUVWXY', 10);
console.log('Order Code:', generateOrderCode());2. 兼顾字典序与无歧义的 ULID
ULID(Universally Unique Lexicographically Sortable Identifier)专为兼顾“可排序”与“紧凑排版”而设计。
它同样占用 128 位二进制空间,编码为 26 个字符,采用 Crockford's Base32 编码规范(数字加字母,严格排除了易混淆的 I, L, O, U)。其前 10 字符为 48 位毫秒时间戳,后 16 字符为 80 位随机熵。其核心特性是字符串字典序与时间产生顺序严格一致。
// 安装依赖: npm install ulid
import { ulid } from 'ulid';

const eventId = ulid();
console.log('Event ID:', eventId);六、工程选型步骤与决策路径
面对多样化的方案,技术团队不应简单凭感觉做决定,而应按照清晰的判定顺序进行选型。以下是一套行之有效的四步决策法:
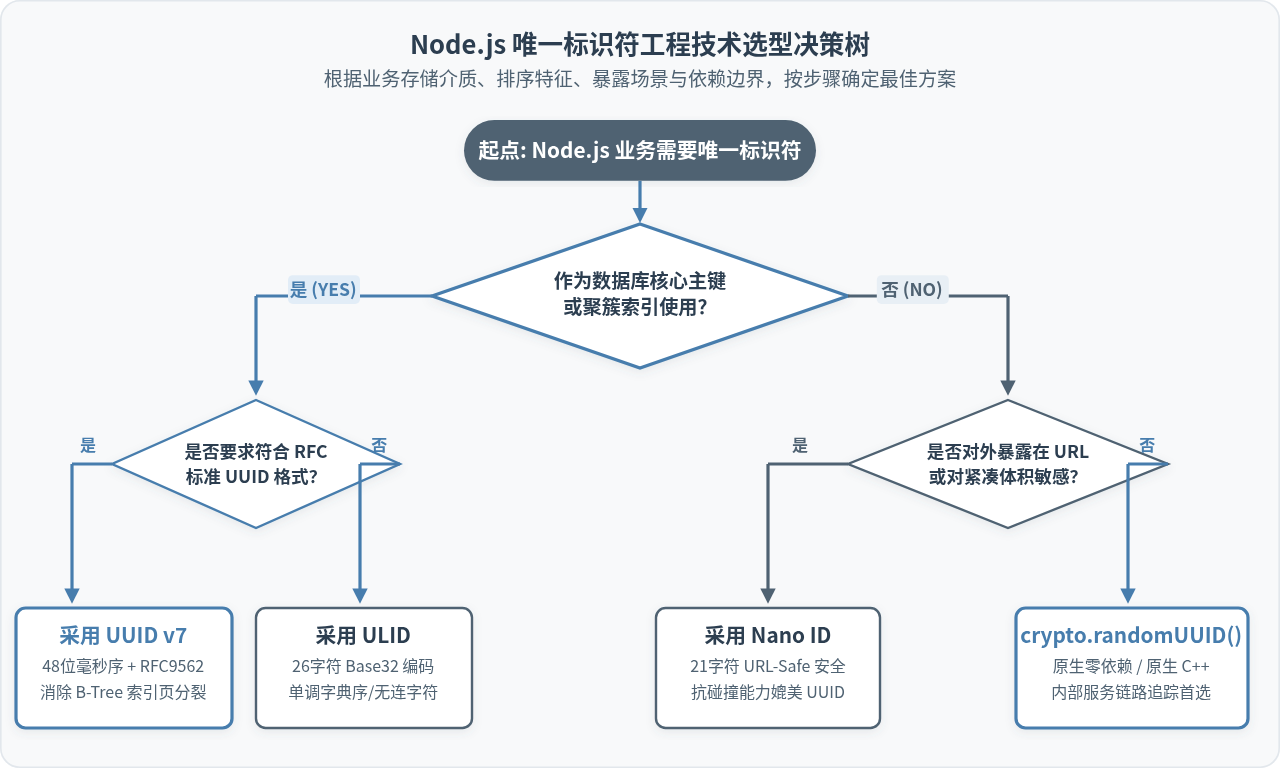
- 步骤一:判定是否作为关系型数据库主键。如果该标识符需要作为 MySQL、PostgreSQL 等数据库的聚簇主键或高频索引字段,第一优先级选择 UUID v7(或 ULID)。绝不要选用纯随机的 UUID v4 或 Nano ID 作为大规模表的主键,否则会导致灾难性的 B-Tree 页分裂与写入减速。
- 步骤二:判定是否直接暴露在公开 URL 中。如果是面向用户的公开资源访问路由、短链接、文件下载链接,需要兼顾美观与网络传输开销,首选 Nano ID。它没有冗长的连字符,体积小 36%,且不受 URL 规范转义困扰。
- 步骤三:判定是否属于内部链路追踪或临时上下文。如果该标识符仅在服务器内存、微服务 RPC Header、日志系统(如 Winston/Pino)中作为 Request ID 流转,首选 Node.js 内置
crypto.randomUUID()。它具备零依赖、原生 C++ 性能及符合标准的优势。 - 步骤四:判定是否存在业务安全防推断需求。由于 UUID v7 和 ULID 前半部分是完全明文的毫秒时间戳,任何获取到该 ID 的客户端都能精确解析出其创建的具体时间。如果该 ID 作为订单号或用户公开 ID,竞对可能会通过采样计算你的日订单增长速率。对于这种敏感业务场景,应使用 Nano ID 或无序 UUID,或者在时间戳上增加业务混淆层。
七、生产落地准则与优化避坑指南
选定生成方案后,在实际工程落地中还需要遵循以下最佳实践细节:
1. 数据库存储介质优化:切忌使用 VARCHAR(36)
虽然 UUID 打印出来是 36 字符的文本,但在数据库中,推荐优先使用专门的 UUID 原生列类型(PostgreSQL),或者在 MySQL 中使用 BINARY(16) 存储底层 16 字节原始数据。
// 在 Node.js 中将 36 字符 UUID 快速转换为 16 字节 Buffer
function uuidToBinary(uuidStr: string): Buffer {
  return Buffer.from(uuidStr.replace(/-/g, ''), 'hex');
}

// 从数据库查询出来的 BINARY(16) 还原为标准 UUID 字符串
function binaryToUuid(buf: Buffer): string {
  const hex = buf.toString('hex');
  return `${hex.slice(0, 8)}-${hex.slice(8, 12)}-${hex.slice(12, 16)}-${hex.slice(16, 20)}-${hex.slice(20, 32)}`;
}
使用 BINARY(16) 相比 VARCHAR(36)(在 utf8mb4 下更占用较多字节)能节省超过 55% 的磁盘与索引内存开销。在亿级数据量下,这意味着几十分钟到几个小时的索引维护时间差距,以及数十 GB 的内存缓存节省。
2. 超高并发场景下的熵池性能优化
在普通的单机数千 QPS 场景下,直接调用 crypto.randomUUID() 的性能已经绰绰有余(现代硬件上单核每秒通常可生成数十万个 UUID)。但在极端的高吞吐网关或日志打点场景下,频繁发起系统调用从操作系统 CSPRNG 提取随机字节会产生上下文切换开销。
对于此类极限场景,成熟的做法是采用预分配内存缓冲区(Buffered Entropy Pool)。即一次性通过 crypto.randomFillSync 批量拉取 64KB 的随机字节存入内存池,在用户请求时直接通过指针切分偏移量,耗尽后再触发下一次批量填充。这种设计可以在保持密码学安全的前提下,将单次生成的 CPU 消耗降至极限。
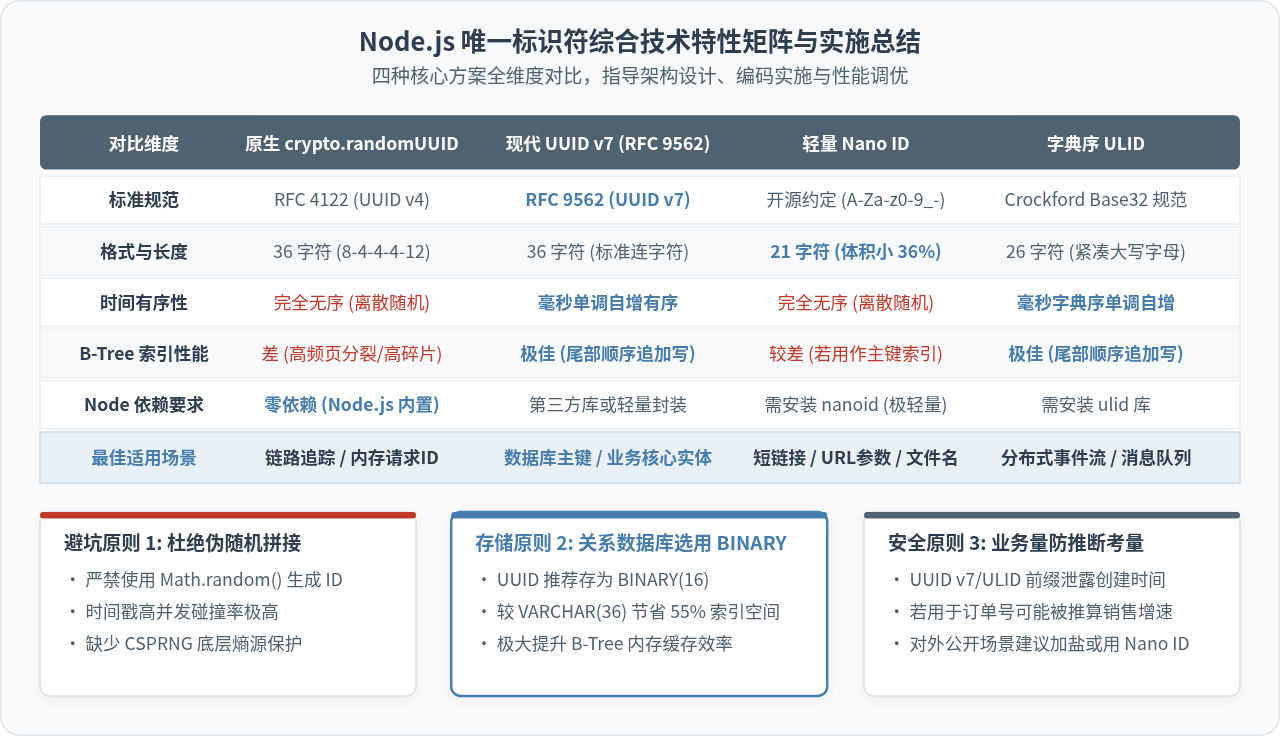
八、全文总结
在 Node.js 中生成唯一标识符绝非简单的函数调用,而是一项兼顾安全性、工程维护性与底层存储性能的架构决策。我们可以将核心结论浓缩为三条黄金法则:
- 微服务内部流转与追踪:坚定使用内置的
crypto.randomUUID(),享受零依赖、原生优化与标准兼顾带来的便利。 - 数据库核心主键与聚簇索引:全面拥抱全新的 UUID v7(或 ULID),利用时间单调有序性彻底消除 B-Tree 索引页分裂,保障高并发写入下的持续吞吐。
- 面向用户的公开资源与 URL 传参:优先选用 Nano ID,以紧凑优雅的 URL-Safe 编码降低传输开销并提升人眼可读性。
淘汰已经过时的伪随机数拼接做法,根据具体业务边界匹配最合适的标识符形态,是构建稳健、高效 Node.js 后端系统的坚实基石。
Node.js中使用path模块获取文件名
2026-11-05 15:15:15
Node.js中url模块与querystring模块处理查询字符串的区别
2026-11-05 15:04:45
JavaScript(JS)主要用来做什么
2026-11-05 10:10:47
怎么修改Node.js和npm的全局安装路径与缓存目录
2026-11-04 19:48:28
NW.js 常见问题排查:Node 模块加载失败与版本兼容解决
2026-11-04 11:22:45







