JS修改DOM内容:innerHTML、textContent与innerText怎么选
深入对比JavaScript中修改与读取DOM内容的三个核心属性:innerHTML、textContent与innerText。从浏览器底层渲染机制、回流重排性能损耗、XSS安全漏洞防范到实际业务决策树,指导前端开发者做出最佳选择。
发布时间:2026-11-01 · 类别:Web 前端规范与工程实践 · 适用对象:JavaScript 开发者
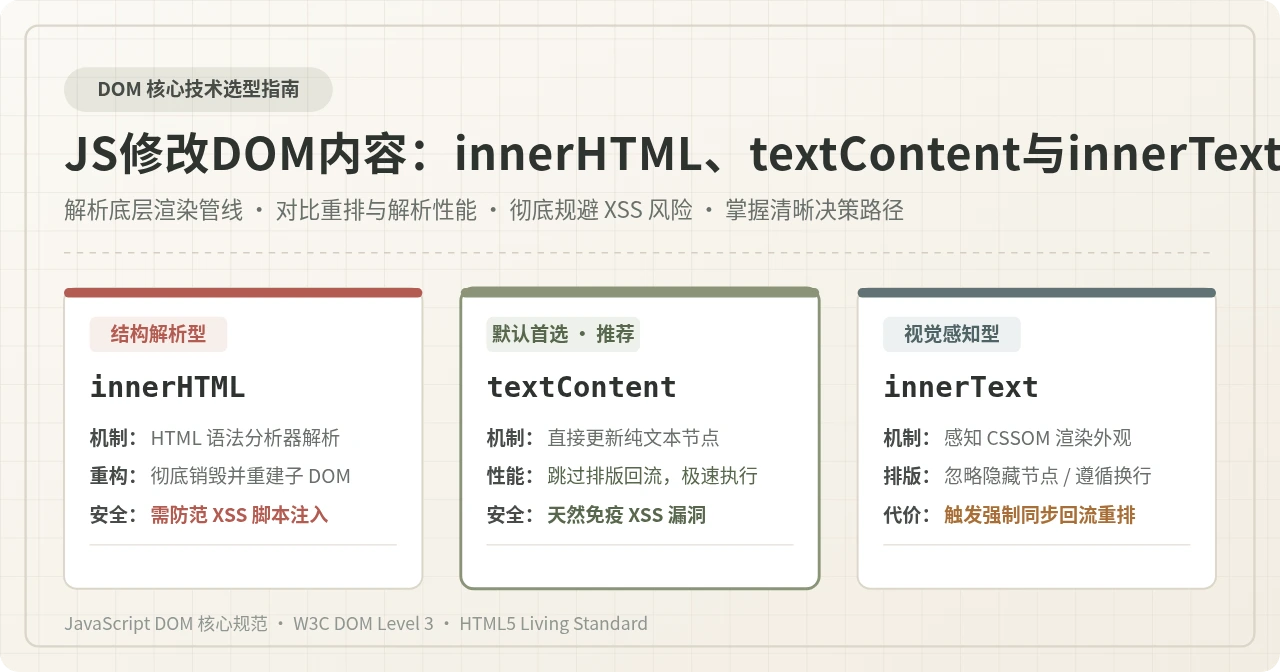
知识卡片:innerHTML、textContent 与 innerText 关键特性与工程定位速览
textContent(性能最高、行为稳定且天然杜绝 XSS 注入);只有在需要解析渲染 HTML 标签片段时才选用 innerHTML(且凡涉及用户输入必须配合净化库过滤);只有在需要感知 CSS 渲染外观、忽略隐藏文本或遵循视觉排版折行时才使用 innerText(需警惕频繁读取触发的回流重排损耗)。
一、三者的底层机制与浏览器处理管线
虽然这三个属性在日常代码中经常被用来“向页面塞入文字或替换区域”,但在浏览器内部的执行链路上,它们走的是完全不同的引擎通道。理解这三条流水线,是做出理性技术选型的前提。
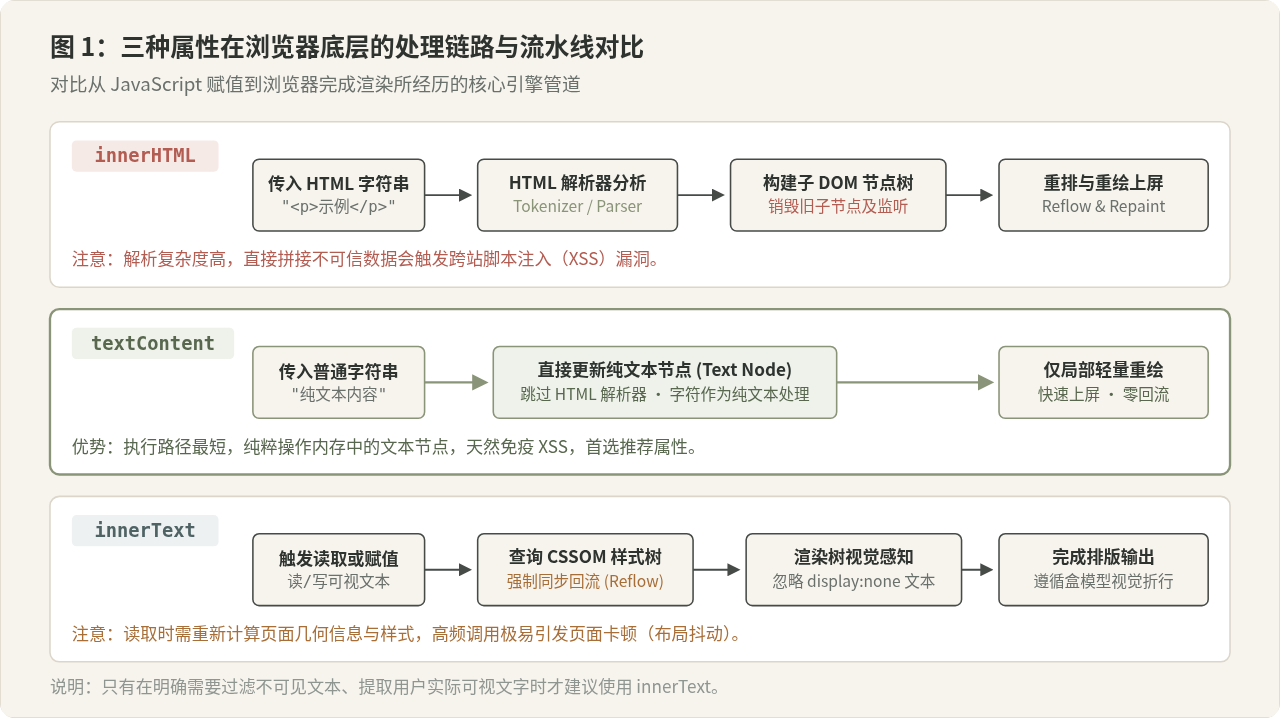
图 1:从 JavaScript 赋值到浏览器完成渲染的三种底层处理管线对比
1. innerHTML:触发完整的 HTML 词法分析与 DOM 重构
innerHTML 读写的是元素内部的 HTML 语法标记序列。当对一个元素的 innerHTML 赋值时,浏览器并不仅仅是将字符串贴入页面,而是启动内部完整的 HTML 解析器(HTML Tokenizer 与 Parser),逐字进行词法分析,构建全新的子 DOM 节点树,随后挂载到目标元素下。
这种机制带来了两个非常关键的工程后果:
- 销毁原有子节点与事件监听器:即便你只在原内容后追加一个字符,赋值操作也会强制销毁目标容器下所有已有的子 DOM 节点,并重新生成一套新的节点。这意味着先前通过
addEventListener绑定的所有事件函数将彻底失效,非常容易引发隐蔽的业务 Bug 或内存泄露。 - 脚本注入安全风险(XSS):HTML 解析器会将字符串中的标签还原为活动元素。如果字符串来源于未经处理的用户输入(如富文本评论、URL 参数、表单字段),恶意用户注入的
<img src=x onerror=alert(1)>便会立即在受害者浏览器中执行。
2. textContent:高效轻量的纯文本节点更新
textContent 是由 W3C DOM Level 3 正式制定的标准属性。它的语义十分纯粹:读取或设置节点及其所有后代节点的文本内容(Text Node)。
在写入时,浏览器会直接将传入的字符串当作纯字符处理,既不启动 HTML 词法解析器,也不会将 <div> 解析为元素标签,而是自动将其转义为纯文本。在底层,浏览器仅需更新或创建单一的 TextNode 并更新其内存中的数据。整个过程完全绕过了样式计算(CSSOM)和布局重排,执行速度处于数量级级别的领先优势。
3. innerText:高度依赖 CSSOM 与渲染树的视觉感知接口
innerText 最早源于旧版 Internet Explorer 4 的私有扩展,后来由于在特定业务场景下的实用性被纳入了 WHATWG HTML Living Standard。它的核心特征在于 Aware of Styling and Layout(具备样式与排版感知能力)。
读取 innerText 时,浏览器必须结合当前的 CSS 样式表(CSSOM)和排版布局树(Layout/Render Tree)来计算“一个真实用户在屏幕上能看到什么文字”。如果元素设置了 display: none,或者属于不可见的 <script>、<style> 标签,innerText 会智能将其过滤;遇到块级元素如 <p> 或 <br> 时,它会主动将排版折行换算为换行符
。正因如此,调用 innerText 往往会触发强制同步回流(Forced Synchronous Layout),如果将其写在循环或滚动事件中,极易引起页面严重的掉帧与卡顿。
二、真实 DOM 场景下的读写行为差异对比
为了直观展现三者的行为差异,我们构建一个包含“普通文字”、“隐藏节点”、“换行标签”与“样式代码”的典型 DOM 节点:
<!-- 测试容器 HTML 结构 -->
<div id="demo">
  欢迎访问 <strong>技术专栏</strong>
  <span style="display: none;">(内部草稿内容)</span>
  <p>第二行段落</p>
  <style>body { margin: 0; }</style>
</div>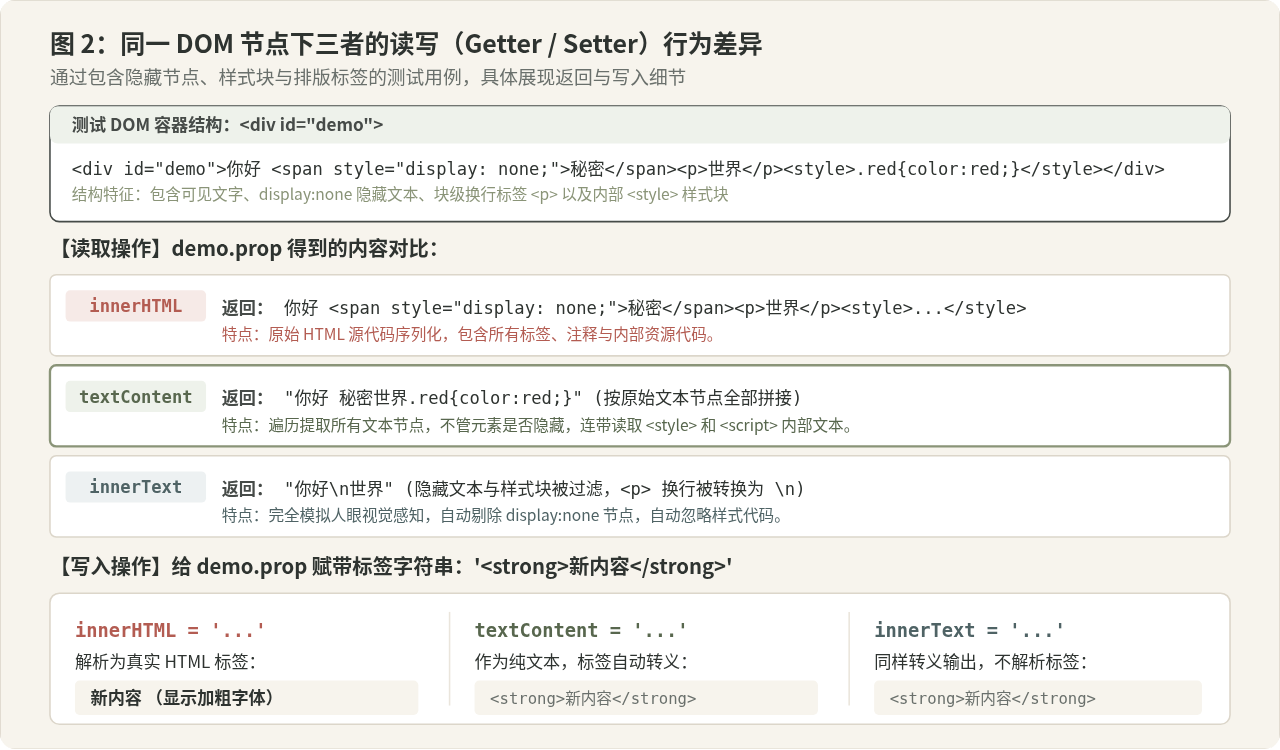
图 2:针对同一 DOM 节点进行读取(Getter)与写入(Setter)时的表现差异
1. 读取操作(Getter)的具体差异
对上述相同的 demo 元素分别调用读取接口,控制台输出的结果截然不同:
| 调用的属性 | 实际返回的字符串结果 | 内部处理特性分析 |
|---|---|---|
demo.innerHTML |
欢迎访问 <strong>技术专栏</strong> <span style="...">(内部草稿内容)</span> <p>第二行段落</p> <style>...</style> |
返回原始 HTML 序列,包含全部子标签、隐藏属性以及内嵌样式代码,原汁原味。 |
demo.textContent |
"欢迎访问 技术专栏 (内部草稿内容) 第二行段落 body { margin: 0; }" |
递归抓取所有子代文本节点。即便通过 CSS 隐藏了文字,或者处于 <style> 中,也会全部拼接返回。 |
demo.innerText |
"欢迎访问 技术专栏
第二行段落" |
完全模拟人眼视觉所见:自动剥离隐藏文本与样式代码,同时将块级元素 <p> 换算为真实的换行符
。 |
2. 写入操作(Setter)的具体差异
当执行赋值操作 demo.xxx = "<em>新内容</em>" 时:
demo.innerHTML = "<em>新内容</em>":浏览器将<em>解析为斜体标签,页面上会呈现出斜体的“新内容”。demo.textContent = "<em>新内容</em>":浏览器将其完全视为纯字符串,页面上会完整显示字符<em>新内容</em>,无任何解析与格式转换。demo.innerText = "<em>新内容</em>":同样作为纯字符串展示,不解析标签,但在字符串内含有<br>节点或文本分段。
三、常见认知混淆与误区辨析
混淆一:“innerText 和 textContent 差不多,随便选哪一个都行?”
辨析与修正:这种看法非常普遍,但往往会在复杂页面或性能敏感场景下引发严重隐患。虽然在最简单的“一个没有样式的普通 span”上赋值纯文字时,两者呈现的效果看似一样,但背后的计算逻辑存在本质差别:
textContent只关心 DOM 树本身,读取和赋值都只在内存中的 DOM 节点上操作,不会查询样式表,不触发页面重排(Reflow),执行效率极高。innerText读取时必须向渲染引擎查询元素的实际布局状态。如果你在一个长列表遍历中频繁读取element.innerText,就会导致浏览器在每一帧内不断强制计算样式与几何位置,产生典型的布局抖动(Layout Thrashing)。
因此,“只要处理纯文本就随意使用 innerText”的习惯是不正确的。只有在确实需要过滤不可见文字或转换排版换行时才用 innerText,其余纯文本场景应始终统一使用 textContent。
混淆二:“innerHTML 存在 XSS 风险,现代开发中必须彻底弃用?”
辨析与修正:这种“一刀切”的看法脱离了实际工程环境。innerHTML 本身并不是病毒,真正危险的是将未经校验的用户输入直接拼接到 innerHTML 中。在以下两种受控场景中,innerHTML 是完全合理且高效的:
- 纯前端静态模板渲染:例如插入由开发者在代码中写死的高亮标记、图标 SVG 片段或固定状态提示卡片。
- 经过专业库净化后的富文本内容:在博客、CMS 系统或文档编辑器中,如果业务必须渲染用户提交的 HTML 内容,可以通过集成业内成熟的净化库(如
DOMPurify)去除危险标签与属性,随后安全地交由innerHTML渲染。
el.innerHTML = "欢迎用户:" + userInput 这样的代码!一旦 userInput 包含 <img src=1 onerror=...>,恶意脚本便会立即执行。绑定不可信数据时,请无条件使用 el.textContent = userInput。
四、操作步骤:如何决定选用哪一个属性?
在编写业务逻辑时,建议团队遵循一套标准化的判断流程,通过逐步排除法快速锁定最优解:
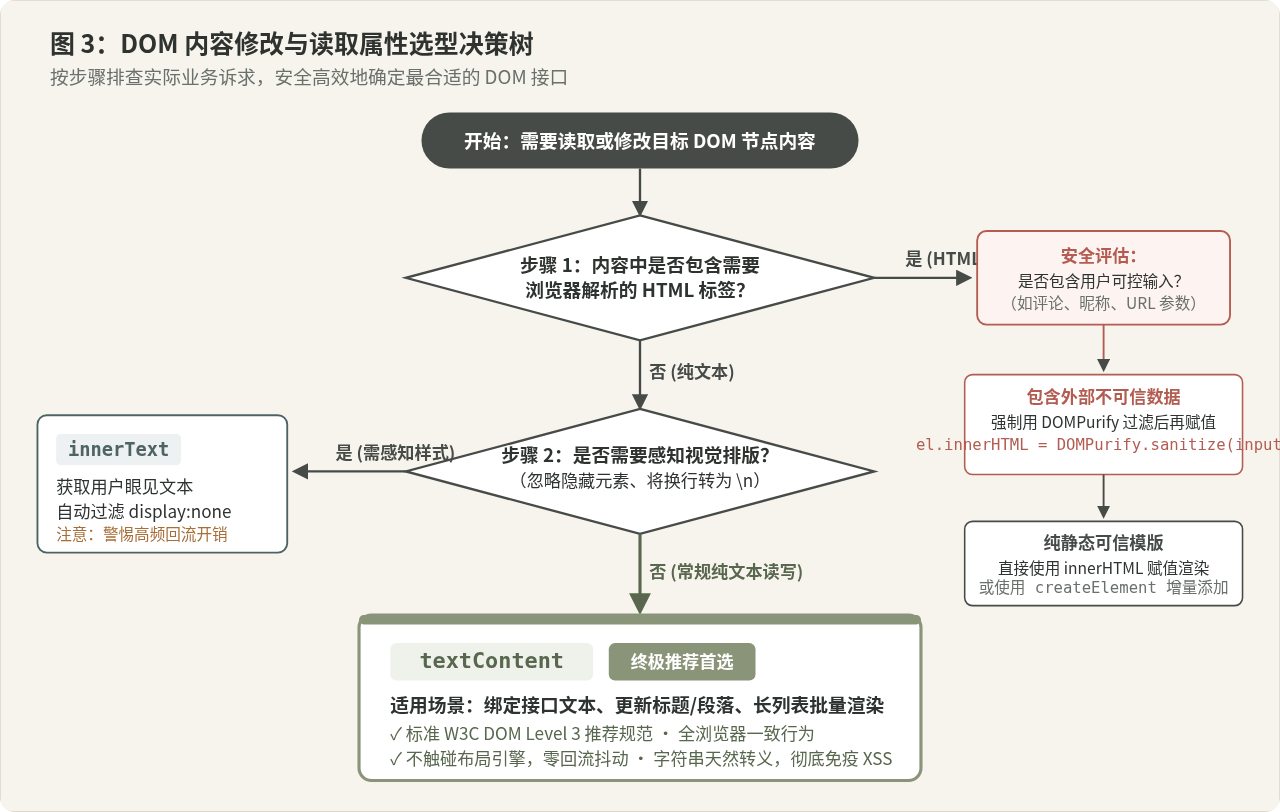
图 3:DOM 内容修改与读取属性选型决策树与排查步骤
第 1 步:明确目标内容是否包含 HTML 标签结构
首先观察你要操作的内容性质:
- 如果你的目标是插入带格式的子元素(如
<a>超链接、<span class="badge">、富文本),则必须走 HTML 解析路径; - 如果仅仅是填充用户名、商品价格、提示文案、时间戳等纯文字,请直接进入第 2 步。
在 HTML 解析路径中的操作规范:
// 场景 A:纯受控的内部模版(安全)
container.innerHTML = `<div class="badge success">验证通过</div>`;

// 场景 B:包含外部用户输入(必须经过 DOMPurify 净化)
import DOMPurify from 'dompurify';
container.innerHTML = DOMPurify.sanitize(userProvidedHtml);

// 场景 C:增量构建复杂交互组件(更推荐 DOM API)
const button = document.createElement('button');
button.textContent = '提交';
button.addEventListener('click', handleSubmit);
container.appendChild(button);
第 2 步:纯文本场景下,评估是否依赖 CSS 视觉渲染外观
当你只需要读写纯文本时,进一步确认业务是否依赖页面实际的 CSS 呈现状态:
- 需要感知视觉排版:例如实现“划词复制工具”、“页面可见文字字数统计”,或者要求自动忽略
style="display:none"的折叠区域,同时把段落换行还原为innerText。 - 无需感知视觉排版:只是从后台获取一段文本并填充到页面容器中,或者提取节点下的全量字符数据 —— 直接进入第 3 步。
第 3 步:常规纯文本数据操作,默认使用 textContent
只要没有特殊的富文本解析诉求与视觉排版过滤需求,textContent 是现代前端代码的标准首选。它兼具以下工程优势:
- 天然免疫 XSS 跨站脚本攻击;
- 执行速度极快,不触碰样式计算与页面重排;
- 行为符合 W3C 国际标准,跨浏览器表现完全统一。
五、工程实战代码范例
范例 1:安全更新用户资料卡片(纯文本首选 textContent)
在个人中心或社交动态中展示用户昵称与个人签名时,用户输入的内容可能包含各种特殊字符甚至攻击脚本:
// 模拟从后端接口获取的用户不可信输入
const userData = {
  nickname: '<script>alert("xss")</script>张三',
  bio: '热爱前端开发 <img src="x" onerror="stealCookie()">'
};

const nameEl = document.querySelector('.user-nickname');
const bioEl = document.querySelector('.user-bio');

// 正确做法:使用 textContent 自动转义,杜绝脚本执行
nameEl.textContent = userData.nickname;
bioEl.textContent = userData.bio;

// 页面效果:安全展示出含有标签的文字,不会弹出恶意提示框
范例 2:关键字搜索高亮匹配(结合安全的 innerHTML)
搜索结果列表中,经常需要把用户输入的搜索词用 <mark> 标签高亮显示。此时既需要解析 HTML 标签,又必须防止用户输入本身注入恶意脚本:
function renderSearchHighlight(container, rawText, searchKeyword) {
// 1. 编写辅助函数,对原始文本做基础转义
const escapeHtml = (str) => {
return str
.replace(/&/g, '&')
.replace(/</g, '<')
.replace(/>/g, '>')
.replace(/"/g, '"');
};
const safeContent = escapeHtml(rawText);
const safeKeyword = escapeHtml(searchKeyword);
if (!safeKeyword) {
container.textContent = rawText;
return;
}
// 2. 将安全转义后的关键字替换为带高亮样式的 HTML 片段
const regex = new RegExp(`(${safeKeyword})`, 'gi');
const highlightedHtml = safeContent.replace(regex, '<mark class="highlight">$1</mark>');
// 3. 安全地使用 innerHTML 赋值渲染
container.innerHTML = highlightedHtml;
}范例 3:编辑器可见区域纯文本统计(正确利用 innerText 的视觉感知)
在文章编辑器中统计“读者实际在屏幕上能看到的正文字数”时,应自动剔除隐藏的草稿段落与代码块外部的辅助标记:
function getVisibleArticleWordCount(editorElement) {
  // 利用 innerText 自动过滤 display:none 元素并保留排版换行
  const visibleText = editorElement.innerText;

  // 清理首尾多余空白并统计字数
  const cleanedText = visibleText.replace(/\s+/g, ' ').trim();
  return cleanedText.length;
}
六、核心特性速查与终极总结
综合以上各维度的技术细节与工程经验,我们对三个属性的核心特性进行了系统化归纳:
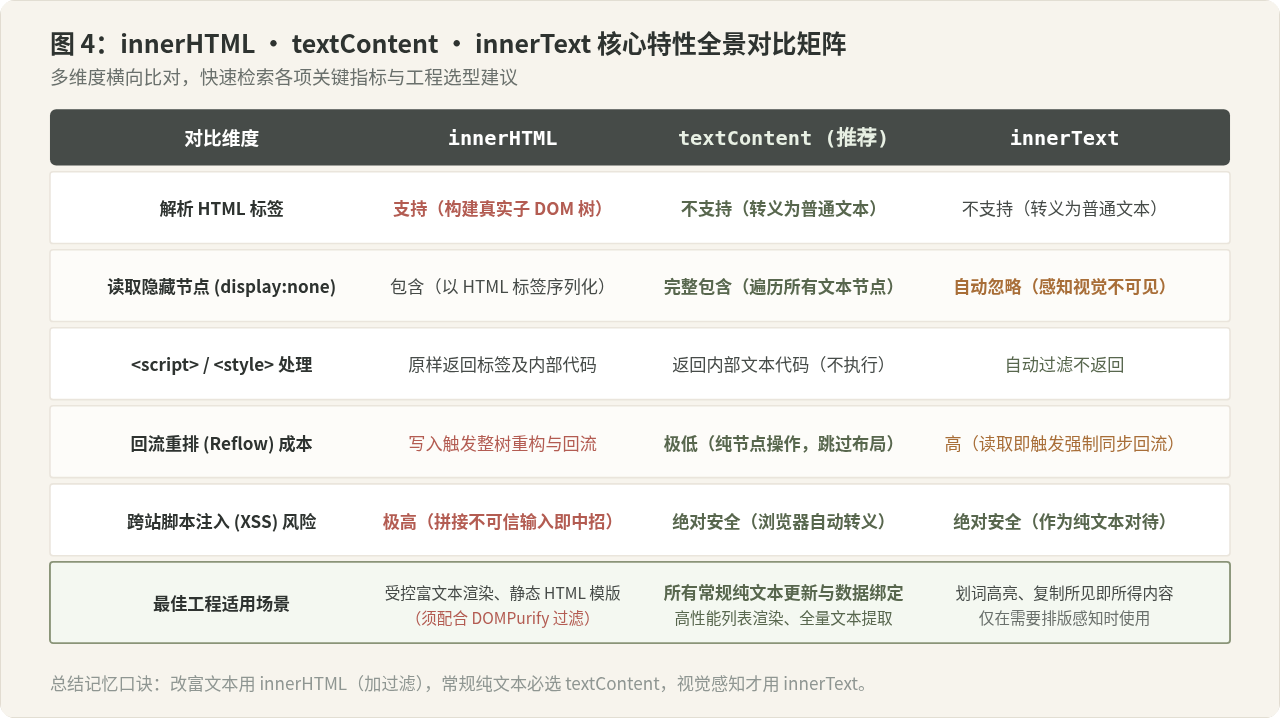
图 4:innerHTML、textContent 与 innerText 关键特性速查表与对比矩阵
改富文本带结构:用 innerHTML,外部不可信数据务必经过净化;
常规数据做绑定:默认选 textContent,性能极高且天然杜绝注入;
人眼视觉要排版:才选 innerText,留意性能开销谨防频繁回流。
在实际团队协作中,建议通过 ESLint 规则(如 no-inner-html)对直接赋值 innerHTML 的行为建立审查机制,并在业务代码中普遍将 textContent 作为基础操作的默认规范。通过建立清晰的边界认知,开发者既能保障 Web 应用的运行性能,又能从根本上夯实前端的安全底座。
tween.js 内存泄漏预防:怎么正确停止动画与清理对象
2026-11-05 15:52:56
Vue或React项目中为何不建议直接使用JS刷新页面
2026-11-05 13:57:30
哪里可以找到高质量的免费JS脚本资源?
2026-11-05 13:15:03
JS数组对象怎么根据指定ID字段去重
2026-11-04 21:41:10
JS数组去重方法性能对比:Set、Map与Filter谁更快
2026-11-04 16:14:15