怎么避免JS正则表达式回溯灾难导致页面卡死
深入分析 JavaScript 正则表达式回溯灾难(Catastrophic Backtracking)的产生机制与页面卡死原因,提供危险模式重构、输入前置校验、Web Worker 异步沙盒兜底等完整防范指南与误区辨析。
一、为什么正则表达式回溯会让页面瞬间卡死
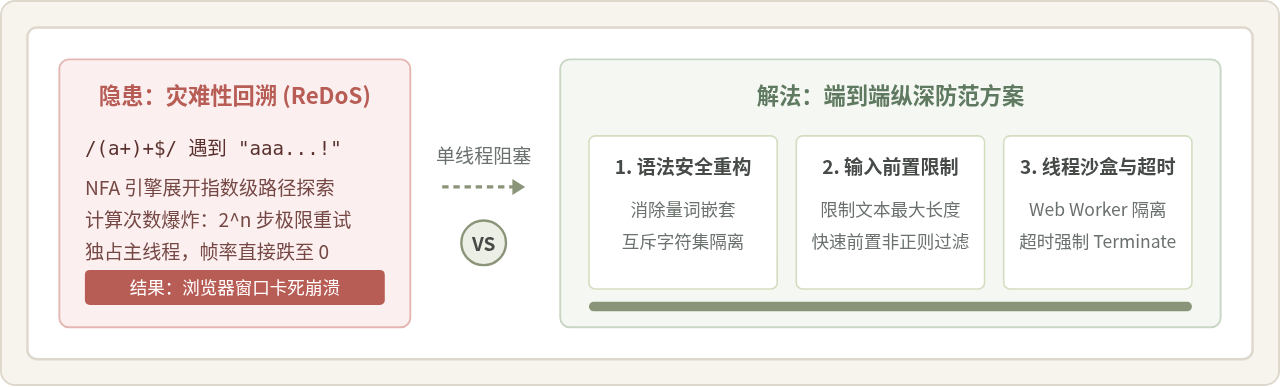
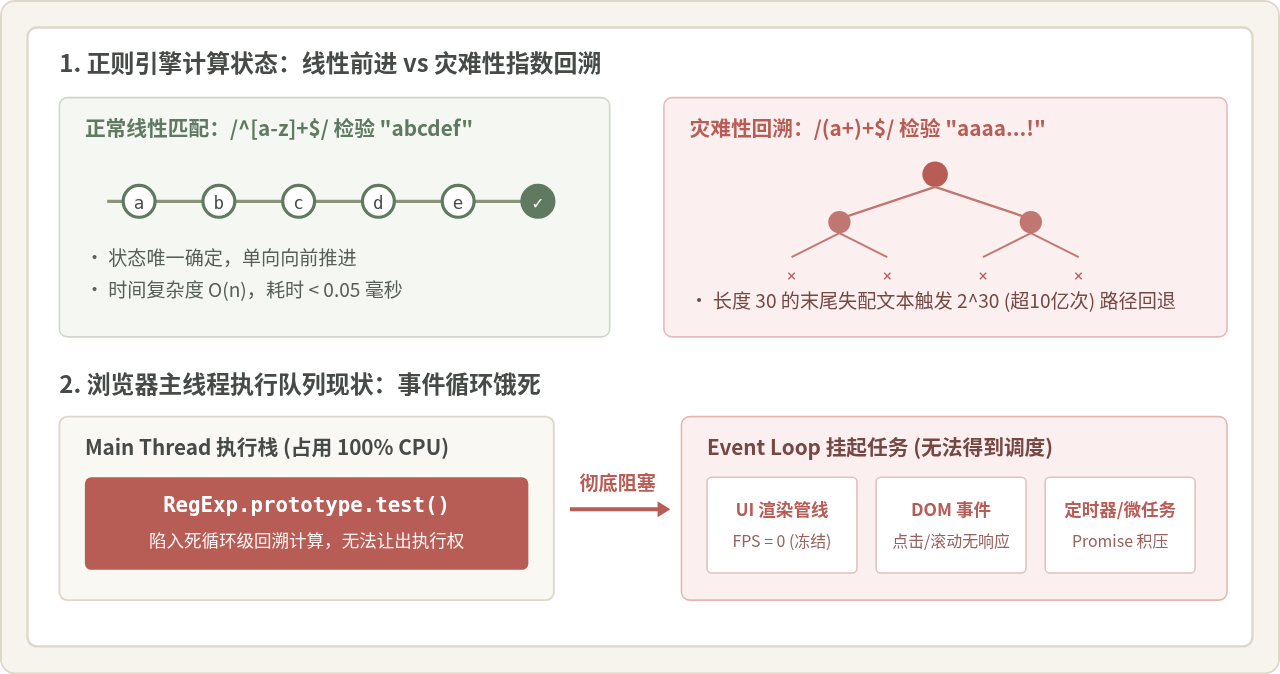
JavaScript 引擎(如 Chrome 的 V8、Safari 的 JavaScriptCore)内置的正则表达式引擎绝大部分基于传统的 NFA(非确定性有限状态自动机) 架构实现。NFA 引擎的特征是“以正则表达式为主导”,支持捕获组、反向引用、前瞻断言等复杂特性,但它采用深度优先搜索与回溯算法来匹配目标文本。
当正则表达式中包含多个可以匹配相同字符的模糊量词时,如果目标文本恰好在末尾与模式不匹配,NFA 引擎并不会立即报错放弃,而是会撤销上一步的选择,退回到上一个决策节点重新尝试新的组合。这种尝试如果发生在线性结构中,耗时仅微秒级;但一旦存在嵌套量词或重叠分支,可能尝试的状态组合数将呈现 O(2^n) 甚至更高级别的指数级激增。这就称为灾难性回溯(Catastrophic Backtracking),在安全领域也被称为正则拒绝服务(ReDoS, Regular Expression Denial of Service)。
更为严重的是,浏览器的 JavaScript 执行环境是单线程事件循环机制。当脚本调用 reg.test(str) 或 str.match(reg) 陷入指数级回溯运算时,CPU 核心占满,调用栈无法出栈。这直接导致浏览器的 UI 渲染管线、鼠标点击响应、键盘输入以及微任务与宏任务队列全部处于饥饿挂起状态,最终用户界面出现“网页未响应”弹窗或彻底卡死。
二、导致灾难性回溯的三类典型危险模式
并不是所有正则表达式都会发生回溯灾难。只有当模式内部存在歧义匹配(Ambiguous Match),即一个字符可以被模式的多个部分合法认领,且这些部分被重复量词包裹时,灾难才会爆发。在前端业务开发中,最常见的是以下三类模式:
1. 嵌套量词模式(Nested Quantifiers)
形如 (x+)+、(a*)*、(x+)*y。外层有一个量词,内层子模式也有量词。
// 危险示例:校验一组由空格或逗号分隔的单词
const dangerousRegex = /^([a-zA-Z0-9]+[\s,]*)+$/;

// 当输入匹配时,速度极快:
dangerousRegex.test("user1, user2, user3"); // < 0.1ms

// 当遇到近乎匹配却在尾部非法的长字符串时:
const malicious = "a".repeat(30) + "!";
dangerousRegex.test(malicious); // 耗时超过 5 秒,页面直接冻结!
原因剖析:字符串中每一个字符 a 既可以由内层的 [a-zA-Z0-9]+ 消耗,也可以由外层重复量词分配给新的分组。面对 30 个 a,总共有 2^(30-1) 种可能的分割方式。当尾部的 ! 导致整体失败时,引擎必须把这 5.3 亿种可能逐一穷举,才敢判定失败。
2. 包含重叠分支的交替量词(Overlapping Alternatives)
形如 (a|a+)+ 或 (hello|hello world)+。管道符 | 两侧的分支具有前缀包含或字符交叠关系,且整体被 + 或 * 量词包裹。
// 危险示例:处理带下划线或普通字符的标识符
const dangerousOverlap = /^([a-z]|[a-z]_)+$/;

// 针对 "aaaa...a!",引擎在每个位置都纠结是走左分支还是右分支
// 带来指数级的交叉验证尝试
3. 前后贪婪通配重叠(Unanchored Greediness)
在两个贪婪匹配(如 .* 或 [\s\S]*)之间夹杂可空或者宽泛的模式,且整个正则没有严格互斥的锚定条件。
// 危险示例:提取等号后的内容
const dangerousKV = /^.*=\s*(.*)$/;

// 如果文本很长且包含多个等号与空格,由于两个 .* 的贪婪扩张与回退
// 在超长字符串处理时会产生严重的性能抖动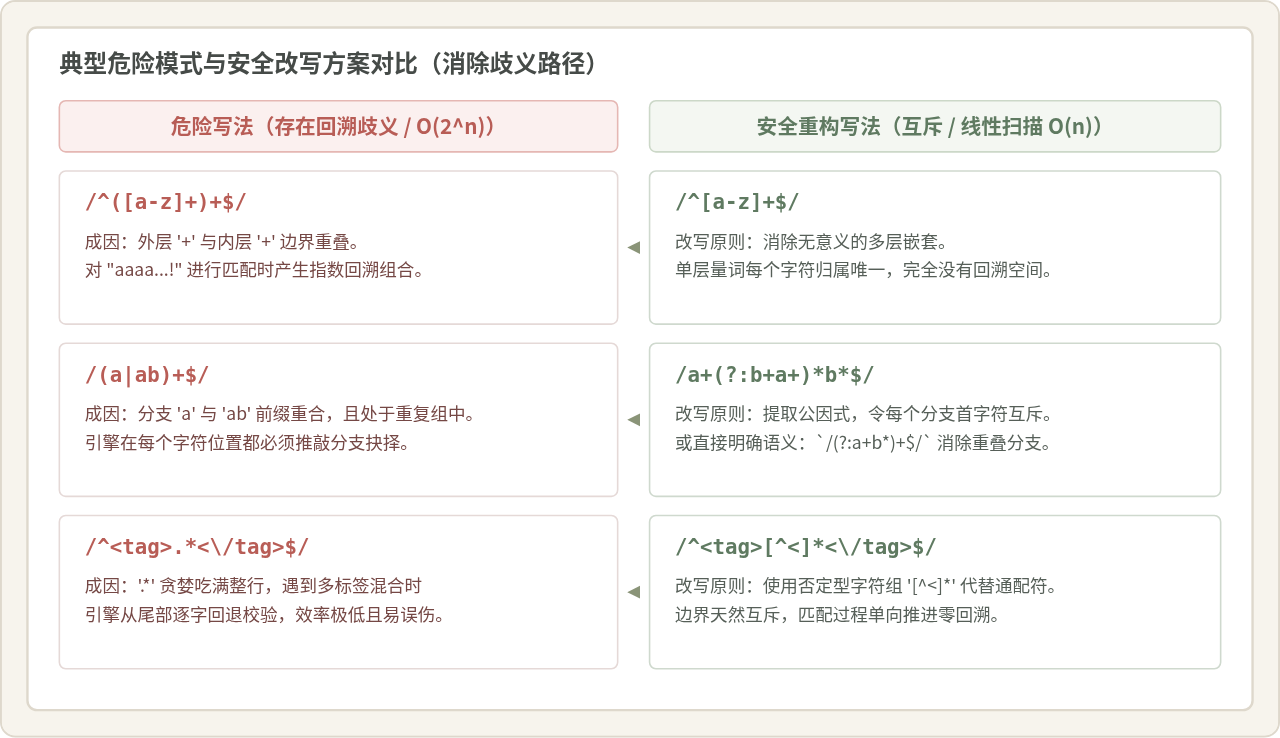
三、容易混淆的认知:常见防范误区辨析
在处理正则性能问题时,很多前端开发者常凭直觉尝试修复,但部分做法看似合理,实际上无法解决回溯灾难。
| 常见认知与说法 | 为什么看似合理 / 成立条件 | 事实真相与修正建议 |
|---|---|---|
| “加上开头 ^ 和结尾 $ 就能防止回溯卡死” | 锚点确实能防止正则在整个长文本的每一个偏移量位置都重复尝试启动匹配(减少外层滑动尝试)。 | 无法消除内部指数回溯。如果正则内部存在 (a+)+$,锚点恰好要求必须匹配到末尾。当末尾失配时,由于被锁死在整个字符串区间,引擎会更完整地穷举所有内部划分,反而在失配时引发更持久的卡死。 |
| “把贪婪量词 + 改成惰性量词 +? 就安全了” | 惰性量词从最短可能开始尝试,在能够提前命中的场景下确实可以少走几步。 | 非匹配场景回溯总量完全不变。惰性匹配只是反转了探索顺序(从“先长后短”变成“先短后长”)。如果文本末尾注定无法匹配,引擎依然必须遍历完整个决策树的全部组合,计算量没有任何减少。 |
| “只有恶意攻击者才会触发 ReDoS,日常表单没关系” | 恶意构造的攻击载荷确实更精准。 | 普通用户无意识的输入也会天然触发。用户长文本粘贴、不小心在复制的邮箱末尾多带了一个特殊符号、或者在密码框长按输入重复字符,都会瞬间成为完美的非匹配对抗样本,直接使前端页面白屏崩溃。 |
四、操作步骤:如何排查并定位项目中的有毒正则
排查存量代码或新提交的正则是否存在回溯风险,推荐遵循以下标准的四步诊断法:
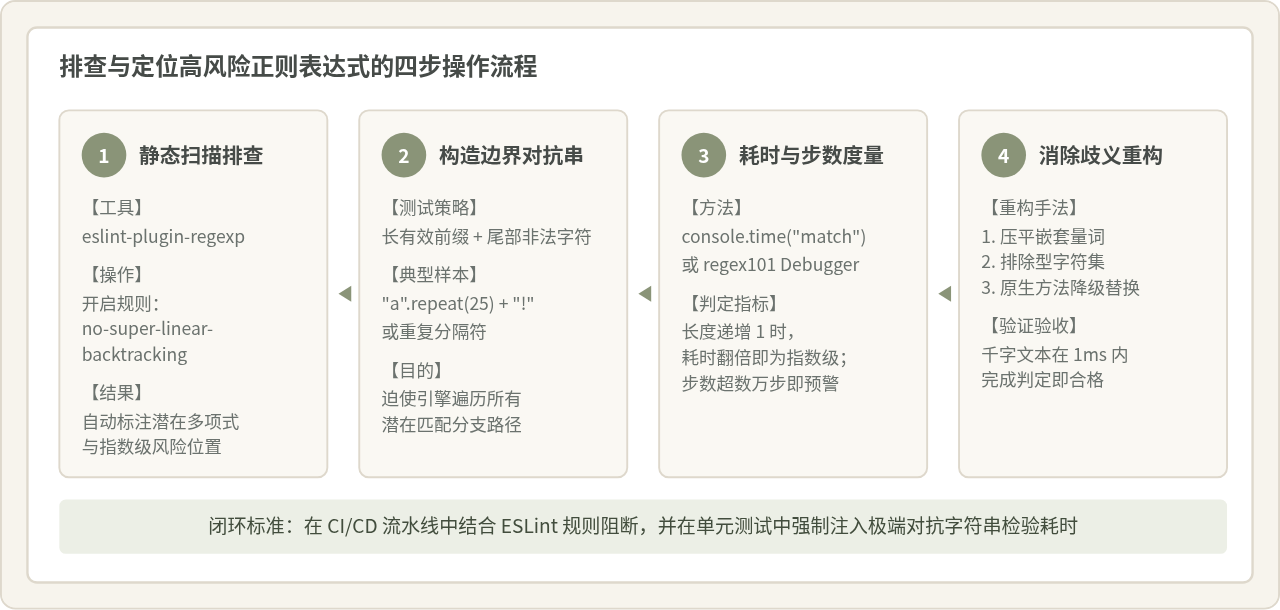
步骤 1:利用 ESLint 插件进行静态代码审计
在项目中安装专用的正则静态分析插件,可以在编码与代码提交阶段自动拦截大部分灾难性正则:
npm install eslint-plugin-regexp --save-dev
在 eslint.config.js 或 .eslintrc.json 中启用以下核心规则:
// eslint.config.js
import regexpPlugin from "eslint-plugin-regexp";

export default [
  regexpPlugin.configs["flat/recommended"],
  {
    rules: {
      // 严禁存在超线性/指数级回溯风险的正则
      "regexp/no-super-linear-backtracking": "error",
      // 严禁存在潜在为空的反向引用
      "regexp/no-potentially-empty-backreference": "error"
    }
  }
];
步骤 2:针对关键正则编写对抗性单测(Fuzzing 测试)
在单元测试中,除了验证合法的“成功用例”,必须专门为正则编写“近乎匹配却在尾部破坏”的对抗测试,并断言执行耗时:
// 正则抗回溯回归测试示例
function assertRegexPerformance(regex, maliciousInput, maxTimeMs = 50) {
  const start = performance.now();
  regex.test(maliciousInput);
  const elapsed = performance.now() - start;

  if (elapsed > maxTimeMs) {
    throw new Error(`正则回溯风险预警!耗时 ${elapsed.toFixed(2)}ms 超过阈值 ${maxTimeMs}ms`);
  }
}

// 测试匹配由逗号分割数字的正则
const numberListRegex = /^(\d+,?)+$/;
// 构造末尾带有非数字的恶意样本
const testSample = "1,".repeat(25) + "X";

// 如果执行超过 50ms 即报警失败
assertRegexPerformance(numberListRegex, testSample);
五、代码级安全重构的四种实用技巧
技巧 1:使用“排除型字符集”代替通配贪婪符
这是前端日常开发中最有效、最简单的改造手段。在提取两个特定标记之间的内容时,永远不要使用 .*? 或 .*,而是使用明确排除了终结符的字符集 [^...]。
// 危险写法(匹配双引号字符串,遇到未闭合的长引号时会疯狂回溯)
const badQuoteRegex = /"([^"\\]|\\.)*"/;

// 安全写法(明确排除转义符与双引号)
const safeQuoteRegex = /"(?:[^"\\]|\\.)*"/;
// 更优方案:拆分普通字符块与转义序列,确保每次匹配吃进互斥字符
技巧 2:优先使用原生字符串 API 替代复杂正则
很多前端场景仅仅是为了做简单的前缀判断、后缀检查或特定符号分割,引入复杂正则不仅容易产生回溯,还会增加解析成本:
// 不推荐:使用正则判断文件后缀与提取参数
const isImage = /\.(png|jpe?g|gif|webp)$/i.test(filename);
const param = str.replace(/^.*?id=([^&]+).*$/, "$1");

// 推荐:改用性能极高且绝对零回溯的原生字符串方法
function checkIsImage(name) {
  const dotIndex = name.lastIndexOf(".");
  if (dotIndex === -1) return false;
  const ext = name.slice(dotIndex + 1).toLowerCase();
  return ["png", "jpg", "jpeg", "gif", "webp"].includes(ext);
}

// 提取 URL 参数直接使用 URLSearchParams
const urlParams = new URLSearchParams(window.location.search);
const id = urlParams.get("id");
技巧 3:严格前置限制输入长度(MaxLength)
指数级回溯的核心在于字符串长度 n 变大时计算量翻倍。如果输入文本限定在较短长度内,哪怕正则不够完美,实际耗时也会被物理限制在几微秒之内。
function safeValidateInput(regex, inputStr, maxLength = 100) {
  if (typeof inputStr !== "string") return false;
  // 第一道防线:物理拦截超长输入
  if (inputStr.length > maxLength) {
    console.warn(`输入超出限制长度 ${maxLength},直接拒绝`);
    return false;
  }
  return regex.test(inputStr);
}
技巧 4:利用 Lookahead 前瞻模拟原子组(Atomic Group)
在 PCRE、Java 或 Python 等正则引擎中,支持 (?>...) 原子组语法,原子组内部一旦匹配成功,就立即丢弃内部的所有回溯点。虽然 ECMAScript 目前尚未原生全面落地独立原子组语法,但在现代 JS 引擎中,可以通过前瞻断言配合反向引用 (?=(pattern))\1 的经典模式实现相同的效果:
// 原始易回溯正则:/(a+)b/ 在面对 "aaaa...a" 时回溯不断尝试缩短 a+
// 使用前瞻模拟原子组:
// (?=(a+))\1 会一次性把所有的 'a' 锁定为第一捕获组,绝不回退吐出字符!
const atomicRegex = /^(?=(a+))\1b$/;

// 即使面对超长不匹配字符串,瞬间即可判定失败(0ms 级),完全零回溯
atomicRegex.test("a".repeat(1000) + "c"); // 立即返回 false,毫不卡顿
六、运行时兜底:使用 Web Worker 隔离与超时熔断
当业务需求面对用户自主上传、输入任意复杂正则表达式,或者需要匹配数万字以上的富文本内容时,仅靠前端代码审计无法保证 100% 绝对安全。此时最可靠的工程方案是将正则执行移入 Web Worker 子线程,主线程设置超时计时器。一旦超时直接 terminate() 销毁子线程,从而保证主界面 60 帧丝滑不卡死。
以下是经过生产环境验证的通用正则 Worker 异步包装器代码:
/**
 * 安全正则匹配执行器(Web Worker 沙盒版)
 * @param {RegExp|string} regex 正则表达式或正则字符串
 * @param {string} text 待检测的目标文本
 * @param {number} timeoutMs 允许最大执行时间(毫秒)
 * @returns {Promise<boolean>}
 */
function runRegexInWorker(regex, text, timeoutMs = 200) {
  return new Promise((resolve, reject) => {
    // 构造内联 Worker 脚本
    const workerCode = `
      self.onmessage = function(e) {
        const { source, flags, text } = e.data;
        try {
          const reg = new RegExp(source, flags);
          const result = reg.test(text);
          self.postMessage({ status: 'success', result });
        } catch (err) {
          self.postMessage({ status: 'error', message: err.message });
        }
      };
    `;

    const blob = new Blob([workerCode], { type: "application/javascript" });
    const workerUrl = URL.createObjectURL(blob);
    const worker = new Worker(workerUrl);

    let isFinished = false;

    // 超时熔断机制
    const timer = setTimeout(() => {
      if (!isFinished) {
        isFinished = true;
        // 关键操作:强制终止正在死循环的 Worker 线程,释放核心算力
        worker.terminate();
        URL.revokeObjectURL(workerUrl);
        reject(new Error(`正则表达式执行超时 (${timeoutMs}ms),已强制中断,避免页面卡死`));
      }
    }, timeoutMs);

    // 接收 Worker 正常返回
    worker.onmessage = function(e) {
      if (isFinished) return;
      isFinished = true;
      clearTimeout(timer);
      worker.terminate();
      URL.revokeObjectURL(workerUrl);

      if (e.data.status === "success") {
        resolve(e.data.result);
      } else {
        reject(new Error(e.data.message));
      }
    };

    worker.onerror = function(err) {
      if (isFinished) return;
      isFinished = true;
      clearTimeout(timer);
      worker.terminate();
      URL.revokeObjectURL(workerUrl);
      reject(err);
    };

    // 发送正则参数启动匹配
    const regObj = regex instanceof RegExp ? regex : new RegExp(regex);
    worker.postMessage({
      source: regObj.source,
      flags: regObj.flags,
      text: text
    });
  });
}

// 使用示例:
async function handleUserSearch() {
  const userInput = document.getElementById("searchBox").value;
  const userRegex = /(x+)+y/; // 潜在有毒正则

  try {
    const isMatched = await runRegexInWorker(userRegex, userInput, 300);
    console.log("匹配结果:", isMatched);
  } catch (error) {
    console.error("安全熔断处理:", error.message);
    alert("该文本匹配较为复杂,系统已自动保护页面交互流畅。");
  }
}keydown 事件每次按键)的小型短文本校验。对于短字符串表单,优先采用前端“长度前置过滤 + 语法去重叠”;Worker 方案专用于处理长文章、日志分析、Markdown 编辑器预览等重型文本处理场景。
七、总结
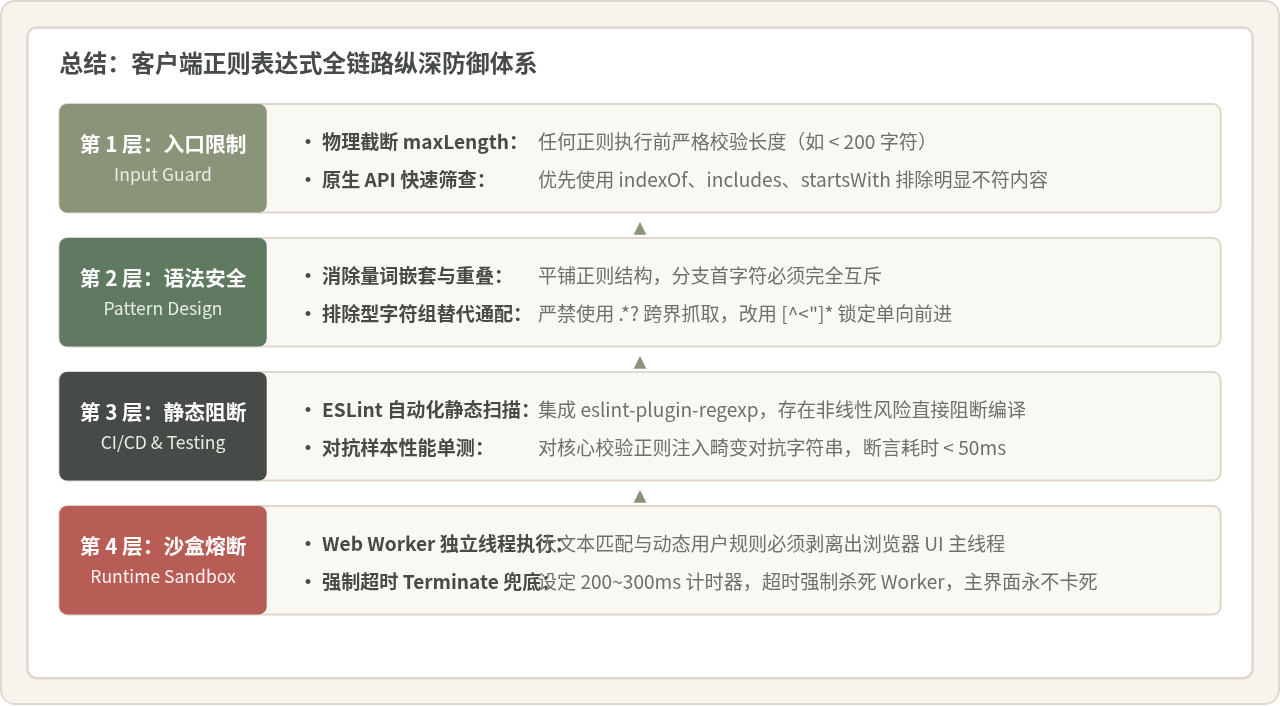
JavaScript 正则表达式回溯灾难之所以致命,根源在于 NFA 引擎在歧义语法下的指数级回溯探索,与浏览器 JavaScript 单线程事件循环的相互作用。要保证页面交互永不卡死,应当建立分层防范意识:
- 常规表单校验:坚持“前置限制最大字符长度 + 语法消除嵌套量词 + 排除型字符集”,从根源上消除歧义分支。
- 开发与构建阶段:引入
eslint-plugin-regexp,将危险正则识别前置到代码提交之前。 - 长文本与不可控规则:果断引入 Web Worker 异步沙盒与超时熔断,彻底将密集的正则计算与主线程的渲染、点击事件解耦。
通过这套从设计、扫描到运行时兜底的完整防御体系,即可彻底解决正则表达式导致的页面无响应与浏览器卡顿问题。
tween.js 内存泄漏预防:怎么正确停止动画与清理对象
2026-11-05 15:52:56
Vue或React项目中为何不建议直接使用JS刷新页面
2026-11-05 13:57:30
哪里可以找到高质量的免费JS脚本资源?
2026-11-05 13:15:03
JS数组对象怎么根据指定ID字段去重
2026-11-04 21:41:10
JS数组去重方法性能对比:Set、Map与Filter谁更快
2026-11-04 16:14:15
相关标签: