

JavaScript大数精度丢失:转为整数时的注意事项
深入解析JavaScript中将大数转换为整数时发生精度丢失的底层机理、JSON反序列化前置损伤及位运算截断陷阱,提供使用BigInt和String的标准防御步骤、实战代码与选型矩阵。
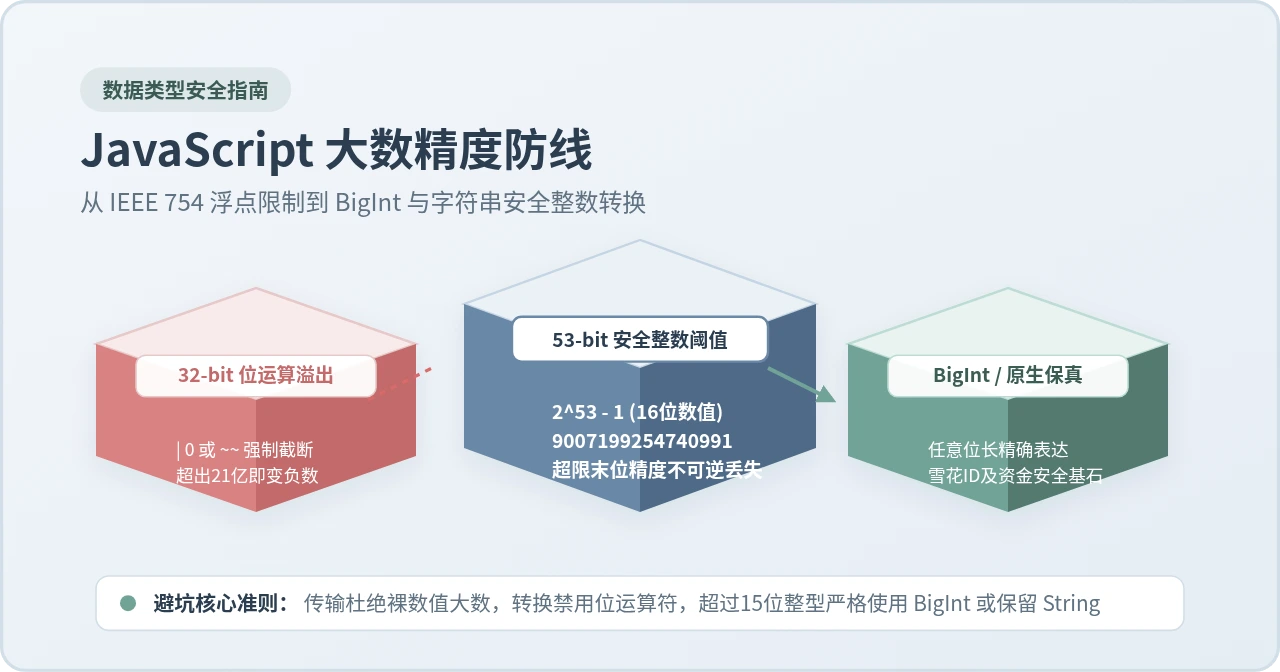
在 JavaScript 中,所有常规数值均采用 IEEE 754 双精度浮点格式表示,其安全整数上限仅为 Number.MAX_SAFE_INTEGER(即 9,007,199,254,740,991 / 253 - 1)。当处理数据库 64 位整型、雪花算法 ID 或高精度订单号等超过 16 位的数值时,若直接使用 Number()、parseInt() 或位运算进行整型转换,将引发不可逆的末位精度丢失甚至数值符号反转。本文直击转换过程中的底层机理与陷阱,提供规范的防御步骤、无损转换方案及生产环境选型依据。
一、为什么转为整数时会发生精度丢失?底层机理剖析
初学者在遇到大数问题时,往往容易困惑:“我明明是转成整数,并没有小数点,为什么最后几位数字会被篡改?”要解答这个问题,必须从 JavaScript 底层的两种数值规格——双精度浮点数(Float64)与按位运算 32 位整型(Int32)的存储限制谈起。
1. IEEE 754 的 53 位尾数精度红线
JavaScript 的 Number 类型在底层占据 64 位(8 字节)内存空间,遵循 IEEE 754 标准:其中 1 位为符号位,11 位为指数位,余下的 52 位用于表示有效数字尾数(Mantissa)。在规格化表示中,尾数最高位默认隐含一个数字 1,因此实际能够精确表达的有效二进制位宽为 52 + 1 = 53 位。
由于 2^53 - 1 = 9007199254740991(16 位十进制),只要整数落在 -9007199254740991 到 9007199254740991 这一区间内,每一个整数都能与二进制浮点表示一一精准对应。而一旦超过这个范围,由于尾数位数不足以支撑个位精细度,相邻两个浮点数之间的步进间隔就会扩大为 2、4、8 甚至更大。
// 超过安全整数范围后的典型失真现象
console.log(9007199254740992 === 9007199254740993);
// 输出: true (尾数的奇数无法编码,强制舍入为相邻偶数)

console.log(Number("184293847291823901"));
// 输出: 184293847291823900 (末位 01 被抹平为 00)
2. 按位运算符的“32位有符号整数”强制截断
很多前端代码库为了书写简便,喜欢使用按位运算符进行快速向下取整,例如 num | 0、~~num 或 num >> 0。对于小范围数值,这确实能够去除小数部分;但在大数场景下,这是一种灾难性操作。
根据 ECMAScript 规范,所有按位运算符在执行前,都会通过内部抽象操作 ToInt32() 将操作数强制转化为 32 位有符号二进制补码。其表示范围仅为 -2,147,483,648 到 2,147,483,647(约 ±21.4 亿,仅 10 位十进制)。任何高于 32 位的二进制比特全部被硬性丢弃。
// 灾难示例:使用位运算截断大数
const snowflakeId = 172839485764839219;
console.log(snowflakeId | 0);
// 输出: 777977651 (完全变成另一个风马牛不相及的小数)

console.log(~~"9007199254740991");
// 输出: -1 (高位溢出导致符号位被破坏)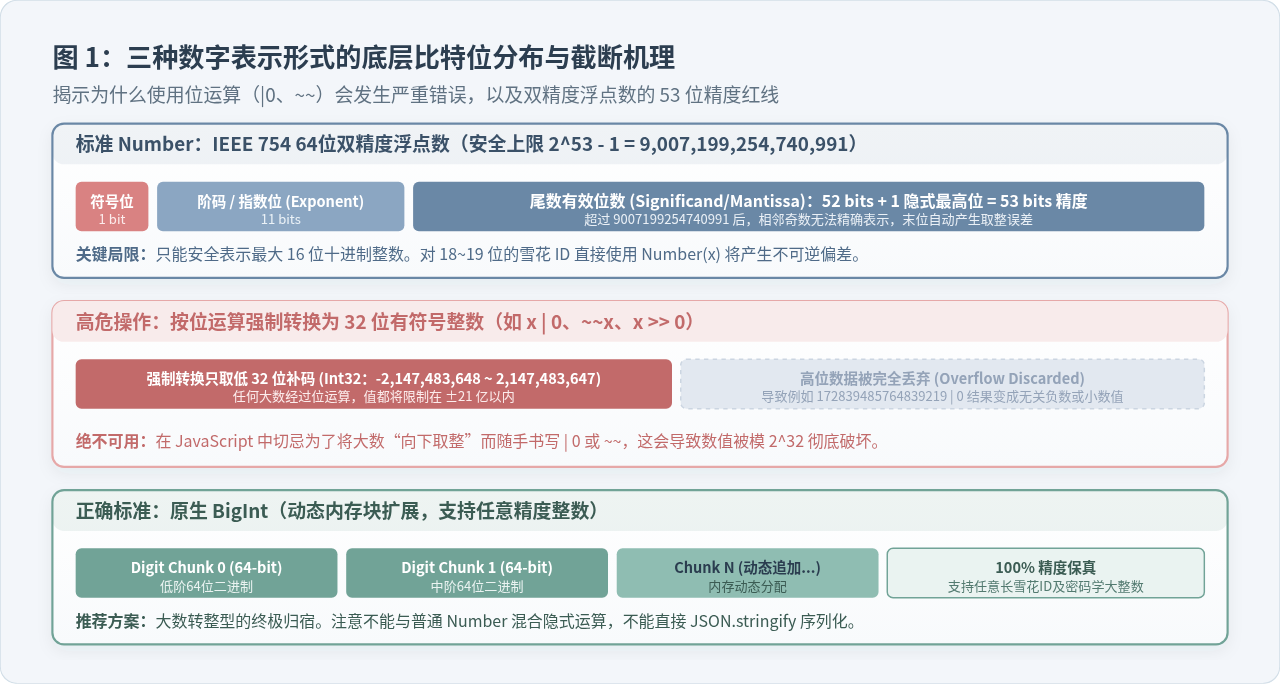
| 0、~~、^ 0 等位运算符。它们的存在不仅无法保护大数,反而是造成业务 ID 错乱的元凶。
二、接口传输陷阱:JSON.parse 在转换前已造成前置损失
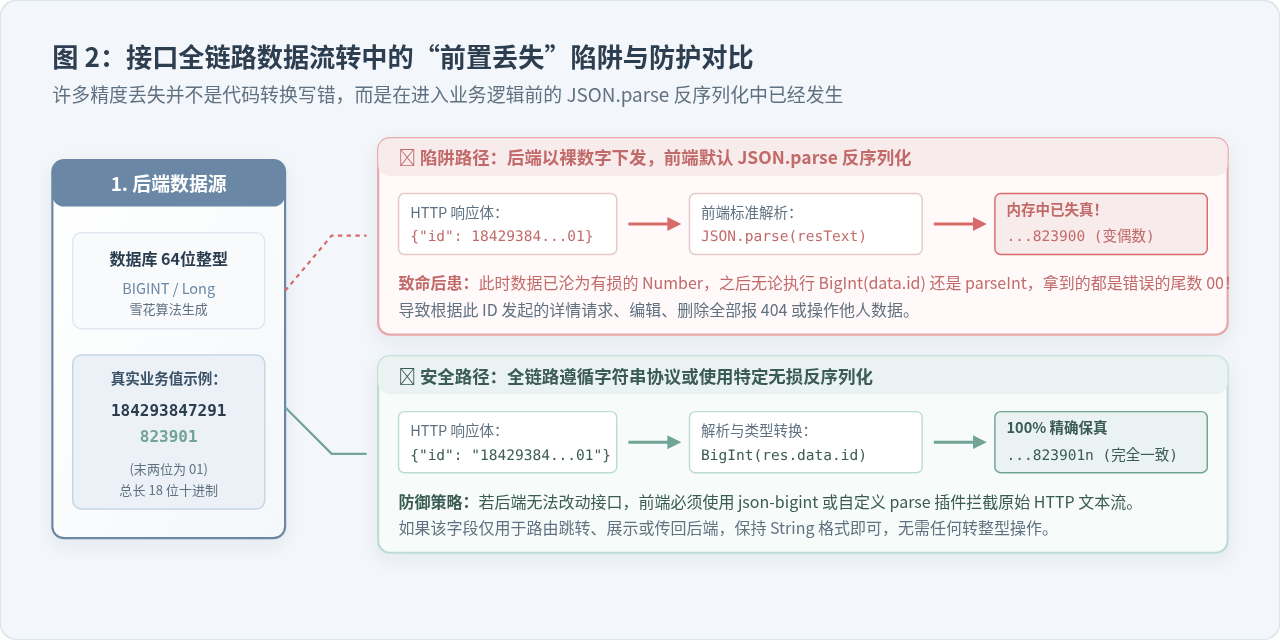
在实际业务排查中,超过 80% 的“大数转整型精度丢失”事故,其真正的破坏点根本不是开发者后续调用的转换函数,而是在网络请求反序列化阶段就已经木已成舟。
1. 为什么“还没开始转,值就已经错了”?
考虑一个典型的微服务调用流程:后端数据库中的主键为 64 位长整型(如 Java 中的 Long id = 184293847291823901L)。后端直接将对象序列化为 JSON 字符串并返回给前端:
HTTP/1.1 200 OK
Content-Type: application/json

{"code": 200, "data": {"orderId": 184293847291823901, "amount": 100}}
浏览器或 Axios 在收到响应后,底层会直接执行原生 JSON.parse(responseText)。然而,JSON 规范本身并没有区分整型和浮点型,所有的纯数值字面量在 JavaScript 引擎中都会被无差别解析为标准 Number(双精度浮点数)。
当 184293847291823901 经过 JSON.parse 处理后,在内存中已经被截断固化为了 184293847291823900。此时,无论开发者在后续代码中多么谨慎地使用 BigInt(data.orderId) 还是 String(data.orderId),拿到的都只是一个早已损毁的值。
2. 接口端与前端的双重防线
要根治这一前置陷阱,必须在数据流入 JavaScript 内存之前建立防线:
-
防线一(最佳实践·服务端协议治理):推动后端团队在序列化层将 64 位整型统一输出为字符串(例如 Java Spring Boot 配置 Jackson 的
ToStringSerializer,或 Go 语言配置json:",string")。前端接收到{"orderId": "184293847291823901"}字符串后,天然具备免疫能力。 -
防线二(前端防御·自定义响应流拦截):如果后端接口无法立即重构,前端必须在 Axios 的
transformResponse中介入原始文本,使用json-bigint代替原生JSON.parse:
import axios from 'axios';
import JSONBig from 'json-bigint';

// 配置 json-bigint:超大整数转为 BigInt 或 String,保留精度
const JSONBigNative = JSONBig({ storeAsString: true });

const apiClient = axios.create({
  baseURL: '/api',
  transformResponse: [
    function (data) {
      if (typeof data === 'string') {
        try {
          // 在原生浮点数解析之前进行无损替换
          return JSONBigNative.parse(data);
        } catch (err) {
          return data;
        }
      }
      return data;
    }
  ]
});
三、常见整型转换方法在大数下的行为盲区
即使前端拿到了合法的字符串类型大数,在将其转为整型时,不同的 API 也存在鲜明的边界与隐藏行为。下文逐一验证常见转换手段的实际表现。
1. parseInt(str, 10):无法逃离 Float64 的返回值局限
许多人误以为 parseInt 返回的是“纯整数”,因此可以安全处理任意长数字。事实上,在 ECMAScript 规范中,parseInt 的返回值类型就是标准的 Number。
const bigStr = "9007199254740995";
const result = parseInt(bigStr, 10);

console.log(result); // 9007199254740996 (发生舍入偏差)
console.log(result.toString() === bigStr); // false
不仅如此,当数值过大导致触发科学计数法时,parseInt 会产生令人意外的截断错误。例如 parseInt(100000000000000000000000),因为传入的数值首先被转为字符串 "1e+23",parseInt 遇到非数字字符 'e' 便立即停止解析,最终返回 1。
2. Number(val):严格但同样受限
Number(val) 对格式要求严格,遇到非纯数字字符直接返回 NaN,但在大数精度保护上与 parseInt 毫无二致——上限依然是 53 位。它并不适合作为大数整型转换的手段。
3. Math.trunc / Math.floor:只能用于安全整数范围
Math.trunc() 是去除浮点数小数部分最标准的数学方法,它不会像位运算那样产生 32 位截断。然而,它的输入与输出依然是 Number。如果传入的数值本身已超出了 Number.MAX_SAFE_INTEGER,其内部尾数早已变形,向下取整也挽救不了已丢失的个位数。
4. BigInt(val):真正的大数整数解决方案
ECMAScript 2020(ES11)正式引入了原生 BigInt 数据类型,用于表示任意精度的整型数值。只要内存允许,BigInt 可以容纳千位甚至万位长度的整数。
// 正确用法:必须基于字符串构造,绝对不要传入裸大数
const safeBigInt = BigInt("184293847291823901");
console.log(safeBigInt); // 184293847291823901n (末位精确无误)

// 错误警示:如果传入未经转换的 Number,传入时已经失真
const wrongBigInt = BigInt(184293847291823901);
console.log(wrongBigInt); // 184293847291823900n (依然是错的!)BigInt无法表示小数:传入包含小数点的字符串(如BigInt("123.45"))会直接抛出SyntaxError。- 不能与普通
Number混合进行隐式数学运算(如10n + 5会抛出TypeError),必须显式转换。 - 原生
JSON.stringify()无法直接序列化BigInt,否则会报错Do not know how to serialize a BigInt,需要补充toJSON原型方法或序列化处理器。
四、安全转为整数的标准操作步骤与防错实现
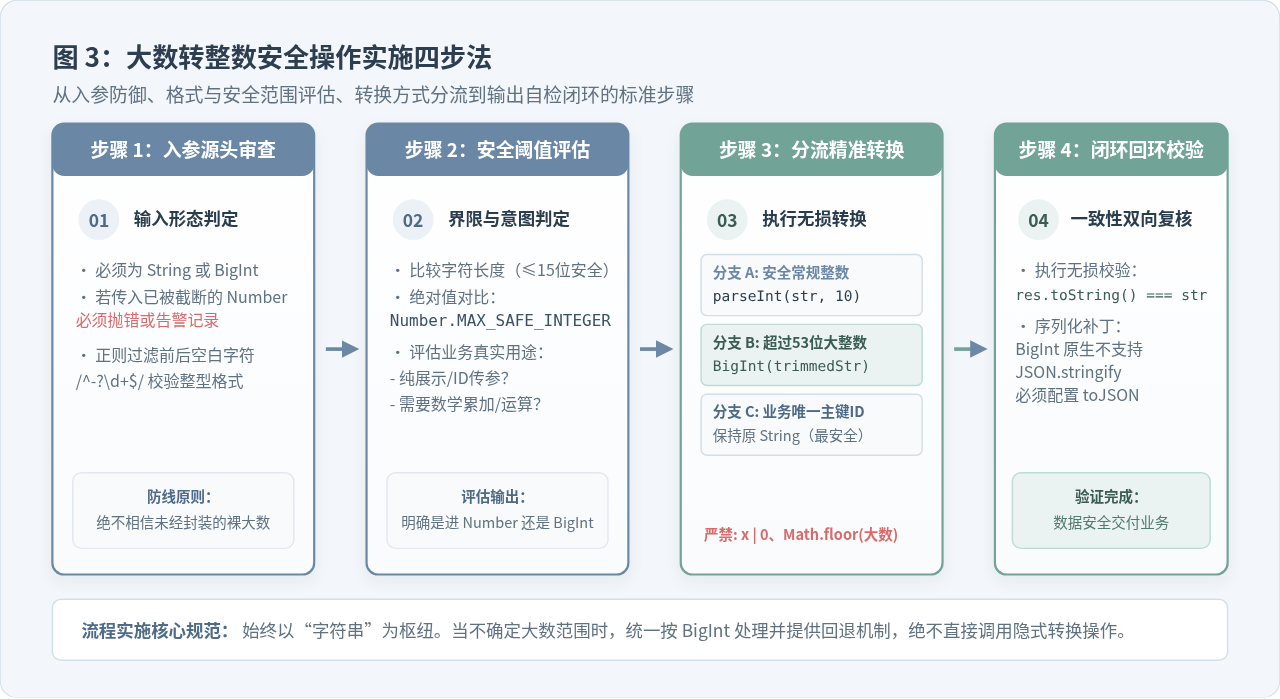
针对工程开发中不确定来源的大数字符串,必须建立一套标准化的转换校验流程,确保“在安全范围内转为高性能 Number,超出安全范围转为保真 BigInt,非法字符阻断抛错”。
标准操作实施步骤:
-
步骤一:入参源头审查与预清洁
校验输入类型必须为string或原生bigint。若误传入了number且大于安全上限,立即记录警告日志;对字符串执行trim()并使用正则表达式/^-?\d+$/校验其纯整型格式。 -
步骤二:安全阈值评估
判断字符串字符长度。若长度小于等于 15 位,或其数值绝对值严格落在Number.MIN_SAFE_INTEGER与Number.MAX_SAFE_INTEGER之间,则标记为安全浮点整型。 -
步骤三:精准分流转换
若在安全阈值内,使用parseInt(cleanStr, 10)获得高效的Number;若超出安全阈值,直接使用BigInt(cleanStr)进行任意精度封装。 -
步骤四:回环一致性自检
将转换后的对象重新调用.toString(),断言其与入参纯整数字符串完全一致,确保不存在隐式精度丢失。
生产级防错工具函数封装:
在公共工具库中,建议封装统一的转换函数 safeParseInteger,兼顾常规性能与超限保真:
/**
 * 大数安全转整数工具函数
 * @param {string | number | bigint} input 待转换原始输入
 * @param {Object} options 配置选项
 * @param {boolean} options.strictBigInt 是否强制所有超限均返回 BigInt (默认 true)
 * @returns {number | bigint}
 */
function safeParseInteger(input, options = { strictBigInt: true }) {
  // 1. 类型判定与预检查
  if (typeof input === 'bigint') {
    return input;
  }

  if (typeof input === 'number') {
    if (!Number.isSafeInteger(input)) {
      console.warn(
        `[大数安全警告] 传入的裸数值 ${input} 已超出安全整数界限,其精度可能已不可逆损坏!建议检查数据源是否应改为字符串传输。`
      );
    }
    return Math.trunc(input);
  }

  if (typeof input !== 'string') {
    throw new TypeError(`[大数转换失败] 参数必须为字符串、数字或BigInt,收到类型: ${typeof input}`);
  }

  const trimmed = input.trim();

  // 2. 正则校验纯整数格式 (支持正负号)
  if (!/^-?\d+$/.test(trimmed)) {
    throw new SyntaxError(`[大数转换失败] 非法整数字符串: "${input}"`);
  }

  // 3. 快速安全范围判定 (15位以内十进制绝对安全)
  const isNegative = trimmed.startsWith('-');
  const digitsOnly = isNegative ? trimmed.slice(1) : trimmed;

  if (digitsOnly.length <= 15) {
    return parseInt(trimmed, 10);
  }

  // 4. 精确安全边界对比
  const numVal = parseInt(trimmed, 10);
  if (Number.isSafeInteger(numVal) && numVal.toString() === trimmed) {
    return numVal;
  }

  // 5. 超限分支:进入 BigInt 安全区间
  if (options.strictBigInt) {
    const bigIntVal = BigInt(trimmed);
    // 闭环一致性校验
    if (bigIntVal.toString() !== trimmed) {
      throw new Error(`[大数转换异常] BigInt 转换后一致性校验未通过`);
    }
    return bigIntVal;
  }

  throw new RangeError(
    `[大数转换失败] 数值 "${trimmed}" 超出 JavaScript 安全整数上限且未开启 BigInt 回退`
  );
}

// 验证用例
console.log(safeParseInteger("1024"));
// 输出: 1024 (普通 Number 类型,计算性能最优)

console.log(safeParseInteger("184293847291823901"));
// 输出: 184293847291823901n (BigInt 类型,末位精度100%保留)

// 保护 BigInt 的 JSON 序列化补丁
if (!BigInt.prototype.toJSON) {
  BigInt.prototype.toJSON = function () {
    return this.toString();
  };
}
五、选型决策矩阵与场景实践总结
在真实项目架构中,并非所有“大数字”都需要转成数值类型。根据数据的实际业务语义,选择最合适的存在形式往往能达到事半功倍的效果。
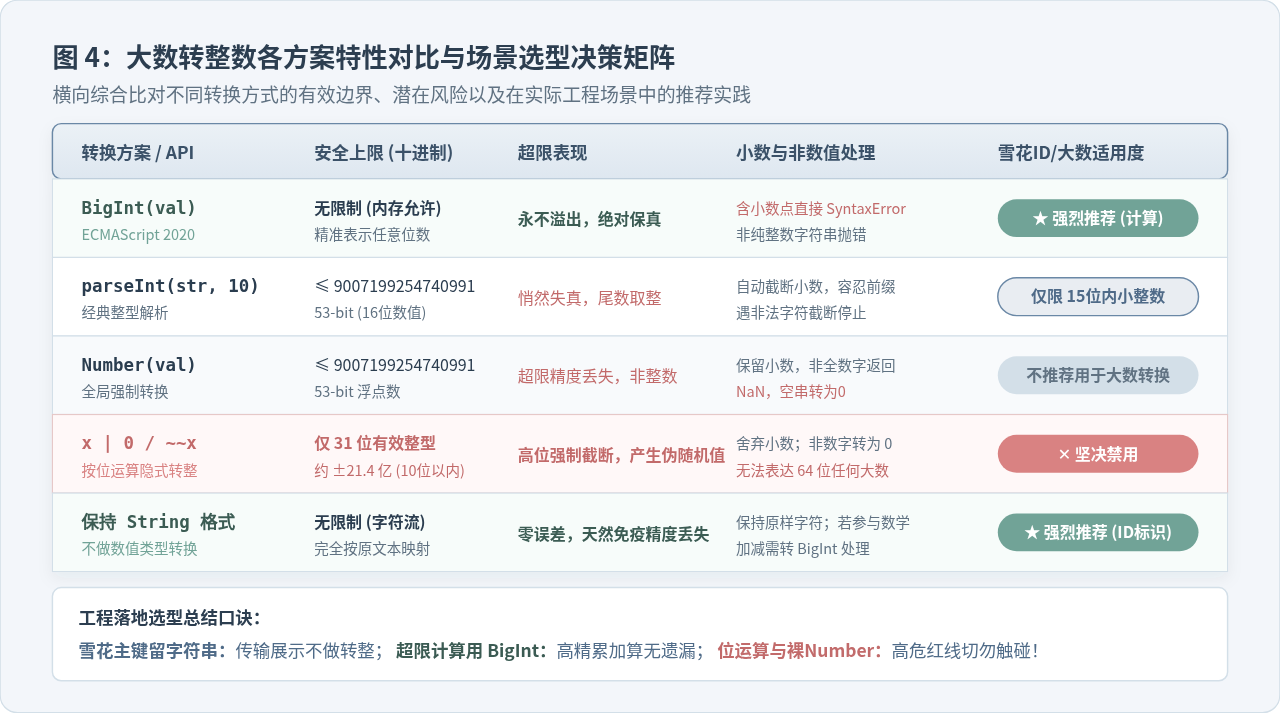
| 转换方案 | 安全阈值 | 超限表现 | 序列化友好度 | 业务推荐场景 |
|---|---|---|---|---|
| 保持 String | 无上限 | 绝不失真 | 原生支持,完全保真 | 业务 ID、订单流水号、Token(无需数学运算,只用于查询与展示) |
| BigInt(str) | 无上限 (依赖内存) | 绝不溢出 | 需扩充 toJSON |
高精度资产计息、微积分计算、区块链 Hash 整型累加 |
| parseInt(str, 10) | ≤ 253 - 1 | 截断/舍入误差 | 原生支持 | 分页页码、列表索引、普通计数器(15位以内纯整型) |
| 按位运算 (| 0, ~~) | ≤ 231 - 1 | 高位直接丢失溢出 | 原生支持 | 仅用于图形渲染内部小坐标、性能敏感微计算(大数完全禁止) |
终极检查清单(生产环境 5 条铁律):
- 铁律 1(标识不转数):雪花 ID、订单号、用户主键等,其本质是“以数字形式呈现的唯一字符串标识”,前端全链路严禁将其转为
Number,直接保留String处理。 - 铁律 2(接口契约规范):涉及大于 15 位数字的主键字段,后端向前端返回 JSON 时必须统一格式化为字符串。
- 铁律 3(位运算红线):在全项目 ESLint 规则中开启
no-bitwise,避免团队成员出于习惯随手书写val | 0造成隐蔽 Bug。 - 铁律 4(大数必须由字符串构造):使用
BigInt时,坚决禁止书写BigInt(obj.bigNumber),必须确保入参为原始字符串形式。 - 铁律 5(序列化防护):全局注入
BigInt.prototype.toJSON = function() { return this.toString(); },防止向后端传参或本地缓存使用JSON.stringify时引发意外奔溃。
JS 怎么使用 pako.js 解压 gzip 数据流
2026-11-05 15:54:33
零基础先学JavaScript还是Python?对比学习难度与上手曲线
2026-11-05 14:47:40
JS代码反混淆:主流在线工具与本地软件推荐
2026-11-04 19:28:41
浏览器控制台查看格式化JSON有哪些实用技巧
2026-11-04 16:56:53
JS控制台打印基础:console.log语法与多参数用法
2026-11-04 09:23:11







