

JS手机号正则校验误判漏判的常见原因与修正
深入剖析JavaScript手机号正则校验中误判与漏判的四大核心原因,包括起止边界符缺失、RegExp全局修饰符状态机陷阱、过时的号段白名单以及输入噪声,并提供生产级标准修复方案与用例验证。
在前端表单验证中,手机号校验逻辑看似简单,却经常出现两类严重问题:把非法输入判定为合法的“误判”,以及把真实用户的手机号拒之门外的“漏判”。绝大多数线上问题并非正则语法报错,而是源自正则边界符缺失、共享带 /g 修饰符的正则实例、死板枚举已落伍的号段白名单,以及未清洗复制粘贴带来的首尾空白与特殊符号。本文针对这些具体场景,逐项剖析底层原因并给出可直接复用的标准修正实现。
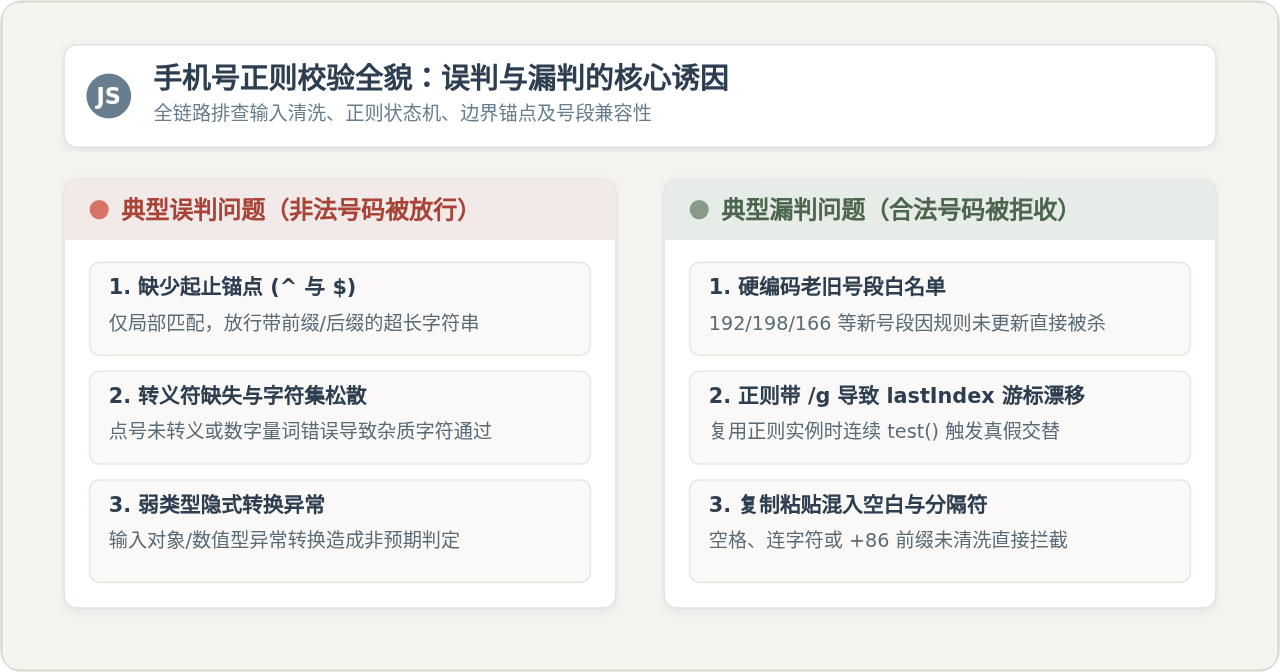
一、导致“误判”的核心原因:子串匹配与弱校验
误判指的是代码将本不符合中国大陆 11 位手机号规范的文本判定为校验通过。这类问题容易让脏数据、注入字符串或畸形输入直接流入后端数据库。
1. 缺少起止锚点(^ 与 $)
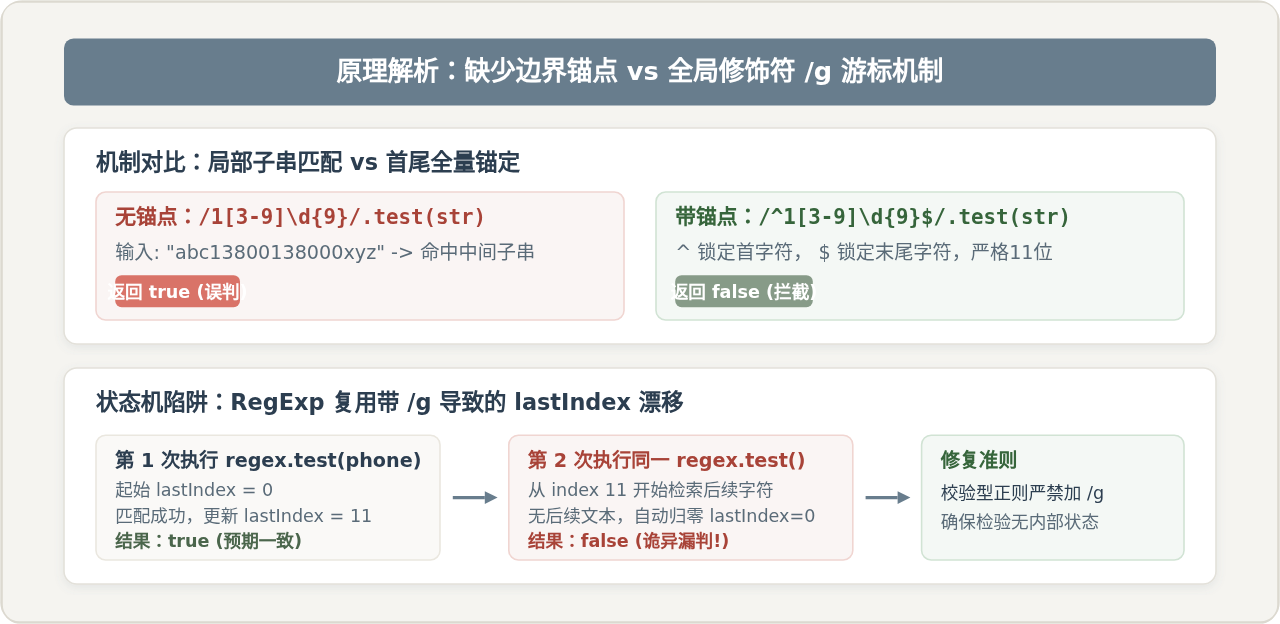
在 JavaScript 中,RegExp.prototype.test() 默认的行为是“子串搜索”而非“全串匹配”。只要被测试字符串中有一段能够契合正则表达式,就会返回 true。
例如许多初学者常写出类似 /1[3-9]\d{9}/ 的正则表达式,一旦输入 "abc13800138000xyz"、"13800138000123"(14位超长数字)甚至恶意脚本片段,正则都会命中其中的 11 位连续数字并判定为有效。
// 错误示例:缺少首尾锚点
const wrongRegex = /1[3-9]\d{9}/;
console.log(wrongRegex.test("tel: 13800138000_extra")); // true,产生严重误判
console.log(wrongRegex.test("138001380009999"));       // true,超长数字被误放行

// 正确示例:显式使用 ^ 锁定开头、$ 锁定结尾
const correctRegex = /^1[3-9]\d{9}$/;
console.log(correctRegex.test("tel: 13800138000_extra")); // false
console.log(correctRegex.test("138001380009999"));       // false
2. 数字量词与字符集松散
另一个导致误判的常见细节是数字量词书写随意。中国大陆手机号码总长固定为 11 位数字,第一位固定为 1,第二位当前覆盖 3-9,后续必须且只能跟随 9 位阿拉伯数字。写成 \d+ 或未限制字符集的规则,都会导致任意长度的数字串被放行。
二、导致“漏判”的核心原因:有状态正则与号段落后
相比于误判,漏判的危害往往更为隐蔽和直接:它会把真实注册或登录的用户硬生生拦截在表单外,直接造成用户流失与投诉。
1. RegExp 携带全局修饰符 /g 导致 lastIndex 游标漂移
这是 JavaScript 正则中最经典也最容易让人困惑的 Bug。很多开发者为了“图全面”,习惯性在正则末尾附带 /g(Global 标志),或者将带有 /g 的正则定义为全局模块常量并在表单校验中反复调用。
带有 /g 或 /y 的 RegExp 实例是有状态的。每次调用 test() 命中后,正则对象的 lastIndex 属性会被更新为匹配子串结束位置的索引。当下一次再次调用该正则的 test() 时,JavaScript 会从该 lastIndex 位置向后检索。对于固定长度的全匹配字符串,第二次检测必然因为找不到后续字符而返回 false,并将 lastIndex 重置为 0。这就导致了“同一个合法手机号连续点两次,一次成功一次失败”的诡异现象。
// 危险模式:复用带有 /g 的正则对象
const globalRegex = /^1[3-9]\d{9}$/g;

console.log(globalRegex.test("13800138000")); // true,此时 globalRegex.lastIndex 被置为 11
console.log(globalRegex.test("13800138000")); // false,从 index 11 开始检索,直接漏判!
console.log(globalRegex.test("13800138000")); // true,上一次失败后重置为 0,又变回 true

// 修正规则:校验类正则表达式严禁携带 /g 修饰符
const safeRegex = /^1[3-9]\d{9}$/;
console.log(safeRegex.test("13800138000")); // 始终为 true,幂等安全
2. 硬编码老旧号段白名单导致新用户被拦截
很多项目早期从网络上复制了一段极其冗长、精细枚举各个号段的正则表达式,例如 /^1(3[0-9]|4[57]|5[0-35-9]|7[0135678]|8[0-9])\d{8}$/。
工信部在过去数年中陆续分配了大量全新号段,包括中国广电的 192、中国移动的 198/195、中国联通的 166/167、中国电信的 199/191/193,以及各类虚拟运营商的 16x/17x 号段。如果前端代码仍在使用早期的静态白名单,所有持有这些新号段的合法用户在提交时都会被提示“请输入正确的手机号码”,造成严重的生产故障。
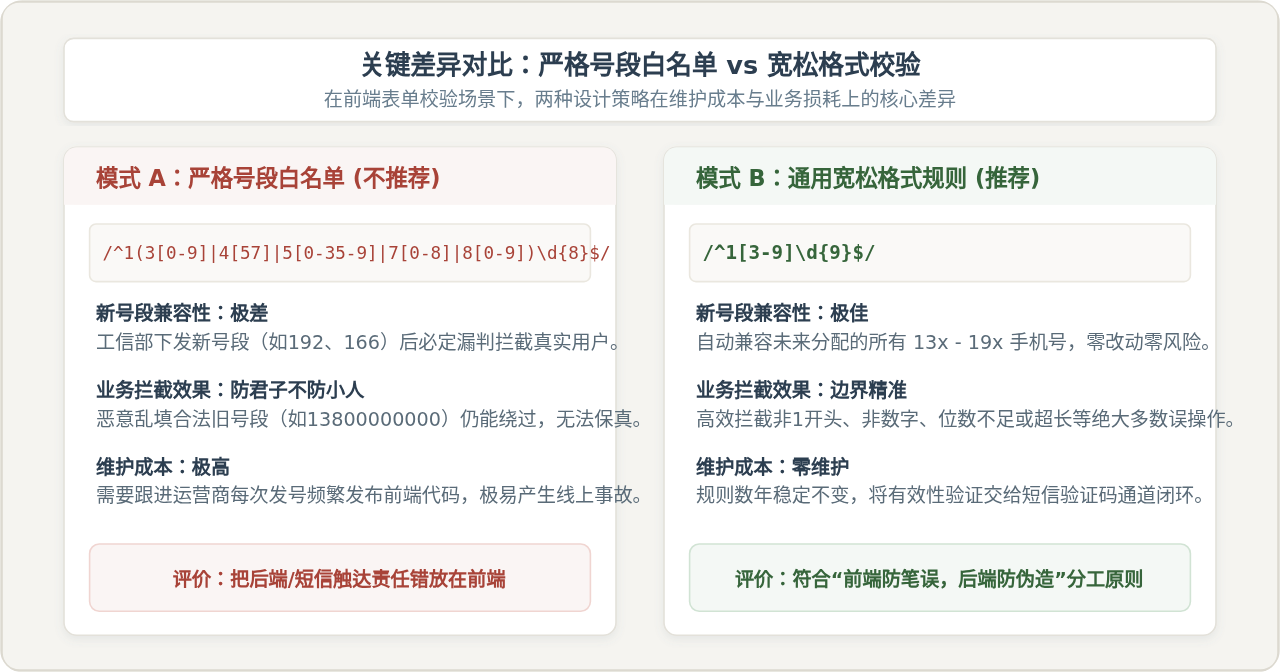
三、关键差异剖析:严格号段规则 vs 宽松格式规则
为了在源头上避免漏判,我们需要在一致的使用条件下,对比“严格号段白名单”与“通用宽松格式校验”的实际表现:
| 对比维度 | 严格号段白名单(如 13x/15x/18x 枚举) | 宽松格式校验(/^1[3-9]\d{9}$/) |
|---|---|---|
| 新号段适应性 | 极差。每次工信部下发新号段都必须手动修改代码并重新发布。 | 优秀。天然兼容未来规划的 13x-19x 全号段,无需频繁发版。 |
| 漏判率 | 高。新号段用户被直接拦截,造成有效用户转化流失。 | 极低。符合国内手机号结构的合法输入均可顺利通过。 |
| 拦截虚假号码能力 | 虚假安全。无法拦截随手编造的真实号段空号(如 13800000000)。 | 明确职责。只拦截非数字、字符不足或格式畸形输入。 |
| 维护成本 | 高。需要专人持续跟踪运营商发号动态并维护复杂正则。 | 零维护。规则长期稳定,团队心智负担低。 |
| 工程合理性 | 越权。试图在前端完成本应由短信通道承载的真实性校验。 | 合理。契合“前端校验防笔误,短信下发证真伪”的设计原则。 |
四、输入噪声导致的隐蔽漏判与预处理
除了正则本身的逻辑问题,另一个容易被忽略的漏判原因是“未对用户输入做预处理”。用户在移动端填写表单时,经常通过系统剪贴板粘贴号码,这些文本往往夹杂着不可见噪声:
- 首尾与中间空格:通讯录复制的号码常带有格式化空格,如
"138 0013 8000 "。 - 连字符与特殊分隔符:部分设备粘贴内容形如
"138-0013-8000"。 - 国际区号前缀:带有
"+86"或"0086"前缀。 - 数据类型异常:从某些框架表单绑定的值可能是
number类型,若未转为string可能会在特定调用中引发非预期错误。
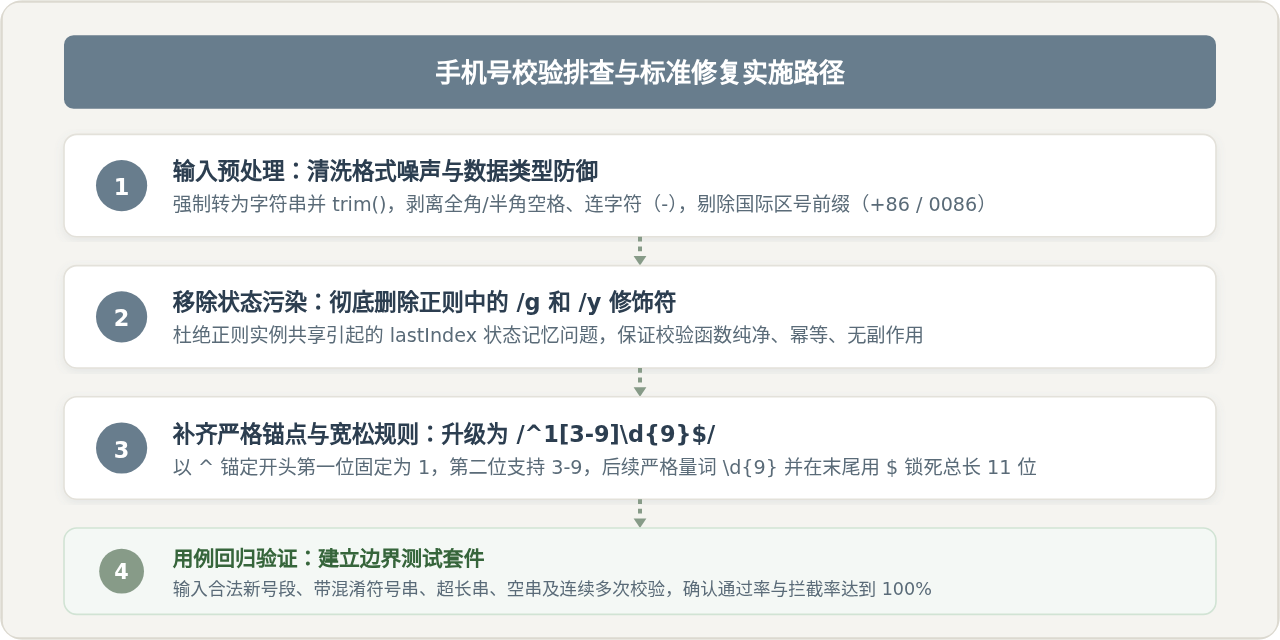
五、生产级标准修复方案与完整代码
结合上述分析,一个健壮的手机号校验模块应当包含两部分:输入清洗(Sanitize)与无状态全量匹配(Validate)。以下为推荐在项目中落地的标准封装:
/**
 * 手机号码格式清洗与校验工具
 * 适用场景:中国大陆 11 位通用手机号基础格式校验
 */

// 预编译无状态正则:严禁添加 /g 标志
const MOBILE_REGEXP = /^1[3-9]\d{9}$/;

/**
 * 清洗手机号字符串
 * 去除首尾空格、中间空格、破折号及常见的中国国际区号 (+86 / 0086)
 * @param {unknown} rawValue 原始输入
 * @returns {string} 清洗后的纯数字字符串
 */
function sanitizeMobile(rawValue) {
  if (rawValue === null || rawValue === undefined) {
    return "";
  }

  // 确保转为纯字符串并去除首尾空白
  let value = String(rawValue).trim();

  // 剥离常见的国际区号前缀
  if (value.startsWith("+86")) {
    value = value.slice(3).trim();
  } else if (value.startsWith("86") && value.length > 11) {
    value = value.slice(2).trim();
  } else if (value.startsWith("0086")) {
    value = value.slice(4).trim();
  }

  // 移除数字之间的空格、破折号及全角横杠
  value = value.replace(/[\s\-‐-―]/g, "");

  return value;
}

/**
 * 校验手机号码是否符合规范
 * @param {unknown} value 输入值
 * @param {boolean} autoSanitize 是否自动执行预清洗,默认为 true
 * @returns {{ isValid: boolean, sanitized: string, error?: string }}
 */
function validateMobile(value, autoSanitize = true) {
  const target = autoSanitize ? sanitizeMobile(value) : String(value || "");

  if (!target) {
    return { isValid: false, sanitized: target, error: "手机号不能为空" };
  }

  if (target.length !== 11) {
    return { isValid: false, sanitized: target, error: "手机号必须为11位数字" };
  }

  if (!MOBILE_REGEXP.test(target)) {
    return { isValid: false, sanitized: target, error: "手机号格式不正确" };
  }

  return { isValid: true, sanitized: target };
}
测试用例回归验证
修复上线前,应使用以下典型用例覆盖常规与边界情况,确保既不误判也不漏判:
// 1. 合法新旧号段回归(必须全部为 true)
console.assert(validateMobile("13800138000").isValid === true, "老牌移动号段通过");
console.assert(validateMobile("19212345678").isValid === true, "中国广电 192 号段通过");
console.assert(validateMobile("19800000000").isValid === true, "中国移动 198 号段通过");
console.assert(validateMobile("16612345678").isValid === true, "中国联通 166 号段通过");
console.assert(validateMobile("19912345678").isValid === true, "中国电信 199 号段通过");

// 2. 带格式噪声的真实输入(清洗后必须为 true)
console.assert(validateMobile(" 138 0013 8000 ").isValid === true, "带空格输入通过");
console.assert(validateMobile("+8613800138000").isValid === true, "带国际区号通过");
console.assert(validateMobile("138-0013-8000").isValid === true, "带连字符输入通过");

// 3. 非法畸形输入防误判(必须全部为 false)
console.assert(validateMobile("13800138000999").isValid === false, "超长数字正确拦截");
console.assert(validateMobile("12800138000").isValid === false, "非法第二位正确拦截");
console.assert(validateMobile("abc13800138000").isValid === false, "混杂字母正确拦截");
console.assert(validateMobile("").isValid === false, "空串正确拦截");

// 4. /g 状态机回归(连续多次校验同一号码必须均返回 true)
for (let i = 0; i < 5; i++) {
  console.assert(validateMobile("13800138000").isValid === true, `第 ${i + 1} 次重复校验正常`);
}
六、排查核对清单与分工边界总结
解决手机号校验问题,根本在于树立正确的分层防护意识。在日常维护和 Code Review 时,可以通过以下四项清单快速排查:
- 查锚点:正则两端是否分别有
^和$,确保全量匹配。 - 查修饰符:正则末尾是否错误添加了
/g或/y,确保校验无共享状态。 - 查规则跨度:是否还在使用早已废弃的硬编码运营商号段表,建议统一切换为
/^1[3-9]\d{9}$/。 - 查清洗逻辑:是否对用户输入的空格、破折号和
+86前缀做好了兜底预处理。
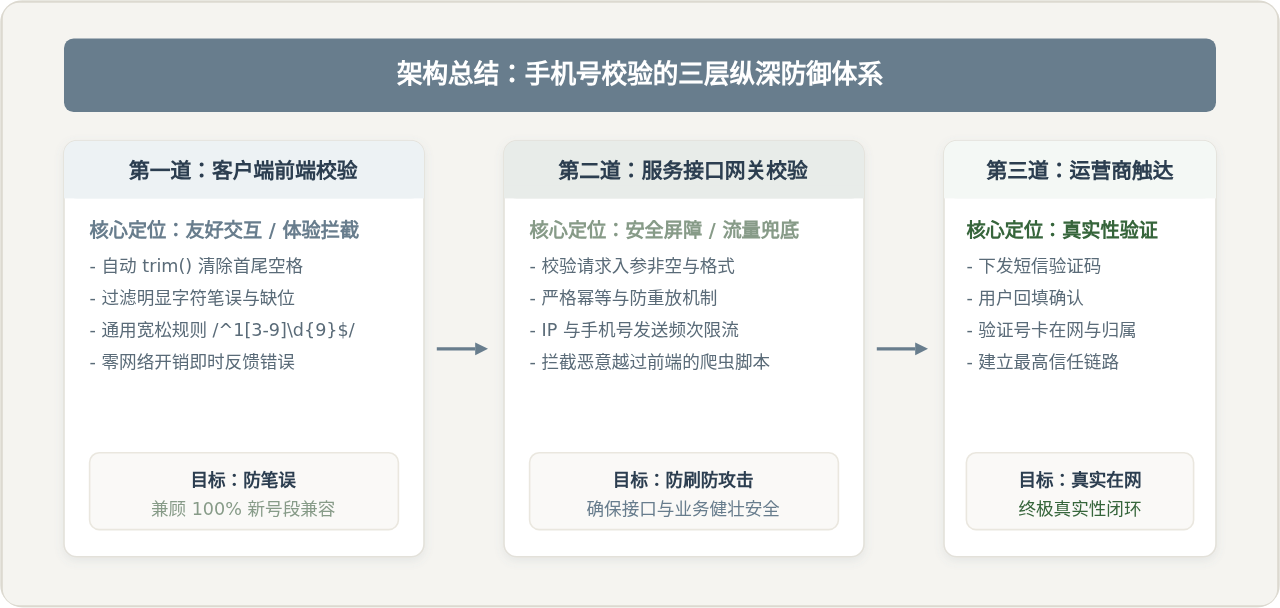
前端正则负责拦截低级的格式输入错误与笔误,后端接口负责防范绕过前端的恶意刷量与重放攻击,而手机号是否在网、是否属于当前操作者的真实性,则交由短信验证码通道最终确认。清晰界定这三层职责,既能从根本上消除误判与漏判,又能避免业务随着运营商新号段下发而频繁出现线上故障。
ES6模块化中js文件怎么用import和export交互
2026-11-05 17:00:48
JS读取本地文件时报错或无响应的常见原因
2026-11-05 16:32:31
let、const与var的区别:JavaScript变量声明最佳实践
2026-11-05 14:16:38
JS中直接定义静态二维数组的字面量写法
2026-11-05 14:16:08
JS 怎么查找字符串中所有匹配项的位置
2026-11-05 14:15:53







