JS中使用push.apply合并数组报栈溢出错误怎么解决?
深入解析在JavaScript中使用Array.prototype.push.apply合并大数组时抛出RangeError: Maximum call stack size exceeded报错的根因,并提供经典for循环、分块批处理(Chunking)与concat等经实测验证的有效解决方案及性能对比。
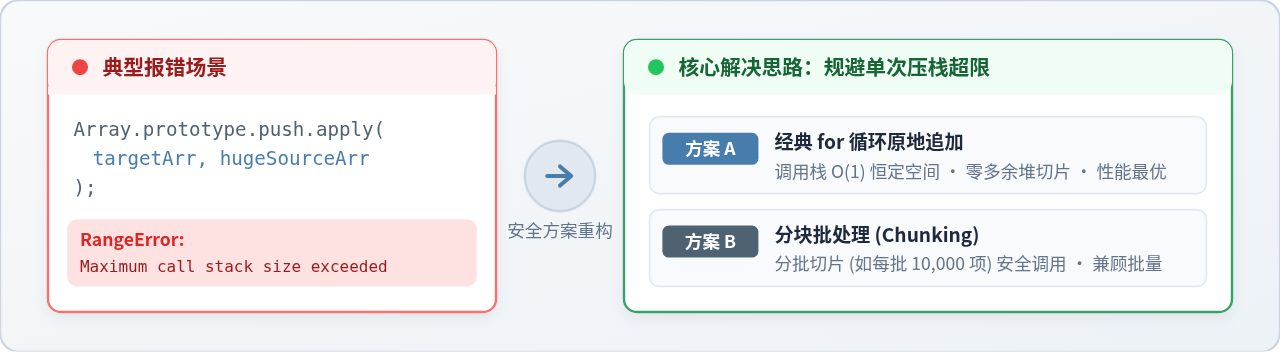
在 JavaScript 中使用 Array.prototype.push.apply(arr1, arr2) 合并数组时,如果 arr2 的元素数量达到数万甚至数十万,浏览器或 Node.js 会直接抛出 RangeError: Maximum call stack size exceeded(超出最大调用栈大小)错误。解决该问题的核心在于消除一次性将整个大数组展开为函数入参的机制。最稳妥高效的做法是改用原生的 for 循环原地追加,或者采用安全步长进行分块分批合并(Chunking);若业务允许生成新的数组实例,则可以直接使用标准的 concat 方法。
一、错误复现与核心原因解析
很多开发者习惯使用 arr1.push.apply(arr1, arr2) 或 ES6 的 arr1.push(...arr2) 将后一个数组的元素就地追加到前一个数组中。对于几百到几千项的中小数据,这种写法简洁且性能良好。但当数据规模膨胀时,就会立即崩溃。
Uncaught RangeError: Maximum call stack size exceeded在 Node.js 中同样表现为进程直接抛出未捕获的
RangeError 异常。
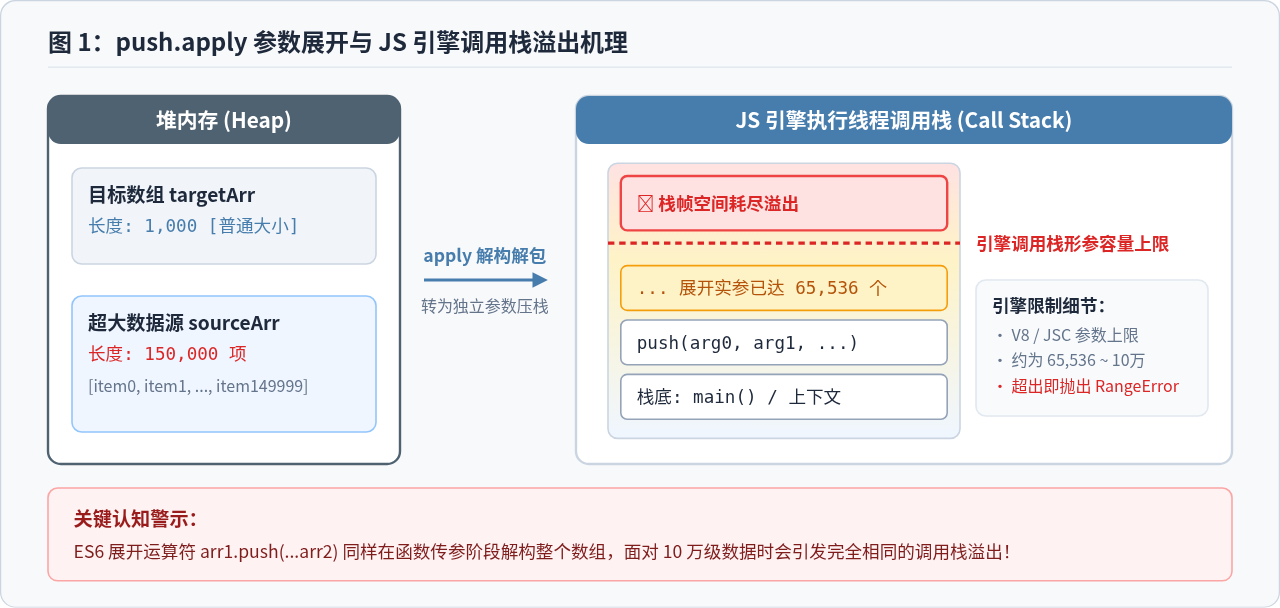
要理解为什么会报错,必须看清 Function.prototype.apply 的底层工作机制:
- 实参压栈机制:根据 ECMAScript 规范,
func.apply(thisArg, argsArray)会把argsArray中的每一项拆解出来,作为独立的形参逐一压入当前函数的调用栈帧中。 - JS 引擎的参数限制:不管是 Google Chrome / Node.js 使用的 V8 引擎,还是 Safari 的 JavaScriptCore,单次函数调用的栈帧参数容量都是有硬性上限的(例如早期固定在 65,536 个参数,或由栈内存总字节大小限制)。一旦传入十万个元素,引擎在准备函数调用栈帧时就会直接检测到溢出并抛出异常。
- Spread 展开运算符同样会爆栈:需要特别提醒的是,ES6 的展开运算符
arr1.push(...arr2)本质上也是将数组展开为逗号分隔的函数实参,因此在大数组面前与push.apply没有任何区别,同样会瞬间触发栈溢出。
二、排查与方案选型决策
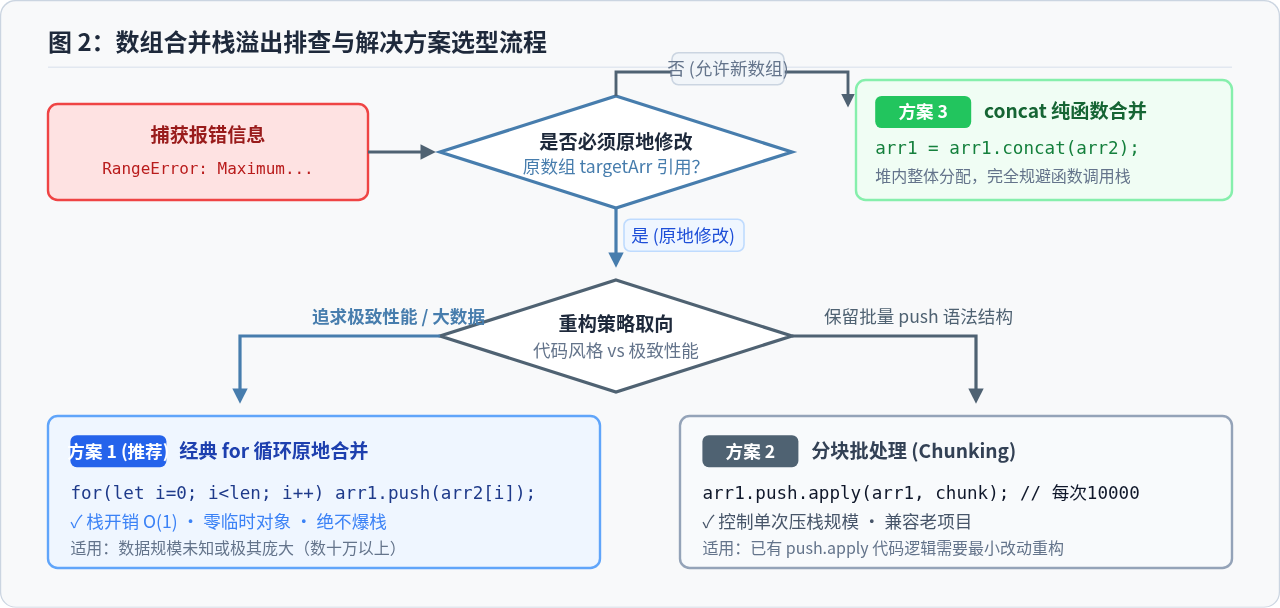
当遇到 Maximum call stack size exceeded 错误时,修复前需要先明确一个关键的业务约束:是否必须在原数组上原地修改(In-place mutation)?
- 如果其他模块、组件或闭包持有着
arr1的对象引用,必须就地修改arr1,不能更改引用地址; - 如果无需保持引用不变(如 Redux 纯函数、无状态计算),则可以生成全新数组。
三、解决方案一:经典 for 循环原地合并(首选推荐)
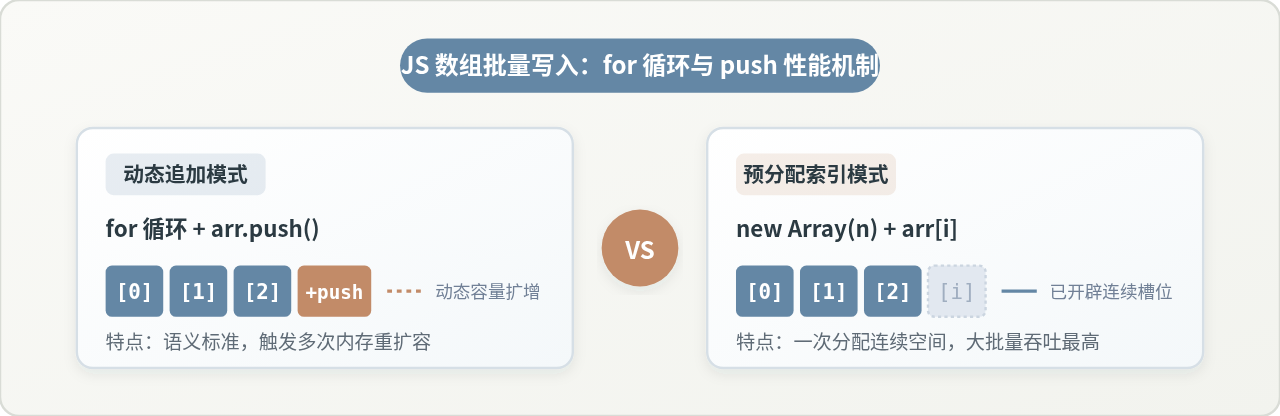
解决超大数组原地追加最稳妥、性能最优且绝对不爆栈的方案,是回归基础的 for 循环。包括 Lodash 等业界知名开源类库在内部处理大数组时,都普遍采用这种方式。
实现原理:循环体内部每次只调用一次普通的 push(item),单次调用仅有一个参数压栈,调用栈深度和栈帧大小在整个生命周期内恒定为 $O(1)$,无论待合并的数组是 10 万项还是 1000 万项,都不会耗尽调用栈。
/**
 * 原地合并数组(安全、高性能、O(1) 栈空间)
 * @param {Array} target 目标数组(被修改)
 * @param {Array} source 待追加的源数组
 * @returns {Array} target 原数组引用
 */
function safePushInPlace(target, source) {
  if (!Array.isArray(target) || !Array.isArray(source)) {
    throw new TypeError('参数必须均为数组');
  }

  const sourceLen = source.length;
  // 提前获取 length,避免每次循环重复计算
  for (let i = 0; i < sourceLen; i++) {
    target.push(source[i]);
  }

  return target;
}slice)带来的内存堆分配与垃圾回收(GC)负担。在 V8 引擎中,由于 push 经过了内联优化(Inline Cache),连续 push 的执行速度极其迅猛。
四、解决方案二:分块批处理合并(Chunking)
如果业务架构高度依赖 push.apply 的批量语义,或者希望对历史存量代码做最小改动,可以引入分块(Chunking)策略。将巨大的 arr2 拆分成若干个安全大小的子数组(例如每块 10,000 到 20,000 项),分批次执行 push.apply。
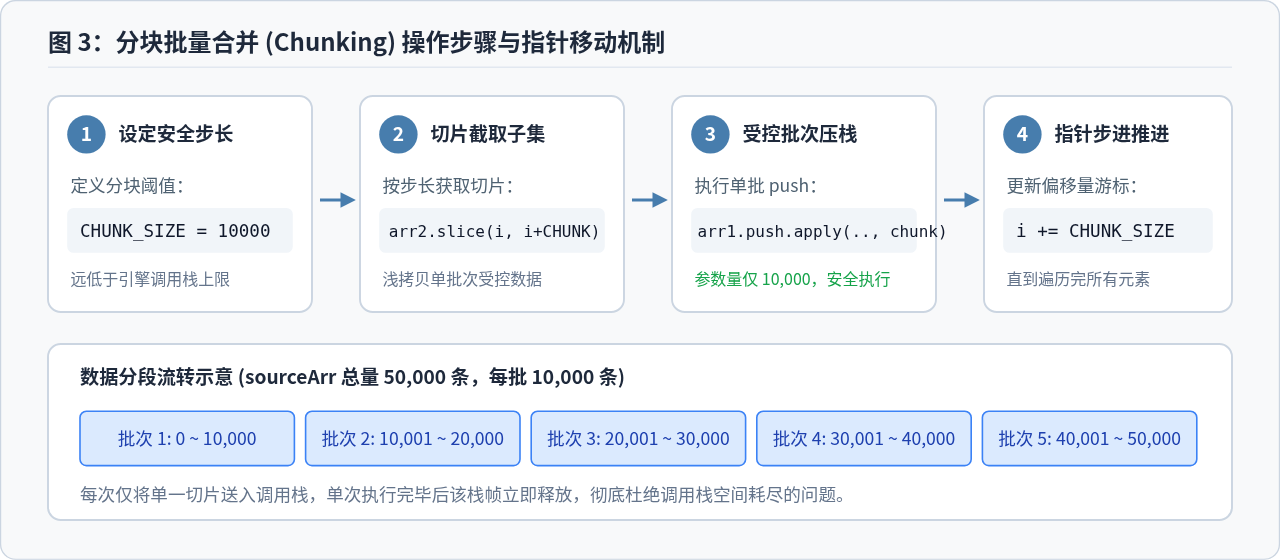
实现步骤与完整示例代码:
/**
 * 分块原地追加合并大数组
 * @param {Array} target 目标数组
 * @param {Array} source 源数组
 * @param {number} chunkSize 每次批量 push 的最大容量,建议 10000~20000
 */
function chunkedPushApply(target, source, chunkSize = 10000) {
  const len = source.length;
  for (let i = 0; i < len; i += chunkSize) {
    // 1. 切出当前批次的安全子数组
    const chunk = source.slice(i, i + chunkSize);
    // 2. 安全调用 push.apply,单次栈帧参数仅为 chunkSize
    Array.prototype.push.apply(target, chunk);
  }
  return target;
}

// 验证执行
const baseList = [1, 2, 3];
const largeList = new Array(120000).fill('item');
chunkedPushApply(baseList, largeList, 10000);
console.log(baseList.length); // 示例输出: 120003(无任何报错)注意事项:虽然分块批处理解决了栈溢出,但每次执行 source.slice() 时都会在堆内存中创建临时子数组。如果源数组非常庞大(例如数百万项),频繁 slice 会造成一定的垃圾回收压力,因此性能上仍略逊于单层 for 循环。
五、解决方案三:使用 concat 创建新数组(纯函数场景)
如果在代码逻辑中不需要修改 arr1 的原有引用,直接使用 JavaScript 原生的 Array.prototype.concat 是最语义化且不会爆栈的写法。
// 创建新数组,不修改原数组引用
let arr1 = [1, 2, 3];
const arr2 = new Array(200000).fill('data');

// concat 在堆内存直接分配空间拼接,不经过实参压栈
arr1 = arr1.concat(arr2);
console.log(arr1.length); // 示例输出: 200003机制解释:concat 内部是由 JS 引擎底层 C++ 直接在堆内存中申请一段能够容纳两部分数据的新缓冲区并完成内存拷贝,完全不需要将元素作为形参压入当前执行栈,因此天然不受调用栈容量的约束。但需要留意,它会分配一个新的完整数组副本,内存开销相对较高。
六、方案横向对比与选型指南
为了帮助读者根据实际项目场景作出最佳抉择,下表与对比图对上述四种方案的关键特性进行了全面比对:
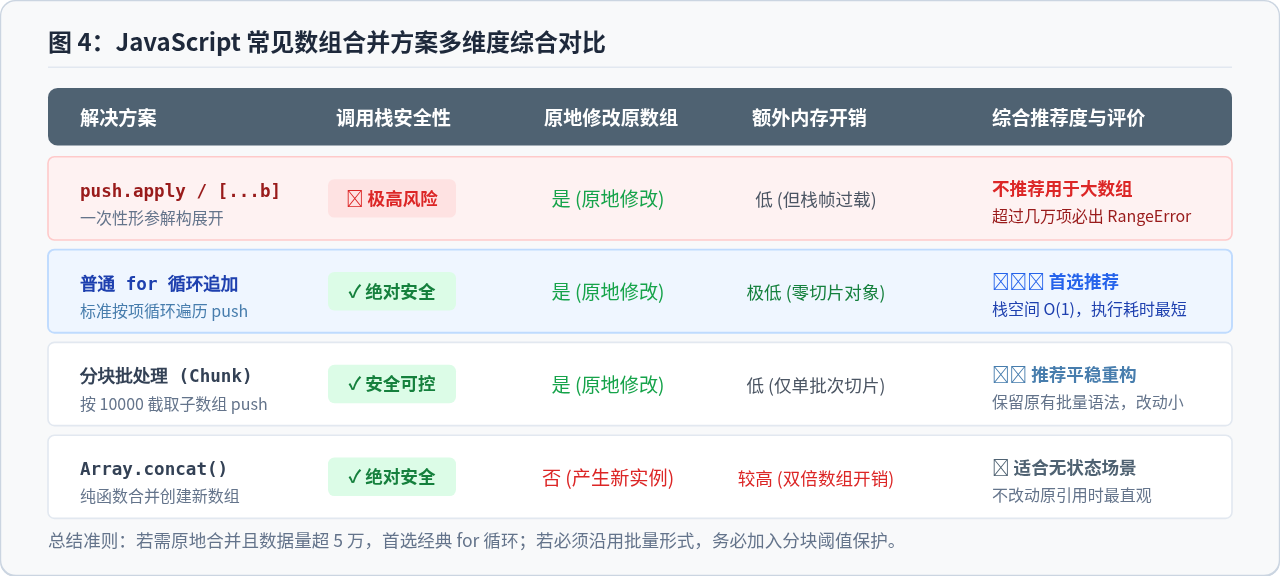
| 合并方案 | 调用栈安全性 | 是否修改原引用 | 内存消耗峰值 | 执行性能 | 推荐使用场景 |
|---|---|---|---|---|---|
push.apply(a, b) |
高风险(大数组溢出) | 是 (In-place) | 低 | 极快(但受限) | 仅限数据量严格 < 5,000 的极小数组 |
push(...b) |
高风险(大数组溢出) | 是 (In-place) | 低 | 极快(但受限) | 仅限日常少量元素展开,绝不可用于大数据 |
| 普通 for 循环 | 绝对安全(O(1) 栈) | 是 (In-place) | 极低(零多余对象) | 最优 | 推荐首选:任何原地合并大数组场景 |
| 分块 Chunking | 安全受控(阈值可配) | 是 (In-place) | 较低(临时切片) | 良好 | 需要平滑重构既有 push.apply 代码 |
| Array.concat | 绝对安全(走堆内存) | 否(生成新数组) | 较高(双倍内存开销) | 次优 | 无需保持原数组引用的纯函数计算场景 |
七、验证测试与避坑要点
在工程项目中完成改造后,可以通过一段轻量级的测试用例来验证合并效果与栈安全性:
// 验证脚本:模拟 200,000 条大数据原地合并
function runTest() {
  const listA = ['head-1', 'head-2'];
  const bigList = new Array(200000).fill(0).map((_, i) => `item-${i}`);

  console.time('safePushInPlace');
  safePushInPlace(listA, bigList);
  console.timeEnd('safePushInPlace');

  // 验证长度与尾项完整性
  console.log('合并后总长度:', listA.length); // 示例输出: 200002
  console.log('最后一项校验:', listA[listA.length - 1]); // 示例输出: item-199999
}

runTest();最后提醒:切勿寄希望于通过 try...catch 来捕获 push.apply 的栈溢出错误并在此之后重试。因为当 Maximum call stack size exceeded 抛出时,原数组可能已经被部分修改,或者当前调用栈上下文已处于异常状态。从架构上直接采用 for 循环或分块追加,从源头杜绝参数超限,才是健壮的前端与 Node.js 服务端开发实践。
JS 鼠标滚轮事件频繁触发导致卡顿怎么优化?
2026-11-05 17:08:07
优化JS回到顶部性能:防抖节流与requestAnimationFrame应用
2026-11-05 16:33:51
JS中Array、Set与Map的区别及应用场景选择
2026-11-05 16:03:02
PixiJS 常见报错排查:纹理跨域、黑屏与内存泄漏解决
2026-11-05 10:05:21
JS数组find与filter取值区别及性能对比
2026-11-05 08:39:21