JS数组find与filter取值区别及性能对比
深入对比JavaScript中Array.prototype.find与filter的核心取值差异、遍历短路机制、性能耗时与内存开销,并提供实用选型指南与避坑建议。
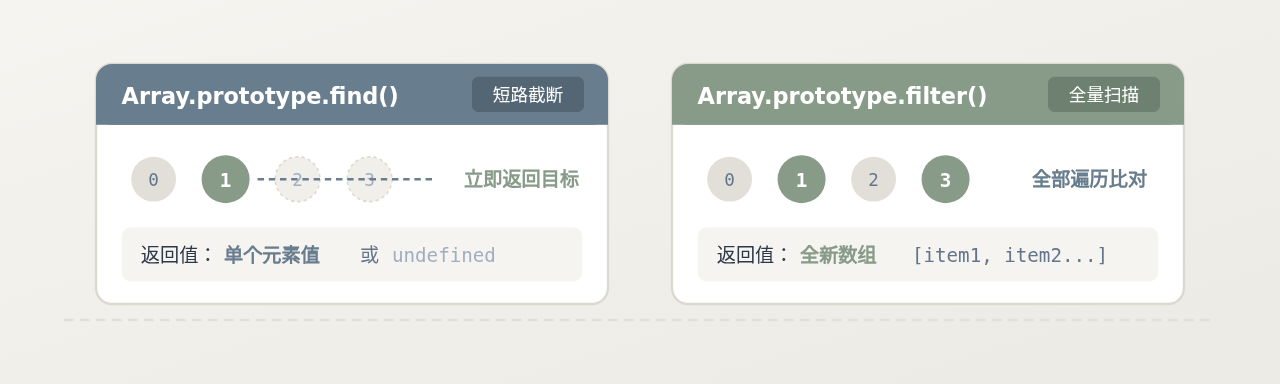
find 与 filter 都是用于条件筛选的高阶方法,但两者的设计目的与底层机制截然不同:find 专为查找单项设计,一旦命中首个符合条件的元素便立即停止遍历(短路截断),直接返回该元素本身或 undefined;filter 专为收集子集设计,无论何时都会完整遍历整个数组,将所有符合条件的元素浅拷贝装入一个全新数组中返回。选对方法不仅关乎数据取值的准确性,在较大数据集或高频执行场景下更存在明显的执行时间与内存开销差异。
一、核心取值行为与返回值区别
在业务开发中,开发者最容易混淆的是两者在命中结果类型以及未命中边界情况下的返回值表现。理解这一差异是编写健壮逻辑的前提。
1. 命中情况下的返回结构
find 接收一个测试函数 predicate,并在数组中自左向右依次检查元素。当测试函数第一次返回真值(truthy)时,find 会直接返回当前元素的原生引用或原始值。
而 filter 同样接收测试函数,但它不会在第一次匹配时停下,而是把所有使测试函数返回真值的元素逐一放入一个新创建的数组容器中,最终返回这个新数组。即使整个数组只有一项满足条件,filter 返回的依然是包裹该项的单元素数组。
2. 未命中时的边界陷阱
当数组中没有任何元素满足筛选条件时:
find返回undefined:这是一个假值(falsy),可以直接配合可选链操作符(?.)或空值合并操作符(??)进行后续安全调用与默认值赋值。filter返回空数组[]:在 JavaScript 的类型转换规则中,空数组对象在布尔上下文中始终判定为真值(truthy)!
很多初学者会写出 if (users.filter(u => u.id === targetId)) { ... } 这样的代码。由于未找到元素时 filter 返回的是 [],其布尔值为 true,导致条件分支始终被错误执行。正确的做法是使用 users.find(...) 判断是否存在,或者检查 filter(...).length > 0。
通过下方具体代码可以清晰观察两者的返回值差异:
// 原始用户数据集
const users = [
  { id: 101, name: 'Alice', role: 'editor' },
  { id: 102, name: 'Bob',   role: 'author' },
  { id: 103, name: 'Carol', role: 'author' },
  { id: 104, name: 'David', role: 'admin'  }
];

// 场景 A:命中条件(查找角色为 author 的用户)
const foundUser = users.find(u => u.role === 'author');
console.log(foundUser);
// 示例输出: { id: 102, name: 'Bob', role: 'author' }
// 特点: 直接得到第一个匹配的对象本身

const filteredUsers = users.filter(u => u.role === 'author');
console.log(filteredUsers);
// 示例输出: [ { id: 102, name: 'Bob', role: 'author' }, { id: 103, name: 'Carol', role: 'author' } ]
// 特点: 得到一个包含所有匹配对象的新数组

// 场景 B:未命中条件(查找不存在的 id)
const missingFound = users.find(u => u.id === 999);
console.log(missingFound);
// 示例输出: undefined

const missingFiltered = users.filter(u => u.id === 999);
console.log(missingFiltered);
// 示例输出: []
console.log(Boolean(missingFiltered));
// 示例输出: true (注意: 空数组布尔值为真值)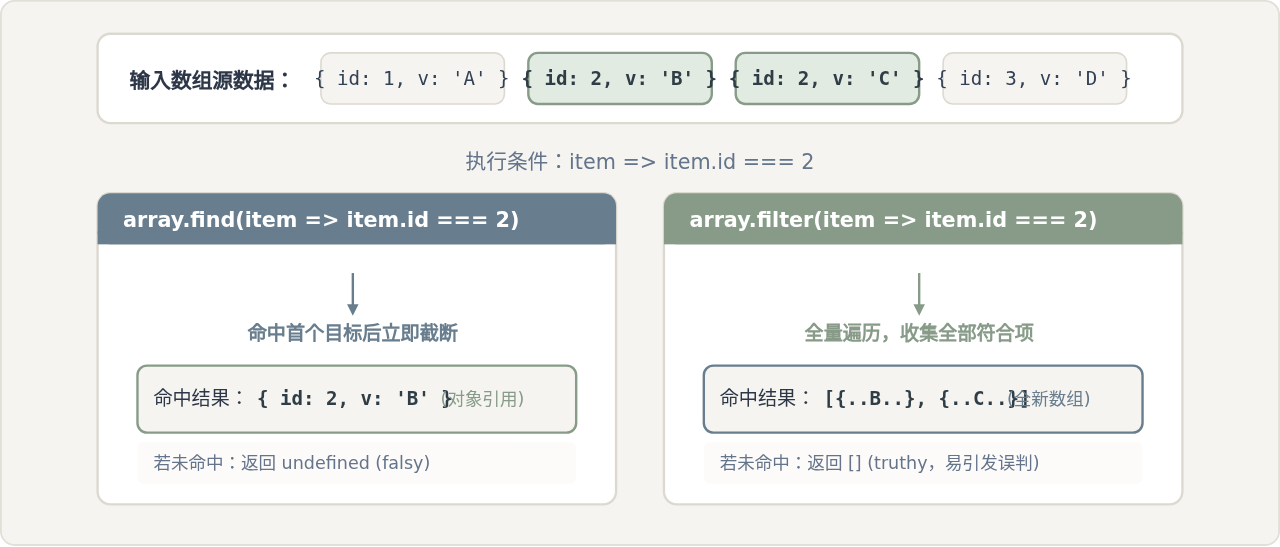
二、遍历机制与短路执行(Early Exit)过程
取值结果上的区别,本质上源于两者底层循环推进策略的不同。在 ECMAScript 规范定义中,find 具备短路(Short-circuiting)特性,而 filter 必须完成穷举遍历。
1. 短路机制的工作流程
短路机制意味着遍历可以在满足特定条件时提前退出:
- 初始化索引指针
k = 0。 - 获取当前元素
kValue = array[k]。 - 调用回调函数
predicate(kValue, k, array)。 - 若结果为真:立即终止执行循环,直接返回
kValue,后续元素完全不参与计算。 - 若结果为假:将指针递增
k = k + 1并回到步骤 2,直到遍历完整个数组。
正因为这个机制,如果目标元素位于数组第 0 位,find 的循环体仅运行 1 次就宣告结束。
2. 穷举遍历的工作流程
与此相对,filter 没有早退通道。它必须严格从下标 0 遍历至下标 length - 1。即使在第 0 项就已经找到了想要的项,引擎仍必须对后续成千上万个元素执行一遍测试函数,判定它们是否也符合条件。
下面的代码通过为回调函数注入计数器,直观展示两者的执行步数差异:
// 创建包含 100,000 个数字的测试大数组
const largeData = Array.from({ length: 100000 }, (_, i) => i + 1);

// 查找目标:数值为 5 的项(位于数组靠前位置)
let findCallCount = 0;
largeData.find(num => {
  findCallCount++;
  return num === 5;
});

let filterCallCount = 0;
largeData.filter(num => {
  filterCallCount++;
  return num === 5;
});

console.log(`find 回调执行次数: ${findCallCount}`);
// 示例输出: find 回调执行次数: 5 (仅循环 5 次即终止)

console.log(`filter 回调执行次数: ${filterCallCount}`);
// 示例输出: filter 回调执行次数: 100000 (完整遍历 10 万次)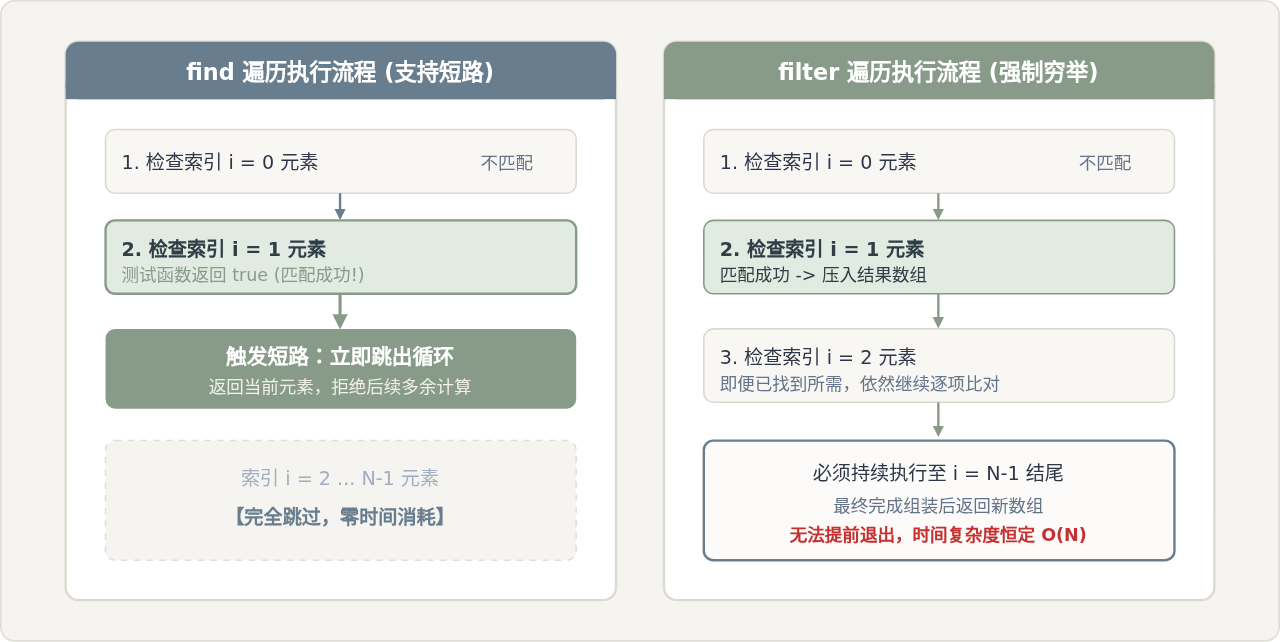
三、性能对比与内存开销分析
短路机制不仅决定了代码的逻辑流程,在计算性能和内存资源分配方面也带来了显著差距。我们可以从时间复杂度、目标位置敏感度与内存开销(GC压力)三个维度深入拆解。
1. 时间复杂度维度的差异
-
find的时间复杂度为 \(O(K)\):其中 \(K\) 代表目标元素首次出现的索引位置加 1(\(1 \le K \le N\))。在最佳情况下(目标就在第 0 位),时间复杂度仅为 \(O(1)\);在平均情况下约为 \(O(N/2)\);仅在最差情况(目标在尾部或不存在)时退化为 \(O(N)\)。 -
filter的时间复杂度恒定为 \(O(N)\):不论目标在开头还是结尾,都必须完整执行 \(N\) 次测试函数并进行边界检查。
2. 内存分配与垃圾回收(GC)影响
除了 CPU 周期,内存开销往往是高性能前端或 Node.js 服务端更应关注的指标:
find零新容器分配:它只是在已有数组上进行指针移动与比较,命中后直接传递原对象引用,不会在堆内存中额外分配新的 Array 实例。filter产生新数组对象:无论筛选结果包含多少项,引擎都必须开辟新的内存块来存放 Array 头部与元素指针。如果在一个每秒触发数十次的循环或高频交互中滥用filter来获取单条记录,会频繁产生短暂存活的临时数组,诱发 V8 引擎的新生代垃圾回收(Scavenge GC),甚至引发页面微卡顿。
| 对比维度 | Array.prototype.find | Array.prototype.filter |
|---|---|---|
| 主要设计意图 | 寻找满足条件的“第一项” | 搜集满足条件的“所有项” |
| 返回值形态 | 元素本身(引用/基础类型)或 undefined |
浅拷贝构成的新数组 Array(无结果为 []) |
| 遍历机制 | 支持短路(命中后立即 break 退出) | 无短路,必须执行完整的全量迭代 |
| 最佳时间复杂度 | \(O(1)\)(首项命中) | \(O(N)\)(无论何处命中均需扫完全部) |
| 最差时间复杂度 | \(O(N)\)(尾项命中或未找到) | \(O(N)\) |
| 内存额外开销 | 无(直接返回引用,零多余分配) | 有(必须为新数组容器分配堆内存空间) |
为了直观验证这种性能差异,可以使用标准 performance.now() 运行以下基准测试:
// 构造包含 500,000 个复杂对象的测试数据
const count = 500000;
const testArray = Array.from({ length: count }, (_, i) => ({
  id: i,
  code: `CODE_${i}`,
  isActive: i % 2 === 0
}));

// 测试 1:目标位于数组靠前位置(id === 100)
console.time('find (前部命中)');
const resFindEarly = testArray.find(item => item.id === 100);
console.timeEnd('find (前部命中)');
// 示例耗时: ~0.02ms

console.time('filter (前部命中取[0])');
const resFilterEarly = testArray.filter(item => item.id === 100)[0];
console.timeEnd('filter (前部命中取[0])');
// 示例耗时: ~8.50ms (相差百倍以上)

// 测试 2:目标位于数组尾部位置(id === 499999)
console.time('find (尾部命中)');
const resFindLate = testArray.find(item => item.id === 499999);
console.timeEnd('find (尾部命中)');
// 示例耗时: ~7.90ms

console.time('filter (尾部命中)');
const resFilterLate = testArray.filter(item => item.id === 499999)[0];
console.timeEnd('filter (尾部命中)');
// 示例耗时: ~8.80ms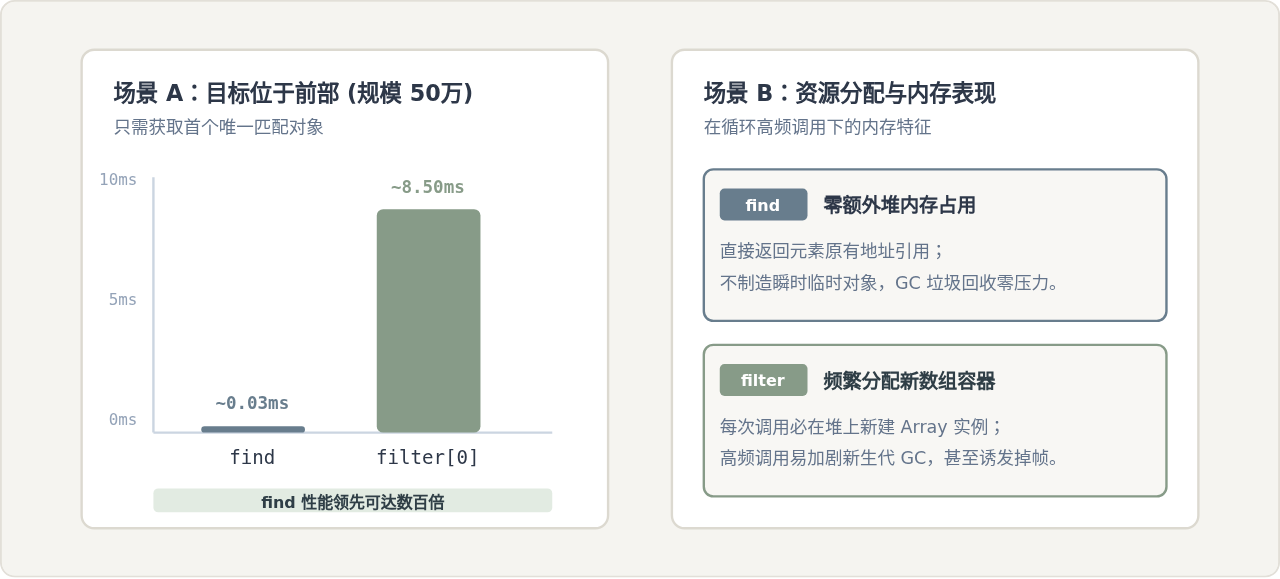
四、常见开发误区与防御式编码规范
明确了取值与性能边界后,在日常编写业务逻辑时还应遵守以下最佳防御实践:
1. 慎用 filter(...)[0] 代替 find(...)
部分开发者习惯书写 const item = list.filter(x => x.id === targetId)[0]。这种写法不仅浪费了全量遍历的时间,而且在没匹配到任何数据时,filter 会产生一个空数组 [],对其进行 [0] 索引取值依然会得到 undefined。这意味着写成 filter(...)[0] 在语义上既无法避免 undefined 的出现,在运行性能上还承受了最劣势的额外遍历和内存分配。应当始终规范使用 find 替代。
2. 安全消费 find 的返回值
由于 find 允许返回 undefined,直接对其读取属性容易触发经典错误:TypeError: Cannot read properties of undefined。现代 JavaScript 推荐使用可选链与空值合并:
// 存在隐患的写法
const activeUser = users.find(u => u.id === targetId);
const userName = activeUser.name; // 若未命中则直接抛出 Uncaught TypeError

// 推荐的防御式写法
const userNameSafe = users.find(u => u.id === targetId)?.name ?? '匿名用户';
3. 不要在测试回调函数内修改原始元素
不管是 find 还是 filter,传入的测试函数都应严格保持为纯函数(Pure Function)。不要在回调函数内部执行赋值修改(如 item.isProcessed = true),这种副作用会破坏不可变数据流,并在 find 发生短路时导致部分元素被修改、部分元素未被修改的数据不一致 Bug。
五、数组查找与筛选方法选型决策
为了在实际开发中快速选用最恰当的方法,可以参考下面的选型决策树:
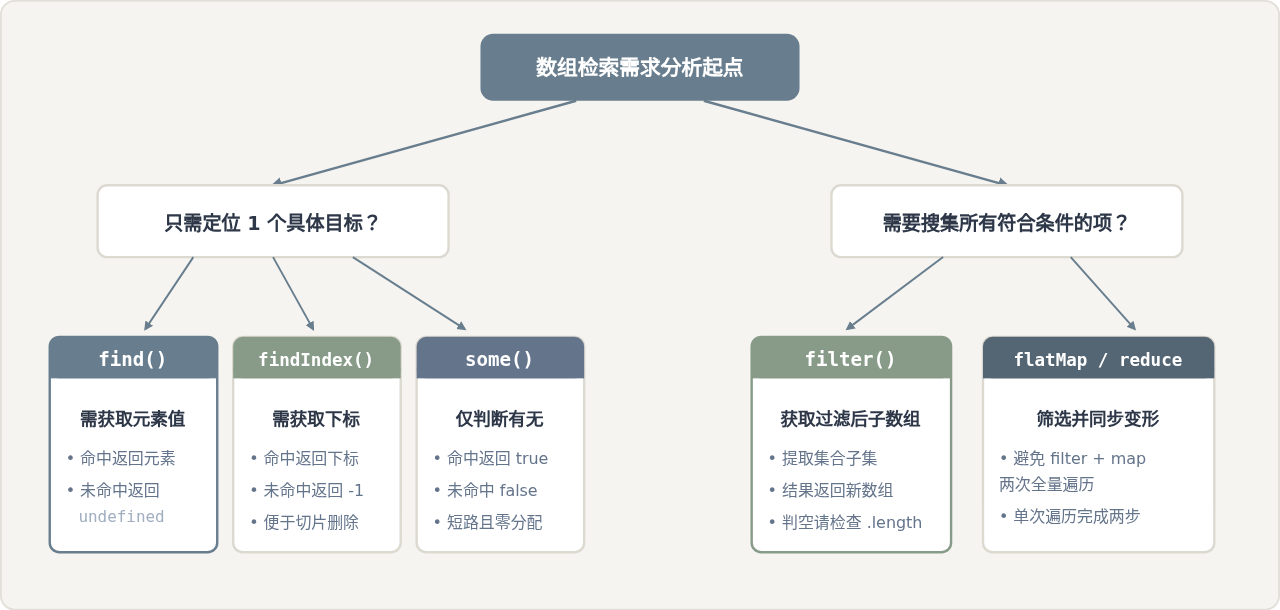
总结而言:
- 当业务目标是查找唯一实体(例如根据主键
id或唯一标识查询对象),或者只关心最先满足条件的那一项时,务必使用find,以享受 \(O(1)\sim O(K)\) 的短路早退与零内存开销优势。 - 当业务目标是获得多项数据集合(例如按分类拉取列表、剔除无效数据等),才应使用
filter,并记得通过result.length > 0或具体索引安全消费返回的新数组。
优化JS回到顶部性能:防抖节流与requestAnimationFrame应用
2026-11-05 16:33:51
JS中Array、Set与Map的区别及应用场景选择
2026-11-05 16:03:02
PixiJS 常见报错排查:纹理跨域、黑屏与内存泄漏解决
2026-11-05 10:05:21
通过添加时间戳参数强制刷新JS资源
2026-11-05 08:32:36
JavaScript 快速排序的迭代写法与非递归优化
2026-11-03 22:39:58