

JS数组批量添加数据:for循环与push的性能差异
深入解析JavaScript中批量添加数组数据的不同实现方式,详细对比for循环索引赋值、for循环push以及预分配容量在V8引擎下的性能差异、底层扩容原理与实际工程选型建议。
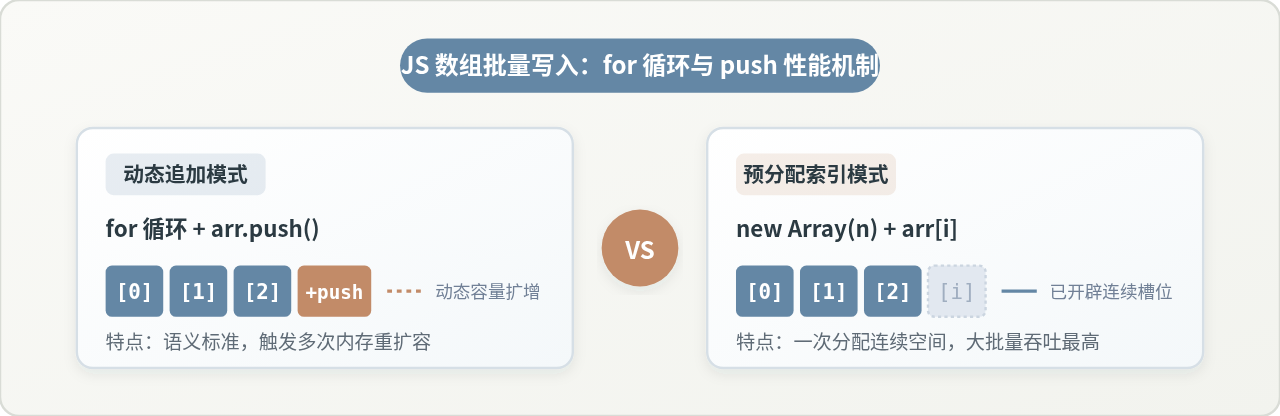
在 JavaScript 开发中,批量写入数组数据是高频的基础操作。常规观点常将讨论聚焦在“使用 for 循环下标赋值是否必然快过调用 arr.push()”上。核心结论是:在中小数据量(如数万项以内)场景下,现代 V8 引擎的即时编译(JIT)优化已将 push 内联为极高效的原语操作,二者的耗时差异通常在毫秒甚至微秒级,对业务完全无感;而在十万至百万级的极端大批量数据写入场景下,提前计算并设定长度的“预分配容量 + 索引赋值”模式能够彻底避免数组动态扩容与底层内存搬迁,性能显著优于动态 push。本文将从具体代码模式、底盘内存扩容机制、基准测试规范与工程选型四个维度展开详细分析。
一、常见的四种批量添加数据实现模式
在 JavaScript 中向数组批量灌入数据,开发者通常会采用以下四种代码编写模式。每种模式在语法简洁度、内存行为及调用栈特征上各有侧重:
模式 1:动态空数组 + for 循环 push()
这是前端与 Node.js 业务开发中最普遍的写法。初始化一个空数组,并在循环体内通过数组原生方法 push() 依次将元素压入尾部:
// 模式 1:动态空数组 + push
function insertWithPush(count) {
  const list = [];
  for (let i = 0; i < count; i++) {
    list.push(i);
  }
  return list;
}
这种写法语义清晰、容错率高,无需预先知道目标数据集的精确长度,是现代 JavaScript 引擎重点优化的热点路径。
模式 2:动态空数组 + for 循环索引赋值
同样以空数组起步,但在循环中不调用 push 方法,而是直接通过索引下标 list[i] 进行赋值:
// 模式 2:动态空数组 + 索引赋值
function insertWithIndexDynamic(count) {
  const list = [];
  for (let i = 0; i < count; i++) {
    list[i] = i;
  }
  return list;
}
由于 list 初始容量为 0,每次 list[i] = i 在超出当前物理缓冲区时,引擎同样需要动态修改数组的 length 属性并判断是否需要申请更多内存。
模式 3:预分配长度 + for 循环索引赋值
在初始化阶段通过 new Array(count) 明确告知引擎目标容量,随后自索引 0 开始严密紧凑地顺序赋值:
// 模式 3:预分配容量 + 顺序索引赋值
function insertWithPreAllocated(count) {
  const list = new Array(count);
  for (let i = 0; i < count; i++) {
    list[i] = i;
  }
  return list;
}
该模式为底层分配提供了明确的连续内存边界预期,也是针对大规模数据吞吐性能优化的核心手段。
模式 4:解构展开语法 push(...batch) 及其陷阱
在合并已有批量数组时,部分开发者习惯使用 ES6 展开语法 target.push(...source)。然而这种模式存在致命边界条件:
// 模式 4:展开运算符批量追加(存在调用栈溢出风险)
function batchPushSpread(target, source) {
  // 警告:当 source 数组长度超过 JS 引擎函数调用栈上限(通常约 6.5 万~12 万参数)时崩溃
  target.push(...source);
  return target;
}RangeError: Maximum call stack size exceeded,导致程序中断。因此大批量追加绝不可直接使用平铺语法。
二、底层机理:性能差异背后的三个核心原因
为了搞清楚为什么在大数据量下预分配索引赋值更快,而在常规小规模下与 push 差距不大,我们需要深入 V8 引擎的内部执行机制。
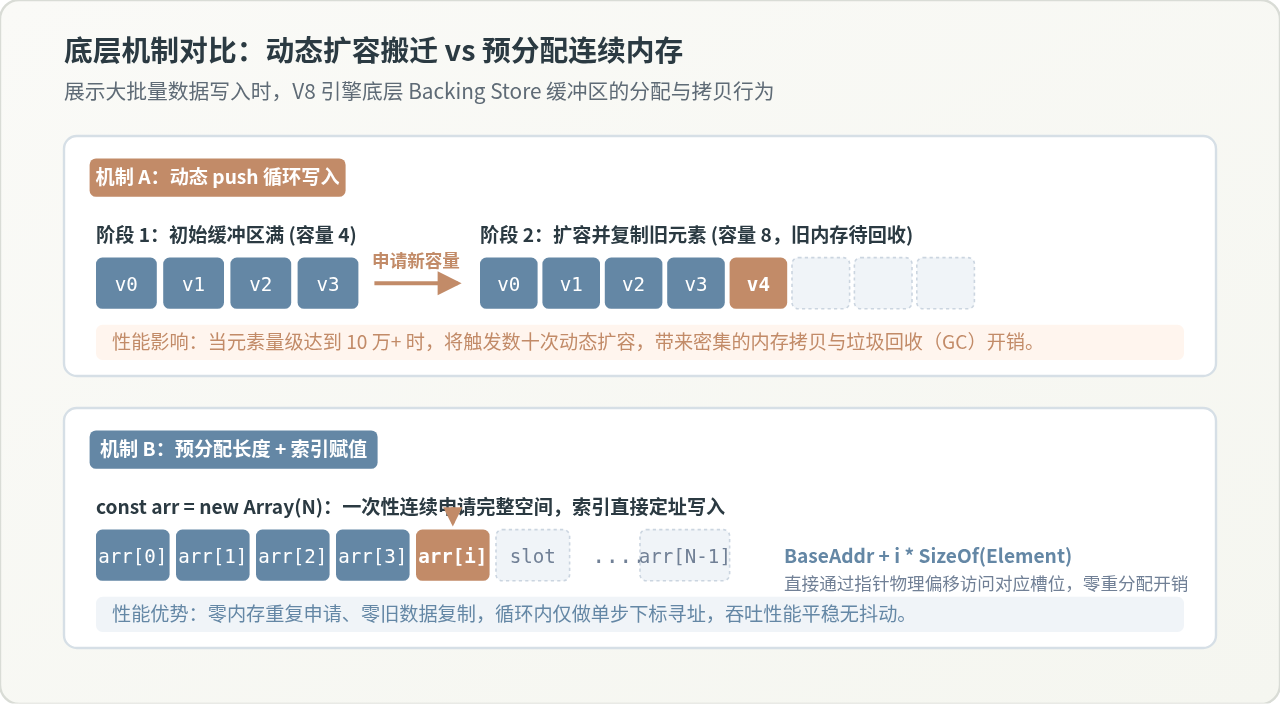
1. 动态扩容(Over-allocation & Copy)的内存开销
在 V8 引擎中,JavaScript 数组在底层由一个名为 ElementsAccessor 的结构和连续的物理缓冲区(Backing Store)支撑。当声明 const arr = [] 时,引擎并不会预先占用大块内存,初始容量通常很小。
当执行 arr.push() 导致当前容量饱和时,V8 会按照一定增长公式(大约为旧容量的 1.5 倍加上固定偏移量)申请一块全新的、更大的连续内存空间。随后,引擎必须将旧内存块中的所有已有元素指针逐一拷贝到新内存块中,并废弃旧块。如果写入 100 万条数据,动态追加模式会经历数十次“分配新内存 -> 全量内存拷贝 -> 触发旧内存 GC 回收”的完整周期。这一系列操作会产生明显的累积耗时。
而如果使用 new Array(count),V8 在初始化阶段便直接分配出满足对应大小的连续缓冲区。循环内部的 list[i] = val 仅是一次通过基础指针加上索引偏移(BaseAddr + i * PointerSize)的纯内存写入,全程无需发生二次扩容与拷贝。
2. 函数调用与内联缓存(Inline Caching)
过去的传统认知认为:push() 必然慢,因为每执行一次都需要触发一次 JavaScript 函数调用(Function Call Overhead),包括形参入栈、上下文切换和返回值处理。
然而在现代 JavaScript 引擎中,这一假设早已不再成立。V8 的 TurboFan 优化编译器具备强大的函数内联(Inlining)和内联缓存(Inline Cache, IC)能力。对于标准的密集型数组,Array.prototype.push 会在 JIT 编译后直接被内联替换为两到三条高效的原语机器指令:检查容量、写入目标槽位、递增 length。因此在中小规模数据循环中,单次 push 的指令周期开销与单次索引赋值已极其接近。
3. 数组元素形态(Elements Kinds)与空洞陷阱
V8 对数组进行了非常细致的类型状态跟踪。数组的形态演变是单向不可逆的,这对实际性能产生深远影响。
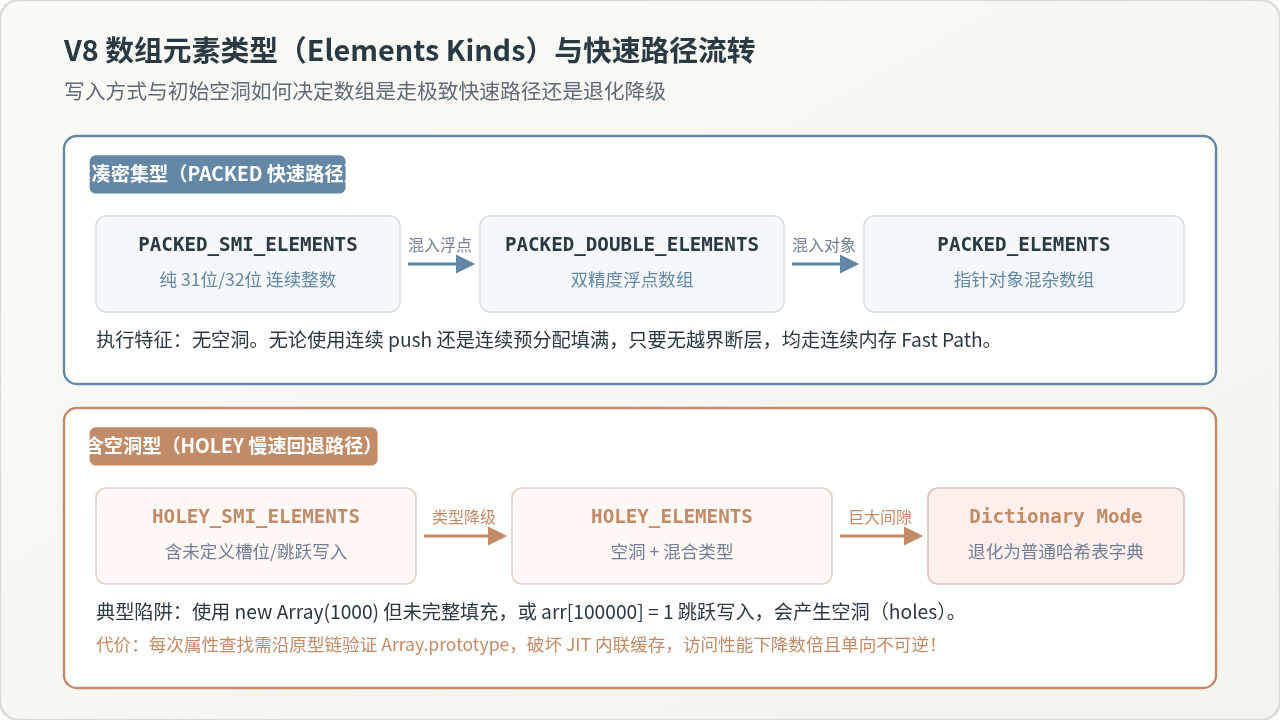
当数组元素紧密排列且全为整数时,数组处于最优的 PACKED_SMI_ELEMENTS 状态,访问走最快的纯内存偏移读取(Fast Path)。如果混入浮点数或普通对象,则会平滑降级为 PACKED_DOUBLE_ELEMENTS 或 PACKED_ELEMENTS。
关键的隐患在于“空洞”(Holes)。如果使用 const arr = new Array(1000) 但在后续操作中未将其完整填满,或者不慎使用了跳跃式索引写入(例如在长度为 5 的数组上执行 arr[100] = 1),数组就会退化为含空洞的 HOLEY_* 状态。此时引擎无法保证某个下标一定有值,每次访问都必须额外检查 hasOwnProperty 乃至沿着原型链(Prototype Chain)进行回溯查找,导致访问速度下降数倍。极端情况下,超大跨度的稀疏数组甚至会退化为哈希表字典模式(Dictionary Mode)。
三、科学的基准测试步骤与测量示例
性能对比不能仅凭经验推测,必须建立在排除了宿主环境噪点、消除 JIT 冷启动偏差的标准化基准测试之上。
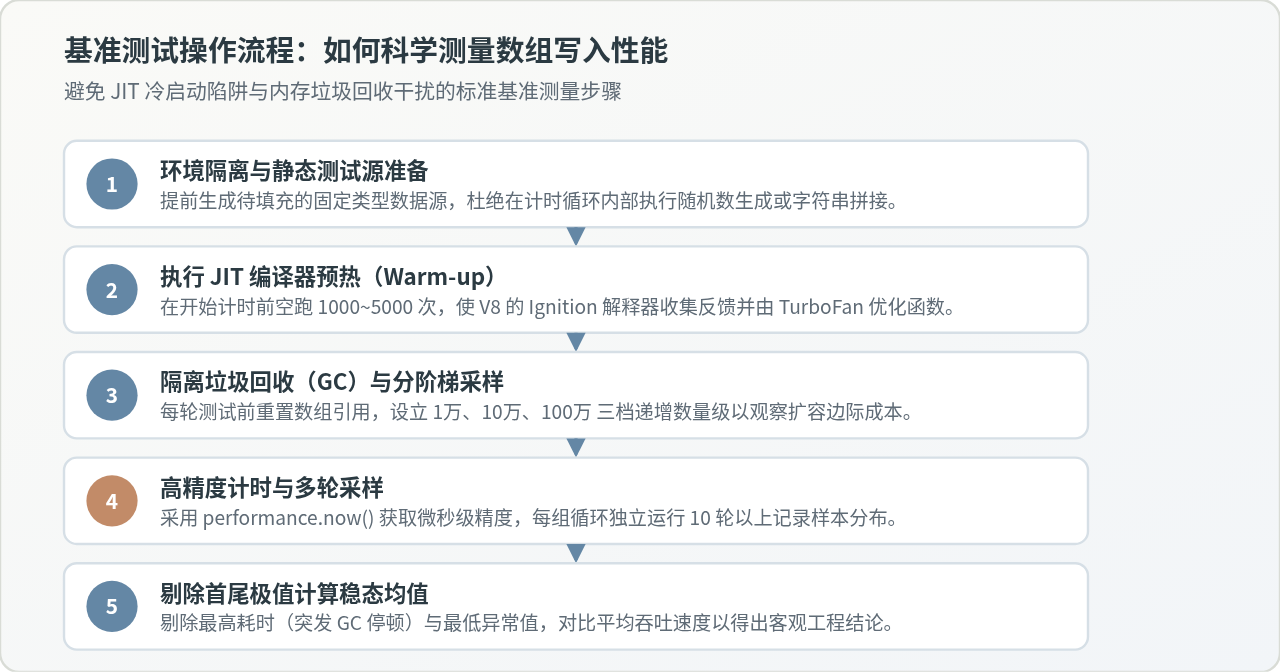
基准测试实施代码
以下代码演示了如何在 Node.js 或浏览器控制台中构建一个严谨的测试用例。测试代码包含预热环节并采用微秒级精度的 performance.now():
// 科学基准测试脚本
const { performance } = require('perf_hooks');

function benchPush(count) {
  const arr = [];
  for (let i = 0; i < count; i++) {
    arr.push(i);
  }
  return arr.length;
}

function benchIndexDynamic(count) {
  const arr = [];
  for (let i = 0; i < count; i++) {
    arr[i] = i;
  }
  return arr.length;
}

function benchIndexPreAlloc(count) {
  const arr = new Array(count);
  for (let i = 0; i < count; i++) {
    arr[i] = i;
  }
  return arr.length;
}

function runBenchmark(count, iterations = 10) {
  // 1. 预热 JIT 编译器
  for (let w = 0; w < 5; w++) {
    benchPush(1000);
    benchIndexDynamic(1000);
    benchIndexPreAlloc(1000);
  }

  // 2. 批量采样并求均值
  function testFn(fn) {
    let total = 0;
    for (let i = 0; i < iterations; i++) {
      const start = performance.now();
      fn(count);
      const end = performance.now();
      total += (end - start);
    }
    return (total / iterations).toFixed(2);
  }

  console.log(`--- 数据规模:${count.toLocaleString()} 项(运行 ${iterations} 轮均值)---`);
  console.log(`1. 动态 push:           ${testFn(benchPush)} ms`);
  console.log(`2. 动态索引直接赋值:    ${testFn(benchIndexDynamic)} ms`);
  console.log(`3. 预分配长度 + 索引:   ${testFn(benchIndexPreAlloc)} ms`);
}

// 分别测试 1万、10万、100万 三个阶梯
runBenchmark(10000);
runBenchmark(100000);
runBenchmark(1000000);
测试结果示例与趋势分析
在典型现代硬件环境(如 64 位 V8 引擎环境)下执行上述测试脚本,输出的耗时对比如下表所示(注意:此为基准测试环境下的典型示例输出,具体毫秒数值会随不同机器 CPU 频率与内存带宽浮动,但相对趋势完全一致):
| 数据规模(项数) | 动态 push (ms) | 动态索引赋值 (ms) | 预分配长度 + 索引赋值 (ms) | 性能相对表现 |
|---|---|---|---|---|
| 10,000(一万) | ~ 0.18 ms | ~ 0.19 ms | ~ 0.12 ms | 绝对差距仅 0.06ms,业务层面无感知 |
| 100,000(十万) | ~ 2.80 ms | ~ 2.95 ms | ~ 1.40 ms | 预分配节省约 50% 耗时,扩容代价显现 |
| 1,000,000(百万) | ~ 31.50 ms | ~ 33.20 ms | ~ 13.80 ms | 预分配优势显著,执行效率提升 2.3 倍 |
从测量数据中可以得出明确趋势:
- 动态 push 与动态索引赋值性能几乎重合:在未预设长度的情况下,直接通过下标
arr[i] = val并不能带来性能提升,甚至在某些引擎分支上因为反复修改length属性而略慢于高度内联优化的push()。 - 规模越大,预分配收益越陡峭:当数据量突破十万级,内存扩容的重分配与拷贝成本开始占据总耗时的主导地位。预分配避免了这部分无谓消耗,呈现出线性的平稳吞吐。
四、工程实践中的选型决策与优化指南
在实际项目开发中,选择何种批量添加方式不能单一依据“理论极限速度”,而应当兼顾代码可读性、维护成本与业务数据特征。
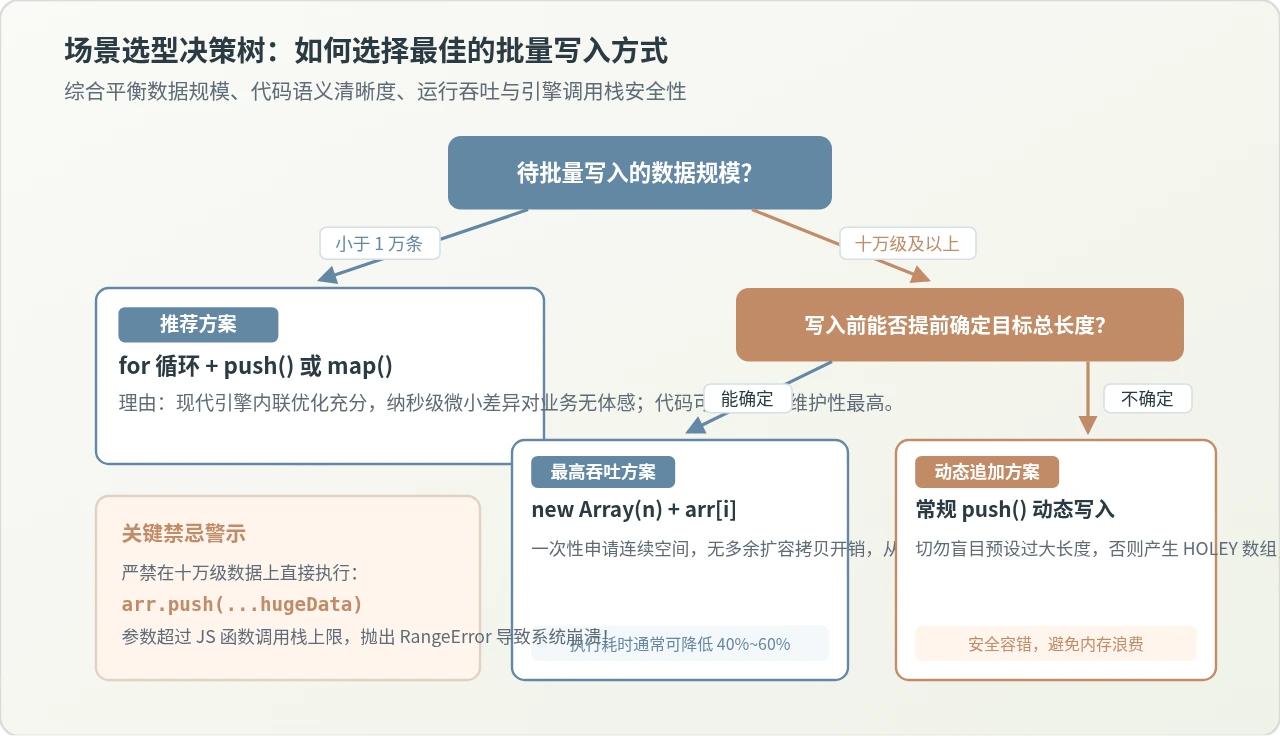
推荐的工程选型策略
-
常规业务数据(元素 < 10,000 项):
坚决优先使用
for循环 +push(),或者函数式风格的map()/filter()。现代引擎对小数组的微秒级差异并不影响用户交互体验,直观清晰的代码结构具有更高的维护价值。 -
海量计算与数据密集型场景(元素 > 50,000 项):
例如三维图形顶点计算、音视频波形处理、大规模日志分析或数据流转换。此时只要最终容量可知,应当果断采用
const arr = new Array(len)并使用for循环紧密顺序索引赋值。 -
两个已有数组的批量合并:
避免使用
target.push(...source),推荐根据规模选用target.concat(source);若要求必须在原数组上修改且数据过大,可采用分块追加(Chunking)算法分段推入。
// 错误用法:预设长度后依然调用 push
const arr = new Array(100);
for (let i = 0; i < 100; i++) {
  arr.push(i); // 致命错误!
}
console.log(arr.length); // 输出 200!前 100 项全为 empty slots
new Array(n) 已经将 length 设置为 n。在此基础上再调用 push,会在原有 n 个空槽位之后继续追加,导致数组长度翻倍且前半段完全为空洞,彻底破坏数组性能。
五、核心结论总结
回答标题提出的核心问题:for 循环与 push 之间的性能差异,核心不在于循环语句语法或 push 方法本身,而在于数组背后的内存分配机制(动态扩容 vs 预分配连续空间)。
在编写日常 JavaScript 代码时,不需要因为“传言 push 慢”而将正常的 push() 刻意重写为动态索引赋值。只有在明确面对数十万级以上的大规模数据清洗、图像像素阵列或复杂算法模拟时,运用“预分配确定容量 + 紧密顺序索引赋值”才能真正发挥出 V8 引擎极致的高性能吞吐潜力。
JS 鼠标滚轮事件频繁触发导致卡顿怎么优化?
2026-11-05 17:08:07
优化JS回到顶部性能:防抖节流与requestAnimationFrame应用
2026-11-05 16:33:51
JS中Array、Set与Map的区别及应用场景选择
2026-11-05 16:03:02
PixiJS 常见报错排查:纹理跨域、黑屏与内存泄漏解决
2026-11-05 10:05:21
JS数组find与filter取值区别及性能对比
2026-11-05 08:39:21
相关标签:







