兼容IE浏览器的JS地址栏参数解析代码
针对缺少URLSearchParams原生接口的IE8至IE11等老旧浏览器环境,提供完整实用的纯JavaScript地址栏URL参数解析代码。包含单参数正则提取、全量参数对象转换及复杂边界异常防护。
在不支持 URLSearchParams 接口的 Internet Explorer(如 IE8、IE9、IE10、IE11)及部分老旧内核 Webview 中,直接调用现代浏览器 API 会抛出脚本未定义错误。实现全兼容的核心方案是直接获取地址栏原始字符串(window.location.search 或 window.location.href),通过原生字符串检索与分割,结合 decodeURIComponent 对键值逐项解码。本文提供经过严格测试的纯 JavaScript 实现代码,包含单参数精准提取与全量参数对象解析两种模式,并给出针对中文乱码、Hash 锚点干扰以及重复参数等实际问题的防御方案。
为什么现代参数解析方法在 IE 中会失效
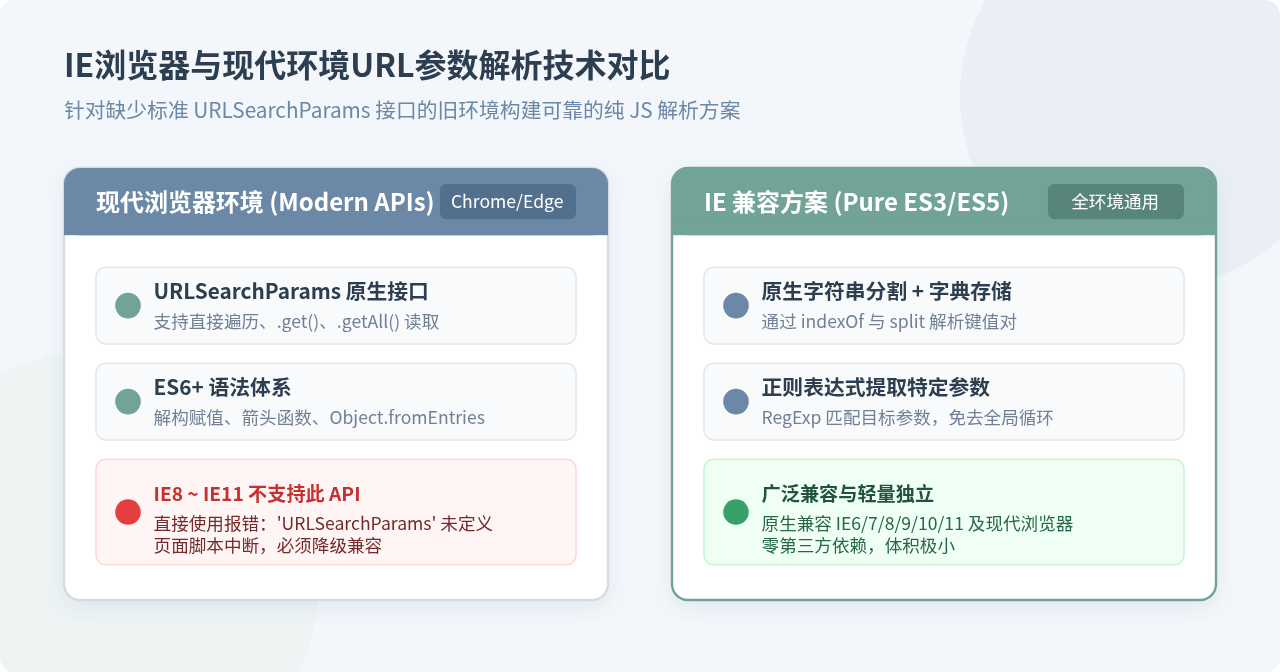
现代前端开发中获取参数通常使用 new URL(window.location.href).searchParams.get('key') 或 new URLSearchParams(window.location.search)。然而,W3C 的 URL 标准是在较晚时期才被主流浏览器实现的,微软在 IE 整个生命周期(包括最终版本 IE11)中均未加入 URLSearchParams 原生支持。
如果在 IE 中直接执行此类现代代码,页面会立即触发以下致命错误:
若使用 Babel 转译,由于该接口属于全局 BOM/DOM API 而非标准 ES 语言语法,普通的语法降级插件并不会自动为其注入 Polyfill,直接调用依然报错。
为了让脚本在从 IE6 到当前最新版本的任何浏览器中均能平稳工作,必须采用纯 ECMAScript 3/5 原生字符串处理机制,不依赖任何外部库和高版本全局构造函数。
方案一:正则表达式快速提取指定参数(最轻量)
当页面只需要获取某一个关键参数(例如根据 id 或 token 进行数据初始化)时,遍历所有参数会产生不必要的对象分配。此时使用正则表达式提取是性能最高、代码量最少的做法。
1. 核心代码实现
/**
 * 获取URL中指定参数的值(兼容IE6+及所有现代浏览器)
 * @param {string} name 需要提取的参数名称
 * @param {string} [url] 可选的目标URL,默认取当前页面地址
 * @return {string|null} 返回解码后的参数值,不存在时返回 null
 */
function getQueryString(name, url) {
    if (!name) {
        return null;
    }
    // 未传 url 时,默认使用 location.search;若无 search 则取 href 中的查询部分
    var searchStr = "";
    if (typeof url === "string") {
        var qIdx = url.indexOf("?");
        searchStr = (qIdx !== -1) ? url.substring(qIdx) : url;
    } else if (typeof window !== "undefined" && window.location) {
        searchStr = window.location.search || "";
        // 兼容部分单页应用的 Hash 路由格式(例如 /#/page?id=1)
        if (!searchStr && window.location.hash) {
            var hashQIdx = window.location.hash.indexOf("?");
            if (hashQIdx !== -1) {
                searchStr = window.location.hash.substring(hashQIdx);
            }
        }
    }

    // 剔除开头的 ? 与末尾可能连带的 # 锚点
    searchStr = searchStr.replace(/^\?/, "").split("#")[0];
    if (!searchStr) {
        return null;
    }

    // 构造严格匹配的正则表达式:前后必须是 & 或字符串边界,防止搜索 'id' 误匹配 'userid'
    var reg = new RegExp("(^|&)" + name + "=([^&]*)(&|$)", "i");
    var match = searchStr.match(reg);

    if (match !== null) {
        var rawVal = match[2];
        // URL 规范中加号 '+' 常常表示空格,需先转换为空格再解码
        rawVal = rawVal.replace(/\+/g, " ");
        try {
            return decodeURIComponent(rawVal);
        } catch (e) {
            // 降级防止非法 % 编码导致脚本中断
            return unescape(rawVal);
        }
    }
    return null;
}
2. 执行示例与结果
// 假定当前地址栏为:http://example.com/index.html?userId=9527&userName=%E5%BC%A0%E4%B8%89&from=search
var id = getQueryString("userId");
var name = getQueryString("userName");
var channel = getQueryString("from");
var nonExist = getQueryString("page");

console.log(id);       // 输出:"9527"
console.log(name);     // 输出:"张三"(正常解析中文字符)
console.log(channel);  // 输出:"search"
console.log(nonExist); // 输出:null
方案二:全量参数解析为普通 JavaScript 对象(通用方案)
当页面需要统一接收多个参数,或者需要将地址栏状态序列化存储时,将所有参数解析为一个结构化的普通对象(Object)更为方便。
1. 核心代码实现
/**
 * 将URL中的全部查询参数解析为 JavaScript 键值对对象(兼容IE6+)
 * @param {string} [url] 可选的目标URL,默认取当前页面地址
 * @return {Object} 返回包含所有参数的对象
 */
function parseQueryParams(url) {
    var result = {};
    var searchStr = "";

    // 步骤一:规范化获取查询字符串
    if (typeof url === "string") {
        var qIndex = url.indexOf("?");
        searchStr = (qIndex !== -1) ? url.substring(qIndex + 1) : url;
    } else if (typeof window !== "undefined" && window.location) {
        searchStr = window.location.search ? window.location.search.substring(1) : "";
        if (!searchStr && window.location.hash) {
            var hashIndex = window.location.hash.indexOf("?");
            if (hashIndex !== -1) {
                searchStr = window.location.hash.substring(hashIndex + 1);
            }
        }
    }

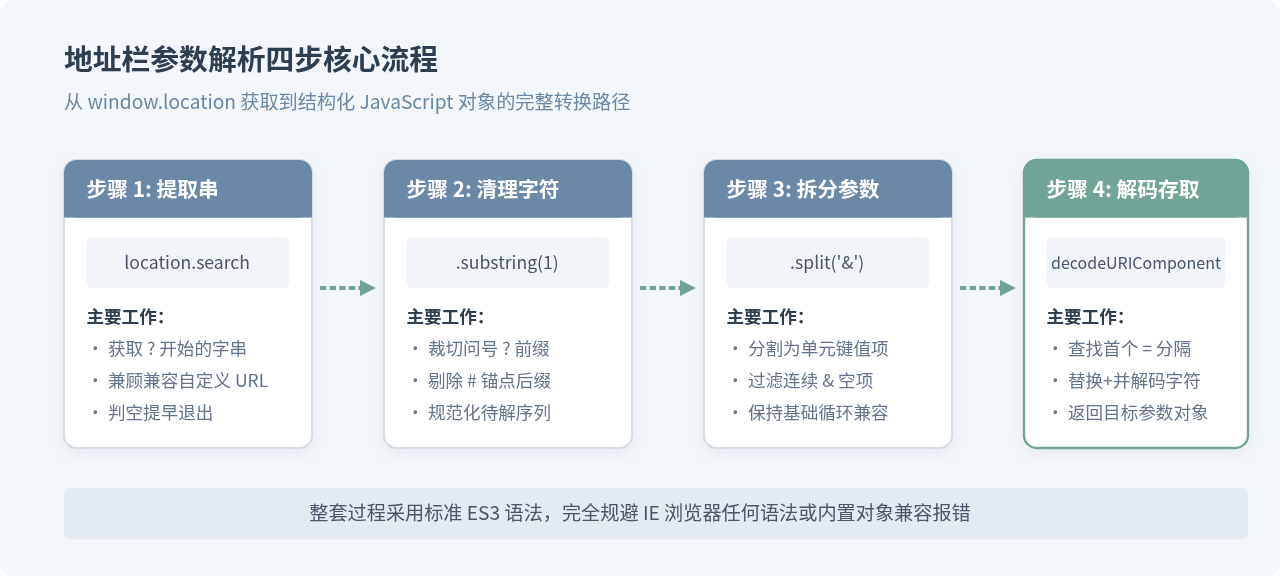
    // 步骤二:清理首尾杂质,截除锚点
    if (!searchStr) {
        return result;
    }
    searchStr = searchStr.replace(/^\?/, "").split("#")[0];

    // 步骤三:按 & 拆分为参数对数组
    var pairs = searchStr.split("&");

    // 辅助函数:安全解码
    function safeDecode(val) {
        var str = String(val).replace(/\+/g, " ");
        try {
            return decodeURIComponent(str);
        } catch (err) {
            return unescape(str);
        }
    }

    // 步骤四:遍历每一对参数并完成键值解析
    for (var i = 0; i < pairs.length; i++) {
        var item = pairs[i];
        if (!item) {
            continue; // 忽略连续 && 产生的空项
        }

        // 切勿直接使用 item.split('='),因为 value 内部可能包含 base64 或 token 用的 '='
        var eqIdx = item.indexOf("=");
        var key = "";
        var value = "";

        if (eqIdx === -1) {
            // 存在只有 key 没有 value 的标志位(如 ?debug&preview)
            key = safeDecode(item);
            value = "";
        } else {
            key = safeDecode(item.substring(0, eqIdx));
            value = safeDecode(item.substring(eqIdx + 1));
        }

        // 解决同名参数覆盖问题:已存在则自动转为数组存储
        if (result.hasOwnProperty(key)) {
            if (Object.prototype.toString.call(result[key]) === "[object Array]") {
                result[key].push(value);
            } else {
                result[key] = [result[key], value];
            }
        } else {
            result[key] = value;
        }
    }

    return result;
}
2. 执行示例与结果
// 针对复杂场景进行解析测试
var testUrl = "http://example.com/api?tag=html&tag=css&token=YWJjPWVuZA==&debug&city=%E5%8C%97%E4%BA%AC#main";
var params = parseQueryParams(testUrl);

console.log(params.tag);   // 输出:["html", "css"](同名参数自动合并为数组)
console.log(params.token); // 输出:"YWJjPWVuZA=="(末尾等号完整保留,未被截断)
console.log(params.debug); // 输出:""(独立无值参数正常保留为键)
console.log(params.city);  // 输出:"北京"(中文正常转码)
生产环境必防的四大特殊边界
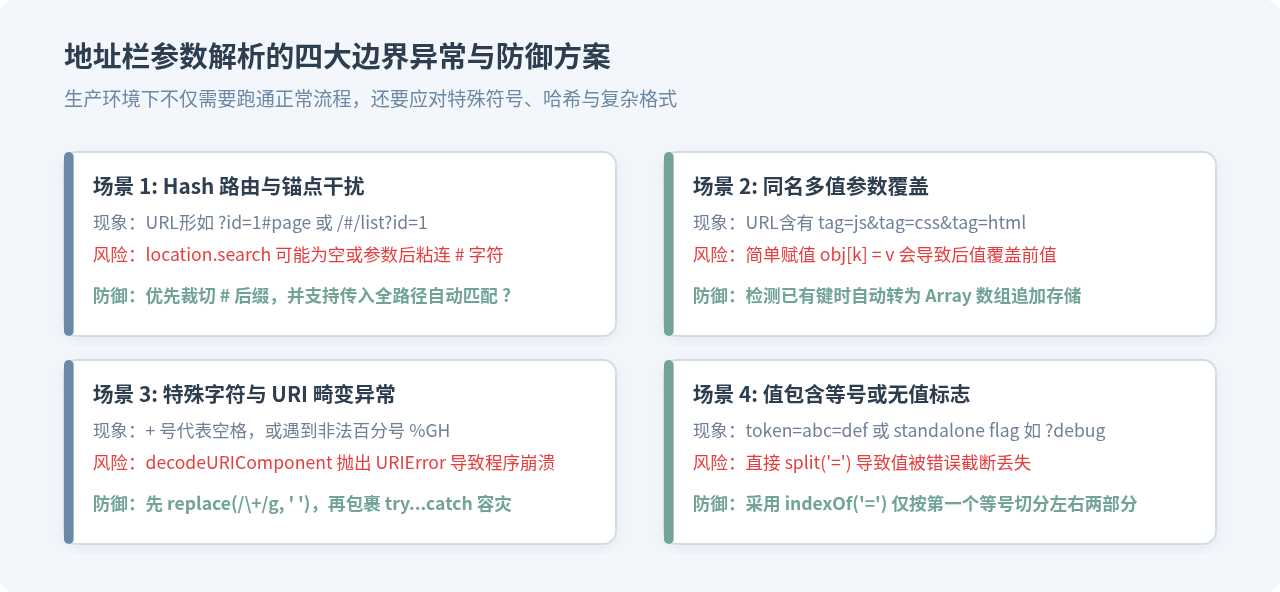
很多简单的示例代码在演示环境中能够工作,但在复杂项目中往往遇到各种隐蔽 Bug。以下列出在编写 IE 兼容参数解析时必须处理的四大边界场景:
1. Hash 路由带来的问号位置错乱
在前后端分离架构或单页应用(SPA)中,若采用 Hash 路由,地址往往长成这样:http://domain/#/detail?id=123。在此结构下:
- 浏览器的
window.location.search实际输出为空字符串; - 参数全部跟随在
window.location.hash的后面。
因此,代码必须具备自动回退机制:当 location.search 取不到值时,主动检查 location.hash 是否包含 ?,确保在 Hash 模式下依然能正确取到参数。
2. 参数值内部包含“=”符号
常见的新手实现会直接使用 item.split('=') 将每一段拆成两截。如果某个参数是 Base64 编码的签名串或加密密文(如 token=MTIzNDU2==),直接调用 split('=') 会将字符串分割为 ["token", "MTIzNDU2", "", ""],导致后半截等号被直接丢弃,解密失败。通过 item.indexOf('=') 仅定位首个等号并采用 substring 提取,能够保证参数值的原始完整性。
3. 中文编码与异常字符(URIError)容错
早期 IE 开发者常用 unescape(),但该函数早已被规范废弃,且无法支持 UTF-8 编码的汉字。标准方法应使用 decodeURIComponent()。但需要注意:如果地址栏中包含了不规范的百分号序列(例如用户手动输入或恶意拼装的 ?keyword=100%OFF),decodeURIComponent() 会直接抛出全局异常 URIError: URI malformed。必须使用 try...catch 将解码逻辑包裹起来,在捕获错误时平稳降级,避免整站脚本瘫痪。
4. 空格在 URL 中的加号“+”表达形式
根据 application/x-www-form-urlencoded 标准,表单提交时空格会被编码为加号 +。原生 decodeURIComponent() 并不会自动将 + 还原为空格,而是保留 +。因此在调用解码之前,需要先调用 .replace(/\+/g, " ") 进行规范化处理。
开箱即用的 IE 兼容参数工具封装
为了在工程项目中便于团队统一调用,我们可以将上述方法整合为一个轻量、独立的全局工具对象 UrlParams,无缝兼容 IE6-IE11 及现代所有浏览器:
/**
 * UrlParams: 兼容IE6~IE11及现代浏览器的轻量URL参数工具集
 */
var UrlParams = (function () {
    function cleanUrl(url) {
        var str = "";
        if (typeof url === "string") {
            var qIdx = url.indexOf("?");
            str = (qIdx !== -1) ? url.substring(qIdx + 1) : url;
        } else if (typeof window !== "undefined" && window.location) {
            str = window.location.search ? window.location.search.substring(1) : "";
            if (!str && window.location.hash) {
                var hIdx = window.location.hash.indexOf("?");
                if (hIdx !== -1) {
                    str = window.location.hash.substring(hIdx + 1);
                }
            }
        }
        return str ? str.replace(/^\?/, "").split("#")[0] : "";
    }

    function decode(val) {
        var s = String(val).replace(/\+/g, " ");
        try {
            return decodeURIComponent(s);
        } catch (e) {
            return unescape(s);
        }
    }

    return {
        // 获取单个参数
        get: function (name, url) {
            if (!name) return null;
            var raw = cleanUrl(url);
            if (!raw) return null;
            var reg = new RegExp("(^|&)" + name + "=([^&]*)(&|$)", "i");
            var m = raw.match(reg);
            return m !== null ? decode(m[2]) : null;
        },

        // 获取所有参数为对象
        getAll: function (url) {
            var res = {};
            var raw = cleanUrl(url);
            if (!raw) return res;
            var parts = raw.split("&");
            for (var i = 0; i < parts.length; i++) {
                var pair = parts[i];
                if (!pair) continue;
                var eq = pair.indexOf("=");
                var k = "", v = "";
                if (eq === -1) {
                    k = decode(pair);
                    v = "";
                } else {
                    k = decode(pair.substring(0, eq));
                    v = decode(pair.substring(eq + 1));
                }
                if (res.hasOwnProperty(k)) {
                    if (Object.prototype.toString.call(res[k]) === "[object Array]") {
                        res[k].push(v);
                    } else {
                        res[k] = [res[k], v];
                    }
                } else {
                    res[k] = v;
                }
            }
            return res;
        }
    };
})();
总结与运行环境支持矩阵
在政企系统、金融内网、工控前置机及部分定制浏览器终端中,IE 兼容性依然是系统稳定运行的底线。使用本文提供的解析代码,无需引入重型 Polyfill,即可保证老旧环境与现代浏览器的无缝对接。
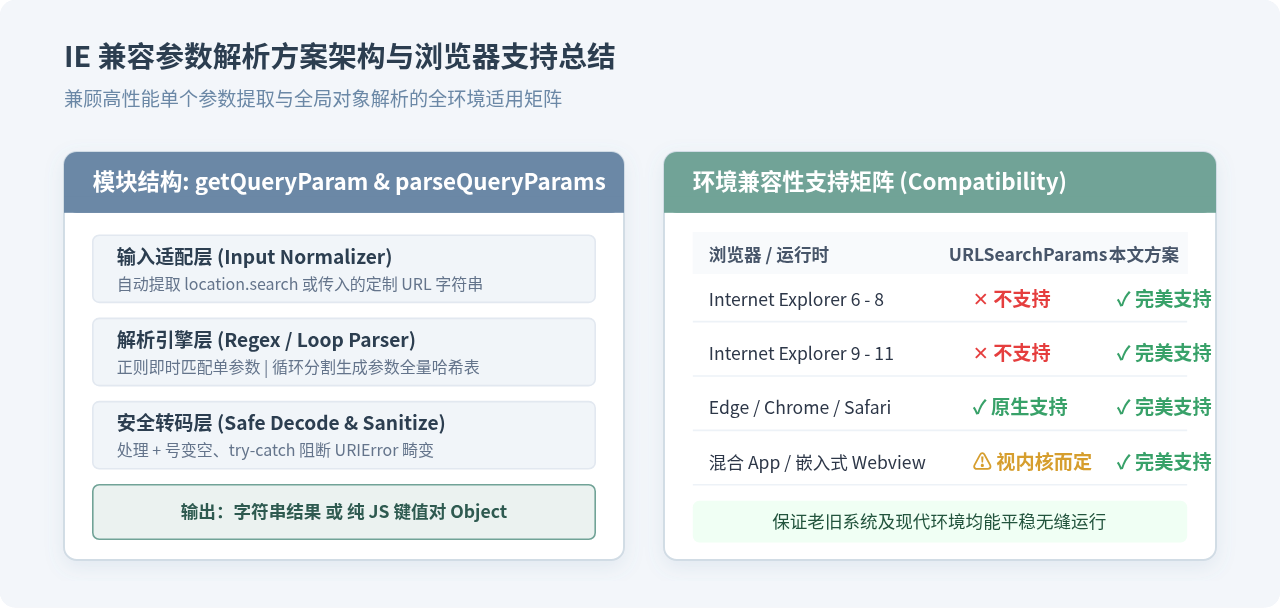
- 若页面仅需按需读取 1~2 个固定参数(如
pageIndex、id),优先调用UrlParams.get(name),执行速度最快; - 若需要收集所有查询信息传递给后端接口,建议在页面初始化时调用一次
UrlParams.getAll()缓存在全局变量中,避免高频重复解析。
JS在setTimeout或Ajax回调中打开新标签页失败怎么处理
2026-11-05 15:50:12
JS直播协议选型:HLS、FLV与WebRTC的延迟与兼容性对比
2026-11-05 12:16:14
JS实现回到顶部:scrollTop赋值与浏览器兼容性处理
2026-11-04 23:43:35
JS使用classList动态添加、移除和切换CSS类名
2026-11-04 23:40:58
在 D3.js 中实现平滑过渡动画的技巧
2026-11-03 23:46:09