

解决JavaScript读写文件时的中文乱码与编码问题
深入浅出讲解在Node.js和浏览器环境中解决JavaScript读写文件时中文乱码的根源与实战解决方案,涵盖UTF-8、GBK编码转换、TextDecoder与iconv-lite的具体使用步骤与避坑指南。
在 JavaScript 开发中,读写本地文本或导出文件时频繁遭遇中文乱码,例如汉字变为“锟斤拷”、“浣犲ソ”或连续的黑色问号“”。这一问题的根本症结并不在于底层数据损坏,而是读取或写入文件时采用的字符编码规则与文件物理存储的二进制字节流不匹配。JavaScript 运行时内部一律采用 Unicode(UTF-16)表示字符串,只要在 I/O 边界掌握正确的二进制解码与编码转换机制,就能彻底杜绝各类中文字符乱码现象。
一、中文乱码的本质与编码失配原理
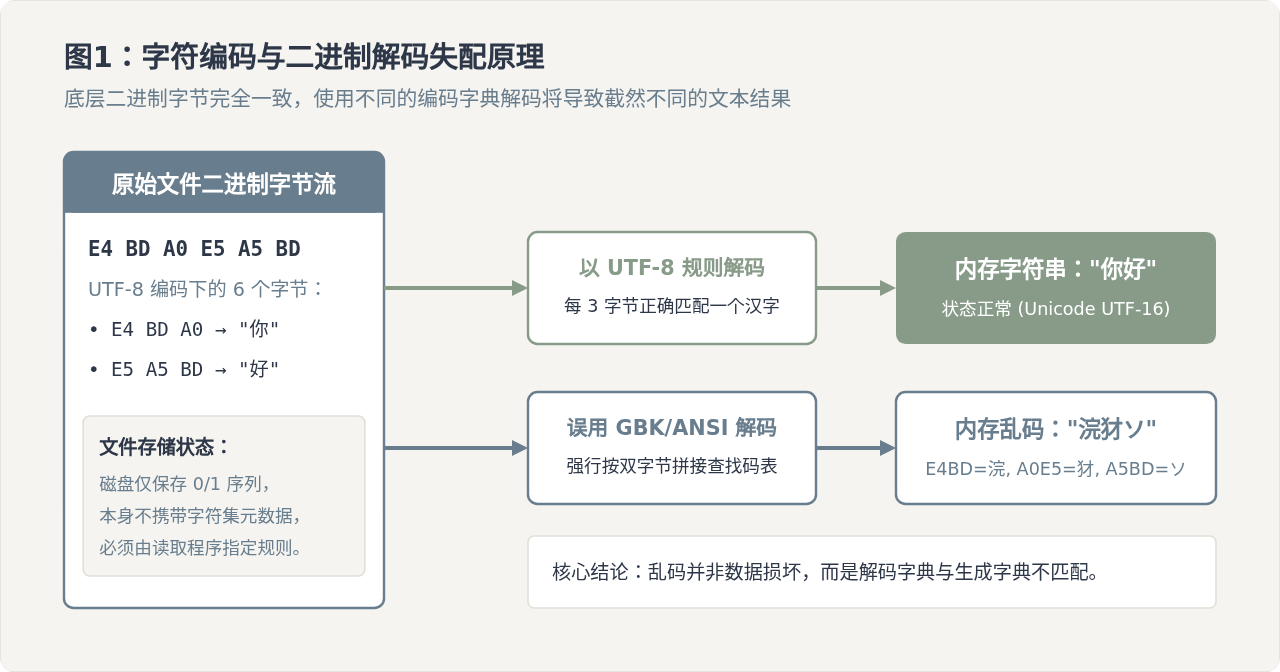
磁盘上的任何文件本质上都只是一串连续的二进制字节(Bytes)。当计算机需要将这串字节呈现为可读的文字时,必须借助一张“编码映射表”。对于英文字符,标准的 ASCII 编码使用单字节(0-127)就能满足要求;但对于包含数万个汉字的中文,单字节无法表示,因而演化出了多种汉字编码规范:
- UTF-8:现代互联网通用的变长编码,单个常用汉字通常占用 3 个字节(例如“你”对应
E4 BD A0,“好”对应E5 A5 BD)。 - GBK / GB2312:我国早期的双字节汉字编码标准,每个汉字固定占用 2 个字节。在许多 Windows 平台历史软件、老旧办公系统以及简体中文版 Excel 导出的 CSV 文件中依然广泛存在。
- ANSI:Windows 系统在不同语言区域环境下的本地默认编码,在中文简体 Windows 下通常指代 GBK。
当一个原本使用 UTF-8 编码保存的文件(每个汉字 3 字节),被程序强制当作 GBK(每个汉字 2 字节)去解码时,程序就会两两合并字节并在 GBK 码表中查找对应字符,最终呈现出“浣犲ソ”这样的荒谬文字。反过来,如果 GBK 编码的双字节序列被作为 UTF-8 解码,由于不符合 UTF-8 严格的多字节引导规范,解码器会将非法序列判定为无法识别,替换为 Unicode 替代字符 U+FFFD(即 )。当这些替代字符再次被错误转码时,便会产生臭名昭著的“锟斤拷”。
二、Node.js 服务端读写中文文件的标准步骤
Node.js 原生提供的 fs 模块默认只支持 utf8、ascii、base64、hex 等几种编码,原生不支持 GBK 或 GB2312。如果在 Node.js 中使用 fs.readFileSync(path, 'utf8') 去读取 GBK 编码的文件,Node.js 会强行用 UTF-8 解析双字节,导致返回包含大量替代字符的损坏字符串。
处理这类文件的正确操作步骤是:首先读取文件的纯二进制 Buffer,再根据目标文件的真实编码,借助专业的编码处理库(如工业级广泛使用的 iconv-lite)或原生 TextDecoder 将其解码为纯文本。
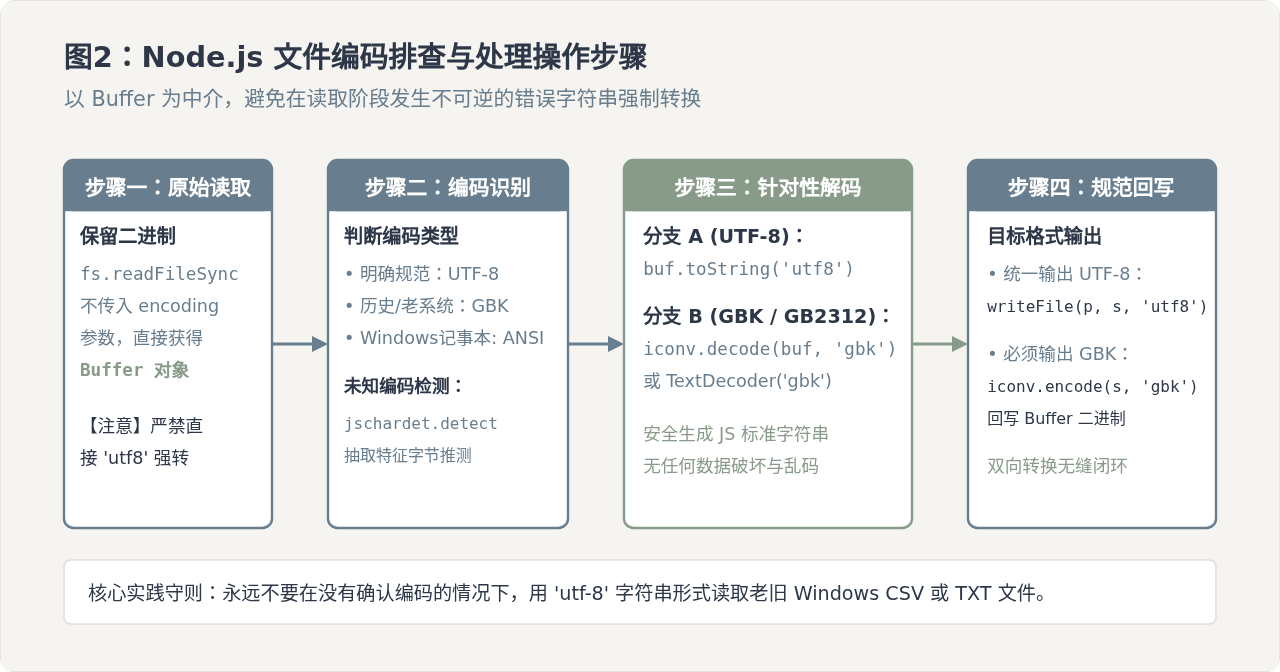
1. 使用 iconv-lite 完成 GBK 文件的读写示例
在项目中执行 npm install iconv-lite 安装支持库,随后编写如下完整脚本:
const fs = require('fs');
const iconv = require('iconv-lite');

// 1. 读取 GBK / ANSI 文件:不传任何编码参数,得到纯二进制 Buffer
const gbkBuffer = fs.readFileSync('legacy_data.csv');

// 2. 将二进制 Buffer 按 GBK 字典解码为正确的 JavaScript 字符串
const decodedText = iconv.decode(gbkBuffer, 'gbk');
console.log('解码后的中文文本:', decodedText);

// 3. 业务处理完毕后,如果需要写回 GBK 文件(供老旧软件读取):
const outputGbkBuffer = iconv.encode(decodedText + '\n新增一行数据', 'gbk');
fs.writeFileSync('output_gbk.csv', outputGbkBuffer);

// 4. 如果推荐转换为现代通用的 UTF-8 文件保存:
fs.writeFileSync('converted_utf8.csv', decodedText, 'utf8');
2. 原生利用 TextDecoder 解码非 UTF-8 数据
在 Node.js 12+ 之后,Node.js 已经内置了 Web 标准的 util.TextDecoder,该 API 支持绝大多数常见字符集(包括 GBK、GB18030、Big5 等)。如果不想引入第三方依赖,可以直接使用原生方案:
const fs = require('fs');

// 读取原始二进制字节
const buffer = fs.readFileSync('chinese_gbk.txt');

// 实例化 GBK 解码器
const decoder = new TextDecoder('gbk');
const text = decoder.decode(buffer);

console.log('TextDecoder 成功解析:', text);TextDecoder 原生支持解码 GBK,但原生 TextEncoder 目前仅支持 utf-8。因此如果要在 Node.js 中写出 GBK 编码的文件,仍然必须使用 iconv-lite。
三、浏览器端文件读写与导出防乱码
在浏览器端,中文乱码最常出现在两个典型场景:用户通过 <input type="file"> 上传老旧格式文本时的解析,以及前端使用 JavaScript 动态生成 CSV 文件供用户下载时,使用 Excel 打开全部变成乱码。
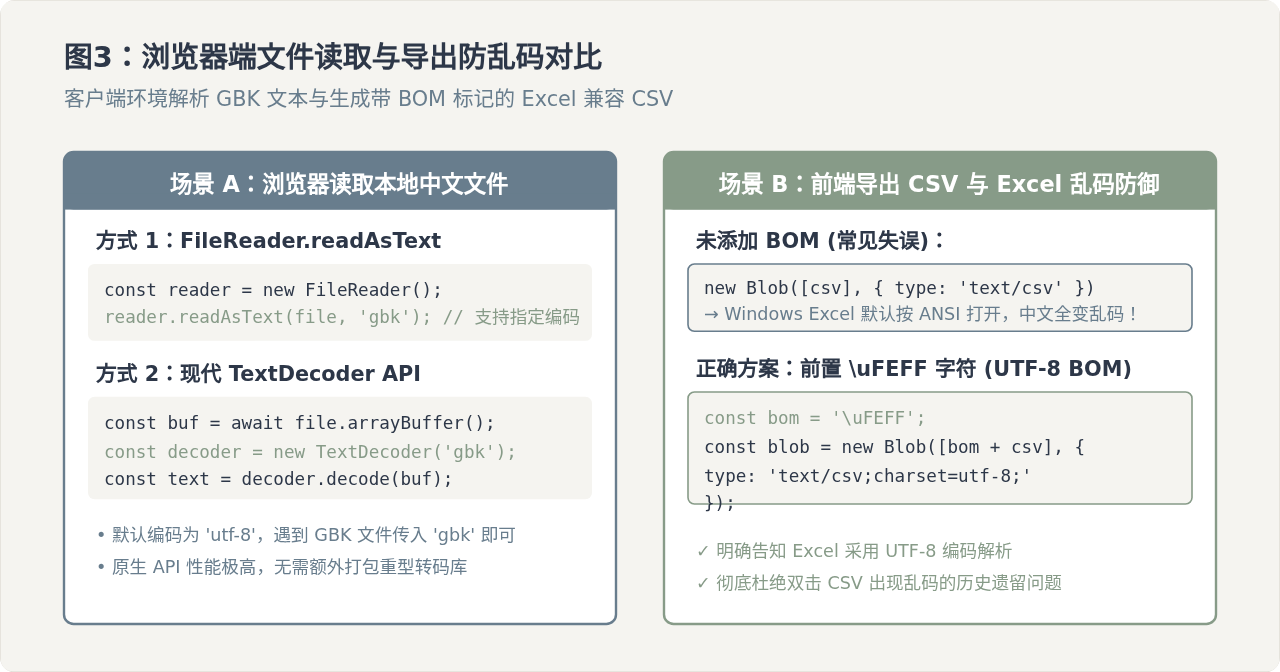
1. 浏览器读取本地文件时的编码指定
在前端监听文件上传事件时,如果用户上传的是 GBK 编码的文本文件,切勿直接调用 file.text()(因为 file.text() 强制按 UTF-8 解码)。正确方法是使用 FileReader 或 TextDecoder:
// 监听文件选择
document.getElementById('fileInput').addEventListener('change', async (e) => {
  const file = e.target.files[0];
  if (!file) return;

  // 推荐方式:转换为 ArrayBuffer 后通过 TextDecoder 精准解码
  const arrayBuffer = await file.arrayBuffer();

  // 如果确定是老旧 GBK 文件,指定 'gbk';默认情况可使用 'utf-8'
  const decoder = new TextDecoder('gbk');
  const content = decoder.decode(arrayBuffer);

  console.log('读取到的中文内容:', content);
});
2. 前端导出 CSV 在 Excel 中乱码的彻底根治
许多前端开发者会发现:导出的 CSV 文件在 VS Code 或记事本中打开中文完全正常,但用户直接双击使用 Microsoft Excel 打开时全部变成乱码。其原因在于:
Windows 版本的 Excel 在双击打开 .csv 文件时,如果文件开头没有发现特定的字节顺序标记(Byte Order Mark,简称 BOM),会默认采用系统本地编码(简体中文系统下即 GBK)来解析文本。而前端代码默认生成的字符串通常是标准无 BOM 的 UTF-8,两者的冲突导致了乱码。
解决办法:在构建 Blob 时,于字符串最前端拼接一个 Unicode 零宽无断空格字符 \uFEFF(该字符在 UTF-8 下编码即为 0xEF 0xBB 0xBF,代表 UTF-8 BOM)。Excel 识别到该标记后,就会强制切换至 UTF-8 引擎进行渲染:
function exportToCsv(filename, rows) {
  // 1. 将二维数组转换为逗号分隔的 CSV 字符串
  const csvBody = rows.map(row => row.map(val => `"${val}"`).join(',')).join('\n');

  // 2. 关键核心:在文件头部追加 '\uFEFF' BOM 标记
  const bom = '\uFEFF';
  const blob = new Blob([bom + csvBody], { type: 'text/csv;charset=utf-8;' });

  // 3. 触发浏览器安全下载
  const url = URL.createObjectURL(blob);
  const link = document.createElement('a');
  link.href = url;
  link.setAttribute('download', filename);
  document.body.appendChild(link);
  link.click();
  document.body.removeChild(link);
  URL.revokeObjectURL(url);
}

// 示例调用:
exportToCsv('员工花名册.csv', [
  ['工号', '姓名', '部门', '入职日期'],
  ['1001', '张三', '技术部', '2024-01-15'],
  ['1002', '李四', '产品部', '2024-03-20']
]);
四、未知编码探测与大文件流式处理
在实际生产业务中,系统常常无法预先获知用户上传的文件究竟是 UTF-8 还是 GBK。如果盲目猜测,总会有部分文件出现解码异常。
1. 引入编码嗅探(jschardet)
计算机无法百分之百仅凭二进制字节推断出人类设计的编码意图,但可以通过统计学规律对字节分布进行特征匹配。在 Node.js 或前端中,可以使用开源库 jschardet 提取文件开头的特征片段进行分析:
const fs = require('fs');
const jschardet = require('jschardet');
const iconv = require('iconv-lite');

// 读取文件头部前 4096 字节进行采样,无需加载整个大文件
const fd = fs.openSync('unknown_data.txt', 'r');
const sampleBuffer = Buffer.alloc(4096);
const bytesRead = fs.readSync(fd, sampleBuffer, 0, 4096, 0);
fs.closeSync(fd);

// 探测编码
const detected = jschardet.detect(sampleBuffer.subarray(0, bytesRead));
console.log('探测结果:', detected); // 例如 { encoding: 'GB2312', confidence: 0.99 }

// 根据判定结果选用对应解码器
const targetEncoding = detected.encoding || 'utf-8';
const fullBuffer = fs.readFileSync('unknown_data.txt');
const content = iconv.decode(fullBuffer, targetEncoding);
2. 大文件的流式(Stream)无乱码转换
当处理几十兆甚至数百兆的大型数据文件时,切忌使用 fs.readFileSync 一次性将全部数据读入内存,这极易引发内存溢出(OOM)。但如果直接使用普通的 fs.createReadStream 切片读取并分块调用 chunk.toString(),由于汉字由多个字节组成(UTF-8 为 3 字节,GBK 为 2 字节),切片边界可能会刚好截断一个完整汉字的中间字节,造成分块边缘随机乱码。
为了解决分块截断问题,必须使用专门的流式解码器。iconv-lite 提供了开箱即用的流式处理接口:
const fs = require('fs');
const iconv = require('iconv-lite');

// 创建源文件的可读流
const readStream = fs.createReadStream('large_gbk_file.txt');

// 创建按行或按目标的写入流
const writeStream = fs.createWriteStream('large_utf8_file.txt');

// 通过管道流式解码与重新编码,内部会自动暂存未闭合的多字节字符
readStream
  .pipe(iconv.decodeStream('gbk'))       // 将二进制流安全解码为文本流
  .pipe(iconv.encodeStream('utf8'))      // 将文本流重新编码为 UTF-8 二进制流
  .pipe(writeStream)
  .on('finish', () => {
    console.log('大文件编码流式转换完成,无内存暴涨与边界截断问题');
  });
五、常见问题排查与速查对照
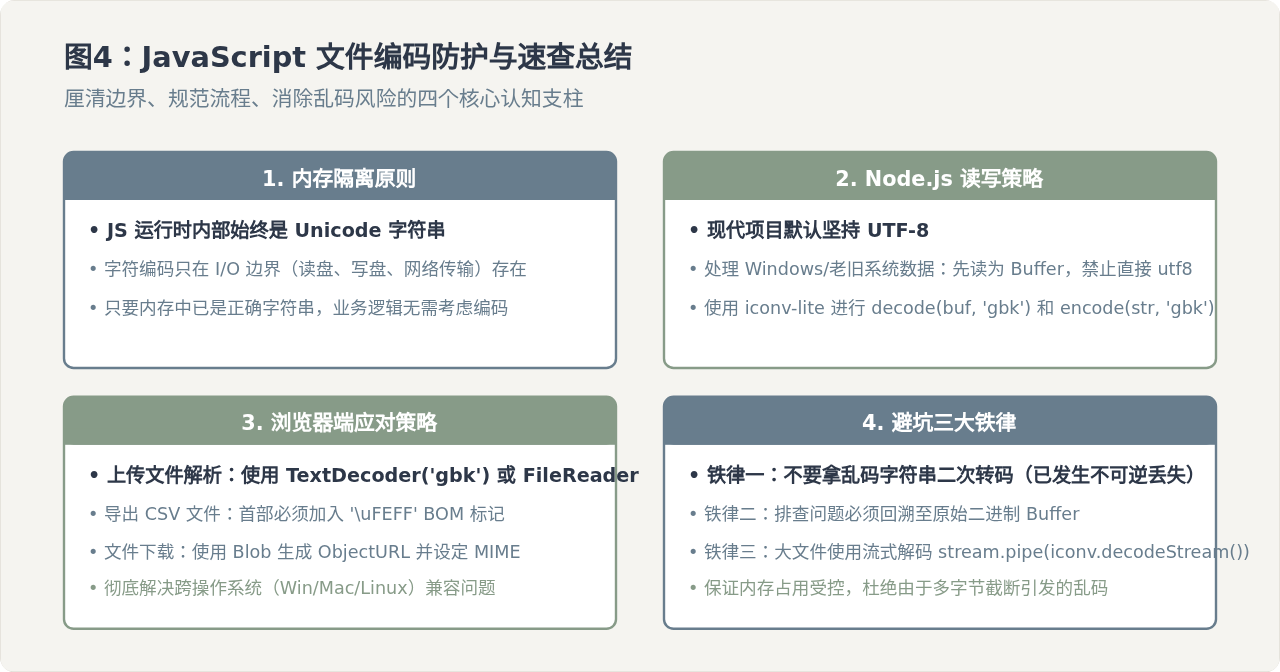
在日常排查时,可通过下表快速对照常见故障现象与对应修复方案:
| 异常现象 | 产生原因 | 标准修复措施 |
|---|---|---|
| 文本变成“锟斤拷”或连续的“” | 将非 UTF-8(如 GBK)数据用 UTF-8 强行解码,产生了不可逆的 Unicode 替代符 | 保留原始二进制 Buffer,使用 iconv-lite.decode(buf, 'gbk') 或原生 TextDecoder('gbk') 解码 |
| 中文字符变为类似“浣犲ソ”的生僻拼音文字 | 原文件为标准 UTF-8,但读取端配置为了 GBK / ANSI 规则 | 调整读取配置为 utf8 或移除错误的 GBK 转换中间件 |
| 前端导出的 CSV 文件在 Windows Excel 打开乱码,但在记事本中正常 | Excel 缺少 UTF-8 BOM 识别标记,默认按 Windows 本地 ANSI 编码解析 | 在 CSV 字符串前显式拼接 \uFEFF,即 new Blob(['\uFEFF' + content]) |
| 流式读取大文件时,偶尔每隔几千字出现个别乱码汉字 | Stream 分块缓冲区边界刚好切断了多字节汉字,直接对 chunk 执行了 toString() |
改用 iconv.decodeStream(),或在原生流中使用 string_decoder 模块暂存未完结字节 |
六、总结
解决 JavaScript 文件读写中的中文乱码问题,核心在于建立“二进制数据与字符表现分离”的工程意识:
- 文件存在于介质上时永远只是原始二进制(Buffer / ArrayBuffer),本身并没有绝对的“文字属性”。
- JavaScript 字符串在内存中始终是统一的 Unicode(UTF-16)。
- 所有的乱码均诞生在由“二进制转换为字符串(解码)”或“字符串写入为二进制(编码)”的 I/O 边界处。
在 Node.js 中读取老旧或未知文件时,坚持先获取原始 Buffer,辅以 iconv-lite 或 TextDecoder 定向转码;在浏览器导出涉及中文的 CSV 等文本报表时,养成前置 \uFEFF BOM 标记的习惯。遵循这套确定性的工作流,即可在任何平台与环境中稳健自如地处理中文文件读写。
Node.js中使用path模块获取文件名
2026-11-05 15:15:15
Node.js中url模块与querystring模块处理查询字符串的区别
2026-11-05 15:04:45
JavaScript(JS)主要用来做什么
2026-11-05 10:10:47
怎么修改Node.js和npm的全局安装路径与缓存目录
2026-11-04 19:48:28
NW.js 常见问题排查:Node 模块加载失败与版本兼容解决
2026-11-04 11:22:45







