

Tampermonkey油猴脚本与Node.js脚本:JS自动化场景该怎么选择
深入对比Tampermonkey油猴脚本与Node.js脚本在运行机制、凭证依赖、触发方式和扩展能力上的核心差异,提供清晰的JavaScript自动化选型指南与实用案例。
一、运行机制与宿主环境深度剖析
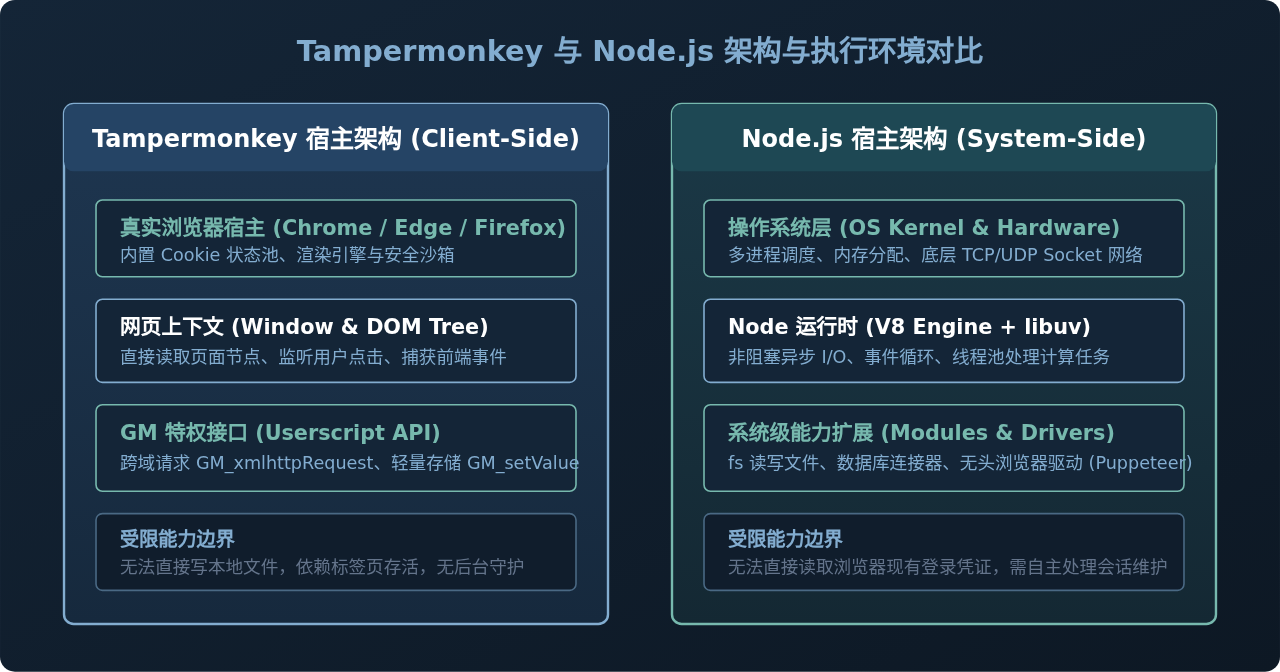
很多开发者在面临技术选型时容易混淆两者的定位,根本原因在于两者都可以编写现代 JavaScript 代码,并且都可以发起网络请求与处理 JSON 数据。然而,它们的运行宿主存在本质差异:
- Tampermonkey(浏览器扩展环境):脚本注入在真实浏览器的标签页沙箱中,寄生于页面生命周期。它天生共享当前浏览器会话的所有 Cookie、LocalStorage、Canvas 指纹及已渲染的真实 DOM 树,且享受浏览器的反爬虫环境信任。
- Node.js(独立服务端/系统运行环境):脚本运行于系统级 V8 引擎中,拥有完整的操作系统访问权(包括直接读写文件系统、监听网络端口、连接各类数据库)。它脱离了图形界面,所有 HTTP 请求均通过原生模块或三方库由底层网卡直接发出,默认不带有任何浏览器会话信息。
二、核心考量维度:何时用油猴,何时用 Node.js
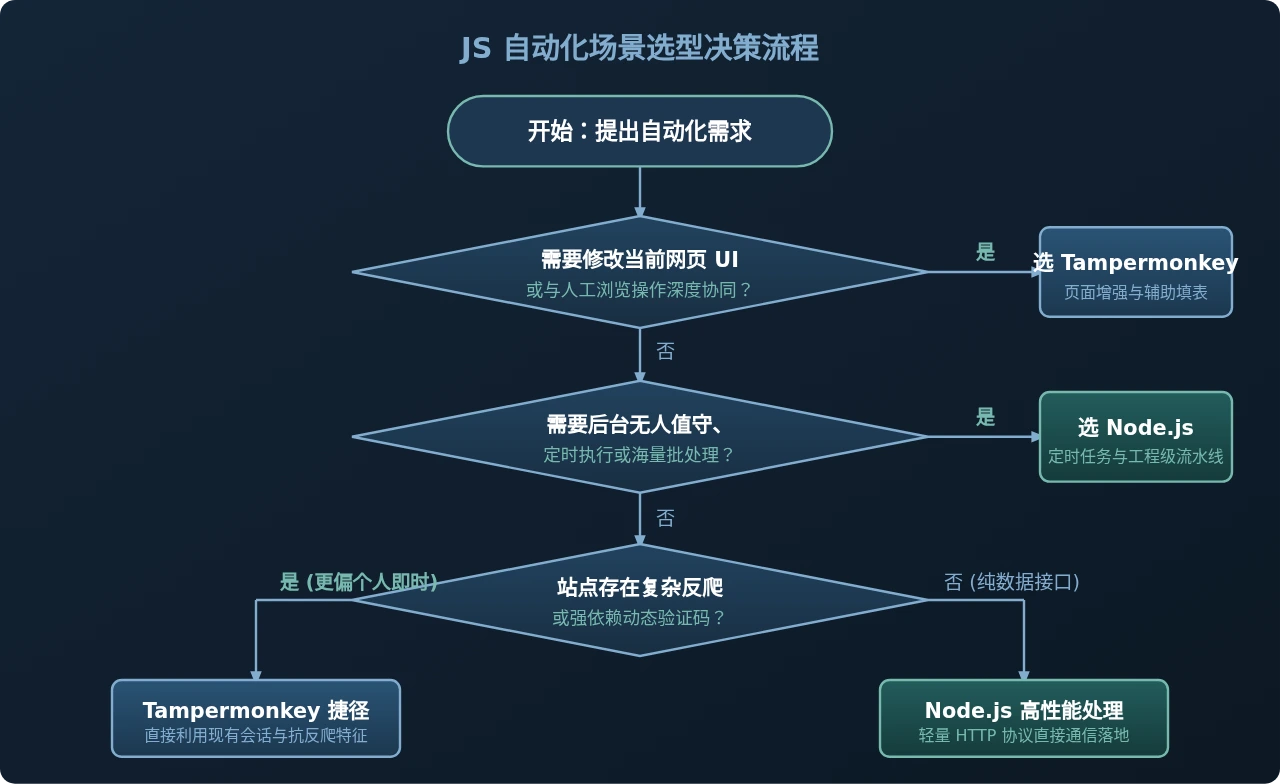
在实际决定采用何种技术方案时,建议从以下四个具体技术约束来判断,避免由于选型错误而在后期反复推倒重来。
1. 登录凭证与身份鉴权
现代 Web 应用的身份鉴权越来越严格,短信验证码、滑块验证码、设备指纹等机制层出不穷。
- Tampermonkey:天然借力。你在浏览器中正常扫码登录,油猴脚本就能直接通过浏览器的上下文发起请求,或直接在页面中读取已经脱敏的数据,完全不需要逆向复杂的加密算法或模拟登录流程。
- Node.js:必须独立建立会话。除非你主动提取 Cookie 传入脚本,或者编写基于 Puppeteer 的无头浏览器自动化登录流程,否则脚本无法自发维持身份鉴权。对于需要经常二次扫码确认的内部系统,Node.js 的维护成本显著提高。
2. 运行触发方式与常驻性
自动化脚本是单次辅助,还是长期自动化运转?
- Tampermonkey 依赖标签页。只有在对应的 URL 页面被打开并完全载入后,脚本才会执行。如果浏览器关闭、或者目标页面未被触发访问,油猴脚本完全处于休眠状态,无法胜任严格的凌晨定时批处理。
- Node.js 具备真正的守护进程。可以通过 Linux
crontab、Windows 任务计划程序或PM2进程管理器实现 24 小时无人值守轮询与定时触发。
3. 数据存储与系统资源消耗
处理好的数据去往哪里,是选型的又一硬性标准。
- Tampermonkey 存储受限。油猴提供的
GM_setValue仅能存储轻量级的键值对数据(通常在几兆字节内),无法直接将数据追加写入本地的 Excel、SQLite 或本地磁盘文件夹。虽然可以通过触发浏览器下载,但大批量并发保存文件体验极差。 - Node.js 拥有完整的系统 I/O。无论是生成 CSV、操作本地 SQLite 数据库,还是将数据推送到企业内网的消息队列中,Node.js 都可以通过几行标准代码完成。
三、典型开发与部署步骤对照
为了直观展示两种方案从立项到运行的具体差异,我们分别展示其完整实现示例与操作路径。
1. Tampermonkey:界面注入与即时数据提取
在 Tampermonkey 中,开发流程通常包含:安装扩展 -> 新建用户脚本 -> 编写元数据指令(@match 等)-> 刷新目标网页即可立刻看到效果。
// ==UserScript==
// @name         业务数据一键采集器示例
// @namespace    https://example.com/
// @version      1.0
// @description  在数据列表页注入快捷提取按钮,读取 DOM 并复制到剪贴板
// @match        https://example.com/dashboard/orders*
// @grant        GM_setClipboard
// ==/UserScript==

(function() {
    'use strict';

    // 1. 创建操作按钮
    const btn = document.createElement('button');
    btn.innerText = '一键导出当前页';
    btn.style.cssText = 'position:fixed;top:15px;right:15px;z-index:9999;background:#142537;color:#83ADD0;border:1px solid #77B9AE;padding:8px 14px;border-radius:4px;cursor:pointer;';
    document.body.appendChild(btn);

    // 2. 绑定事件提取页面 DOM 内容
    btn.onclick = function() {
        const rows = document.querySelectorAll('.table-row');
        const results = [];
        rows.forEach(r => {
            const title = r.querySelector('.title')?.innerText.trim() || '';
            const price = r.querySelector('.price')?.innerText.trim() || '';
            results.push({ title, price });
        });

        // 利用 GM 特权直接存入系统剪贴板
        GM_setClipboard(JSON.stringify(results, null, 2));
        alert(`已抓取 ${results.length} 条数据并存入剪贴板!`);
    };
})();
2. Node.js:脱机定时批量拉取与落地文件
在 Node.js 环境中,我们通常无需依赖任何 UI 渲染,通过工程化代码直接操作网络与本地磁盘:
// save-orders.js
import fs from 'node:fs/promises';
import path from 'node:path';

async function fetchAndSaveOrders() {
    const targetUrl = 'https://example.com/api/orders?page=1&size=50';

    // 显式携带已获取或配置好的身份 Token
    const response = await fetch(targetUrl, {
        headers: {
            'Authorization': 'Bearer YOUR_SAVED_TOKEN',
            'User-Agent': 'NodeAutomationWorker/1.0'
        }
    });

    if (!response.ok) {
        throw new Error(`请求失败: ${response.status} ${response.statusText}`);
    }

    const data = await response.json();
    const filePath = path.resolve('./orders_backup.json');

    // 直接写入本地文件系统
    await fs.writeFile(filePath, JSON.stringify(data, null, 2), 'utf-8');
    console.log(`[${new Date().toISOString()}] 成功持久化数据至 ${filePath}`);
}

fetchAndSaveOrders().catch(console.error);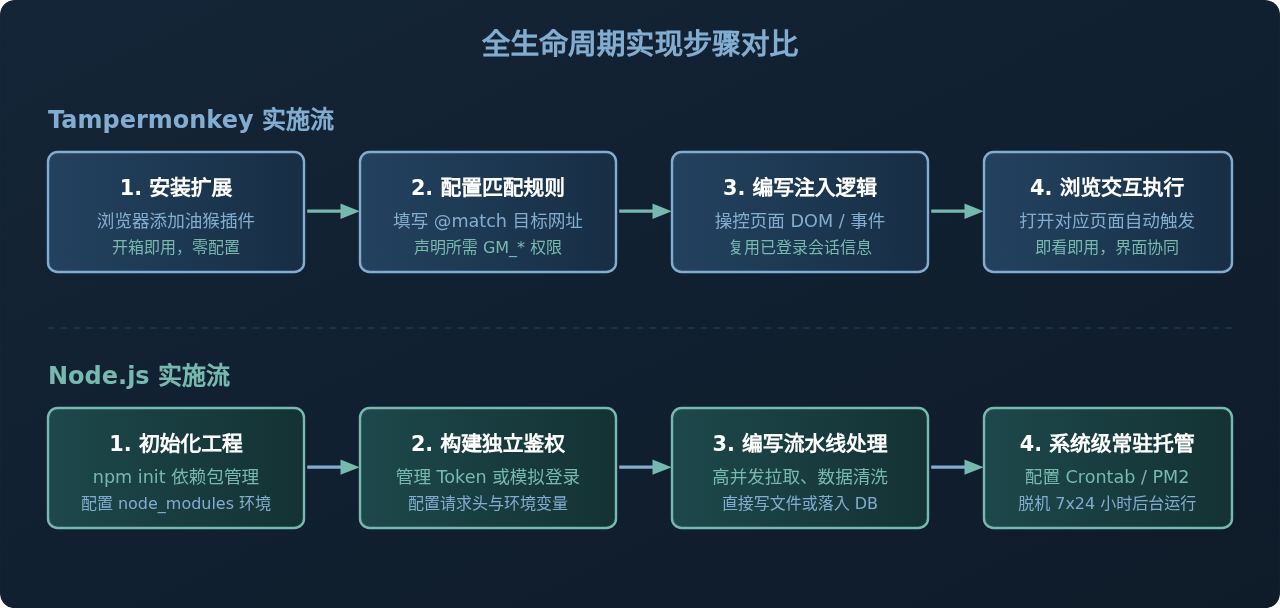
四、进阶模式:Tampermonkey 与 Node.js 的协同组合
在很多高难度的实际业务自动化场景中,最佳策略往往不是非此即彼,而是将两者组合使用。
例如,某企业内部系统使用了极高强度的动态图形验证码与动态请求加签算法,若使用纯 Node.js 逆向签名和处理验证码成本高昂,且极易被风控拦截;但若仅靠 Tampermonkey,提取出的上万条数据又无法方便地存储在本地数据库中。
- 由工程师或业务人员在正常浏览器中登录系统,保持会话活性。
- 在本地后台运行一个轻量的 Node.js 接收服务(例如监听
http://127.0.0.1:3000/ingest),随时准备接收结构化数据并落盘写入 SQLite 或本地磁盘。 - Tampermonkey 脚本在浏览器中自动翻页,在当前合法会话中读取数据,随后通过
GM_xmlhttpRequest发起跨域请求,直接将每一页数据通过 POST 发送给本地的 Node.js 端口。
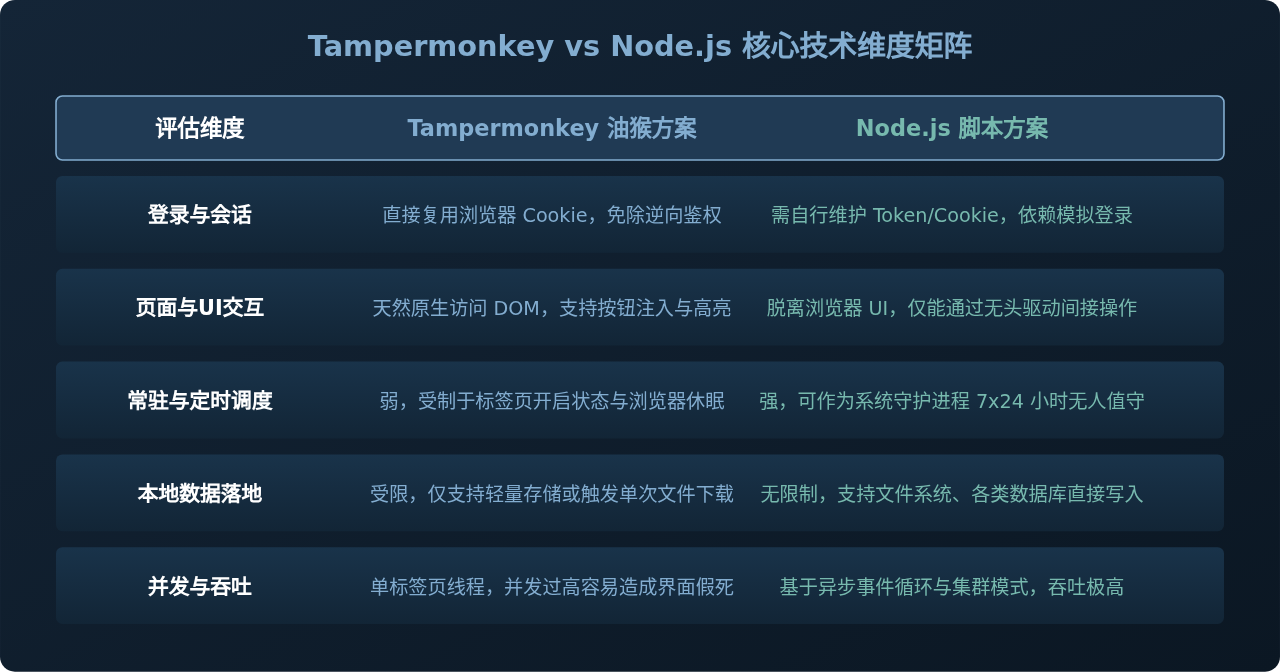
五、多维度综合评估与最终决策总结
为了在面临具体业务场景时能迅速拍板技术路径,以下为量化对比矩阵:
六、常见选型误区与落地建议
| 场景类型 | 推荐方案 | 关键原因与注意事项 |
|---|---|---|
| 日常网页浏览辅助(如视频去广告、自动展开全文、表单预填) | Tampermonkey | 必须实时伴随用户浏览,直接操作 DOM,开发耗时最短。 |
| 复杂反爬站点的个人临时数据提取 | Tampermonkey | 利用已登录浏览器环境,直接绕过短信验证码与滑块风控。 |
| 每日定时报表拉取与入库(如凌晨拉取前一天订单存入 MySQL) | Node.js | 必须脱机无人值守执行,且需要直接连接数据库或写入服务器磁盘。 |
| 大批量跨站点信息监控与告警推送 | Node.js | 多请求并发能力强,内存可控,并能常驻系统后台。 |
| 既有复杂反爬需绕过,又需要本地落地万级数据 | 两者协同 | 油猴提取数据并通过本地接口 POST 给本地 Node.js 脚本存储。 |
总的来说,Tampermonkey 是“人机协同”与“页面增强”的利器,而 Node.js 是“后台批处理”与“工程级自动化”的基石。根据你的任务是否需要依赖屏幕前的用户与活动标签页,即可在几秒钟内确定清晰的技术选型。
Java和JavaScript的应用场景分工:后端企业级开发与Web前端交互
2026-11-05 15:57:34
除了浏览器和Node.js,还有哪些轻量级Js脚本运行工具?
2026-11-04 17:38:24
无需后端:用JavaScript实现简单网站的本地数据存储
2026-11-03 23:03:30
Node.js 下载慢或官网打不开怎么办
2026-11-03 18:19:37
JS解析大体积Excel文件内存溢出怎么办
2026-11-03 18:19:37







