JavaScript中FileReader与createObjectURL读取图片的区别
深入对比JavaScript中FileReader与URL.createObjectURL在读取和预览图片时的核心机制、内存占用、执行性能、生命周期管理以及典型业务场景选型指南。
URL.createObjectURL 通过在内存中创建指向文件底层的引用指针(以 blob: 开头的 URL),实现同步即时返回、零编码开销、极低内存占用,是纯前端即时预览的首选;而 FileReader.readAsDataURL() 则是一个异步事件驱动过程,它将二进制图片完全解码并编码为庞大的 Base64 字符串(体积增加约33%),主要用于需要持久化存储至 localStorage、拼装进 JSON 报文传输或在 Canvas 中直接嵌入图像数据的场景。
一、本质机制与数据载体差异
当用户在网页中通过 <input type="file"> 选中一张图片,或者通过拖拽把图片拖入浏览器时,JavaScript 会拿到一个 File 对象(该对象继承自 Blob)。要将这个本地磁盘或内存中的文件渲染到页面的 <img> 标签上,开发者通常有两条技术路径:使用 FileReader 或调用 URL.createObjectURL。这两者在底层机制和最终输出的数据形式上存在本质差异。
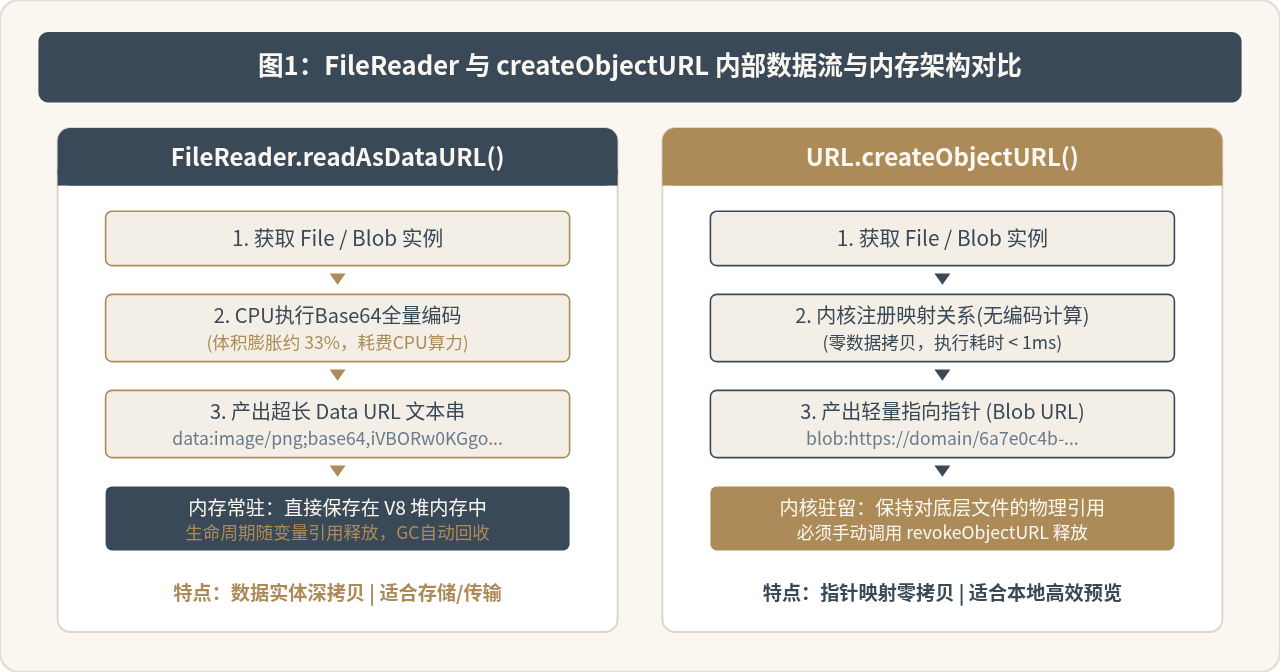
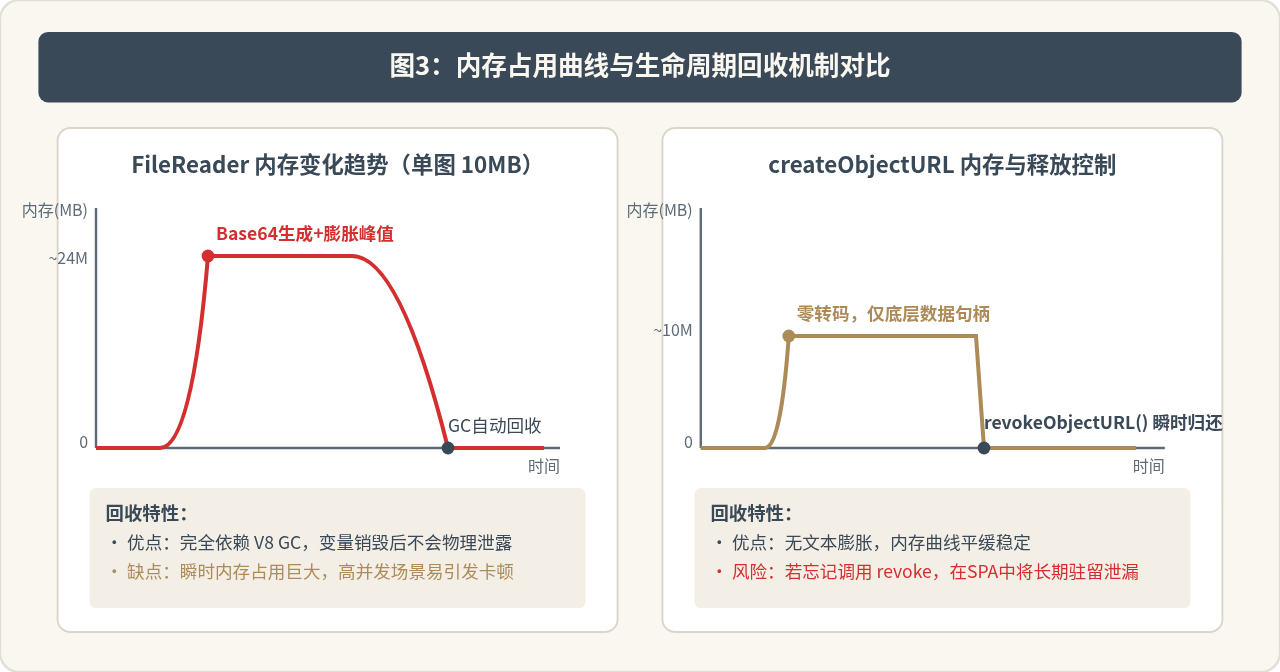
FileReader 是 Web API 提供的文件异步读取器。调用 reader.readAsDataURL(file) 时,浏览器必须从底层读取文件的原始二进制字节流,在 CPU 中执行 Base64 算法进行转换,最终在 V8/JavaScript 堆内存中生成一个完整的 Data URL 字符串,如 data:image/jpeg;base64,/9j/4AAQSkZJRg...。由于 Base64 编码使用 4 个 ASCII 字符表示 3 个字节的二进制数据,生成的字符串体积会比原文件净增约 33%。对于一张 10MB 的高清照片,生成的数据字符串就高达 13.3MB,且这个庞大的字符串会直接常驻在 JavaScript 运行时的变量作用域中。
相比之下,URL.createObjectURL(blob) 并没有对图片文件做任何复制或转码。它只是在浏览器底层内核的网络/资源映射表中注册了一个唯一的临时键值对,映射到该文件在内存或磁盘中的物理引用,并生成一个极短的虚拟统一资源标识符,形如 blob:http://localhost:3000/b149bdf5-d143-42e7-9d7a-cfb1602330a1。这个字符串本身仅有几十个字符,它不是图片数据本身,而是一个“借阅证”。当把这个 URL 赋值给 <img src="..."> 时,浏览器内核会拦截该请求,并像请求普通静态资源一样直接读取底层的二进制数据流。
二、代码调用方式与执行步骤解析
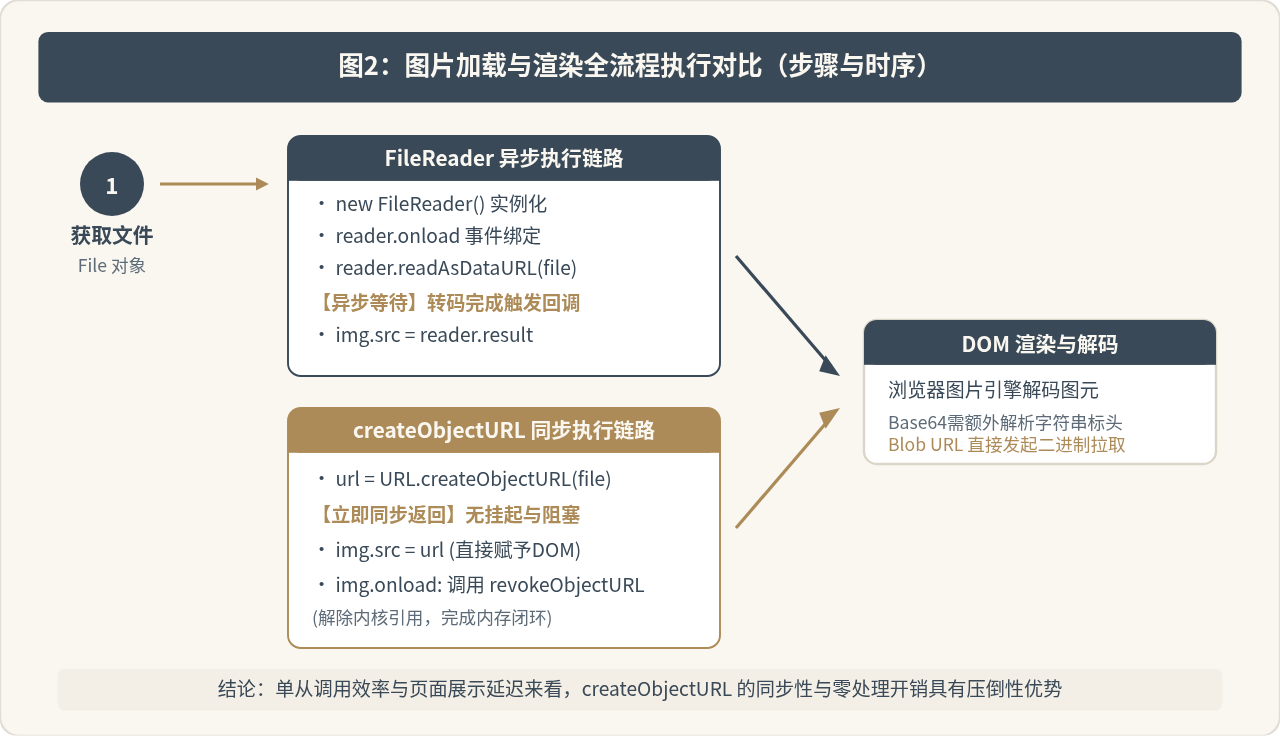
在编码实现层面,两者调用风格完全不同:一个是基于事件驱动的异步处理机制,另一个是极简的同步即时函数。
1. FileReader 的异步事件读取步骤
使用 FileReader 时,需要先实例化对象,注册生命周期回调函数(如 onload、onerror),最后触发读取操作:
// 获取 input 选中的文件
const fileInput = document.querySelector('#upload-input');
const previewImg = document.querySelector('#preview-img');

fileInput.addEventListener('change', (e) => {
  const file = e.target.files[0];
  if (!file) return;

  // 1. 创建 FileReader 实例
  const reader = new FileReader();

  // 2. 注册异步读取完成监听
  reader.onload = (event) => {
    // 获取完整的 Base64 Data URL 字符串并赋值给图片
    previewImg.src = event.target.result;
  };

  // 3. 错误处理机制
  reader.onerror = (err) => {
    console.error('文件读取失败:', err);
  };

  // 4. 发起异步读取
  reader.readAsDataURL(file);
});
2. URL.createObjectURL 的同步极简调用
使用 URL.createObjectURL 则极其直接,无需实例化,直接传入 Blob 或 File 对象,立刻同步返回指向该资源的 URL:
fileInput.addEventListener('change', (e) => {
  const file = e.target.files[0];
  if (!file) return;

  // 1. 同步生成轻量 Blob URL
  const objectUrl = URL.createObjectURL(file);

  // 2. 直接赋值使用
  previewImg.src = objectUrl;

  // 3. 规范要求:在图片完成加载后,释放引用指针以防内存泄漏
  previewImg.onload = () => {
    URL.revokeObjectURL(objectUrl);
  };
});
三、性能开销、内存占用与生命周期深度剖析
在小图片(如几十KB的头像)场景下,两种方案在视觉感受上几乎没有差异。但一旦面对数兆的高清原图、多图批量上传预览,或者长生命周期的单页应用(SPA),两者的表现就会产生巨大分水岭。
1. CPU 运算与主线程影响
FileReader.readAsDataURL() 在执行时,必须逐字节读取并转化为 Base64 文本。尽管读取本身是在浏览器内核辅助线程完成,但在生成并传递巨型字符串到 JavaScript 主线程时,依然伴随着大量的内存分配与复制开销。如果用户一次选中 20 张各 8MB 的相机原图,主线程需要同时接收数百兆的字符串数据,极易造成页面掉帧甚至卡顿。
而 URL.createObjectURL() 仅是在内核生成一个极短的 UUID 索引映射,无论原图是 100KB 还是 500MB,该 API 的调用耗时通常都在 1 毫秒以内,几乎不消耗 CPU 资源。
2. 内存生命周期与内存泄漏陷阱
两者的内存管理模式有着根本的不同:
- FileReader(自动 GC 机制):生成的 Base64 字符串归属于 JavaScript 作用域。当包含该字符串的变量超出作用域、或者
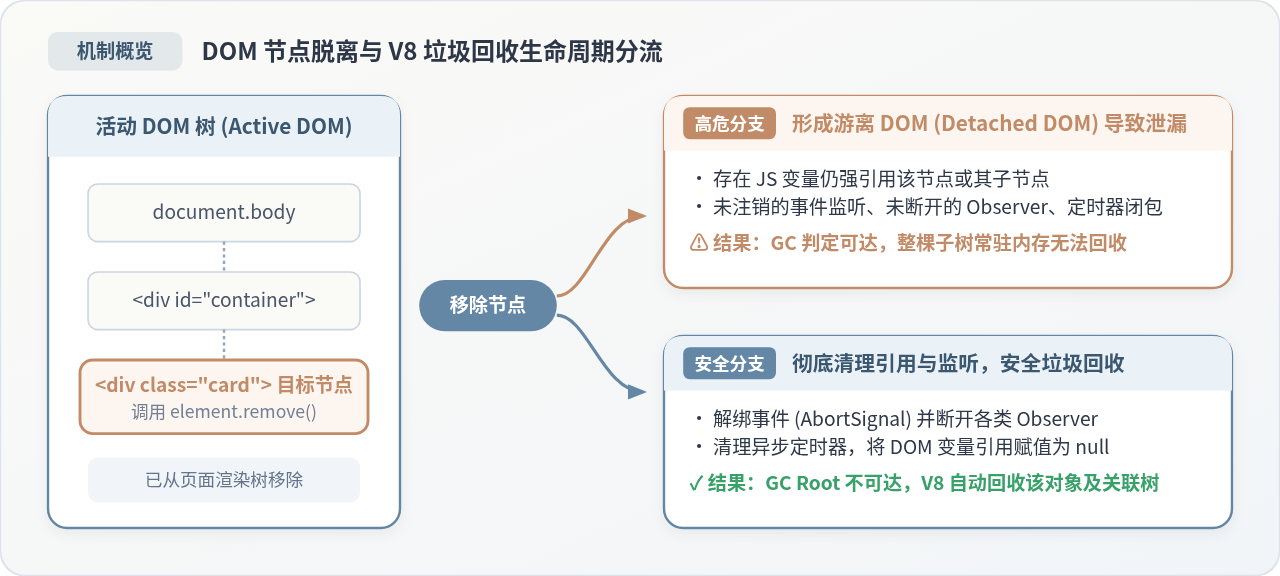
img.src被替换且没有其他变量引用该字符串时,浏览器的垃圾回收器(Garbage Collector)会自动回收这部分堆内存。其优点是不会造成底层泄漏,缺点是大字符串在 GC 前占用峰值极高。 - createObjectURL(手动释放机制):Blob URL 引用的生命周期是与当前文档(Document)的生命周期绑定的。只要用户不刷新或关闭网页,浏览器内核会始终保持该 URL 与底层文件二进制数据块的强引用,这意味着文件占用的内存永远不会被 GC 回收。如果在一个长期运行的单页应用中频繁生成 Blob URL 却从未释放,内存占用会直线上升,最终导致浏览器标签页崩溃。因此,规范中必须在适当时机显式调用
URL.revokeObjectURL(url)解除引用。
四、核心特性全面对比速查表
为了帮助开发者在架构与编码时快速决策,下表总结了两者在关键技术维度上的核心参数与行为差异:
| 对比维度 | FileReader (readAsDataURL) | URL.createObjectURL |
|---|---|---|
| 返回值形式 | Base64 Data URL 字符串(包含编码前缀与完整图像数据) | 虚拟 Blob URL 指针(指向浏览器内部存储映射) |
| 执行方式 | 异步非阻塞(需通过事件监听器接收结果) | 同步立即可用(直接调用函数同步返回) |
| 内存开销 | 高。数据全量深拷贝,字符编码后体积额外膨胀 33% 左右 | 极低。仅生成轻量映射索引,零拷贝底层文件内容 |
| CPU 消耗 | 大文件或多图同时转换时 CPU 占用明显 | 几乎为零,瞬间完成指针生成 |
| 生命周期管理 | 自动。由 JavaScript 引擎 GC 自动垃圾回收 | 手动/页面生命周期。需手动调用 revokeObjectURL 释放 |
| 数据独立性 | 强。生成的是自包含文本,可脱离原始文件存在 | 弱。仅为局部指针,随原始数据对象销毁或页面卸载而失效 |
| 可持久化性 | 可直接存入 localStorage / IndexedDB |
不可持久化。页面刷新或跨会话后该 URL 立即失效变为 404 |
五、典型业务场景选型指南与避坑建议
面对不同的业务诉求,选择正确的 API 能够兼顾页面流畅度与功能完整性。以下是行业中最常见的具体应用场景与选型依据:
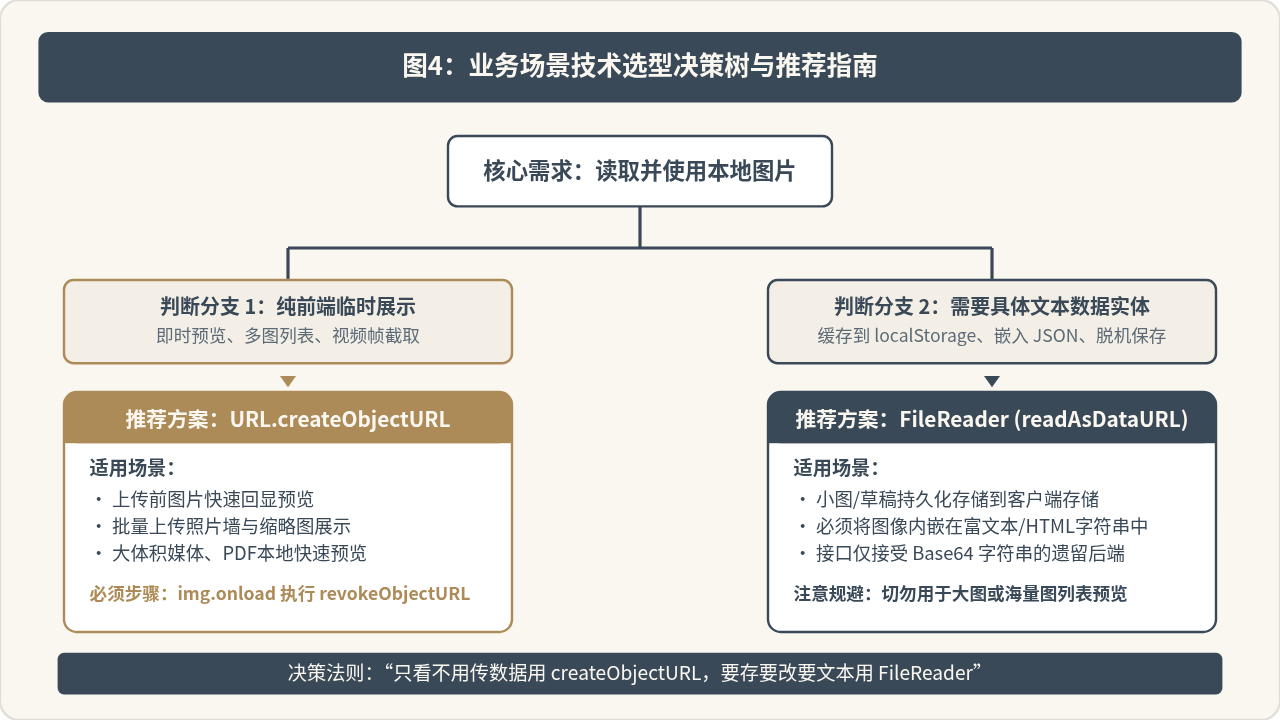
1. 常见陷阱一:上传文件时滥用 Base64
初学者容易有一种误区:认为必须先用 FileReader.readAsDataURL 把图片读出来,再把长长的 Base64 字符串发给后端完成上传。这种做法会带来双重损失:一方面客户端必须花费算力转码,另一方面网络请求包体积白白增加 33%,且服务端还需要消耗 CPU 解码回去。正确的做法是直接利用 FormData 上传原始的 File / Blob 对象,不仅零转码损耗,还可以利用 HTTP 流式传输;如果前端需要预览,配合 createObjectURL 即可。
2. 常见陷阱二:单页应用(SPA)中遗漏 revokeObjectURL
在使用 URL.createObjectURL 时,最稳妥的释放时机是在图片成功加载之后:
// 最佳实践:在图片渲染完成后释放对象URL
const tempUrl = URL.createObjectURL(file);
previewImg.src = tempUrl;

// 在图片资源被解码展示后,立即释放引用
previewImg.onload = () => {
  URL.revokeObjectURL(tempUrl);
};
需要注意的是,调用 revokeObjectURL(tempUrl) 后,只是让该 URL 失效,已经渲染到页面上的 <img> 并不会变空白,因为图片已经被浏览器图片解码引擎缓存。但如果在多处复用同一个临时 URL,则需要等到所有目标都加载完毕后再执行释放。
3. 常见陷阱三:FileReader 实例并发冲突
一个 FileReader 实例在同一时刻只能执行一次读取操作。如果在多选文件遍历中复用同一个 const reader = new FileReader() 并循环调用 readAsDataURL,会直接抛出 InvalidStateError: The object is already busy reading Blobs 异常。处理多个文件时,必须为每个文件创建独立的 FileReader 实例,或者使用 Promise.all 进行异步封装。
六、总结与关键决策依据
总结来说,FileReader 和 URL.createObjectURL 各自满足了 Web 平台不同阶段的诉求:
- 优先选择
URL.createObjectURL的场景:表单上传前的用户图片即时回显、富文本编辑器多图预览、裁剪工具加载原图等。它提供同步执行体验、极高渲染响应速度和极轻量的主线程负载。 - 保留使用
FileReader的场景:离线 Web 应用(PWA)需将用户草稿图保存至localStorage;必须将图元内联进 SVG 或自包含 HTML 文档;以及需要调用readAsArrayBuffer()对图片进行底层二进制解析、EXIF 信息提取或 WebAssembly 处理等深度开发场景。
理解两者在数据实体与内存指针上的分野,能够帮助我们在开发高性能的前端多媒体应用时,做出清晰且健壮的技术选型。
配置 Matter.js 睡眠机制以优化静止物体性能
2026-11-05 15:43:12
JavaScript console.log高级用法:用table、group和time优化调试输出
2026-11-05 08:04:56
JS变量中存储HTML代码时的特殊字符转义方法
2026-11-04 19:04:09
JS怎么安全转换带千分位或货币符号的字符串为数字
2026-11-04 11:54:14
推荐几款稳定的在线JS反混淆工具,支持Obfuscator.io解密
2026-11-04 08:16:21