JavaScript Set与Array的区别:何时选择Set提升性能
深入对比 JavaScript 中 Set 与 Array 的数据结构、查找机制与时间复杂度,解析何时使用 Set 能够实现百倍性能提升,并提供典型场景的代码实践与选型指南。
在日常 JavaScript 开发中,Array(数组)几乎是承载有序数据的默认选择。然而,当应用需要频繁进行“数据去重”、“成员是否存在检测”以及“集合关系比对”时,继续使用 Array 往往会导致严重的执行瓶颈。根本原因在于 Array 的底层查询属于线性扫描,而 Set 基于哈希表实现,能够提供接近常数级的查找速度。理解两者的底层结构差异与性能拐点,是在实际工程中做出合理数据结构选型的关键。
一、数据结构与组织机制的本质区别
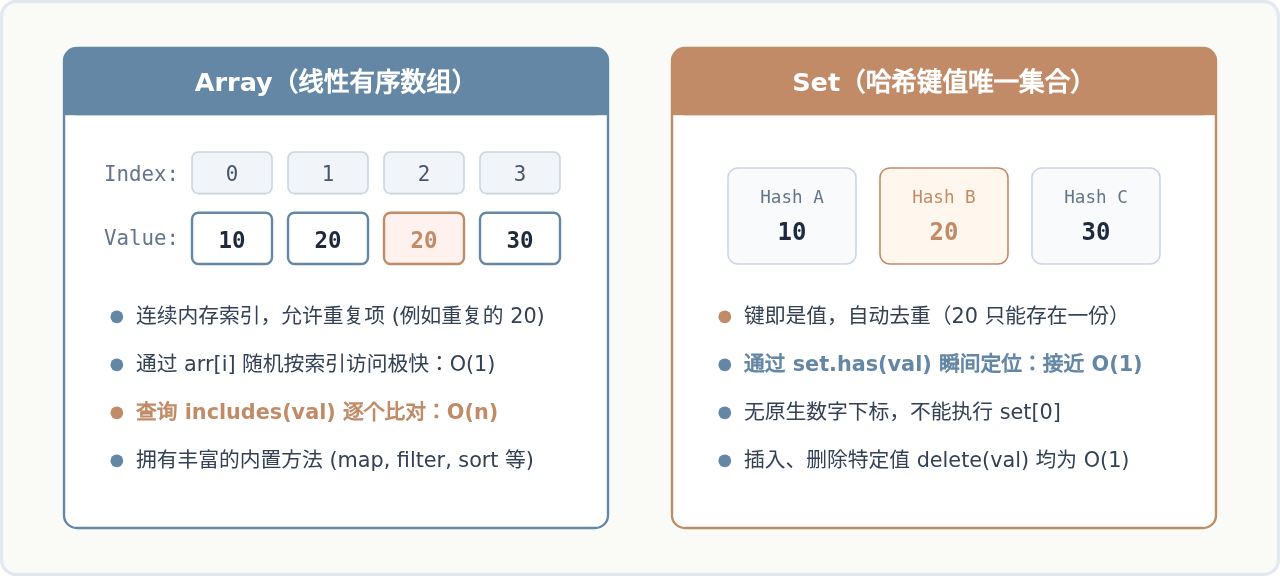
Array 与 Set 最核心的区别并不只是 API 名称的不同,而是底层组织与寻址数据的方式有着根本区别:
- Array 是有序的序列集合:每个元素拥有明确的数字下标索引(从 0 开始递增)。它允许包含重复的元素,元素在内存中以连续或紧凑的索引列表形式存在。
- Set 是唯一值的集合:集合内的每个元素必须是唯一的,重复添加相同值会被自动忽略。Set 内部依赖哈希表(Hash Table)或字典机制来索引值,元素的“值”本身即用于定位与判定。
二、核心操作的时间复杂度与性能差异
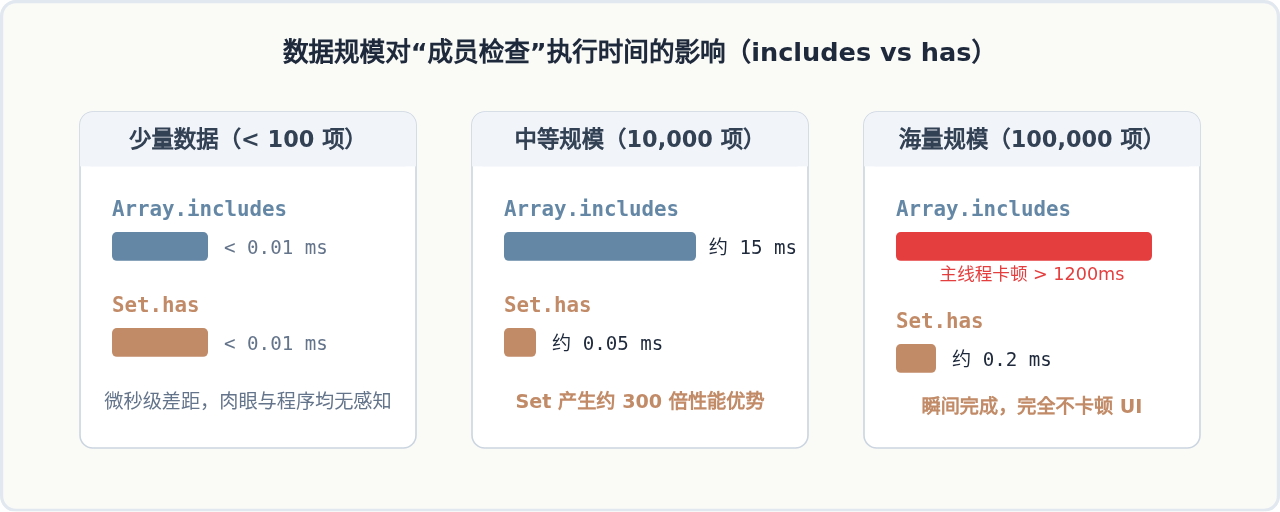
选择数据结构的核心考量之一是操作的时间复杂度。下表总结了 Array 与 Set 在常用操作上的复杂度对比:
| 操作类型 | Array 语法及复杂度 | Set 语法及复杂度 | 性能核心差异说明 |
|---|---|---|---|
| 检查值是否存在 | arr.includes(x) / O(n) |
set.has(x) / O(1) |
Array 必须从前往后逐个比对,数据越多越慢;Set 直接通过哈希定位,耗时恒定。 |
| 末尾追加元素 | arr.push(x) / O(1) |
set.add(x) / O(1) |
两者都在常数级时间内完成追加,Set 会额外进行一次唯一性校验。 |
| 删除指定值 | arr.splice(index, 1) / O(n) |
set.delete(x) / O(1) |
Array 需先线性查找目标再搬移后续元素;Set 定位后直接解除映射。 |
| 按索引随机读取 | arr[i] / O(1) |
不支持 / 需遍历 O(n) |
Array 天生支持直接下标寻址;Set 没有下标,需先转为数组或迭代器遍历。 |
| 批量去重 | arr.filter(...) / O(n²) |
new Set(arr) / O(n) |
嵌套循环去重耗时随数据平方级爆炸;Set 去重仅需一次遍历线性构建。 |
三、何时应当坚决选择 Set:三大高频实战场景
1. 高性能数组去重
在 ES6 之前,常见的数组去重手段是结合 filter 和 indexOf。如果原始数组有 10,000 个元素,由于 indexOf 本身也是一个 O(n) 的遍历过程,嵌套在 filter 中整体就退化为 O(n²) 复杂度,导致数万次甚至上亿次比对。
改用 new Set(arr) 去重,时间复杂度仅为 O(n),之后只需用展开运算符(Spread Operator)即可直接转回数组:
// 传统低效方式:O(n²),在万级数据下会出现秒级卡顿
const slowUnique = (arr) => arr.filter((item, index) => arr.indexOf(item) === index);

// 现代高效方式:O(n),线性一次扫描完成构建
const fastUnique = (arr) => [...new Set(arr)];

// 示例
const numbers = [1, 2, 2, 3, 4, 4, 5];
console.log(fastUnique(numbers)); // 输出: [1, 2, 3, 4, 5]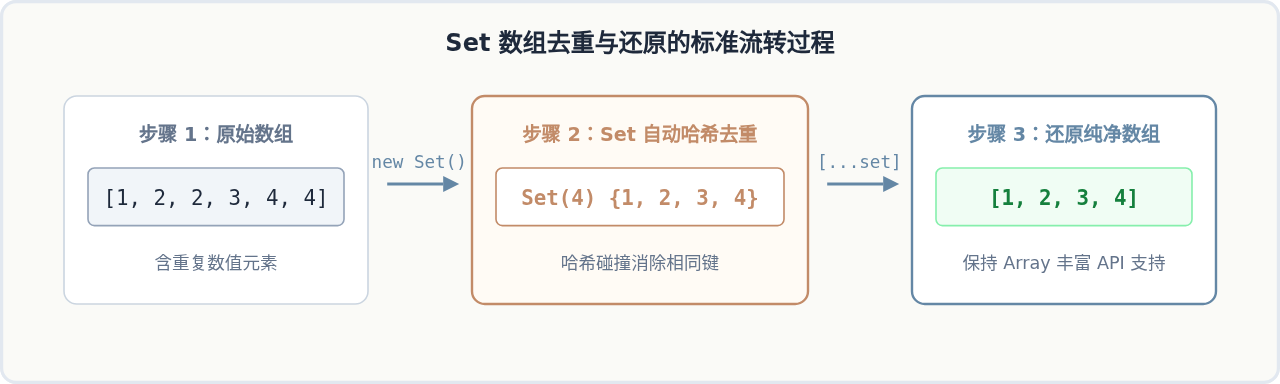
2. 频繁的白名单/黑名单校验与成员查找
在业务逻辑中,经常需要过滤用户行为或权限。例如,判断当前操作权限是否在允许的角色清单中,或者从 50,000 条日志中过滤掉 500 个屏蔽的 ID。
如果使用 forbiddenList.includes(id),每一次循环判定都要对 500 个元素进行线性搜索。在 50,000 次循环下,比对操作高达 25,000,000 次!将黑名单提前存入 Set 后,每一次查找都变成 O(1):
// 原始数据
const allUserActions = getActions(); // 假设有 50,000 条操作记录
const blockedUsers = getBlockedList(); // 假设有 2,000 个被封禁的用户 ID

// 【低效写法】:耗时可达数秒
const validActionsSlow = allUserActions.filter(action => {
  return !blockedUsers.includes(action.userId); // 每次 filter 都是 O(m) 的遍历
});

// 【高效写法】:毫秒级完成
const blockedSet = new Set(blockedUsers); // 先构造 Set:耗时 O(m)
const validActionsFast = allUserActions.filter(action => {
  return !blockedSet.has(action.userId); // 每次判断为 O(1)
});
3. 高效集合运算(交集、并集、差集)
在处理两组数据的重叠性时(如计算两位用户的共同好友、比对配置差集),使用 Set 配合其原生或扩展方法是最简洁且性能最高的方案:
const setA = new Set([1, 2, 3, 4, 5]);
const setB = new Set([4, 5, 6, 7, 8]);

// 1. 交集 (Intersection): 获取同时存在于两组的值
const intersection = new Set([...setA].filter(x => setB.has(x)));
// 结果: Set { 4, 5 }

// 2. 差集 (Difference): 存在于 A 但不存在于 B 的值
const difference = new Set([...setA].filter(x => !setB.has(x)));
// 结果: Set { 1, 2, 3 }

// 3. 并集 (Union): 合并并去重
const union = new Set([...setA, ...setB]);
// 结果: Set { 1, 2, 3, 4, 5, 6, 7, 8 }
四、何时必须坚持使用 Array?
虽然 Set 在查找与去重上优势明显,但它并不能完全替代 Array。在以下场景中,必须优先选择 Array:
- 需要根据下标读取或修改数据:如果需要执行
list[0]读取首项、list[list.length - 1]读取尾项,或者需要二分查找等依赖随机访问的算法,Set 完全无法原生支持。 - 必须保留并依赖重复项:例如电商系统的购物车清单、按序记录的击键日志、金融交易的历史流水等,这些业务场景下重复数据具备明确含义,不能被去重合并。
- 需要灵活的就地排序(In-place Sort):Array 拥有强大的
sort()和reverse()原生方法。Set 内部只能严格按照“元素的插入顺序”遍历,不支持就地重排。若想对 Set 排序,必须先转换为 Array,排完后再转回,反而增加了额外开销。 - 深度依赖函数式转换(map / reduce):尽管 Set 可以通过
forEach遍历,但它没有map、reduce、slice等丰富工具方法。频繁做复杂数据管道处理时,Array 的开发效率和链式调用更加优雅。
避坑提示:对象的引用相等性(Strict Equality)
Set 内部使用类似 Object.is() 的零值相等(Same-value-zero equality)机制判断唯一性。对于引用类型(对象、数组),只有当引用完全相同时才被视作重复。例如 new Set([{id: 1}, {id: 1}]) 会保留两个对象,因为它们在内存中的指针地址不同。如果需要对对象数组按某个属性去重,依然需要以具体字段值(如 item.id)作为 Set 的判断依据。
五、工程选型指南与决策流程
在日常开发中,选择 Array 还是 Set 不需要凭空猜测。通过以下决策流程图,可以直观地确定使用哪一种数据结构:
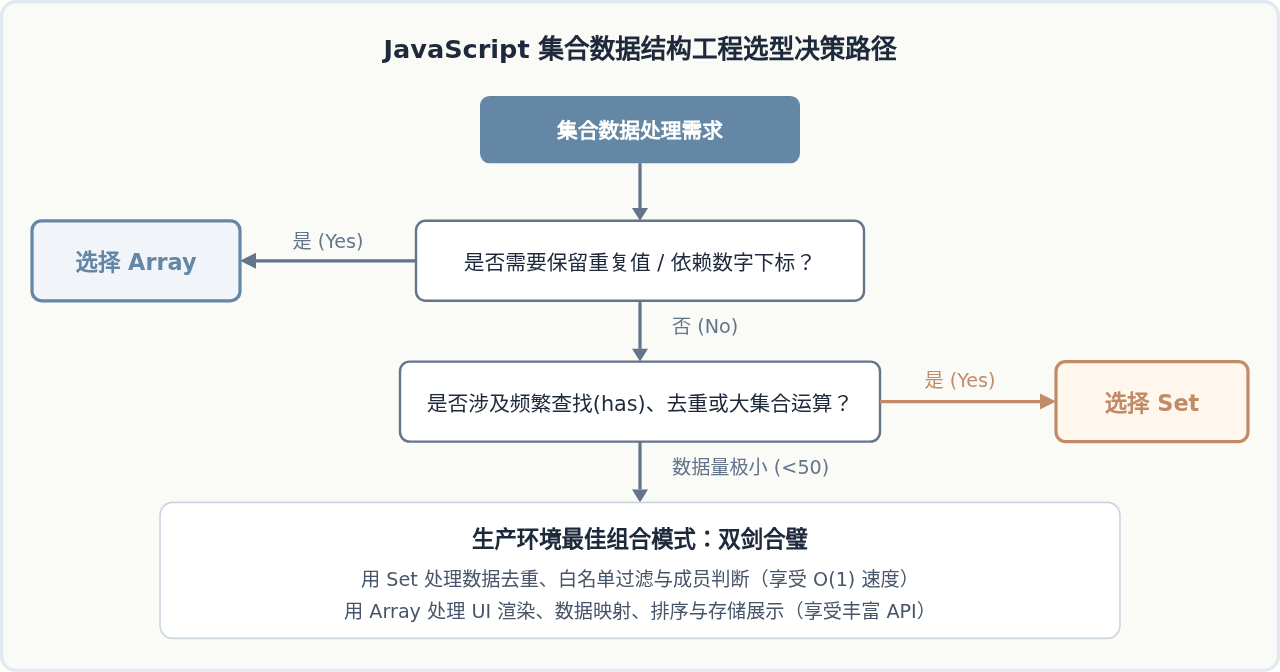
总结
Array 与 Set 并非互斥的对立选择,而是服务于不同操作特征的互补工具。当数据关注点在于“顺序”、“索引”和“变换”时,Array 是无可替代的骨干容器;而当核心痛点在于“查重”、“判存”与“去重”,尤其是数据量超过千级或在紧凑循环中高频执行时,换用 Set 能瞬间消除 O(n) 的遍历拖累,将执行耗时从百毫秒甚至秒级压缩到微秒级。
为什么JS调用reload后页面没有立即更新
2026-11-05 13:38:29
crypto-js 加密结果与 Java/Python 后端不一致怎么解决
2026-11-05 12:09:48
js文件缓存导致代码不更新怎么强制刷新
2026-11-04 22:30:24
JS逆向调试技巧:编写Hook脚本监控加密函数输入输出
2026-11-04 10:42:46
Babylon.js 性能优化技巧:实例化网格与遮挡剔除
2026-11-03 23:43:22