

怎么用JavaScript Set实现数组去重?附引用类型注意事项
深入浅出讲解如何使用JavaScript Set与展开运算符实现数组去重,详解SameValueZero比较机制,以及对象和数组等引用类型去重的陷阱与解决方案。
Set 与展开运算符:const result = [...new Set(array)];。利用 Set 集合成员唯一性的特性,只需一行代码即可过滤掉重复的数值或字符串。但如果数组中存储的是对象、数组等“引用类型”,直接使用 Set 往往会导致去重失效。本文将系统讲解 Set 去重的标准实践、内部机制以及应对引用类型的针对性方案。
一、基础类型数组去重:标准语法与具体步骤
ES6 引入了新的集合类型 Set,它类似于数组,但其内部每个值都是唯一的,不存在重复项。借助这一天生特性,对包含数字、字符串或布尔值的数组去重时,只需完成“数组转 Set”、“Set 自动剔除重复值”、“Set 转回数组”三个步骤。
1. 展开运算符方式(推荐)
展开运算符(Spread Syntax)语法最为简洁直观,是目前前端工程中最常见的写法:
// 示例 1:数字数组去重
const numbers = [1, 2, 3, 2, 4, 1, 5];
const uniqueNumbers = [...new Set(numbers)];
console.log(uniqueNumbers); // 输出: [1, 2, 3, 4, 5]

// 示例 2:字符串数组去重
const tags = ['js', 'css', 'html', 'js', 'vue', 'css'];
const uniqueTags = [...new Set(tags)];
console.log(uniqueTags); // 输出: ['js', 'css', 'html', 'vue']
2. Array.from() 静态方法方式
Array.from() 能够将任何可迭代对象(如 Set、Map、NodeList)转换为真正的普通数组。在需要兼顾兼容性或代码语义偏好时,这种写法同样十分标准:
const rawList = ['apple', 'orange', 'apple', 'banana'];
const uniqueList = Array.from(new Set(rawList));
console.log(uniqueList); // 输出: ['apple', 'orange', 'banana']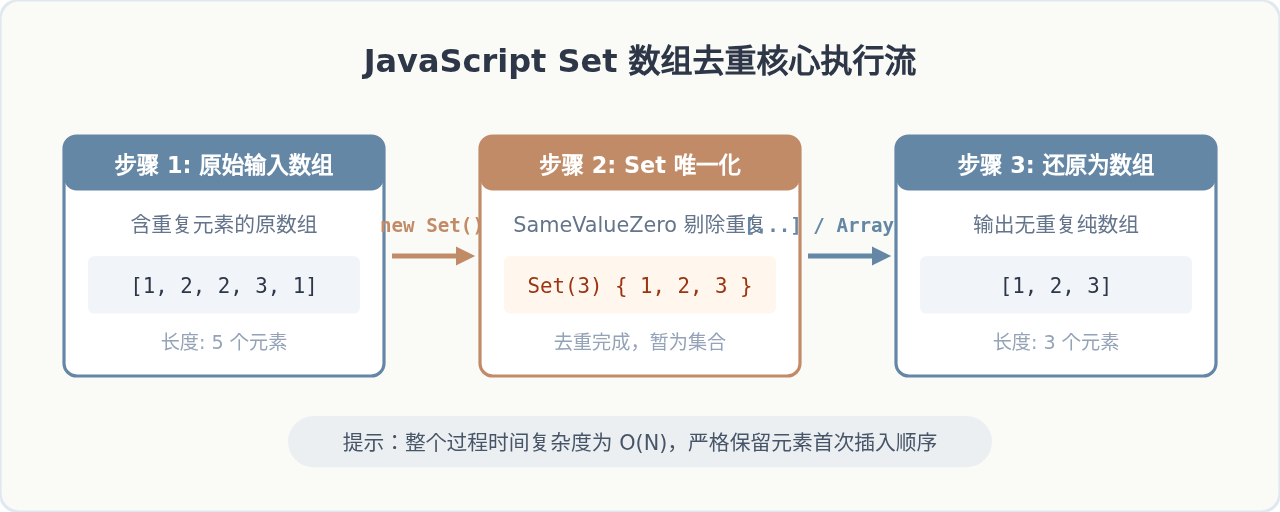
二、深入原理:Set 内部如何判定“重复”?
在日常开发中,我们常用严格相等运算符 === 判断两个变量是否相同。然而在 === 规则下,NaN === NaN 会返回 false。如果去重逻辑基于全等判断,那么数组中的多个 NaN 就会被错误保留。
ECMAScript 规范明确规定:Set 内部使用的是 SameValueZero 判等算法。
- 针对 NaN:
SameValueZero视NaN与NaN彼此相等。因此数组中的多个NaN会被正确去重,仅保留一个。 - 针对正负零:
+0与-0被视为完全相等。 - 针对基础类型(Number、String、Boolean、Symbol):直接比较实际存储的值。
// 验证特殊值去重表现
const specialValues = [NaN, 1, NaN, 0, -0, 'test', 'test', undefined, undefined, null, null];
const uniqueSpecial = [...new Set(specialValues)];

console.log(uniqueSpecial);
// 输出结果: [NaN, 1, 0, 'test', undefined, null]
// 说明: 两个 NaN 成功合并为一个,+0 与 -0 合并为 0,undefined 和 null 均正常去重
三、关键陷阱:为什么对象或数组(引用类型)去重会失效?
很多开发者在处理接口返回的对象列表时,习惯性写出 [...new Set(list)],却发现数据一条都没减少:
// 常见误区:对对象数组直接使用 Set
const users = [
  { id: 101, name: '张三' },
  { id: 101, name: '张三' }
];

const deduplicated = [...new Set(users)];
console.log(deduplicated.length); // 依然输出: 2!去重完全未生效!
之所以产生上述现象,根本原因在于 JavaScript 的内存分配机制:
- 基础数据类型:值直接保存在栈内存(Stack)中,判等时直接比对内容是否一致。
- 引用数据类型:变量在栈中存储的只是一个堆内存指针(Memory Address)。每次书写
{ id: 101, name: '张三' }字面量时,JavaScript 引擎都会在堆中开辟一块全新的独立空间。
Set 的 SameValueZero 算法在对比引用对象时,比较的是这两个对象的引用指针,而不是对象内部的键值属性。因为指针地址不同,Set 判定它们是两个不同的个体,从而完整保留。
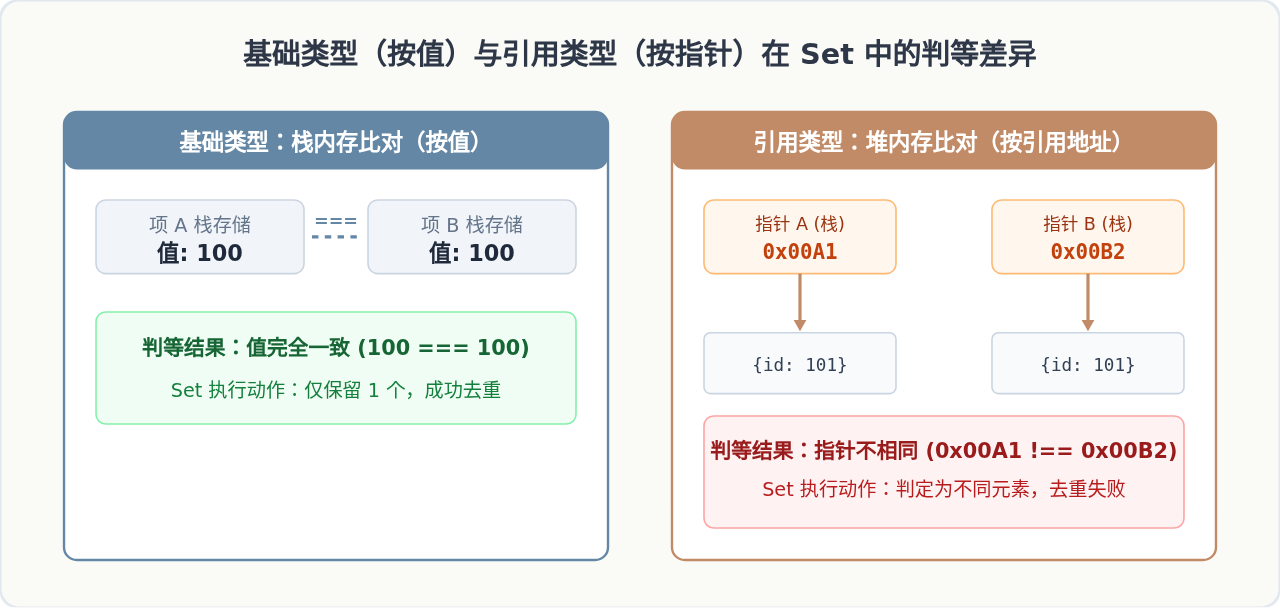
只有当多个元素指向同一个内存引用时,Set 才会生效。例如:const item = { id: 1 }; const arr = [item, item]; [...new Set(arr)];,此时结果长度为 1,因为两个元素存储的指针完全一致。
四、解决方案:对象数组(引用类型)去重的三种有效方法
针对包含引用类型的数组,不能直接调用 new Set(),需要依据具体的业务场景使用下列成熟方案:
方案 1:基于特定主键(如 id)去重 —— 使用 Map(最推荐)
业务开发中,绝大多数列表项都会拥有唯一的业务标识符(如 id、code、uuid)。此时利用 Map 保持键唯一的特性进行过滤,时间复杂度仅为 $O(N)$,兼顾极高执行效率与代码可读性:
function deduplicateByKey(arr, key) {
  const map = new Map();
  return arr.filter(item => {
    const val = item[key];
    if (!map.has(val)) {
      map.set(val, true);
      return true; // 首次出现,保留
    }
    return false; // 已存在相同 key,剔除
  });
}

// 示例应用
const list = [
  { id: 1, name: '北京' },
  { id: 2, name: '上海' },
  { id: 1, name: '北京分部' }
];

const result = deduplicateByKey(list, 'id');
console.log(result);
// 输出: [{ id: 1, name: '北京' }, { id: 2, name: '上海' }]
方案 2:全属性内容深度一致去重 —— JSON.stringify 辅助
如果对象没有显式的主键,且只要所有属性完全一致就视为同一项,可将对象序列化为 JSON 字符串后再使用 Set 判断:
function deduplicateByJSON(arr) {
  const seen = new Set();
  return arr.filter(item => {
    const serialized = JSON.stringify(item);
    if (seen.has(serialized)) {
      return false;
    }
    seen.add(serialized);
    return true;
  });
}

const list = [
  { x: 10, y: 20 },
  { x: 10, y: 20 },
  { x: 30, y: 40 }
];
console.log(deduplicateByJSON(list));
// 输出: [{ x: 10, y: 20 }, { x: 30, y: 40 }]
重要限制:JSON.stringify 对键的声明顺序敏感。例如 { a: 1, b: 2 } 序列化为 '{"a":1,"b":2}',而 { b: 2, a: 1 } 序列化为 '{"b":2,"a":1}',会导致本该相同的对象未被识别。此外,该方式无法处理对象内部包含 undefined、函数或正则的情况。
方案 3:复杂自定义条件去重 —— filter 结合 findIndex
对于没有主键且比对逻辑较为复杂(例如浮点数允许一定误差、多字段复合比较)的小规模数组,可直接使用 filter + findIndex:
const list = [
  { name: 'Tom', age: 20 },
  { name: 'Jerry', age: 18 },
  { name: 'Tom', age: 20 }
];

const uniqueList = list.filter((item, index, self) =>
  index === self.findIndex(t => t.name === item.name && t.age === item.age)
);
console.log(uniqueList);
// 输出: [{ name: 'Tom', age: 20 }, { name: 'Jerry', age: 18 }]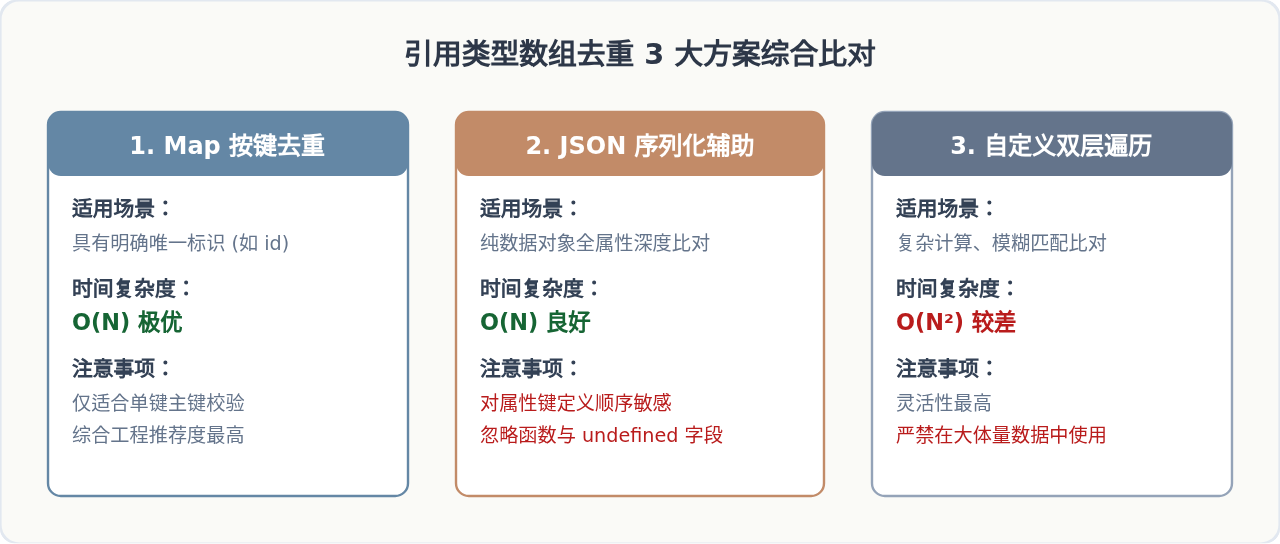
五、性能指标与决策指南
不同去重方式在数据规模扩大时的执行耗时差异非常巨大。下表展示了常见去重算法的核心特征:
| 实现方案 | 适用数据类型 | 时间复杂度 | 内存开销 | 优点与限制 |
|---|---|---|---|---|
[...new Set(arr)] |
基础类型(数字/字符串等) | $O(N)$ | 低 | 语法极简、性能极佳,但不支持普通对象内容去重 |
Map 按 Key 去重 |
对象数组(有主键) | $O(N)$ | 中 | 业务开发首选,稳定且快,依赖特定唯一属性 |
JSON.stringify + Set |
简单对象数组 | $O(N)$ | 中偏高 | 无需指定字段,但属性键乱序可能导致误判 |
filter + indexOf |
基础类型(旧方案) | $O(N^2)$ | 低 | ES5 兼容写法,元素超一万条时会明显卡顿 |
filter + findIndex |
对象数组 | $O(N^2)$ | 低 | 逻辑灵活,但面对大数据集性能断崖式下跌 |
六、高频疑问与细节总结
1. [...new Set(arr)] 与 Array.from(new Set(arr)) 性能有差异吗?
在主流的现代 JavaScript 引擎(如 V8)中,两者的执行性能基本在同一数量级。展开运算符在书写体验上更短更具现代感;而在处理特大数组或在早期的构建编译链中,Array.from() 在部分环境下的内存分配更为平稳。日常开发中可依个人或团队的代码规范自由选择。
2. Set 去重后会打乱原本的排列顺序吗?
不会。按照 ECMAScript 规范,Set 内部的遍历迭代严格按照元素的插入顺序(Insertion Order)进行。因此通过 Set 去重后,每个唯一元素保留的都是其在原数组中第一次出现时的相对次序。
3. 总结建议:
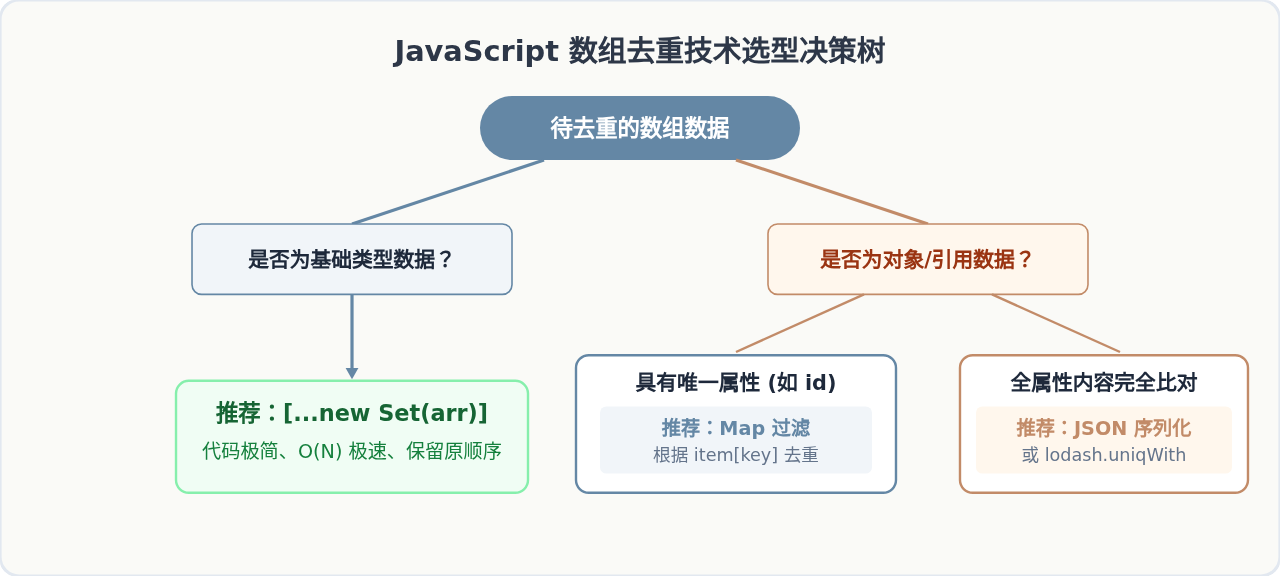
遇到数组去重需求时,第一步先明确数据元素是基础类型还是引用对象。如果是纯数值、文本数组,果断使用 [...new Set(arr)];如果涉及对象数组,优先寻找业务唯一字段并配合 Map 提取唯一项。只要理清了值存储与内存指针的区别,就能在各类业务场景中游刃有余地写出高效且无隐患的去重代码。
JavaScript怎么准确判断数据类型:typeof、instanceof与Object.prototype.toString
2026-11-05 17:09:21
JS中将数组和对象混合组装为JSON字符串
2026-11-05 16:41:42
JS运算符优先级与结合性的区别是什么?
2026-11-05 13:22:02
JS Map怎么只遍历Key或Value
2026-11-05 13:00:36
D3.js 与 ECharts 选型对比:灵活性 vs 开发效率
2026-11-05 09:45:01







