为什么两个相同内容的对象在JavaScript Set中不视为重复?
深入解析JavaScript中Set集合对对象的去重机制,剖析SameValueZero算法与堆内存引用地址的判定逻辑,并提供基于唯一键及深度内容的实用去重方案。
在 JavaScript 中,Set 集合使用语言规范定义的 SameValueZero 算法判定元素是否重复。当向 Set 中添加对象类型时,该算法比较的是对象在内存中的引用地址(Reference / Identity),而不是对象内部的属性键值对(Structural Value)。每次使用字面量语法创建新对象,即便结构和字段值完全相同,JavaScript 引擎也会在堆内存中为其开辟独立的存储空间;由于引用地址不同,Set 自然将它们作为互不相同的两项予以保留。
直观现象:相同的字面量与独立的集合项
初学 JavaScript 集合时,许多开发者常期望 Set 具备“内容深去重”能力。例如以下常见操作:
const userSet = new Set();

const userA = { id: 101, name: "Alice" };
const userB = { id: 101, name: "Alice" };

userSet.add(userA);
userSet.add(userB);

console.log(userSet.size); // 输出: 2
console.log(userA === userB); // 输出: false
控制台输出的结果是 2 而不是预想中的 1。此时若再声明一个变量指向已有引用,行为则截然不同:
const userC = userA;
userSet.add(userC);

console.log(userSet.size); // 输出依然是: 2
console.log(userA === userC); // 输出: true
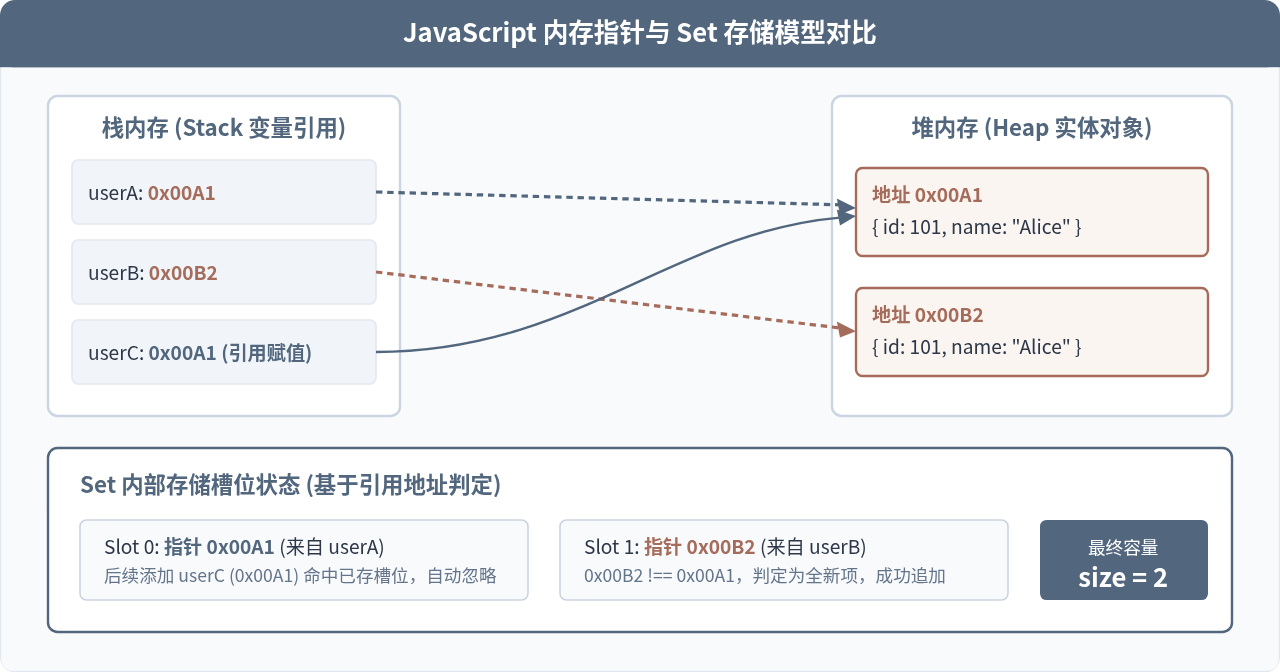
这一对比直接揭示了 Set 的内部判定边界:userC 与 userA 引用同一个内存实体,判定为同一元素并被忽略;而 userA 与 userB 是两个独立创建的实体,即使内部属性完全一致,依然会被共同存入集合中。
内存模型解析:栈指针与堆对象的映射机制
要透彻理解这一现象,需要回顾 JavaScript 的运行时内存模型。JavaScript 的数据类型分为原始类型(Primitive Types,如数字、字符串、布尔值等)和引用类型(Reference Types,即对象、数组、函数等)。
原始类型的值直接在栈内存中按值传递与比较;而引用类型的实际内容存储在堆内存(Heap)中,栈内存中保存的仅仅是一个指向堆内存起始位置的指针地址。
- 字面量求值即分配:每次代码执行到
{ ... }字面量表达式时,JavaScript 引擎都会执行一次对象分配操作,在堆中分配一块新的地址(如0x00A1与0x00B2)。 - 变量保存的是引用:变量
userA存储的是0x00A1,变量userB存储的是0x00B2。 - Set 中存储的也是引用:向
Set存入对象时,集合内部哈希表槽位登记的是该指针地址,而非对象的深层属性复制。
规范底层:SameValueZero 算法的判定逻辑
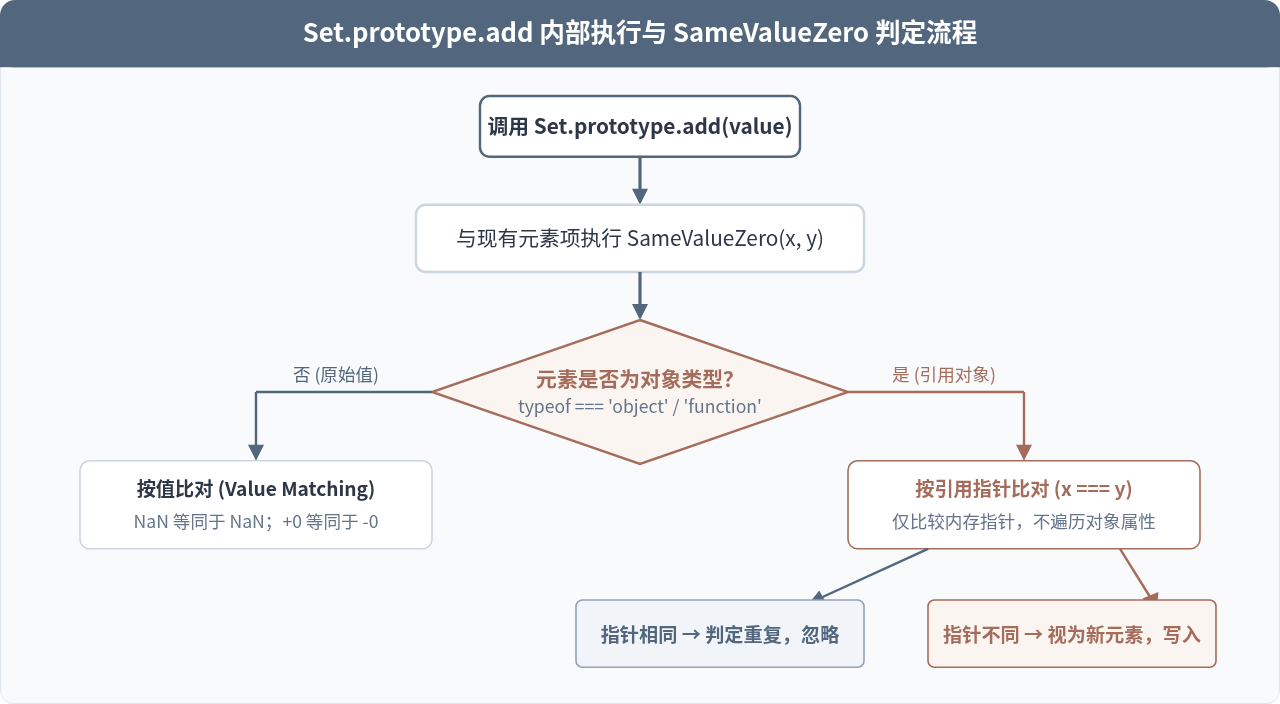
ECMAScript 规范对 Set.prototype.add(value) 与 Set.prototype.has(value) 的等价性比较作出了严格界定:使用的并非普通严格相等 ===(Strict Equality),而是 SameValueZero 算法。
SameValueZero 与严格相等(===)的微小差异
在比较大多数值时,SameValueZero 与 === 的表现完全一致,唯一的关键区别在于对 NaN 的认定:
- 在严格相等
===中:NaN === NaN返回false。若Set采用===,则每次添加NaN都会被视作新元素。 - 在
SameValueZero中:NaN与NaN判定为相等(即视为重复)。+0与-0也被判定为相等。 - 对于对象类型(Object):若两者的类型均为
Object,算法直接比较两者的指针引用。如果引用不相同,直接返回false。
为什么语言标准不默认支持对象的“结构深度比较”?
了解这一机制后,读者可能会自然产生疑问:为什么 JavaScript 官方不在 Set 中直接加入深层属性对比,使内容相同的对象自动去重?这主要出于三项核心工程与架构考量:
- 时间复杂度不可控:哈希集合(Hash Set)的核心价值在于近乎 \(O(1)\) 的增删查改性能。若每次添加对象都要递归遍历所有嵌套属性,比较成本将陡增至 \(O(K)\)(\(K\) 为对象节点总数),若集合包含大量复杂对象,整体插入性能将严重恶化。
- 循环引用与原型链歧义:JavaScript 对象支持复杂的原型链继承,属性可能存在循环引用(
obj.self = obj)或者由 Getter 动态计算。默认深比较极易引发栈溢出或非预期的副作用。 - 缺乏通用 HashCode 协议:在 Java 或 C# 等语言中,对象实现自定义去重依赖配对的
equals()与hashCode()方法。而 JavaScript 原生并未提供统一的对象哈希计算钩子,引擎无法在恒定时间内为任意动态对象生成唯一哈希标识。
实际开发中的对象去重方案
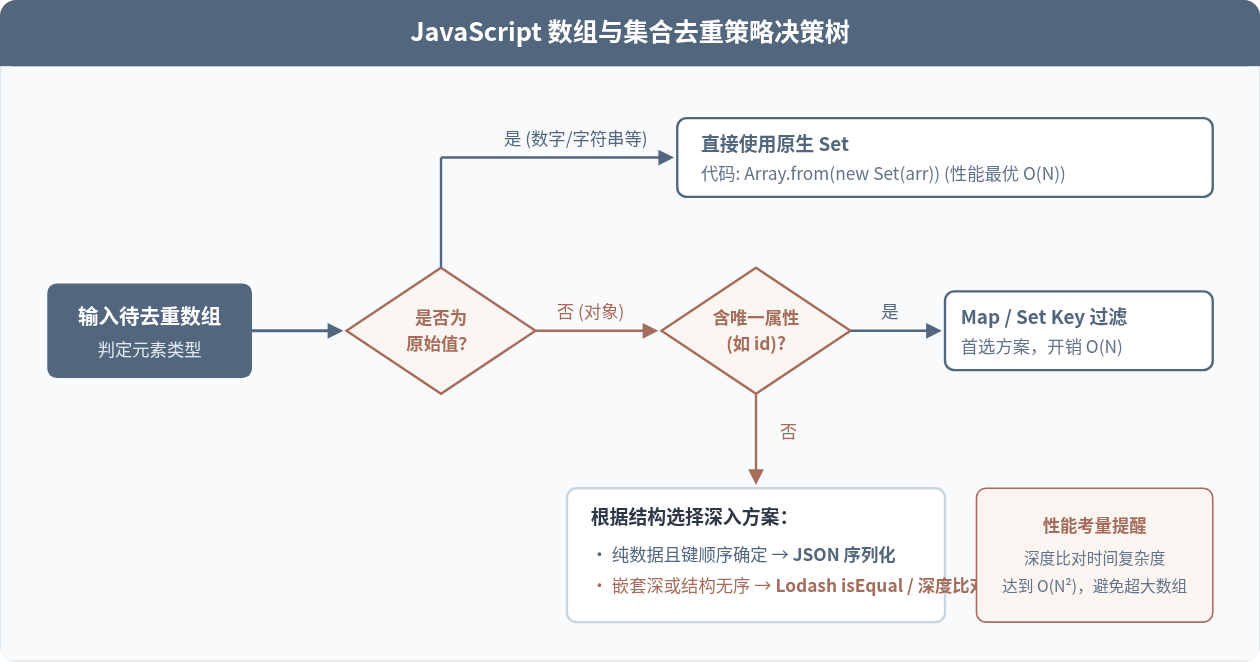
在实际业务开发中,处理对象数组去重是高频需求。既然原生 Set 无法直接按内容去重,我们应该如何针对不同场景设计解决方案?
方案一:按业务唯一标识(Key)过滤(推荐首选)
大部分业务实体(如用户、订单、商品)都具备全局唯一主键(如 id 或 code)。利用 ES6 的 Map 或辅助 Set 记录已处理键,能够在保证 \(O(N)\) 线性性能的同时准确完成去重。
/**
 * 依据指定属性对对象数组进行高效去重
 * @param {Array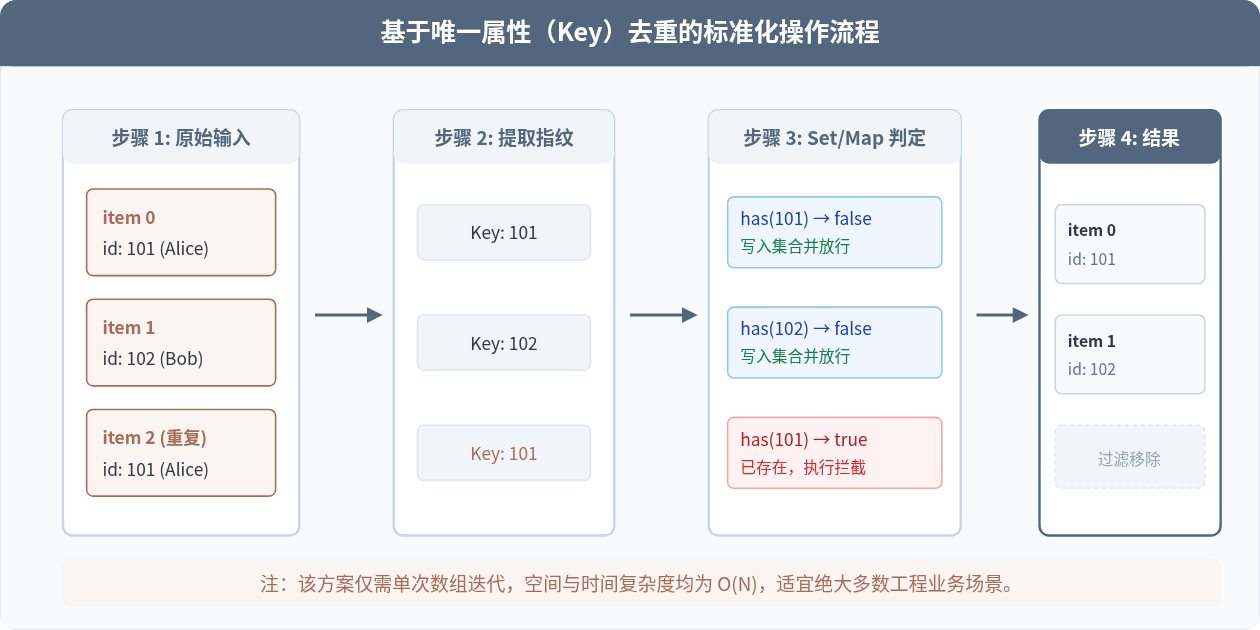
方案二:基于 JSON 序列化去重(轻量纯数据对象)
当对象没有特定主键,且结构扁平、只包含常规字符串与数值时,可通过 JSON.stringify 将整个对象映射为字符串基元,再利用 Set 对字符串去重:
function deduplicateByJSON(array) {
  const jsonSet = new Set();
  const result = [];

  for (const item of array) {
    // 基础序列化转换
    const str = JSON.stringify(item);
    if (!jsonSet.has(str)) {
      jsonSet.add(str);
      result.push(item);
    }
  }
  return result;
}- 属性顺序敏感性:
JSON.stringify({ a: 1, b: 2 })产生'{"a":1,"b":2}',而JSON.stringify({ b: 2, a: 1 })产生'{"b":2,"a":1}',键顺序不同会导致去重失败。 - 类型丢失与忽略:
JSON.stringify会自动丢弃undefined、函数(Function)与Symbol属性,并将Date对象转为 ISO 字符串。 - 循环引用崩溃:如果对象结构包含自引用,调用
JSON.stringify会直接抛出TypeError: Converting circular structure to JSON。
去重技术选型总结
根据数据的复杂度与业务场景,开发者应选择相匹配的去重策略:
| 方案分类 | 实现机制 | 时间复杂度 | 最佳适用场景 | 主要局限 |
|---|---|---|---|---|
| 原生 new Set(arr) | SameValueZero 引用比对 |
\(O(N)\) | 原始类型(字符串、数字)或同引用去重 | 无法对不同引用的同内容对象去重 |
| 键值索引过滤 (Map/Set) | 提取 id 或唯一 key 判重 |
\(O(N)\) | 绝大多数业务数据(接口列表、数据库实体) | 要求对象必须具备可靠的唯一标识键 |
| 序列化去重 (JSON) | 全属性转字符串后入 Set | \(O(N \times K)\) | 简单纯数据配置项、无唯一键的小型对象 | 属性排序敏感、不支持函数/undefined/循环引用 |
| 深度遍历比对 (Deep Equal) | 递归逐层对比键与值 | \(O(N^2 \times K)\) | 复杂嵌套结构、严格要求内容等价且规模较小 | 计算开销大,在大型列表下容易引起页面卡顿 |
结语
JavaScript Set 不对内容相同的对象去重,本质上是语言底层对性能、类型语义与内存架构权衡后的设计选择。Set 承担的是基于快速哈希表的“引用身份”判定职责,而非成本高昂的“结构内容”推导。理解这一机制,不仅有助于避开开发中常见的重复数据排查误区,更能让开发者在面对不同业务数据时,选用恰当的数据结构与去重策略。
什么时候该用JS构造器:与工厂模式、字面量的选择对比
2026-11-05 16:18:22
推荐几款轻量级JS照片墙开源库及对比
2026-11-05 15:56:19
JavaScript递归写法有哪些常见陷阱及避免方法
2026-11-05 14:53:38
JS数组浅拷贝与深拷贝怎么选?场景与方法总结
2026-11-05 14:41:02
p5.js 中 setup() 和 draw() 函数的执行机制详解
2026-11-05 12:32:38