

JS字符串转数组遍历:split('')与[...str]的区别
深入解析JavaScript中字符串转数组遍历时split('')与[...str]的核心区别。从UTF-16代码单元到Unicode代码点迭代器的底层原理,结合生僻字、Emoji乱码、字符串反转与性能基准,提供完整的技术细节与选型指南。
将 JavaScript 字符串转换为数组进行逐字处理,str.split('') 与展开运算符 [...str] 是开发者最常接触的两种写法。尽管它们在纯英文与数字场景下的输出看似一致,但底层的拆分依据存在本质差异:split('') 依赖于底层的 16 位 UTF-16 代码单元(Code Unit)进行机械截断;而 [...str] 则调用字符串的原生迭代器 Symbol.iterator,以 Unicode 代码点(Code Point) 为单位进行语法展开。这一机制差异直接决定了程序在面对 Emoji 表情、生僻字、多语言字符以及字符串反转时的可靠性。
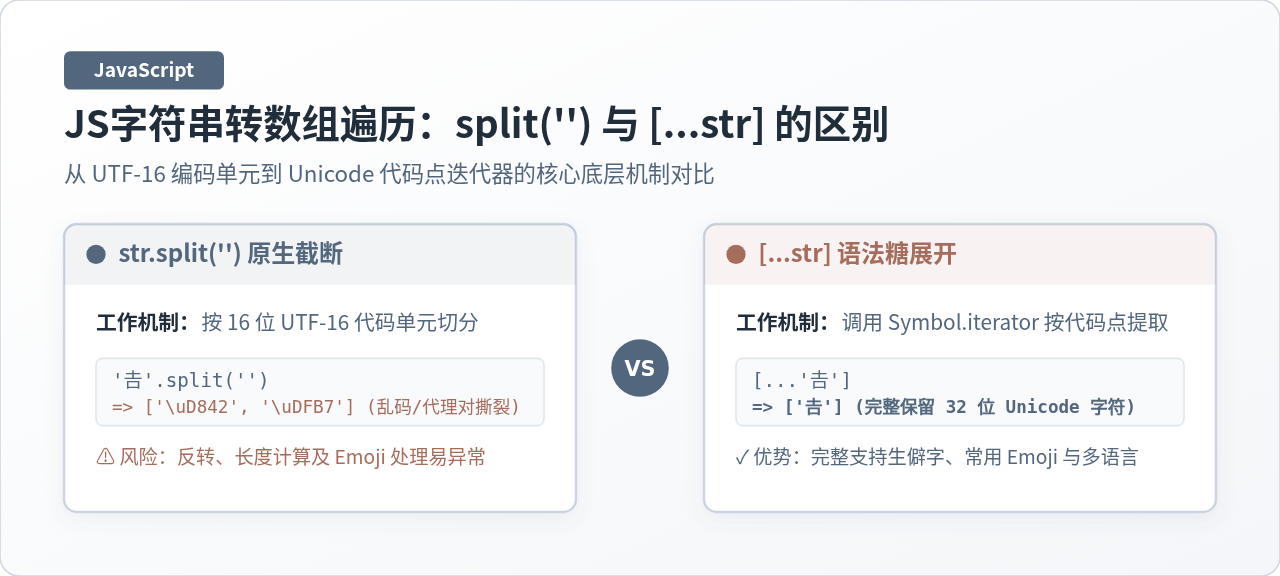
一、核心根源:UTF-16 代码单元与 Unicode 代码点
要透彻理解两者的差异,必须先厘清 JavaScript 字符串的内存表示机制。根据 ECMAScript 规范,JavaScript 字符串内部由一系列 16 位整数(即 UTF-16 编码单元)构成。
Unicode 字符集为全世界所有文字与符号赋予了唯一的编号,称为代码点(Code Point),范围从 U+0000 到 U+10FFFF:
- 基本多语言平面(BMP,U+0000 ~ U+FFFF):覆盖了 ASCII、常用汉字(如“中”、“国”)及多数常用文字。这些字符的码点小于等于 0xFFFF,在 UTF-16 中刚好占用 1 个 16 位代码单元(2 字节)。
- 增补多语言平面(SMP/SIP,U+010000 ~ U+10FFFF):包含现代 Emoji(如
🚀、🎉、👍)、古代文字以及中日韩统一表意文字扩展区汉字(如“𠮷”U+20BB7)。由于 16 位无法容纳超过 0xFFFF 的数值,UTF-16 采用代理对(Surrogate Pair)机制,使用两个连续的 16 位代码单元(高位代理0xD800~0xDBFF与低位代理0xDC00~0xDFFF)联合表示一个完整的字符。
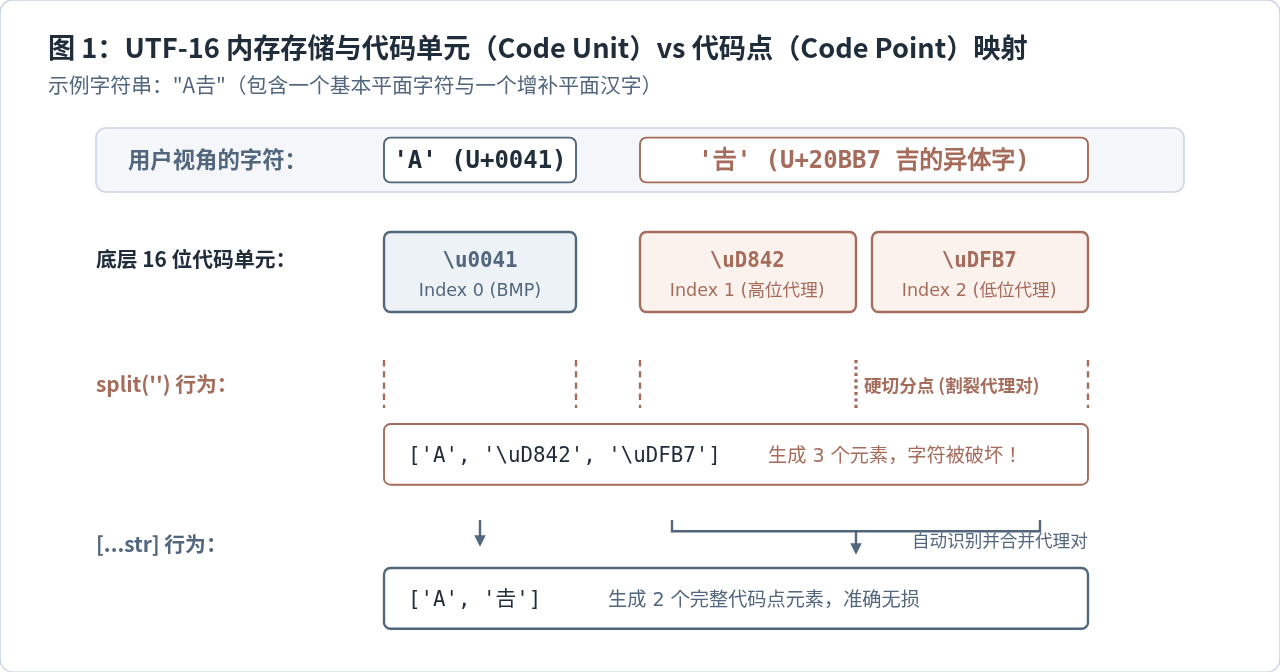
当调用 str.split('') 时,引擎在 C++ 底层按照字符串的 length 属性(本质是代码单元数)逐一截断,它并不关心这两个相邻的代码单元是否组合为一个完整的字。对于增补平面的字符,split('') 会直接把高位代理和低位代理撕成两个孤立的畸形单元。
相反,ES6 引入的 [...str] 是基于迭代协议实现的。当对字符串展开时,会默认调用 String.prototype[Symbol.iterator]。该迭代器具备对 UTF-16 代理对的感知能力:一旦扫描到高位代理,就会自动绑定紧邻的低位代理,合成为一个包含完整 Unicode 代码点的单字字符串输出。
二、推导与执行步骤:两者的内部流转流程
为了直观展现两者在运行时的步骤差异,我们以包含增补平面汉字的字符串 const str = "A𠮷B"; 为例,逐步跟踪引擎的内部处理路径。
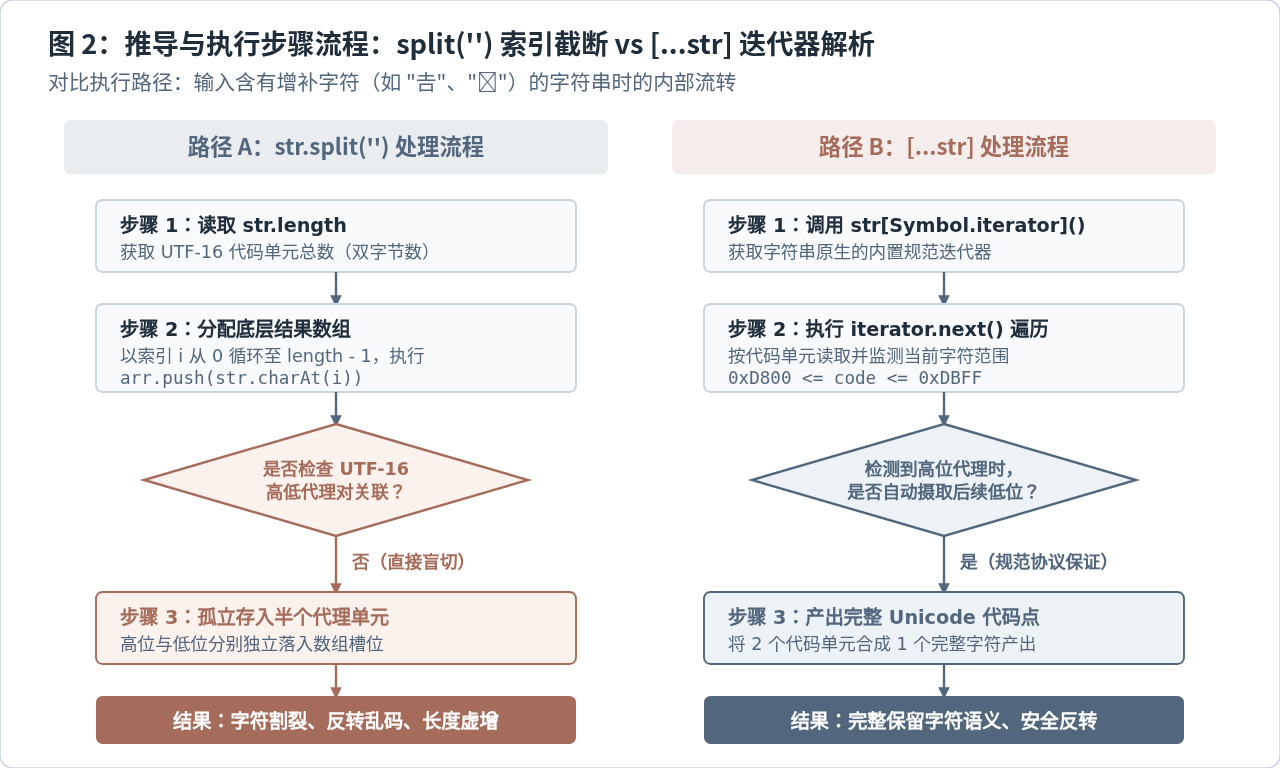
1. split('') 的处理步骤
- 读取长度:引擎查询
str.length。由于 'A' 占 1 个单元,'𠮷' 占 2 个代理单元,'B' 占 1 个单元,计算得到长度为4。 - 开辟数组:分配可容纳 4 个元素的连续内存数组。
- 循环截取:通过索引从 0 遍历到 3,分别调用
charAt(i)填入数组:- 索引 0:
'A'(U+0041) - 索引 1:
'\uD842'(孤立的高位代理) - 索引 2:
'\uDFB7'(孤立的低位代理) - 索引 3:
'B'(U+0042)
- 索引 0:
- 产生结果:返回数组
['A', '\uD842', '\uDFB7', 'B'],长度为 4。“𠮷”字被破坏。
2. [...str] 的处理步骤
- 启动迭代器:执行
str[Symbol.iterator]()创建字符串迭代上下文。 - 首轮遍历:读取第一个单元
0x0041,判断其在 BMP 范围内,产出{ value: 'A', done: false }。 - 代理对合成:读取下一个单元
0xD842,发现落入高位代理区间(0xD800 ~ 0xDBFF),迭代器随即向前预读紧邻单元0xDFB7(合法的低位代理),将两者合并为一个完整的码点字符串'𠮷',产出{ value: '𠮷', done: false }。 - 后续遍历:读取
0x0042,产出{ value: 'B', done: false };检测到末尾,返回{ done: true }。 - 收集结果:展开运算符将产出值收集为数组
['A', '𠮷', 'B'],长度为 3,与人类直觉完全吻合。
三、实战陷阱与代码对比验证
在实际生产环境中,盲目使用 split('') 会导致一系列隐蔽且难以排查的 Bug。下面通过具体的代码场景验证两者的表现。
陷阱 1:字符串反转(Reverse)
初学者常使用 str.split('').reverse().join('') 来反转字符串。当遇到 Emoji 或生僻字时,灾难便发生了:
// 示例 1:包含 Emoji 的反转
const text = "hi🚀";

// 使用 split('') 反转
const broken = text.split('').reverse().join('');
console.log(broken);
// 示例输出: "ih\uDE80\uD83D" (控制台显示为乱码或问号菱形)

// 使用 [...str] 反转
const correct = [...text].reverse().join('');
console.log(correct);
// 示例输出: "🚀ih" (正确保持表情完整)🚀 由高位代理 \uD83D 和低位代理 \uDE80 组成。split('') 将其打散为 ['\uD83D', '\uDE80'],反转后变成了 ['\uDE80', '\uD83D']。低位在前、高位在后构成了非法的 Unicode 序列,渲染引擎无法识别,只得显示为乱码字符 陷阱 2:用户输入长度校验与截字
许多表单限制用户输入“最多 10 个字”,如果使用 str.split('').length 或 str.length,会导致包含生僻字姓名或 Emoji 的正常文本被误判超长:
// 示例 2:字数统计
const name = "张𠮷";

console.log(name.split('').length); // 示例输出: 3 (误判为3个字符)
console.log([...name].length);       // 示例输出: 2 (符合实际字符数)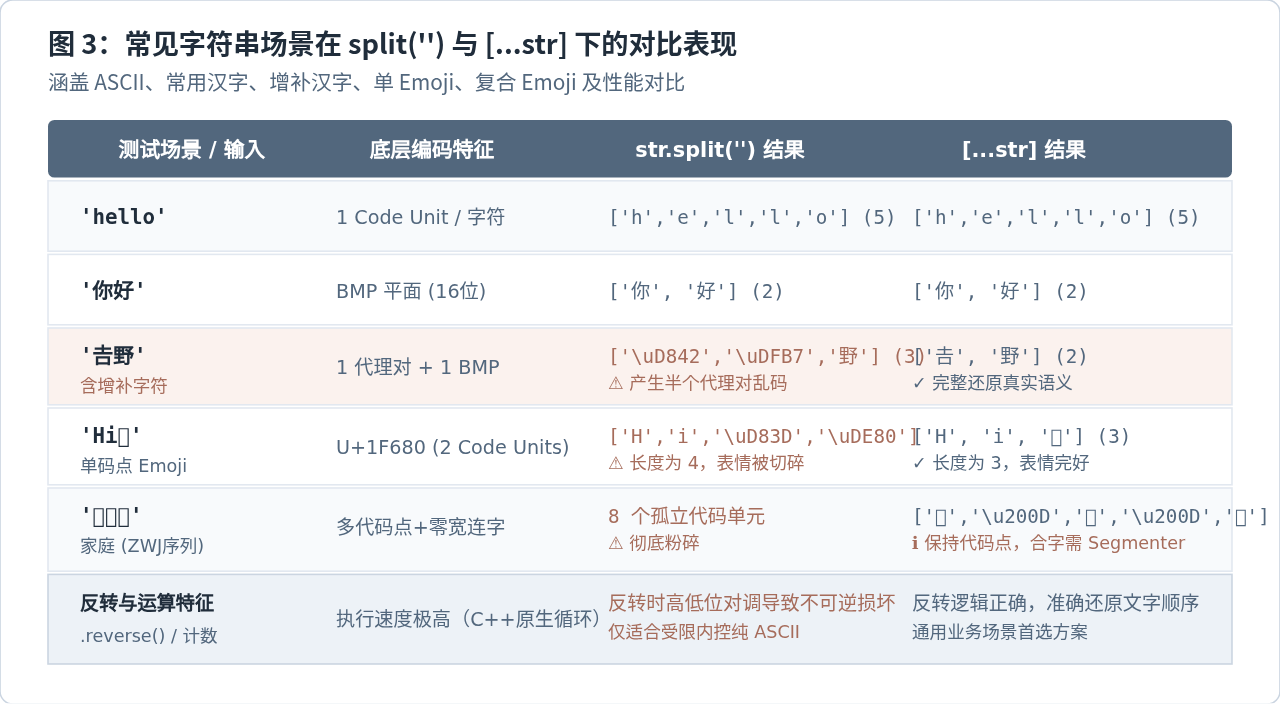
四、进阶延伸:复合 Emoji 与 Intl.Segmenter
读者需要特别注意:[...str] 解决了Unicode 代码点(Code Point)级别的切分问题,但这并不等同于解决了所有“视觉字符”问题。现代 Unicode 规范中存在由多个代码点组成的字素簇(Grapheme Cluster):
- 带肤色修饰的 Emoji:例如
👍🏽是由“大拇指朝上”码点(U+1F44D)和“中等偏深肤色”码点(U+1F3FD)拼接而成的。 - 零宽连字序列(ZWJ):例如家庭表情
👨👩👧,是由父亲、ZWJ(\u200D)、母亲、ZWJ、女儿等 5 个代码点联合渲染的单一图标。
// 示例 3:复合 Emoji 在 [...str] 下的行为
const family = "👨👩👧";
console.log(family.split('').length); // 示例输出: 8 (完全破碎)
console.log([...family].length); // 示例输出: 5 (保留独立码点,但视觉上仍拆散了家庭)
// 现代规范标准解法:Intl.Segmenter (按字素分词)
const segmenter = new Intl.Segmenter('zh', { granularity: 'grapheme' });
const graphemes = Array.from(segmenter.segment(family), s => s.segment);
console.log(graphemes); // 示例输出: ['👨👩👧'] (长度为 1,完美吻合人类视觉认知)[...str] 已足以涵盖 99% 的场景;若业务涉及头像昵称提取、精细文本光标移动或复杂国际化排版,应优先引入标准的 Intl.Segmenter。
五、性能与内存权衡
既然 [...str] 正确性更高,split('') 是否一无是处?答案是否定的。两者的底层性能模型不同:
split('')的速度优势:在 V8 引擎中,split('')拥有极其成熟的 C++ 内部快速路径(Fast Path)。对于纯 Latin-1/ASCII 构成的超大字符串,它无需实例化 JavaScript 迭代器对象,直接在原生堆上申请数组并完成定长内存拷贝,吞吐量通常显著高于展开语法。[...str]的开销来源:展开运算符每次遍历都需要通过原型链访问Symbol.iterator,维护迭代器状态并在每一步进行边界判断,生成迭代器结果对象。在循环数百万次的微基准测试中,其耗时可能达到split('')的 2 到 3 倍。
然而,在真实的日常业务代码中,这种毫秒级别的微观性能差异几乎可以忽略不计。在软件工程实践中,语义正确性永远高于盲目的微基准优化。在未能严格保证输入源百分之百为纯 ASCII 的情况下,使用 split('') 是极具风险的过早优化。
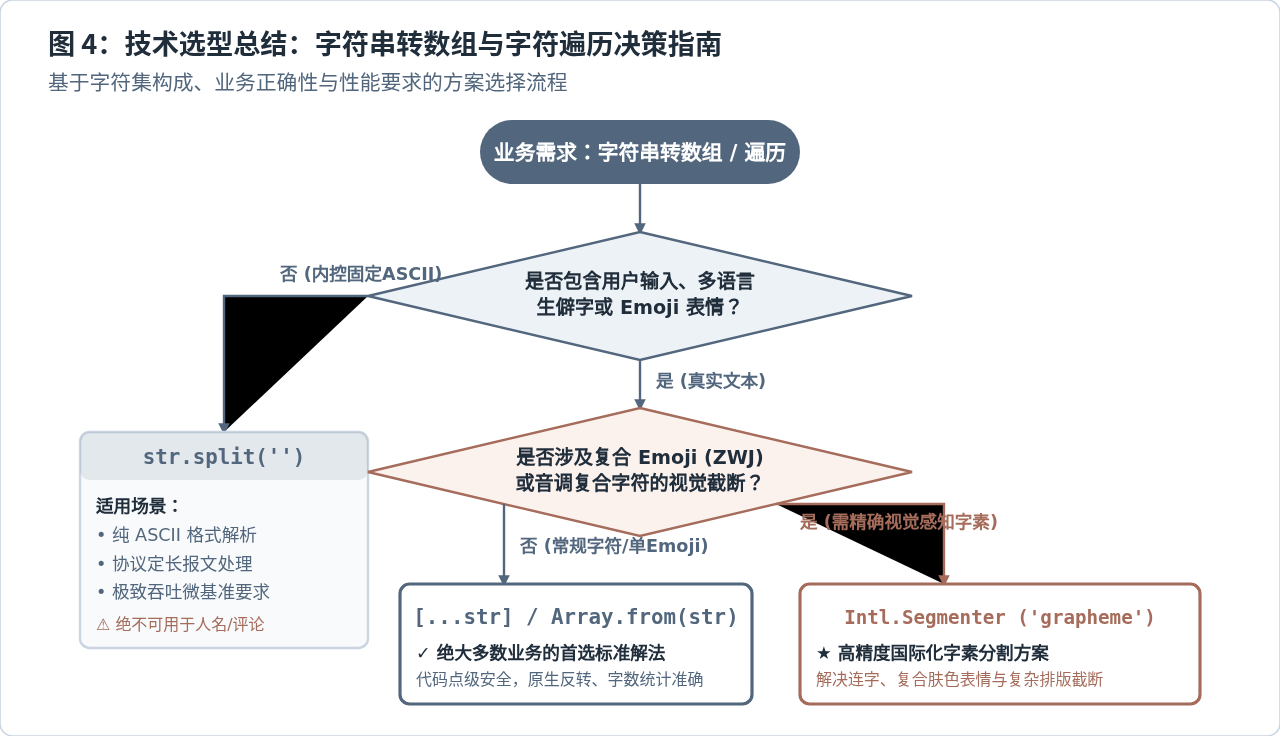
六、总结与选型建议
为了在实际开发中做出清晰、规范的架构决策,可参考以下选型规则:
| 技术方案 | 底层切分依据 | Unicode 兼容性 | 适用场景与推荐建议 |
|---|---|---|---|
[...str] 或 Array.from(str) |
Unicode 代码点(Code Point) | 优秀(完整兼容代理对与单 Emoji) | 【日常推荐】常规业务首选方案。适用于字符串反转、字数统计、逐字遍历及用户输入处理。 |
str.split('') |
16 位 UTF-16 代码单元(Code Unit) | 较差(遇增补字符即撕裂) | 【仅限内控场景】仅用于内部协议格式化、固定十六进制串解析、纯 ASCII 数据处理等追求极端微观性能的地方。 |
Intl.Segmenter |
用户感知字素簇(Grapheme Cluster) | 完美(完整支持 ZWJ 与复合修饰符) | 【高精度场景】国际化文本排版、富文本编辑器、复合 Emoji 截断与首字母头像生成等严格视觉对齐需求。 |
归结为一句话:只要处理的内容可能面对真实人类文字与 Emoji,一律优先使用 [...str];如果需要严格对应屏幕上看到的“一个字符”,请使用 Intl.Segmenter。
JS回调函数怎么写:从同步传参到异步执行的代码示例
2026-11-22 17:05:07
怎么避免JS原型继承中的引用类型属性共享问题
2026-11-22 15:46:54
SheetJS导出Excel时怎么保留前端表格合并结构
2026-11-22 15:29:28
Dreamweaver可以写JavaScript吗?代码提示与调试支持详解
2026-11-22 14:26:36
JavaScript遍历数组的常用方法:for、forEach与for...of对比
2026-11-22 13:12:35







