

JavaScript遍历数组的常用方法:for、forEach与for...of对比
深入对比JavaScript中遍历数组的三种常用方法:经典for循环、Array.prototype.forEach与for...of。全面解析三者的核心机制、break/continue控制流、异步async/await支持及选型依据。
for 循环、原型上的 forEach 方法以及 ES6 引入的 for...of 语句,究竟各有什么本质不同?本文将从底层机制、控制流支持(break / continue / return)、异步时序(async/await)以及稀疏数组处理等维度进行横向对比,给出清晰的边界分析与场景选型指南。
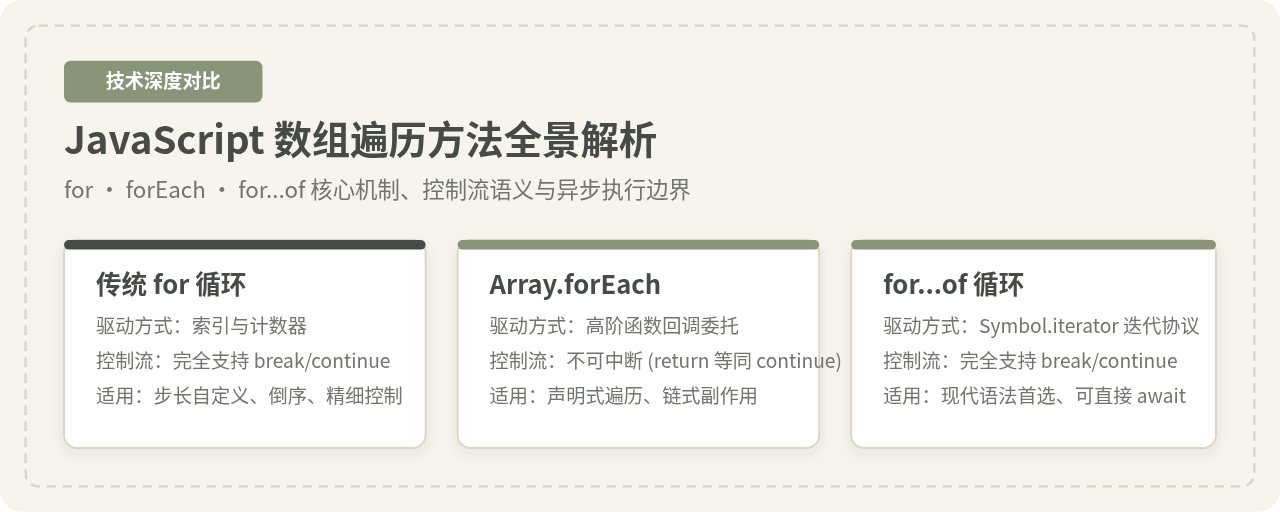
一、三种遍历方法的核心机制与基本语法
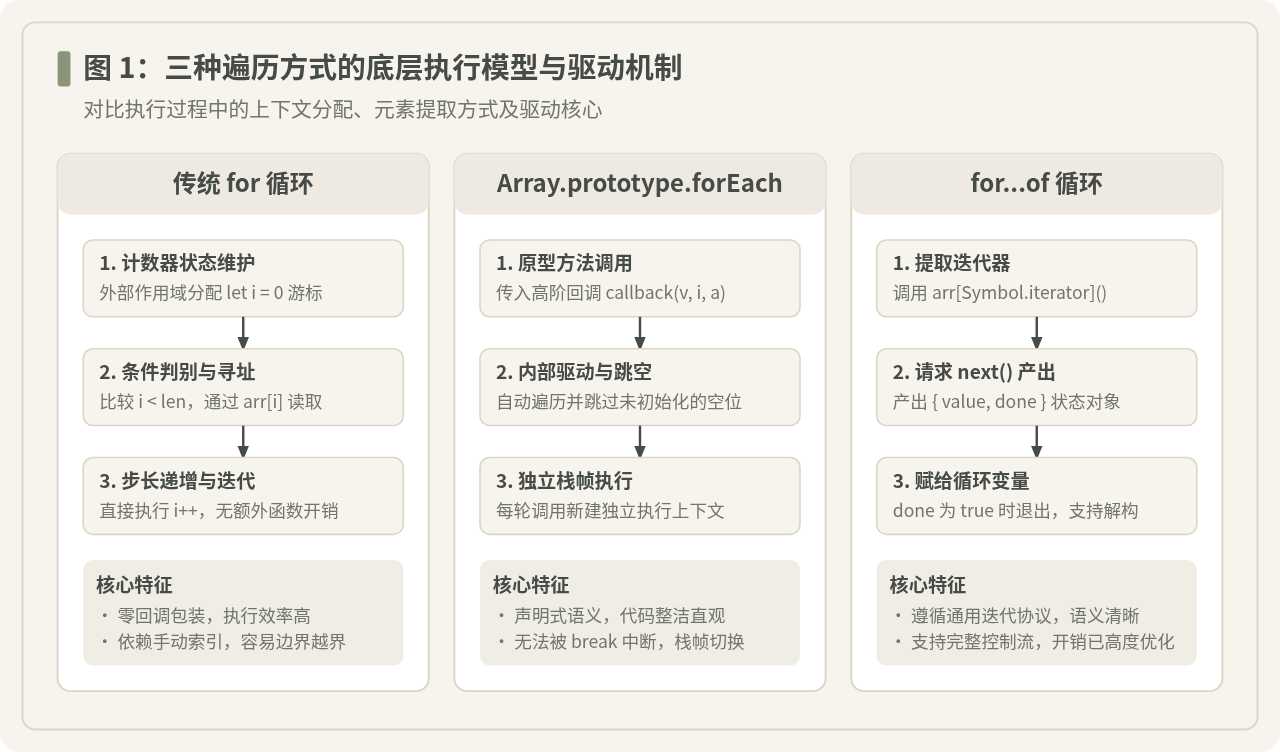
虽然三种方式最终都能逐一访问数组元素,但它们的底层执行模型与驱动机制完全不同。理解这一底层差异,是掌握后续所有特性与边界的基础。
1. 经典 for 循环:基于索引与计数器的精细控制
传统的 for 循环是命令式编程的代表。它在当前代码作用域中显式声明并维护一个计数器变量(通常为 i),通过步长递增条件与下标索引来按需寻址访问:
// 示例:传统 for 循环遍历
const fruits = ['苹果', '香蕉', '橙子'];

for (let i = 0; i < fruits.length; i++) {
  console.log(`索引 ${i}: ${fruits[i]}`);
}
// 输出示例:
// 索引 0: 苹果
// 索引 1: 香蕉
// 索引 2: 橙子
这种方式没有任何额外的函数调用包装,由 JavaScript 引擎直接执行循环步进。它的优势在于控制力极强,支持倒序遍历、跨步长访问(如 i += 2)以及随时按需修改游标。
2. Array.prototype.forEach:基于高阶函数的回调委托
forEach 是 ES5 引入的数组原生实例方法,属于声明式(函数式)风格。它接收一个回调函数,数组在内部自动将每个元素、索引以及数组自身作为参数依次传入回调:
// 示例:forEach 遍历
const fruits = ['苹果', '香蕉', '橙子'];

fruits.forEach((item, index) => {
  console.log(`索引 ${index}: ${item}`);
});
forEach 省去了手动管理索引和越界风险的负担,写法整洁。但关键在于:每一次循环本质上都是一次独立的函数调用,每轮迭代都会压入新的调用栈帧。
3. for...of 循环:基于可迭代协议(Iterable Protocol)的语义抽象
ES6 引入了统一的可迭代协议。只要对象实现了 [Symbol.iterator] 接口,就可以通过 for...of 进行遍历。数组天然内置了该接口:
// 示例:for...of 遍历
const fruits = ['苹果', '香蕉', '橙子'];

for (const item of fruits) {
  console.log(`当前元素: ${item}`);
}

// 如需同时获取索引与元素,可配合 entries() 解构:
for (const [index, item] of fruits.entries()) {
  console.log(`解构索引 ${index}: ${item}`);
}
for...of 将关注点直接聚焦在“元素值”本身,语法语义极其纯粹,而且具备与普通代码块完全一致的执行上下文,兼顾了函数式的优雅与命令式控制流的完整能力。
二、控制流差异:break、continue 与 return
在实际业务逻辑中,我们经常需要在满足特定条件时提前终止遍历(搜索查找)或跳过某些无效数据(数据过滤)。这是三种遍历方式差异最显著、也是最容易写出 Bug 的环节。
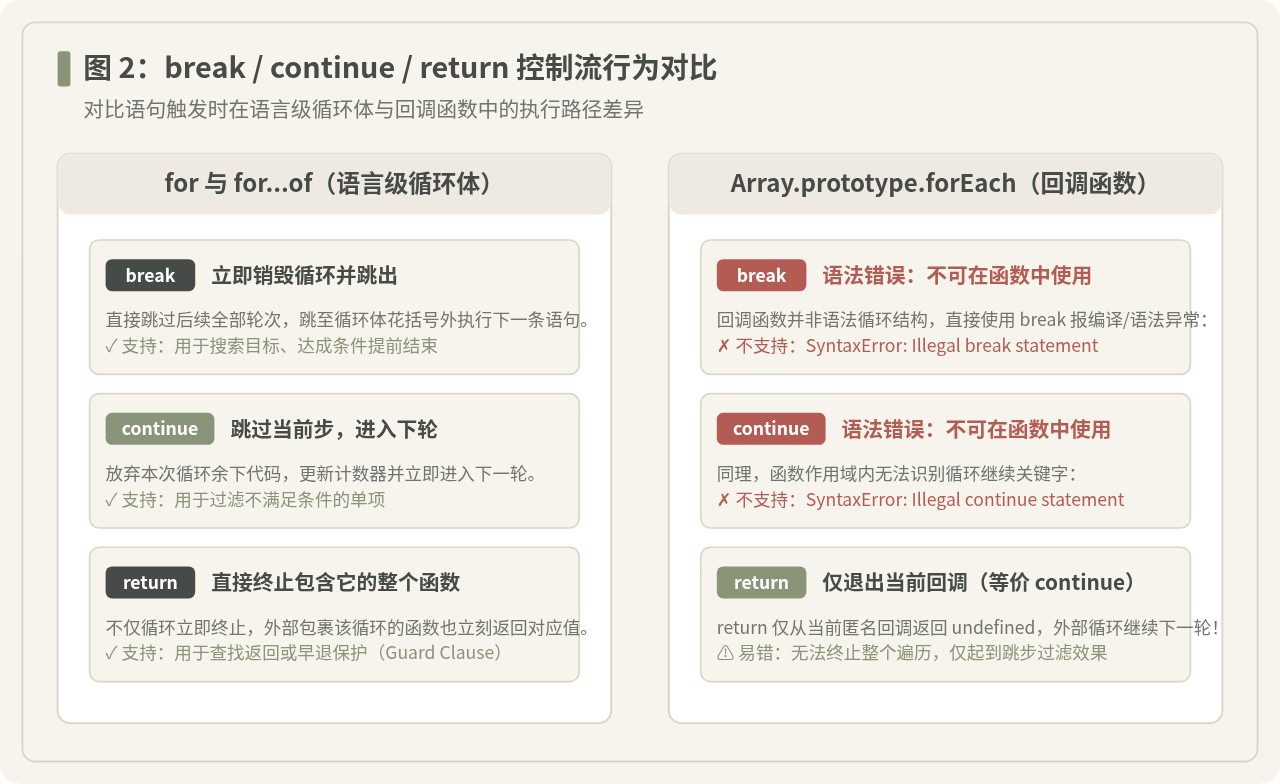
1. break 与 continue 的支持情况
for 循环与 for...of 循环都是语言级的原生循环结构,原生完全支持 break(彻底跳出循环)与 continue(跳过当前步直接进入下一轮)。
然而在 forEach 的回调函数中直接使用 break 或 continue,会导致代码抛出语法错误:
// 错误示例:在 forEach 中使用 break
const numbers = [10, 20, 30, 40];

numbers.forEach(num => {
  if (num === 30) {
    // SyntaxError: Illegal break statement
    // break;
  }
});
之所以会抛出 SyntaxError,是因为 break 语法只允许存在于循环语句或 switch 语句的直接代码块中。在 forEach 内部,你的代码位于一个独立的 JavaScript 函数体内,词法上并不属于循环体。
2. return 语句的语义陷阱
很多开发者在发现 forEach 不能用 break 后,会下意识地尝试用 return 来终止遍历。但这会导致隐蔽的逻辑偏差:
// 陷阱示例:试图用 return 跳出 forEach
const numbers = [1, 2, 3, 4, 5];

numbers.forEach(num => {
  if (num === 3) {
    return; // 本意想在此彻底结束遍历
  }
  console.log(`执行: ${num}`);
});

// 实际输出结果:
// 执行: 1
// 执行: 2
// 执行: 4
// 执行: 5
从输出可以看出,return 仅仅退出了当前这个匿名回调函数(返回 undefined),而 forEach 内部依然会毫不留情地继续触发后续元素的处理。换言之,在 forEach 中使用 return,效果完全等价于 continue,根本起不到 break 的作用。
三、异步操作陷阱:async / await 下的执行时序
现代前端与 Node.js 业务重度依赖异步请求。当数组中的每个元素都需要发起异步操作(如查询数据库、请求接口)时,不同遍历方式的行为天差地别。
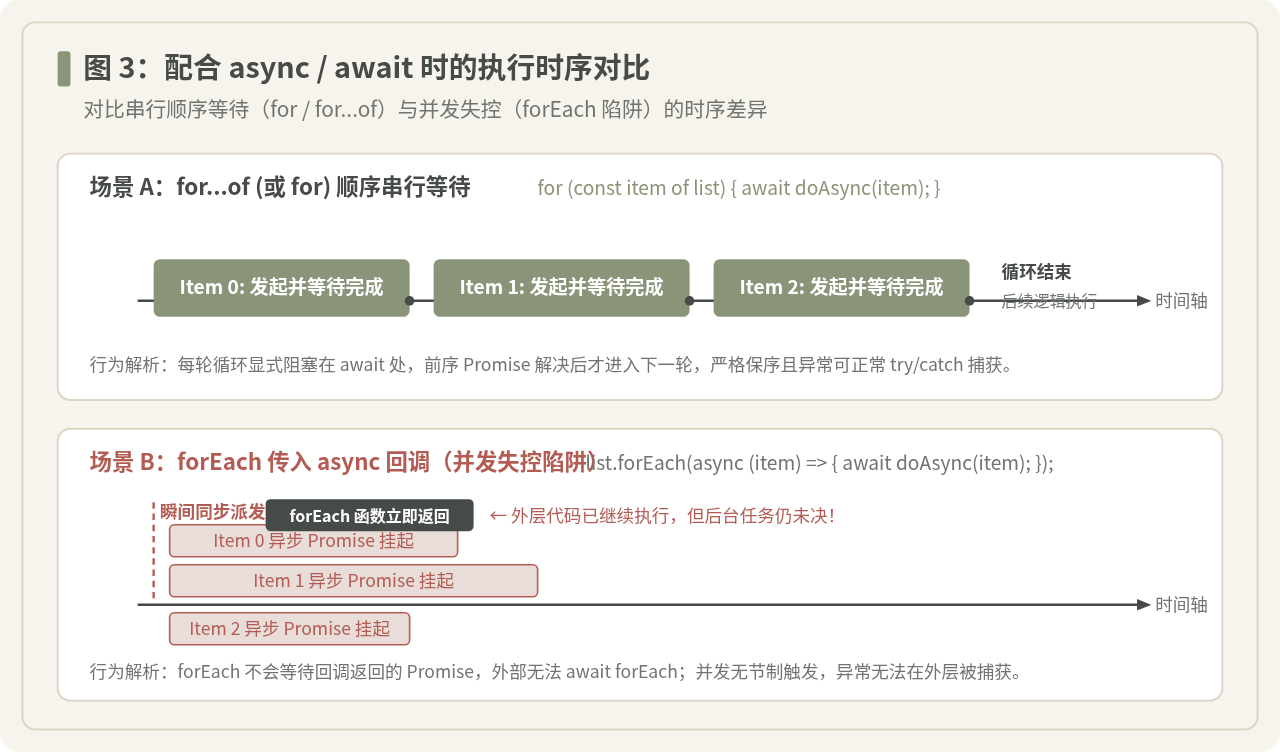
1. for 与 for...of 的严格串行等待
在 for 和 for...of 中使用 await,当前迭代会真正暂停,直到对应的 Promise 状态变为 resolved 后才继续推进:
// 串行请求示例:顺序等待
async function processSequentially(ids) {
  for (const id of ids) {
    const res = await fetchUserData(id); // 严格等待前一个请求返回
    console.log(`用户 ${id} 处理完成`);
  }
  console.log('所有用户依次处理完毕');
}
这种模式适合有顺序依赖、需要接口调用频率限制(Rate Limit)或资源竞争保护的场景。且外层包裹的 try...catch 能够自然捕获单步中的异步异常。
2. forEach 配合 async 的“并发失控”陷阱
若在 forEach 的回调中使用 async,代码虽然不会报错,但会产生严重的非预期行为:
// 典型陷阱:forEach 与 async 混用
async function fetchAll(ids) {
  console.log('开始遍历');

  ids.forEach(async (id) => {
    await fetchUserData(id);
    console.log(`用户 ${id} 加载成功`);
  });

  console.log('遍历流程结束'); // 此行会瞬间先被打印!
}
在上述代码中,forEach 是一个普通的同步函数,其内部实现根本不会检查传入回调的返回值,更不会去 await 回调返回的 Promise。执行过程瞬间派发完毕,“遍历流程结束”瞬间输出,而所有的网络请求依然在后台自由漂浮执行。如果其中某个请求失败,外层由于没有捕获管道,极易导致未捕获的 Promise 异常(UnhandledPromiseRejection)。
四、特殊场景对比:稀疏数组与常见认知辨析
1. 稀疏数组(Sparse Array)中的空洞处理
所谓稀疏数组,是指包含未分配物理存储单元(空位,empty slot)的数组,例如使用 new Array(3) 或 [1, , 3] 构造出来的数组。三种遍历方式对待空位的策略存在本质不同:
// 稀疏数组处理对比
const sparse = [1, , 3]; // 索引 1 为 empty slot

// 1. 经典 for 循环
for (let i = 0; i < sparse.length; i++) {
  console.log('for:', sparse[i]); // 输出: 1, undefined, 3
}

// 2. forEach
sparse.forEach(item => {
  console.log('forEach:', item); // 输出: 1, 3 (直接跳过 empty!)
});

// 3. for...of
for (const item of sparse) {
  console.log('for...of:', item); // 输出: 1, undefined, 3
}
forEach 在底层规范中会使用 HasProperty 检查对应索引是否存在;如果不存在(即为空位),则不触发回调。而 for 下标寻址和 for...of 迭代器产出均会将空位视为值为 undefined 的元素来处理。
2. 常见认知辨析:forEach 已经彻底过时了吗?
社区中常有声音认为“有了 for...of,forEach 就该被完全废弃”。这种说法看似有理,但并不准确:
- 为何看似合理:
for...of确实解决了控制流(break / continue)与异步(await)两大核心痛点,通用性极强。 - 为何需要修正:
forEach作为数组原型方法,与map、filter、slice配合在函数式链式调用中极具可读性;在不需要提前跳出、不需要异步等待、仅对每个元素产生纯副作用(如 DOM 挂载或日志记录)时,forEach的声明式意图表达依然更为紧凑。
3. 性能微基准的理性看待
关于“传统 for 循环性能秒杀其他两者”的说法,在早期旧版浏览器引擎中确实成立。但在现代 V8 引擎经过 TurboFan JIT 的深度优化后,常见密集数组场景下 for...of 与 forEach 的开销已经与传统 for 处于同一数量级。在绝大多数实际业务代码中,I/O 耗时与 DOM 渲染耗时远远大于遍历方式的毫秒级微小差距。代码的可读性、可维护性与控制流正确性,远比微基准测试更有价值。
五、选型指南与决策路径
为了在实际开发中快速做出最合理的选择,可参考下方的属性对比表与选型决策树:
| 特性维度 | 传统 for 循环 | Array.forEach | for...of 循环 |
|---|---|---|---|
| 支持 break / continue | 完整支持 | 不支持(抛 SyntaxError) | 完整支持 |
| return 语句效果 | 终止外层整个函数 | 退出单轮回调(等同 continue) | 终止外层整个函数 |
| 配合 await 串行等待 | 原生完全支持 | 不支持(立即返回、并发失控) | 原生完全支持 |
| 获取当前元素索引 | 直接读取计数器 i |
回调第二参数 index |
需配合 arr.entries() 解构 |
| 遍历其他 Iterable(Set/Map) | 不支持(仅支持数组/类数组) | 仅 Array 原型具备 | 完全支持所有可迭代对象 |
| 稀疏数组空位(Empty) | 读取为 undefined |
自动跳过空位 | 产出为 undefined |
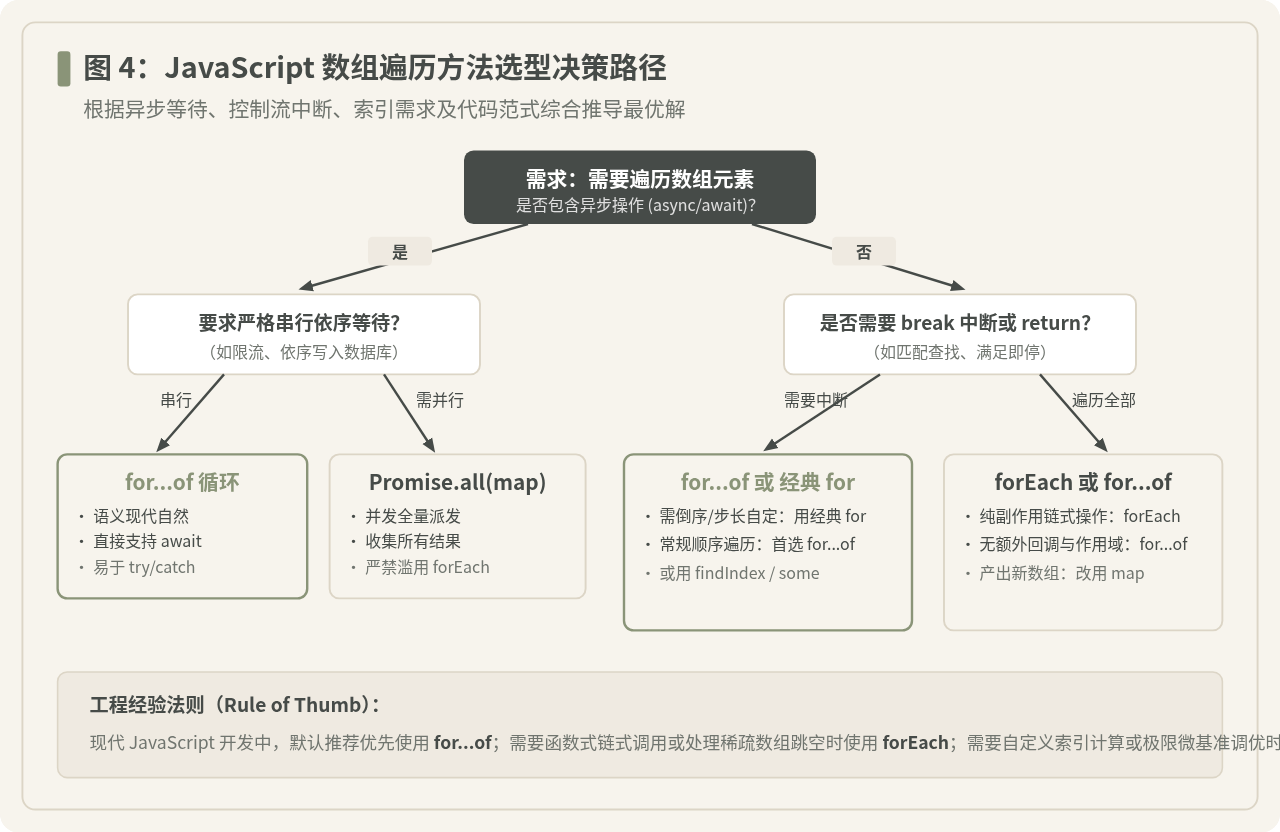
- 日常遍历首选
for...of:代码优雅,语义清晰,天然支持break、continue与await,是最稳健的默认选择。 - 链式处理纯副作用使用
forEach:在数据管道流水线中执行无中断、无异步等待的就地操作。 - 复杂索引步长控制使用经典
for:在需要倒序递减、跳跃步长或极限性能关键路径中保持使用。 - 多任务全量并发:如果遍历目的是并发触发异步且收集全部结果,严禁滥用
forEach,应使用Promise.all(arr.map(...))。
怎么不转换直接遍历JavaScript类数组?借用forEach与for循环技巧
2026-11-22 11:47:03
怎么安全地给深层嵌套JS对象属性赋值而不报错
2026-11-22 10:48:17
前端面试指南:复杂混合异步代码的JS执行顺序推导
2026-11-22 09:01:57
JS字符串转数组的三种方法:split、Array.from与展开运算符
2026-11-22 08:31:00
JavaScript快速排序优化:随机基准与三数取中策略实现
2026-11-21 23:02:35







