避免强制同步布局:JS批量获取元素高度的性能优化
深入解析在JavaScript中批量获取元素高度时引发强制同步布局(Forced Synchronous Layout)与布局抖动的原因,通过读写分离、批处理调度等方法提供具体的性能优化方案与代码实践。
在前端处理瀑布流计算、虚拟列表排版或自适应卡片等场景时,经常需要批量读取大量 DOM 元素的高度。如果在一个循环内交替“修改样式”与“读取尺寸”,页面就会触发强制同步布局(Forced Synchronous Layout, FSL),进而演变为严重的布局抖动(Layout Thrashing),导致主线程长时间阻塞和掉帧卡顿。要彻底解决该问题,核心方法是读写分离:将所有几何属性的查询操作集中在同一阶段完成,计算出目标值后,再统一安排样式变更。
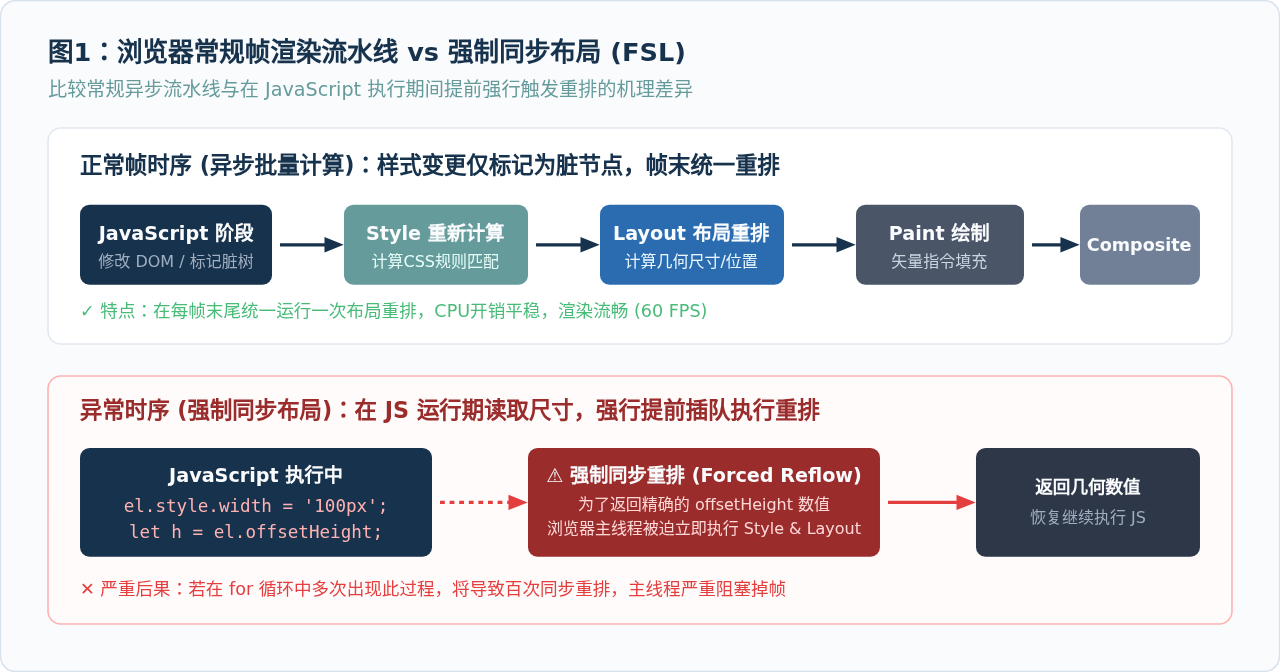
一、什么是强制同步布局与布局抖动?
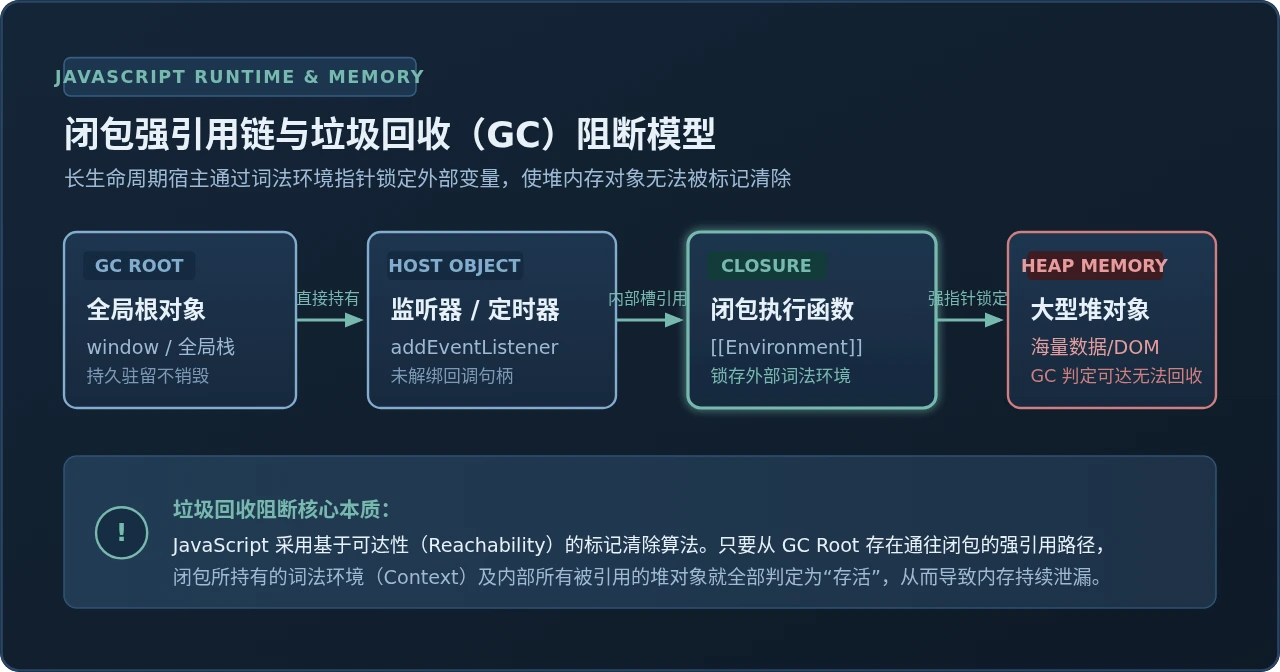
要理解强制同步布局,首先需要回顾浏览器的常规渲染流程。在正常的单帧渲染生命周期中,浏览器会按顺序经历:JavaScript 执行 → Style(计算样式) → Layout(布局重排) → Paint(绘制) → Composite(合成)。
当你在 JavaScript 中修改了某个元素的样式(例如 element.style.height = '120px')时,浏览器并不会立刻重新计算布局。出于性能考量,浏览器会把当前 DOM 树的样式标记为“脏(dirty)”,并将排版工作推迟到当前宏任务执行完毕、下一帧渲染流水线启动时统一处理。
但是,如果修改样式之后,JavaScript 紧接着同步调用了 offsetHeight、clientHeight 或 getBoundingClientRect() 等几何读取属性,浏览器就会陷入两难:内存中的 DOM 样式已经变了,但尚未进行重排计算,先前的几何缓存数值已经过时;为了返回精确的当前尺寸,浏览器主线程不得不强行中断当前的 JS 执行流程,当场提前触发一次同步的 Style 计算与 Layout 重排。这种现象被称为强制同步布局(FSL)。
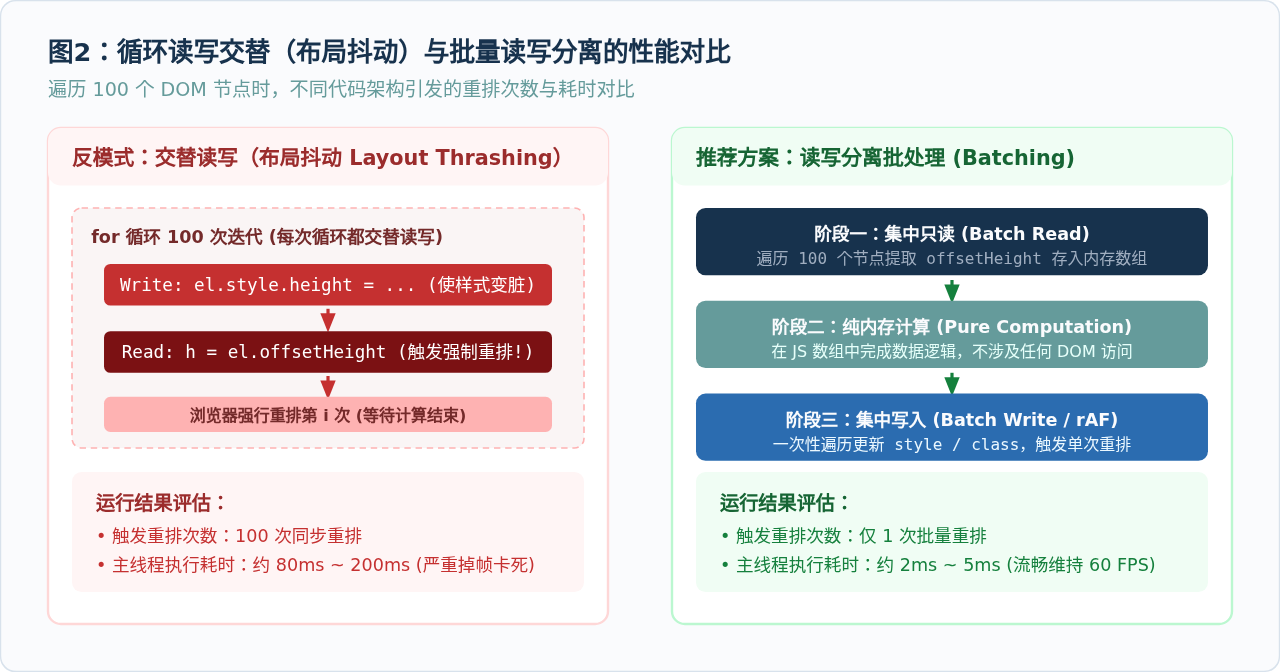
二、经典反模式:循环中的“读-写”交替
如果强制同步布局只偶尔触发一次,对现代 CPU 而言通常只有不到 1 毫秒的消耗,很难察觉。但真正致命的是将读写交替写在循环体内,也就是布局抖动(Layout Thrashing)。
假设我们需要对页面上的 100 张卡片进行动态自适应:根据当前元素的高度加上固定间隙,再设置回它的样式。初学者常常写出类似下面的代码:
// ❌ 经典反模式:在同一循环内交替“写”和“读”
const cards = document.querySelectorAll('.card');

for (let i = 0; i < cards.length; i++) {
  // 1. 写操作:标记样式为脏 (Dirty)
  cards[i].style.width = '240px';

  // 2. 读操作:迫使浏览器立刻执行重排计算出最新的高度
  const currentHeight = cards[i].offsetHeight;

  // 3. 再次写操作:再次标记样式为脏
  cards[i].style.height = `${currentHeight + 20}px`;
}在第 1 次迭代中,
cards[0].style.width 将 DOM 标记为脏;随后的 cards[0].offsetHeight 强行触发一次完整重排;在第 3 步修改 height,DOM 再次变脏。当进入第 2 次循环时,读取 cards[1].offsetHeight 再次强行触发重排……如果有 100 个卡片,浏览器就在一次 JS 宏任务里连续重排了 100 次!原本应平稳运行在 16.6ms 以内的一帧,主线程耗时暴增至 100ms 甚至数百毫秒,导致严重的掉帧与无响应。
三、核心解决方案:批量读写分离(Batching)
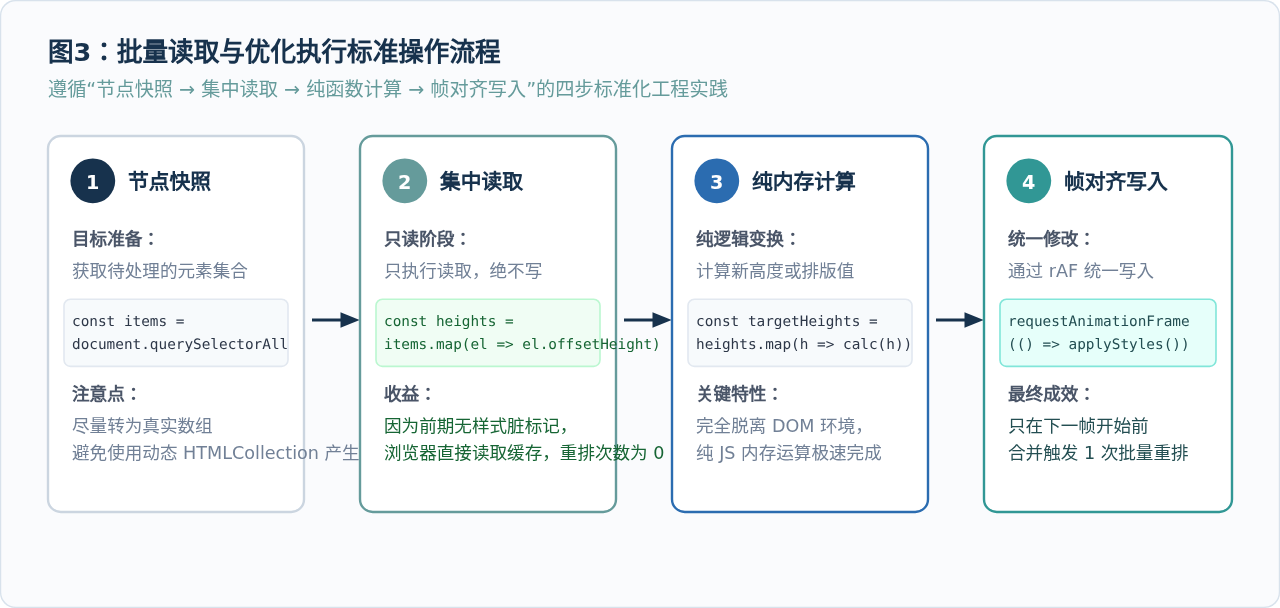
解决该问题的核心在于解耦读取与写入时序。现代浏览器的几何属性缓存是非常智能的:如果没有任何写操作将样式置为“脏”,连续读取成百上千个元素的 offsetHeight 是纯粹的内存访问,0 次重排,耗时极低。
因此,我们应当将整个操作流程规整为清晰的四步:
- 节点快照(Query):一次性获取目标元素集合;
- 集中读取(Batch Read):批量遍历所有元素,将所需的高度数值采集到普通的 JavaScript 数组中;
- 纯内存计算(Pure Computation):在纯 JS 内存中完成所有目标值或排版规则的换算,完全不触碰 DOM;
- 统一写入(Batch Write):结合
requestAnimationFrame将所有样式修改合并执行。
优化后的代码实战
按照“先全部读取、再集中写入”的准则,重构上述反模式代码:
// ✓ 正确模式:严格执行“批量只读”与“批量写入”分离
const cards = Array.from(document.querySelectorAll('.card'));

// 阶段一:批量设置宽度(如果必须先调整宽度)
// 注意:如果宽度在 CSS 中已确定,则应直接省略此步!
cards.forEach(card => {
  card.style.width = '240px';
});

// 阶段二:批量集中读取高度并缓存
// 浏览器在此处仅在第一次读取时执行 1 次重排,后续 99 次直接读取缓存!
const cardHeights = cards.map(card => card.offsetHeight);

// 阶段三:纯内存计算目标尺寸
const targetHeights = cardHeights.map(h => h + 20);

// 阶段四:统一帧对齐写入
requestAnimationFrame(() => {
  cards.forEach((card, index) => {
    card.style.height = `${targetHeights[index]}px`;
  });
});四、哪些属性会触发强制同步布局?
在编写前端逻辑时,开发者应当对所有具有“强制同步重排”副作用的 API 保持警惕。只要在这些属性被访问前存在 DOM 修改,就会触发重排:
| 分类 | 常见触发属性 / 方法 | 优化建议 |
|---|---|---|
| 元素盒模型尺寸与偏移 | offsetHeight, offsetWidth, offsetTop, offsetLeft |
批量一次性读取并保存在数组或 WeakMap 中复用 |
| 滚动条相关几何属性 | scrollHeight, scrollWidth, scrollTop, scrollLeft |
使用全局滚动事件节流(throttle)或统一在 rAF 中采集 |
| 视口与边界几何矩阵 | getBoundingClientRect(), getClientRects() |
结合 IntersectionObserver 替代频繁的主动边界轮询 |
| 计算样式获取 | window.getComputedStyle(element) |
尽量优先使用预设的 CSS class 进行状态变更 |
五、进阶方案与架构选型
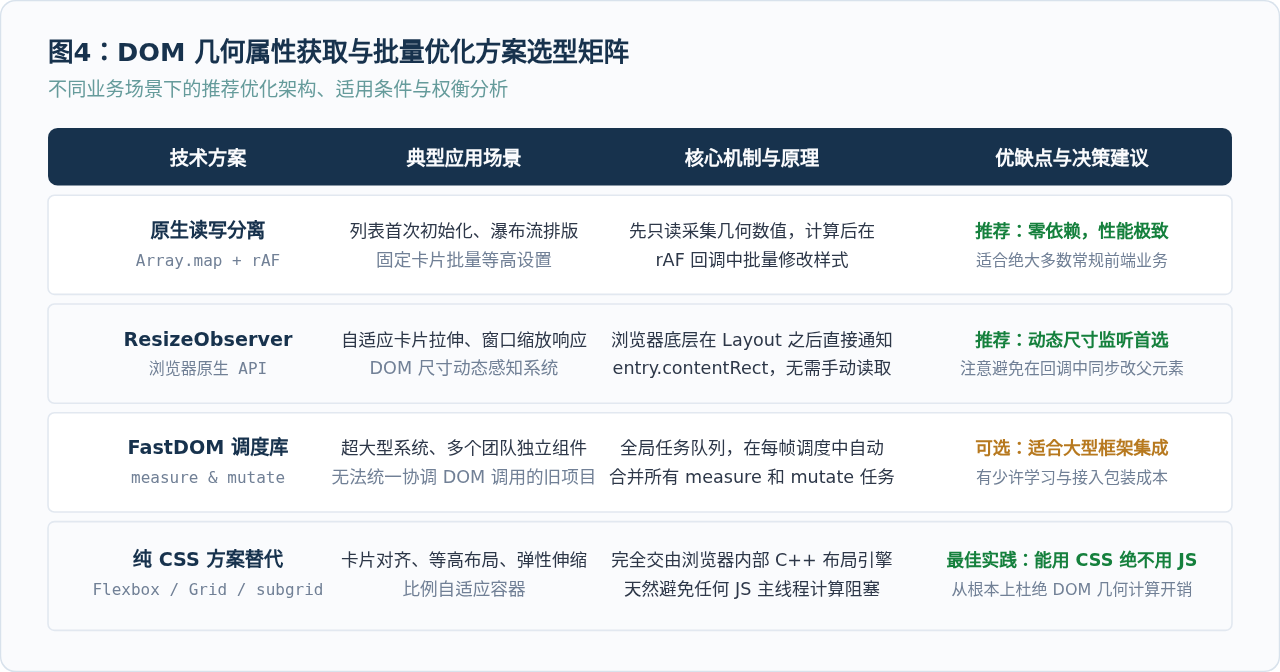
在简单的业务脚本中,手动拆分 map 循环即可满足需求;但在大型协同工程或复杂交互组件中,不同模块往往独立运行,容易在不经意间交叉调用读写。针对这种场景,有以下更为健壮的工程方案:
1. 现代化动态监测:使用 ResizeObserver
当元素尺寸因为窗口变化、异步图片加载或字体加载而发生改变时,不要使用定时器去循环轮询 offsetHeight。原生的 ResizeObserver 运行在浏览器内部布局完成之后,它直接将尺寸数据通过 entry.contentRect 传递给你,天然避开强制同步布局:
// 使用 ResizeObserver 监听容器与子元素变动
const ro = new ResizeObserver(entries => {
  for (const entry of entries) {
    // 直接获取已计算好的尺寸,无需调用 offsetHeight
    const currentHeight = entry.contentRect.height;
    // 逻辑计算...
  }
});

document.querySelectorAll('.card').forEach(el => ro.observe(el));
2. 任务队列调度:FastDOM 理念
开源库 fastdom 提出了非常优雅的微任务队列思想:它将读操作注册到 fastdom.measure(),写操作注册到 fastdom.mutate()。在每一帧的 requestAnimationFrame 中,FastDOM 保证先统一把所有 measure 任务清空,再去批量执行所有的 mutate 任务,从而在代码层面上彻底消灭不同组件间的交替读写竞争。
六、总结与落地清单
优化 JavaScript 批量获取元素高度的核心不是高深的算法,而是对浏览器渲染管线规律的顺应。在日常开发中,建议牢记以下落地清单:
- 严禁循环内读写交替:任何
for、forEach内部只要同时包含尺寸读取与样式写入,必须立刻重构; - 先读后写,只读集中:先用普通变量缓存所需全部尺寸,确认数据计算完毕后,再统一向 DOM 写入;
- 帧对齐写入:将修改 DOM 的操作包裹在
requestAnimationFrame中,让样式修改精准对齐浏览器刷新率; - 能用 CSS 就不用 JS:对于等高卡片、网格对齐等常见排版需求,优先使用
display: grid或display: flex,完全释放主线程。
JS接口安全域名配置后不生效?排查DNS、HTTPS及路径常见错误
2026-11-22 11:42:05
JS离线地图加载优化:瓦片缓存策略与性能提升技巧
2026-11-22 10:39:33
怎么避免JavaScript嵌套三目运算符导致的可读性下降
2026-11-22 10:00:42
JS异步加载多图时怎么避免缩略图闪烁与布局抖动
2026-11-21 23:47:01
前端JS密码正则校验与后端验证的区别及注意事项
2026-11-20 21:53:07