

前端JS密码正则校验与后端验证的区别及注意事项
深入解析前端JavaScript密码正则校验与服务端验证的本质区别、各自职责边界,以及在规则同步、ReDoS防护、Bcrypt长度限制等方面的实战注意事项。
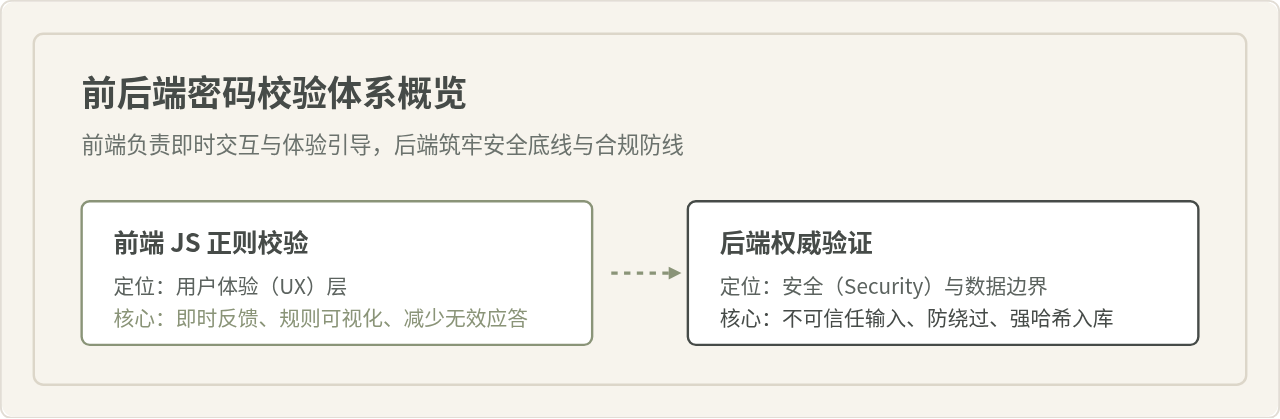
在密码处理逻辑中,核心结论非常明确:前端 JavaScript 正则校验服务于用户体验,后端验证服务于系统安全。 前端校验提供即时反馈,指导用户设置合规密码并减少不必要的网络往返;而后端则是系统安全的最后一道绝对防线,必须假定来自前端的所有数据均不可信并执行完整的二次检验。两者在运行环境、信任模型、错误控制及性能考量上均有显著差异,不能互相替代。
一、前端校验与后端验证的核心区别
很多初学者容易产生一种误解:“既然前端已经用正则表达式严格限制了密码必须包含大小写字母、数字和特殊字符,后端只要直接拿过来加密存储不就可以了吗?”这种想法混淆了“交互界面”与“安全边界”的概念。
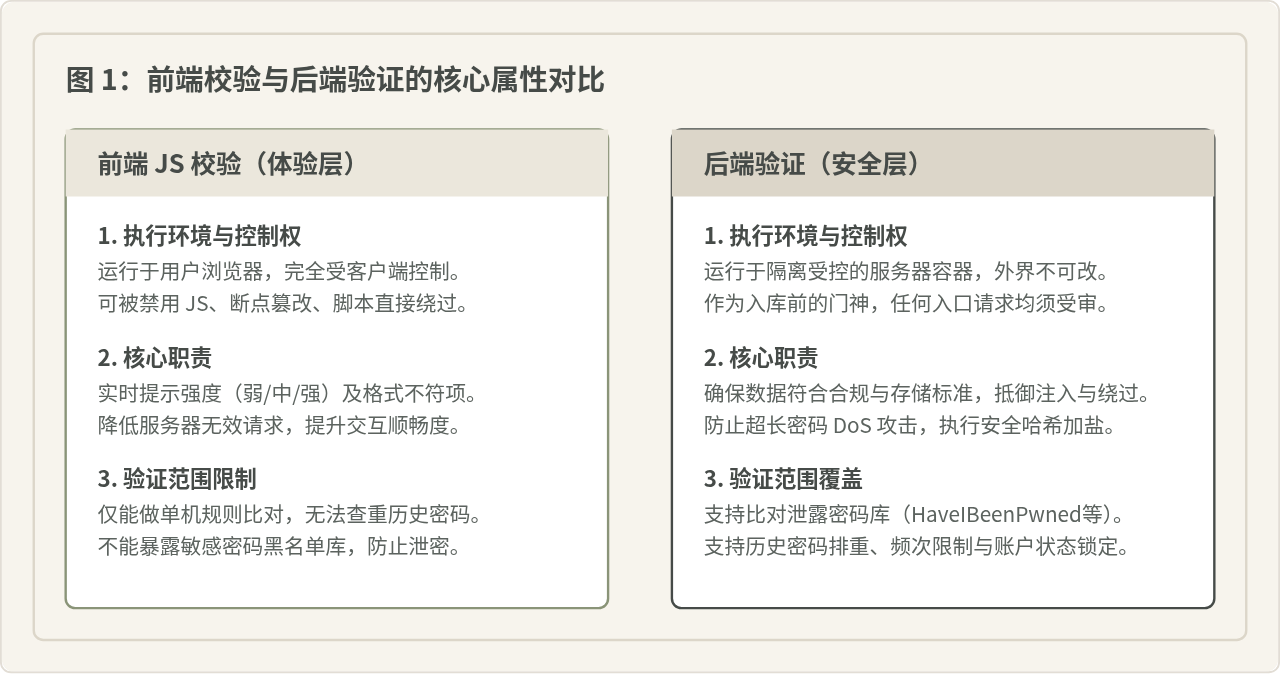
具体来看,两者的差异主要体现在四个维度:
- 信任级别不同:前端环境运行在不受开发者信任的用户设备上。无论是浏览器的开发者工具(F12)、控制台执行脚本、油猴扩展,还是通过 cURL、Postman 直接发起 HTTP POST 请求,都可以轻松绕过前端的所有 JS 限制。后端环境由服务方独立掌控,具有最高权威性。
- 关注目标不同:前端正则校验关注的是“引导”,例如通过高亮指示条告诉用户“还缺少一个大写字母”;后端验证关注的是“防御与准入”,严格校验格式合法性、拒绝超长畸形输入,并在合规后安全哈希入库。
- 信息掌握度不同:前端只能做无状态的字面量匹配;后端可以联动数据库,检查密码是否与用户名/手机号相同、是否在常见弱密码字典中、是否属于最近使用过的历史密码。
- 异常代价不同:前端正则如果写出灾难性的回溯问题(ReDoS),最多导致该用户的单个浏览器标签页卡死;若后端正则存在 ReDoS 漏洞,攻击者发送几个并发请求就能将服务器 CPU 打满至 100%,造成整体服务瘫痪。
二、协同工作流与双重验证步骤
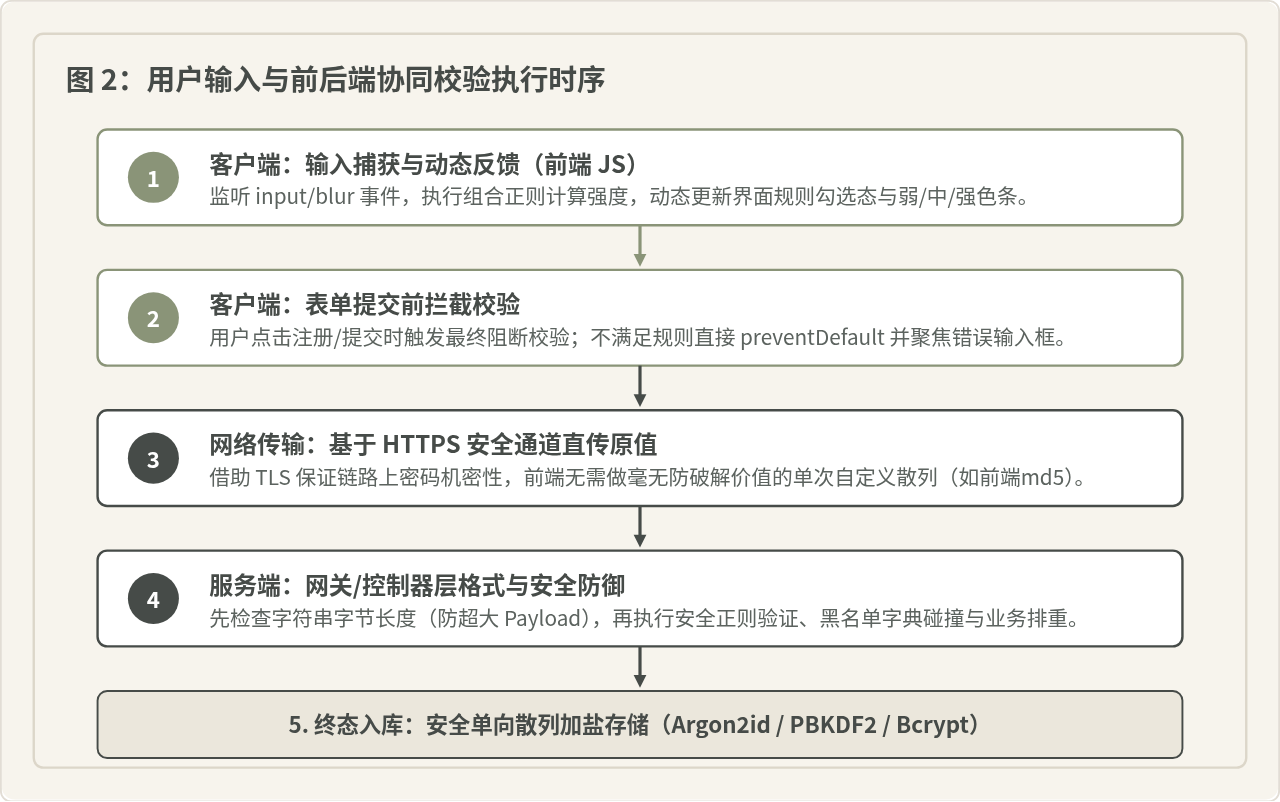
一个健壮的认证流程,必须保证前端和后端的紧密衔接。下图展示了从用户在输入框敲击键盘,到密码最终被安全落库的完整步骤:
1. 前端实现:渐进式体验与代码示范
前端的密码验证切忌只给一个冰冷的整体正则。例如,/^(?=.*[a-z])(?=.*[A-Z])(?=.*\d)[A-Za-z\d@$!%*?&]{8,20}$/ 虽然功能完整,但如果直接拿它来弹窗提示“密码格式错误”,用户根本不知道是长度不够、缺了大写字母,还是包含了不允许的符号。
在前端,更好的实践是将复杂规则拆解为多个原子检查,方便给出分项打勾效果:
// 前端推荐:多维度原子检查与反馈机制
function validatePasswordStrength(pwd) {
  const rules = [
    { key: 'length', valid: pwd.length >= 8 && pwd.length <= 64, label: '长度在 8 到 64 位之间' },
    { key: 'upper',  valid: /[A-Z]/.test(pwd), label: '包含至少一个大写字母' },
    { key: 'lower',  valid: /[a-z]/.test(pwd), label: '包含至少一个小写字母' },
    { key: 'number', valid: /\d/.test(pwd), label: '包含至少一个数字' },
    { key: 'symbol', valid: /[^A-Za-z0-9]/.test(pwd), label: '包含至少一个特殊字符' }
  ];

  const passedCount = rules.filter(r => r.valid).length;
  const isSatisfied = rules.every(r => r.valid);

  return {
    isSatisfied,
    passedCount,
    strength: passedCount <= 2 ? 'weak' : (passedCount <= 4 ? 'medium' : 'strong'),
    detail: rules
  };
}
2. 后端实现:严格守门与防 DoS 示范
后端验证代码位于 Controller 或 DTO 验证器中。除了满足与前端商定的字符规则外,必须对输入的最大长度进行前置硬编码截断或拒绝。以下为基于 Node.js/Express 的后端验证示例:
// 后端:输入合法性校验、防 DoS 与密码哈希
import bcrypt from 'bcrypt';

const PASSWORD_REGEX = /^(?=.*[a-z])(?=.*[A-Z])(?=.*\d)(?=.*[^A-Za-z0-9]).{8,64}$/;

export async function handleRegister(req, res) {
  const { username, password } = req.body;

  // 1. 基础类型与长度硬核前置防御(严防过长字符串直接进正则导致性能被拖垮)
  if (typeof password !== 'string' || password.length < 8 || password.length > 64) {
    return res.status(400).json({ error: '密码长度必须在 8 到 64 位字符之间' });
  }

  // 2. 正则格式校验(与业务安全要求一致)
  if (!PASSWORD_REGEX.test(password)) {
    return res.status(400).json({ error: '密码须同时包含大小写字母、数字及特殊字符' });
  }

  // 3. 业务安全规则(禁止弱密码字典、禁止包含用户名)
  if (password.toLowerCase().includes(username.toLowerCase())) {
    return res.status(400).json({ error: '密码不能包含用户名信息' });
  }

  // 4. 安全单向加盐哈希(Bcrypt / Argon2)
  const saltRounds = 12;
  const passwordHash = await bcrypt.hash(password, saltRounds);

  // 写入数据库逻辑...
  return res.status(201).json({ message: '注册成功' });
}
三、前端防御失效的常见场景与后端拦截
要深刻理解两者区别,最直观的方式就是观察“攻击者如何绕过前端”。在实际网络环境中,任何客户端检查都只是“防君子不防小人”。
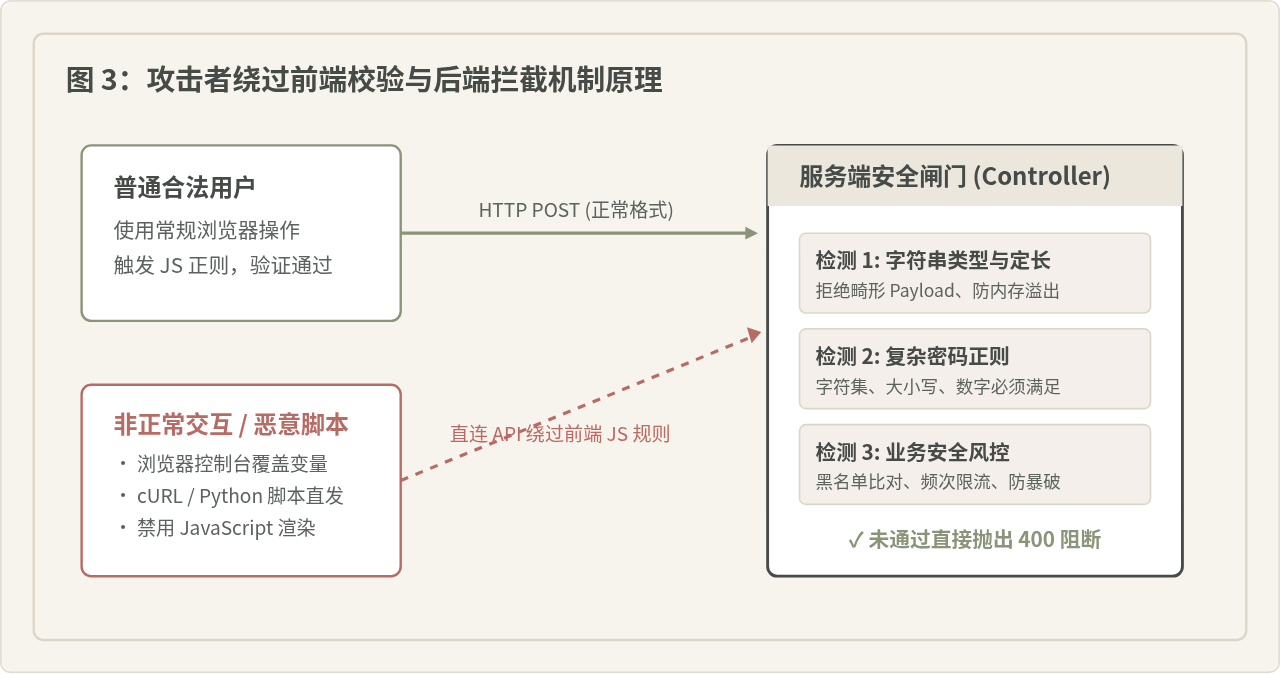
无论是使用爬虫程序发送注册请求,还是利用抓包工具篡改表单参数,网络层面的数据包都可以伪造成任意内容。如果后端省略了验证逻辑,攻击者就可以直接注入空密码、单字符弱密码,甚至在请求体中填充数兆字节的超长文本触发服务崩溃。
四、开发实践中的关键注意事项
在设计和落地密码校验体系时,有几个非常具体且极易被忽视的技术细节值得重点注意:
业界广泛使用的 bcrypt 哈希算法存在一个历史遗留特性:它仅计算前 72 字节的内容,超过 72 字节的部分会被静默丢弃。如果后端没有严格限制密码的最大长度(例如限制为 64 或 72 字符),当用户输入了一个 100 位的密码时,后续只要前 72 位输入正确,就能成功登录。更严重的是,恶意攻击者若提交数千位的超长字符串,不仅绕过了截断逻辑,更会在计算哈希时耗尽服务器 CPU 资源,造成 DoS 攻击。因此,后端必须对密码字符串长度设置硬性上限(建议 64 ~ 72 位)。
编写强密码正则时,开发者习惯使用前瞻断言(Lookahead),如 /^(?=.*[a-z])(?=.*[A-Z])(?=.*\d).{8,64}$/。当正则表达式包含嵌套的量词或模糊匹配时,一旦攻击者构造特殊的长文本,正则引擎可能陷入灾难性指数回溯(Catastrophic Backtracking)。在服务端,必须保证:
1. 正则尽量扁平,避免嵌套量词;
2. 务必先检查 str.length,在长度合法的前提下再进行正则计算;
3. 在 Java、Node 等环境下,可使用超时正则库或原子分组减少回溯风险。
不同语言的正则表达式引擎存在语法细微差异(例如 JavaScript 是 ECMAScript 标准,后端如果是 Java、Python 或 PHP 则基于 PCRE 或专用引擎)。
常见的坑包括:
• Unicode 属性支持:JS 在支持 \p{L}(Unicode字母)前需要启用 /u 标识符,后端各语言的修饰符不尽相同;
• 特殊字符转义:某些标点符号(如 -, [, ], /, \)在不同引擎内的转义规则略有差异。
应对建议:前后端应当建立统一的密码策略规范文档,或将正则字面量定义为共享的常量配置(如通过配置文件或 API 提供校验规则描述),避免因引擎解析不一致导致“前端认为合法、后端直接报错”的尴尬体验。
在注册流程中,前端提示应尽可能详尽,指导用户如何合规;但在登录验证或敏感修改接口中,服务端的错误提示应当具有防嗅探意识。例如,如果登录失败,服务端应统一返回“用户名或密码错误”,而不是明确指明“密码格式不对”或“密码错误”,以防攻击者利用接口响应区分用户名是否存在。
五、前后端协同验证策略总结
为了让知识体系更加清晰,下表归纳了前后端密码校验在各项关键维度上的配合策略:
| 对比维度 | 前端 JS 校验 | 后端安全验证 |
|---|---|---|
| 第一目的 | 用户体验引导、交互即时响应 | 系统安全保障、数据完整性与合规性 |
| 防护等级 | 防君子(无恶意普通用户输入纠错) | 防小人(阻断脚本、抓包篡改与非法调用) |
| 性能影响 | 分摊至客户端单机 CPU,服务端零负担 | 高并发下需格外注意 ReDoS 与哈希计算耗时 |
| 数据传输 | 通过 HTTPS 直接传输,勿使用无盐单次 MD5 | 在内存中进行校验,随即加盐哈希入库,绝不存明文 |
| 异常处置 | 精准指向未满足的项目(如“缺少特殊符号”) | 注册抛出 400 校验错误;登录统一报错防枚举 |
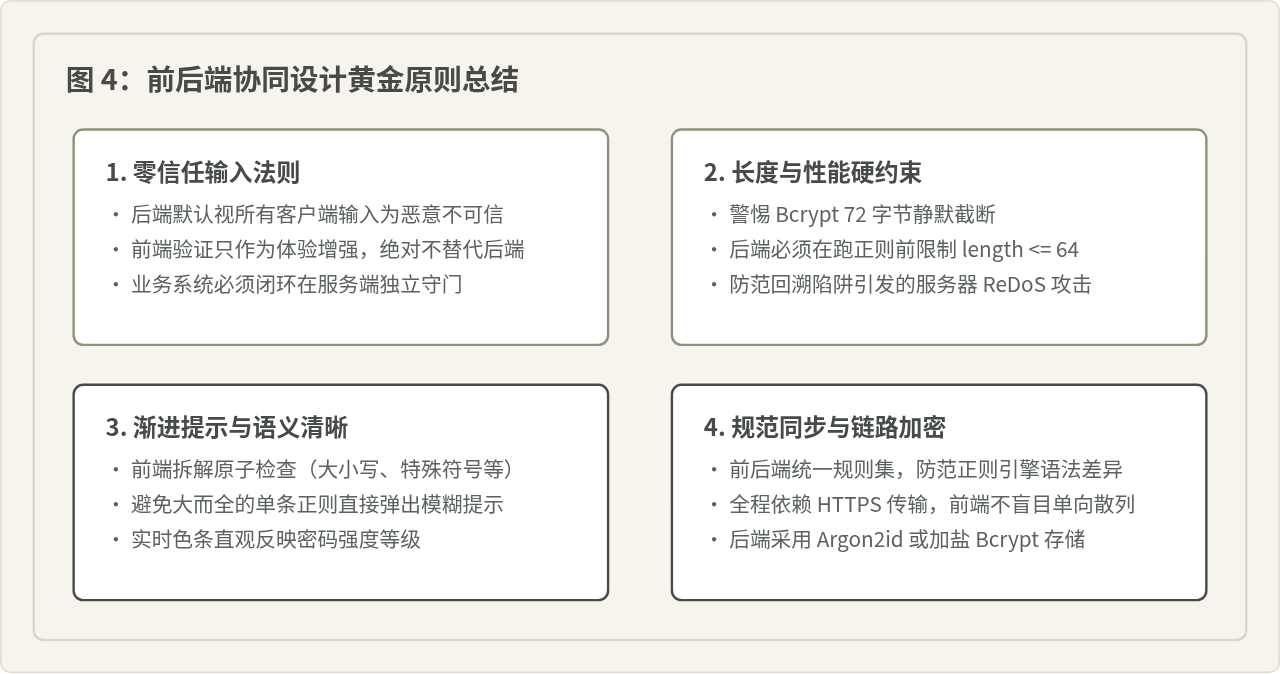
综上所述,密码验证绝非简单的“写一段正则表达式”。在现代 Web 开发中,前端 JS 负责贴心、细致地引导用户,提升转化率与使用满意度;后端则坚守零信任准则,严谨防御畸形攻击与安全绕过。只有将两者分工协作、各司其职,才能在兼顾优良体验的同时构建牢不可破的安全护城河。
JavaScript开发微信小游戏有哪些限制与适配技巧
2026-11-20 21:08:29
JavaScript动态生成正则过滤关键词怎么避免注入风险
2026-11-20 19:52:57
高性能场景下JS对象判空的最优解
2026-11-20 18:58:48
JavaScript密码强度正则:从基础到复杂规则的灵活配置
2026-11-20 16:20:43
JS中Math.random与crypto.getRandomValues生成随机字母的区别
2026-11-20 13:36:46







