

JavaScript动态生成正则过滤关键词怎么避免注入风险
详细讲解在JavaScript中动态生成正则表达式进行关键词过滤与文本高亮时,如何避免SyntaxError语法报错与ReDoS拒绝服务攻击的注入风险,提供生产级转义函数、多关键词组合模式及架构选型方案。
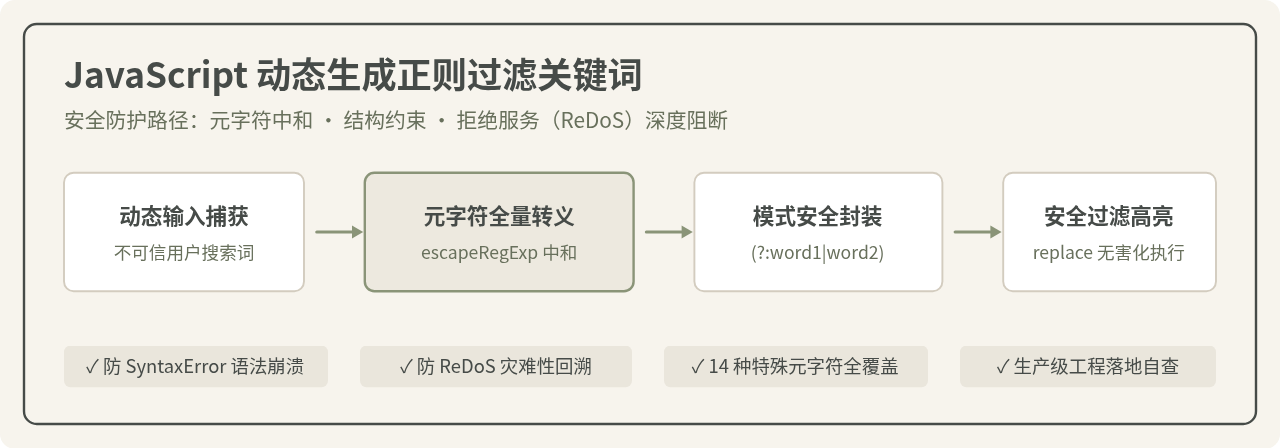
new RegExp(keyword, 'gi'))。然而,如果未对动态变量进行严格的转义处理,外部不可信的字符便会破坏正则表达式本身的语义结构,造成正则注入(RegEx Injection)。轻则因未闭合符号或非法量词引发 SyntaxError 导致页面白屏或 Node.js 进程崩溃,重则因恶意构造的嵌套量词诱发灾难性回溯(ReDoS),瞬间耗尽 CPU 资源使服务陷入瘫痪。解决该问题的根本方法是:在将任何外部关键词传入 RegExp 构造函数之前,必须对全部 14 个正则特殊元字符进行安全转义,同时限制关键词的长度与数量;而在面对超大规模关键词库时,应放弃正则拼接,切换为 Trie 字典树或 Aho-Corasick(AC自动机)多模式匹配算法。
一、动态拼接正则为什么会产生注入风险?
在 JavaScript 中,字面量形式的正则表达式(例如 /apple/gi)在代码编写与打包编译期就已经固定,其语法结构是确定且受控的。与之相对,使用构造函数 new RegExp(patternString, flags) 时,正则引擎是在代码运行阶段动态解析传入的字符串。
这种“运行时动态编译”的特性,使它在本质上类似于执行 SQL 查询或拼接 HTML 片段。如果直接把用户在搜索框输入的字符串当成正则表达式的一部分,那么“用户提交的数据”就会直接升级为“正则引擎的控制指令”。
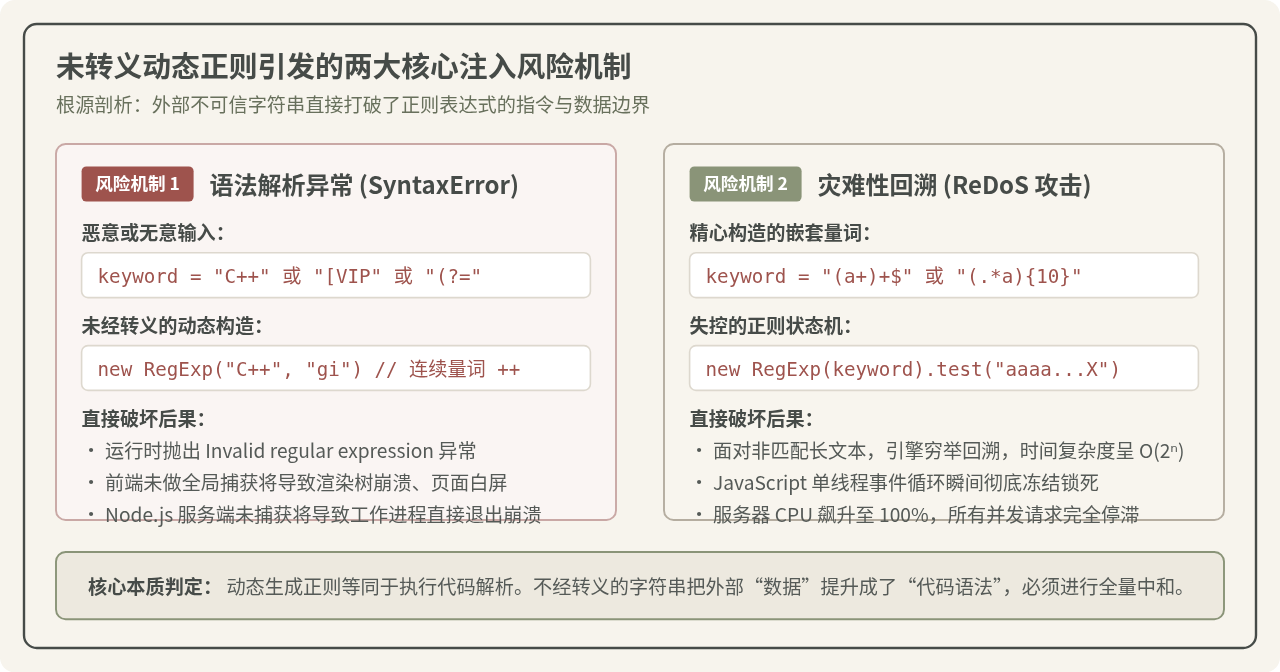
1. 语法解析异常(SyntaxError)导致程序瞬间崩溃
这是日常开发中最常见、也最容易被忽视的问题。用户在日常输入中难免会输入带有符号的文字,例如技术社区中频繁出现的 C++、Node.js,或者标价 $100、会员标识 [VIP]、带括号的注释 (最新) 等。
若直接执行 new RegExp("C++", "gi"),正则引擎会将连续的两个加号 ++ 识别为“量词紧跟量词”,直接抛出:
// 未经转义直接传入 C++ 会触发语法异常
Uncaught SyntaxError: Invalid regular expression: /C++/: Multiple repeat
同理,如果用户输入了单个未闭合的左方括号 [VIP,会抛出 Unterminated character class;输入未闭合的断言 (?=,会抛出 Invalid group。在前端单页应用(SPA)中,若未在调用处逐一包裹 try...catch,该未捕获异常会中断组件的渲染树,直接造成页面白屏;而在 Node.js 服务端处理网络请求时,未捕获的异常甚至会直接导致主进程退出。
2. 灾难性回溯(ReDoS)瘫痪主线程与服务器
相比于显式的语法崩溃,更隐蔽且危害更大的安全隐患是正则表达式拒绝服务攻击(ReDoS, Regular Expression Denial of Service)。
主流 JavaScript 运行时(如 V8、SpiderMonkey、JavaScriptCore)采用的是传统的回溯型 NFA(非确定性有限自动机)引擎。如果攻击者刻意在关键词中注入诸如 (a+)+$、(a|aa)+$ 这类带有嵌套量词或多重重叠分支的模式,当被检测的文本是一长串以 a 开头但结尾不是 a 的不匹配文本时(如 "aaaaaaaaaaaaaaaaaaaaX"),正则引擎为了确认最终是否能匹配成功,会穷举所有可能的排列组合进行回溯尝试。
这种回溯尝试的计算量会随着输入文本长度呈指数级增长($O(2^n)$)。由于 JavaScript 的事件循环机制依赖单线程执行,计算密集的回溯会瞬间把 CPU 占满到 100%,导致主线程彻底失去响应,其他用户的正常 HTTP 请求全部处于无响应挂起状态。
二、核心防御方案:对元字符进行标准转义
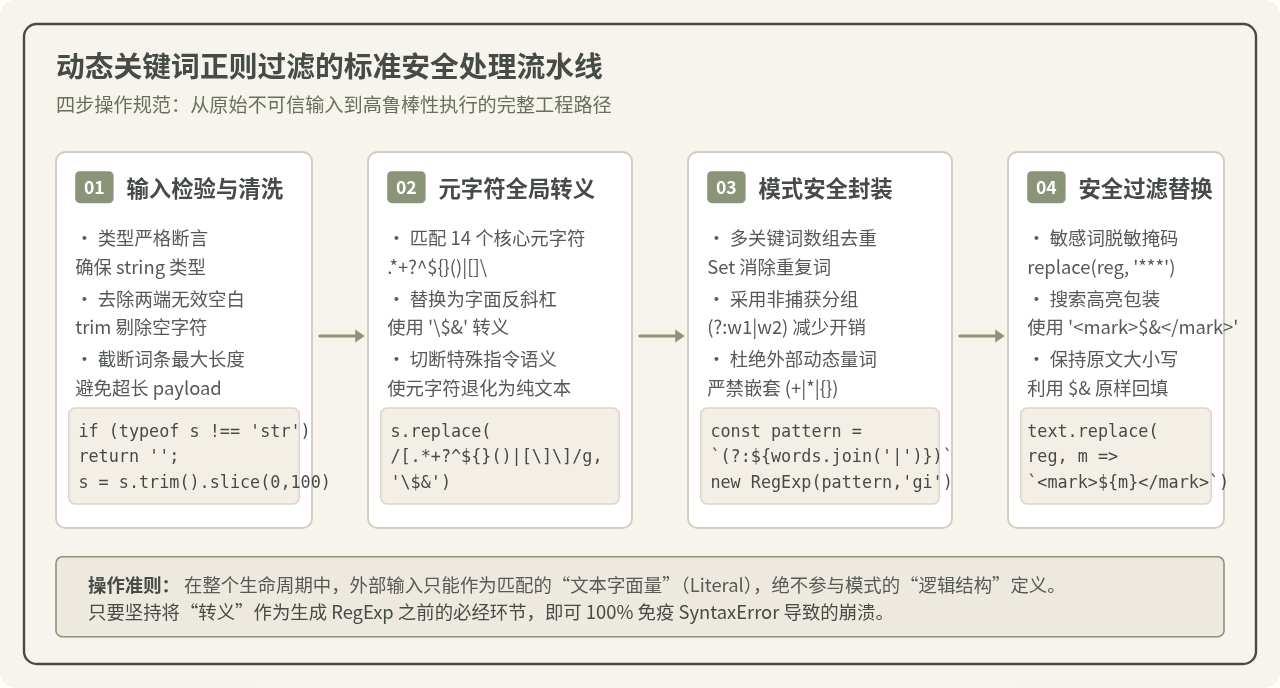
要彻底阻止注入风险,核心目标就是**剥夺动态字符串中特殊字符的“语法控制权”,将其强制退化为单纯的“文本字面量”**。
1. 正则表达式中的 14 个核心元字符
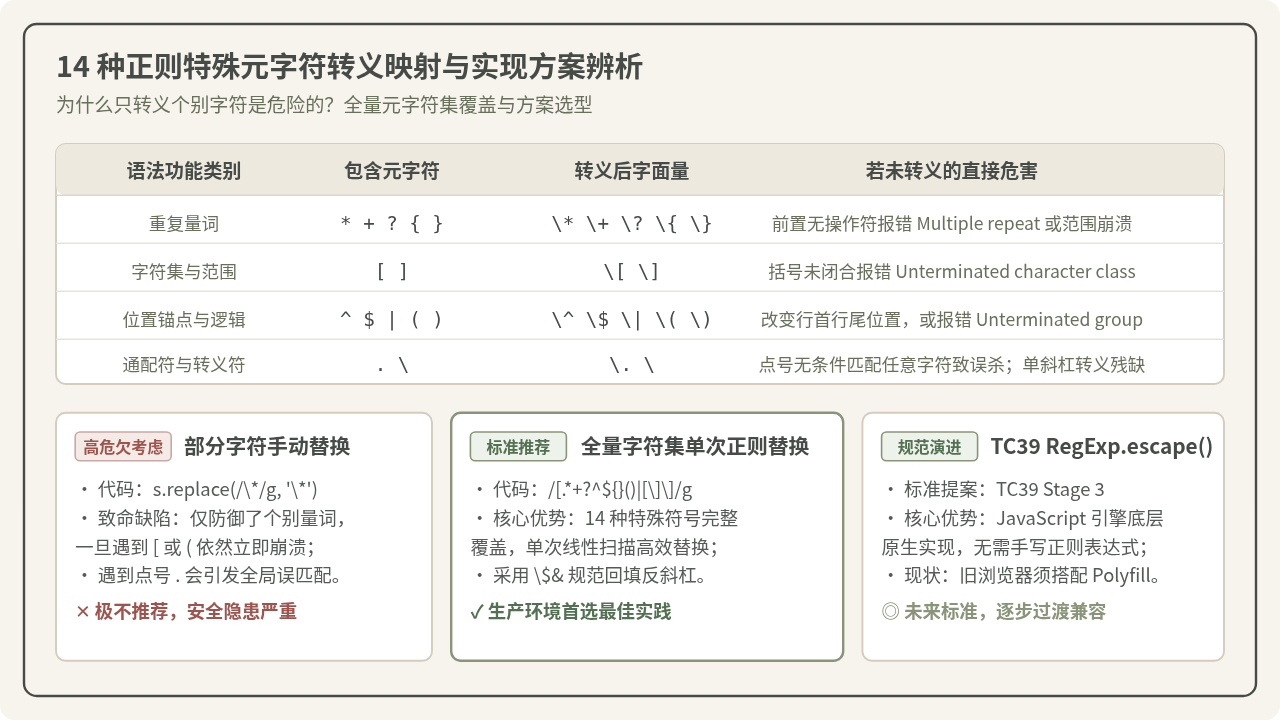
在 ECMAScript 规范中,正则表达式赋予了以下 14 个字符特殊的语法意义:
- 量词与重复:
*(0次或多次)、+(1次或多次)、?(0次或1次)、{与}(指定出现区间)。 - 字符集合与范围:
[与](定义字符集)。 - 位置锚点与逻辑分支:
^(行首)、$(行尾)、|(或运算)、(与)(捕获与分组)。 - 通配符与转义符:
.(匹配除换行外的任意单字符)、\(转义字符自身)。
只要动态字符串中出现了这 14 个字符中的任何一个,我们都必须在它前面插入一个反斜杠 \ 进行中和。
2. 标准转义函数 escapeRegExp 的实现与解析
推荐在项目中封装并全局使用经过社区长期验证的标准转义函数:
/**
 * 对字符串中的所有正则表达式特殊元字符进行安全转义
 * @param {string} string - 待转义的原始输入字符串
 * @returns {string} - 转义后的安全字面值字符串
 */
function escapeRegExp(string) {
  if (typeof string !== 'string') {
    return '';
  }
  // 使用方括号字符类包含全部 14 个元字符,并全局替换为字面反斜杠加自身
  return string.replace(/[.*+?^${}()|[\]\\]/g, '\\$&');
}
这行紧凑的代码蕴含了两个关键的设计细节,也是许多初学者容易产生疑问的地方:
-
为什么字符类中不需要给每个符号都加斜杠?
在正则表达式的字符集合[...]内部,绝大多数元字符(如.、*、+、?、$、{}、()、|)都会自动失去其原本的特殊功能,直接被引擎视作普通的普通字符。只有](字符集结束边界)和\(转义符号自身)必须显式转义。因此[\]\\]精确且安全地封闭了右方括号与反斜杠,保证了正则本身的解析无误。 -
为什么替换目标必须写成
'\\$&'?
在 JavaScript 字符串字面量中,两个连续的反斜杠\\会被解释为一个内存中的字符\。而在String.prototype.replace的替换模板中,$&是一个保留标记,代表“本次匹配到的子字符串”。因此'\\$&'的含义就是:把匹配到的特殊符号,原样替换为“反斜杠 + 该符号”。例如遇到+时替换为\+,遇到[时替换为\[。
三、容易混淆的写法与常见误区辨析
在实际项目代码审查中,经常能看到一些看似可行但存在安全死角的处理方式。理解这些误区有助于在团队内建立更严谨的规范。
为什么看似合理:很多开发者在测试注入时,习惯性在搜索框输入 * 或 ++,发现控制台报错后,便随手写了一个针对这两个符号的替换。如果在功能测试中输入的都是普通的英文或汉字,系统看起来毫无问题。
实际存在的严重缺陷:一旦用户在搜索中输入包含 [、(、? 的词条(例如搜索论文公式、特定代码变量或打错符号),正则引擎依然会因为语法结构不完整而当场报错崩溃;更危险的是,如果用户输入了未经转义的点号 .,该正则会无差别匹配任何单个字符,导致敏感词过滤或高亮时大面积误伤正常内容。
为什么看似合理:部分开发者觉得单一长正则表达式看起来晦涩,便尝试写成 str.replace(/\*/g, '\*').replace(/\+/g, '\+') 这种链式调用。
实际存在的严重缺陷:首先,只要遗漏任何一个元字符就会产生防御缺口;其次,如果替换顺序不当(例如先转义了其他字符生成了 \,随后又去全局替换 \),会导致先前的反斜杠被二次转义,使表达式彻底混乱;最后,多次字符串替换会频繁分配临时中间变量,在大批量文本处理时带来多余的性能开销。
ECMAScript 规范委员会正在推进 RegExp.escape() 提案(目前处于 Stage 3 阶段),旨在为 JavaScript 语言提供引擎底层的原生安全转义方法。
虽然未来我们将可以直接调用 new RegExp(RegExp.escape(keyword)),但在目前存量的主流浏览器版本及 LTS 之前的 Node.js 环境中,该 API 尚未实现全环境默认覆盖。因此,在当前阶段的生产代码中,最稳健的做法依然是内置上述 escapeRegExp 工具函数,或通过规范的 Polyfill 引入,绝不能在未经环境垫片的情况下直接假定 RegExp.escape 存在。
四、工程实战:完整的关键词过滤与高亮安全实现
在实际业务中,我们通常需要处理“多个关键词同时过滤”或“搜索结果高亮显示”。下面给出两套完整、可直接复用的工业级函数封装。
1. 安全构建多关键词复合正则
当存在关键词列表(如敏感词库或多个搜索标签)时,需要先对数组进行类型校验、去重与转义,再使用非捕获分组 (?:...) 拼接分支,避免创建不必要的捕获组:
/**
 * 将关键词数组安全地组合成全局不区分大小写的正则表达式
 * @param {string[]} keywords - 动态关键词列表
 * @param {number} maxKeywordLen - 单个关键词允许的最大长度,默认 100
 * @returns {RegExp|null} - 构造成功的安全正则,无有效词时返回 null
 */
function createSafeKeywordRegExp(keywords, maxKeywordLen = 100) {
  if (!Array.isArray(keywords) || keywords.length === 0) {
    return null;
  }

  // 1. 过滤无效类型、去除空白、限制长度,并使用 Set 完成去重
  const uniqueCleanWords = Array.from(new Set(
    keywords
      .filter(item => typeof item === 'string')
      .map(item => item.trim())
      .filter(item => item.length > 0 && item.length <= maxKeywordLen)
  ));

  if (uniqueCleanWords.length === 0) {
    return null;
  }

  // 2. 对每个关键词实施全量元字符转义
  const escapedWords = uniqueCleanWords.map(escapeRegExp);

  // 3. 使用非捕获组 (?:...) 组合多选分支
  const combinedPattern = `(?:${escapedWords.join('|')})`;

  // 4. 实例化正则,g 代表全局,i 代表忽略大小写
  return new RegExp(combinedPattern, 'gi');
}
2. 敏感词脱敏替换与搜索结果高亮
/**
 * 敏感词过滤脱敏:将文本中的匹配项替换为指定掩码
 */
function filterSensitiveKeywords(rawText, keywords, mask = '***') {
  if (typeof rawText !== 'string' || rawText.length === 0) {
    return rawText;
  }
  const safeRegExp = createSafeKeywordRegExp(keywords);
  if (!safeRegExp) {
    return rawText;
  }
  return rawText.replace(safeRegExp, mask);
}

/**
 * 关键词高亮显示:在保留原始大小写的前提下包装 mark 标签
 */
function highlightSafeKeywords(rawText, keywords) {
  if (typeof rawText !== 'string' || rawText.length === 0) {
    return rawText;
  }
  const safeRegExp = createSafeKeywordRegExp(keywords);
  if (!safeRegExp) {
    return rawText;
  }
  // 利用 $& 保留原文具体的大小写形态
  return rawText.replace(safeRegExp, '<mark>$&</mark>');
}
3. 实际输入场景验证效果
我们使用包含各种极端特殊字符的真实测试用例,对比转义前后的执行表现:
| 输入关键词 | 未转义直接 new RegExp 的表现 | 经 escapeRegExp 转义后的编译结果 | 实际过滤结果验证 |
|---|---|---|---|
"C++" |
抛出 SyntaxError: Multiple repeat 崩溃 | /C\+\+/gi |
精准匹配 "C++",无报错 |
"[VIP]" |
匹配包含 V、I、P 任一字母,严重误杀 | /\[VIP\]/gi |
仅完整匹配字符串 "[VIP]" |
"a.b" |
点号匹配任意字符,连同 "axb" 一并替换 | /a\.b/gi |
严格匹配字面量 "a.b" |
"$9.99" |
符号 $ 识别为行尾锚点,匹配完全失败 | /\$9\.99/gi |
准确命中价格文本 "$9.99" |
五、纵深防御:超越转义的系统级安全考量
虽然 escapeRegExp 能够百分之百解决“语法解析报错”和“正则结构注入”的问题,但在高并发或大数据量的服务端场景下,仅靠转义仍然存在其他工程边界限制。
1. 关键词物理长度与数量截断
恶意用户虽然无法通过注入特殊字符改变正则语法树,但如果连续发送数万个包含超长随机字符串的词条,生成的正则表达式文本可能会达到数十兆字节。V8 引擎在编译超大正则表达式时需要分配大量堆内存,甚至可能直接造成 Node.js 内存溢出(OOM)。
因此,必须在进入正则编译前设定严密的业务上限:单个关键词长度建议限制在 50 至 100 字符以内;单次批量组合的词条数量建议控制在 200 条以内。
2. 严禁外部可控的“动态嵌套量词”
在任何业务代码中,绝对不要编写类似 new RegExp(`(${escapedWord})+`) 这种在外部变量周围再套一层动态重复量词的代码。这种嵌套形式是催生 ReDoS 的温床。对于关键词过滤,应当只做纯粹的字面值多选分支匹配 (?:a|b|c),保持有限状态机结构的扁平与极简。
3. 海量敏感词库的架构升级:Trie 树与 Aho-Corasick 算法
很多开发团队在项目初期使用正则进行文本过滤,随着敏感词库从几十个扩充到数万个,依然沿用 new RegExp(escapedList.join('|')) 的方案。这会导致显著的性能瓶颈:庞大的正则状态机使得文本扫描的吞吐量急剧下滑,且占用巨大的编译内存。
当关键词数量超过 500~1000 个时,最佳实践是彻底抛弃正则表达式,选用专为多模式字符串匹配设计的算法:
- Trie 树(前缀字典树):通过逐字符构建树状路径,快速判断文本子串是否命中敏感词。
- Aho-Corasick(AC 自动机):在 Trie 树的基础上增加失败跳转指针(Fail Pointer),可以在一次线性扫描文本的过程中同时找出所有命中的敏感词,时间复杂度仅为 $O(n + m)$($n$ 为文本长度,$m$ 为匹配项总数),完全脱离对正则引擎的依赖,从物理层面彻底消除了一切正则注入与回溯风险。
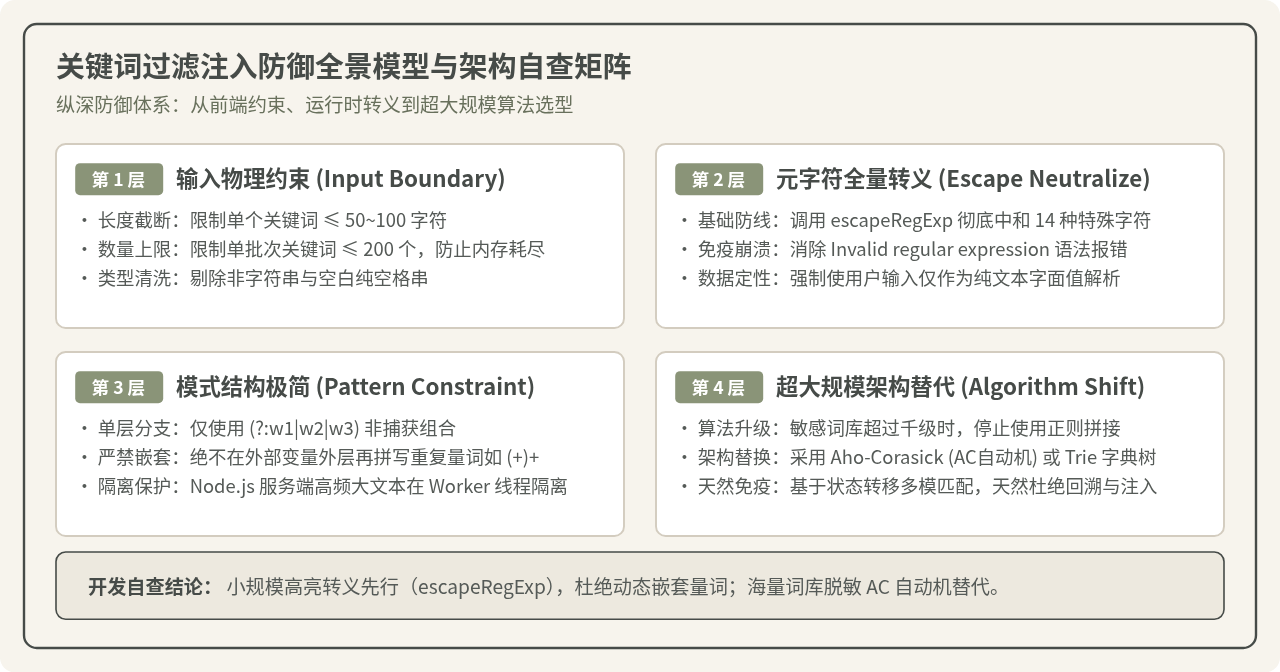
六、安全开发自查清单
工程交付四步检查法
- [ ] 前置过滤:是否检查了输入为合法的
string类型,且做了trim()及长度截断? - [ ] 必经转义:传入
new RegExp()前,是否无一例外地调用了全量覆盖 14 个元字符的escapeRegExp()? - [ ] 模式极简:拼接多词时是否仅使用单层非捕获分支
(?:a|b),严禁拼接额外的外部可控量词? - [ ] 规模适配:关键词库规模是否合理?如超过千条规模,是否已规划切换为 AC 自动机或 Trie 树实现?
高性能场景下JS对象判空的最优解
2026-11-20 18:58:48
JavaScript密码强度正则:从基础到复杂规则的灵活配置
2026-11-20 16:20:43
JS中Math.random与crypto.getRandomValues生成随机字母的区别
2026-11-20 13:36:46
JavaScript localStorage基本用法:增删改查代码示例
2026-11-20 10:53:58
前端JS使用CryptoJS实现AES加密的完整步骤
2026-11-18 21:43:18







