JS浅拷贝与深拷贝的区别:引用传递与值复制详解
深入解析JavaScript中浅拷贝与深拷贝的核心机制。本文从栈内存值复制与堆内存引用传递的底层原理出发,详细拆解展开运算符、Object.assign、structuredClone及手写递归等拷贝方案的运作过程与选型边界。
在日常前端开发中,很多开发者都遇到过这样一个典型场景:从服务器获取了一份用户配置对象 const user = { id: 1, name: "张三", settings: { theme: "dark", notify: true } };,为了在修改弹窗中保留撤销功能,便习惯性地使用展开运算符创建了一个新副本 const form = { ...user };。但在弹窗中将 form.settings.theme 修改为 "light" 时,原本的主页面背景却瞬间联动变白——原数据 user.settings.theme 竟然也被同步篡改了。
这种看似“复制了但又没完全复制”的现象,正是没有理清 JavaScript 中浅拷贝与深拷贝底层运行机制所导致的典型缺陷。JavaScript 引擎对基础数据类型与引用数据类型采用了完全不同的内存存储与赋值机制。本文将从底层栈堆内存模型出发,全面剖析值复制与引用传递的本质差异,并详细讲解浅拷贝与深拷贝的运作流程、常见实现方案以及工程选型策略。
一、底层基石:栈内存与堆内存、值复制与引用传递
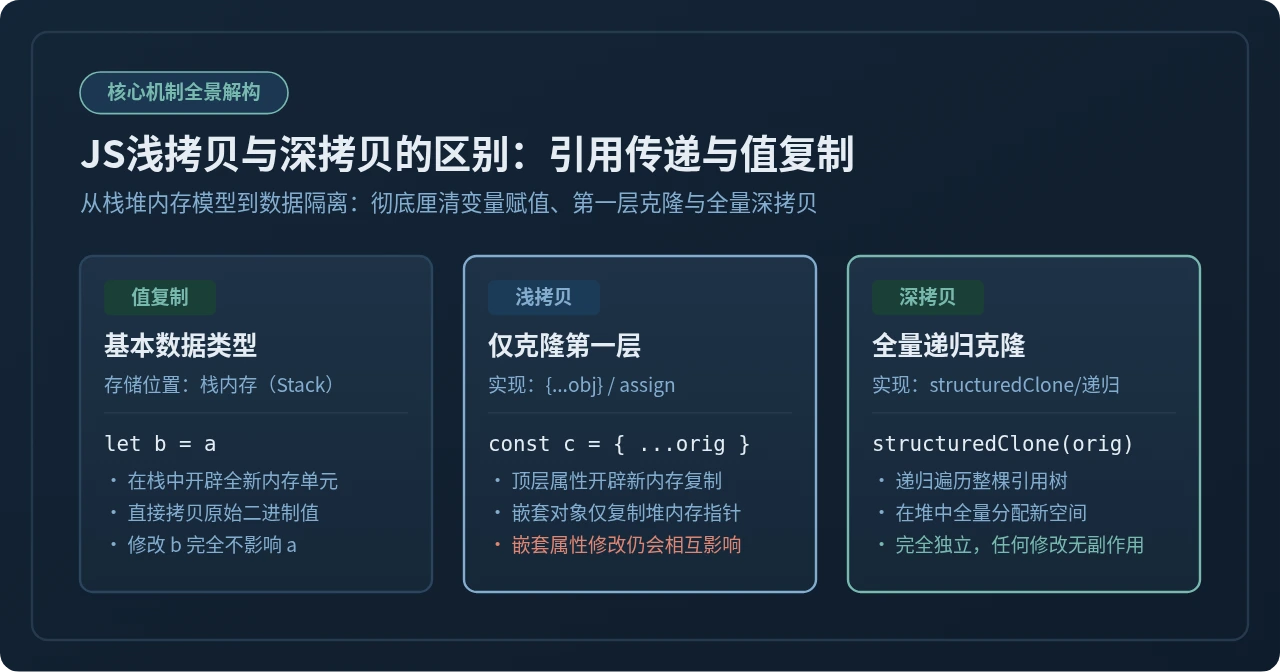
要透彻理解拷贝的差异,必须首先回归 JavaScript 的内存架构。在 V8 等主流 JavaScript 引擎中,内存被清晰地划分为栈内存(Stack)与堆内存(Heap)两大区域:
- 基本数据类型(Primitive Types):包括
Number、String、Boolean、null、undefined、Symbol与BigInt。它们的值在编译期即可确定固定大小,直接保存在栈内存中,由系统自动分配和释放。 - 引用数据类型(Reference Types):包括
Object、Array、Function、Date、RegExp、Map、Set等。由于其大小不固定且可动态增删属性,其实体数据存储在堆内存中;而保存在栈内存中的,仅仅是一个指向该堆内存地址的指针(Reference Pointer)。
执行
let obj2 = obj1; 时,引擎在栈内存中为变量 obj2 分配了空间,但写入的内容仅仅是 obj1 所保存的堆内存地址指针。两个变量本质上拿着同一把“钥匙”开同一扇门,任何一方对属性的修改都会在同一个堆对象上生效。赋值只是引用的传递,没有克隆出任何独立的数据实体。
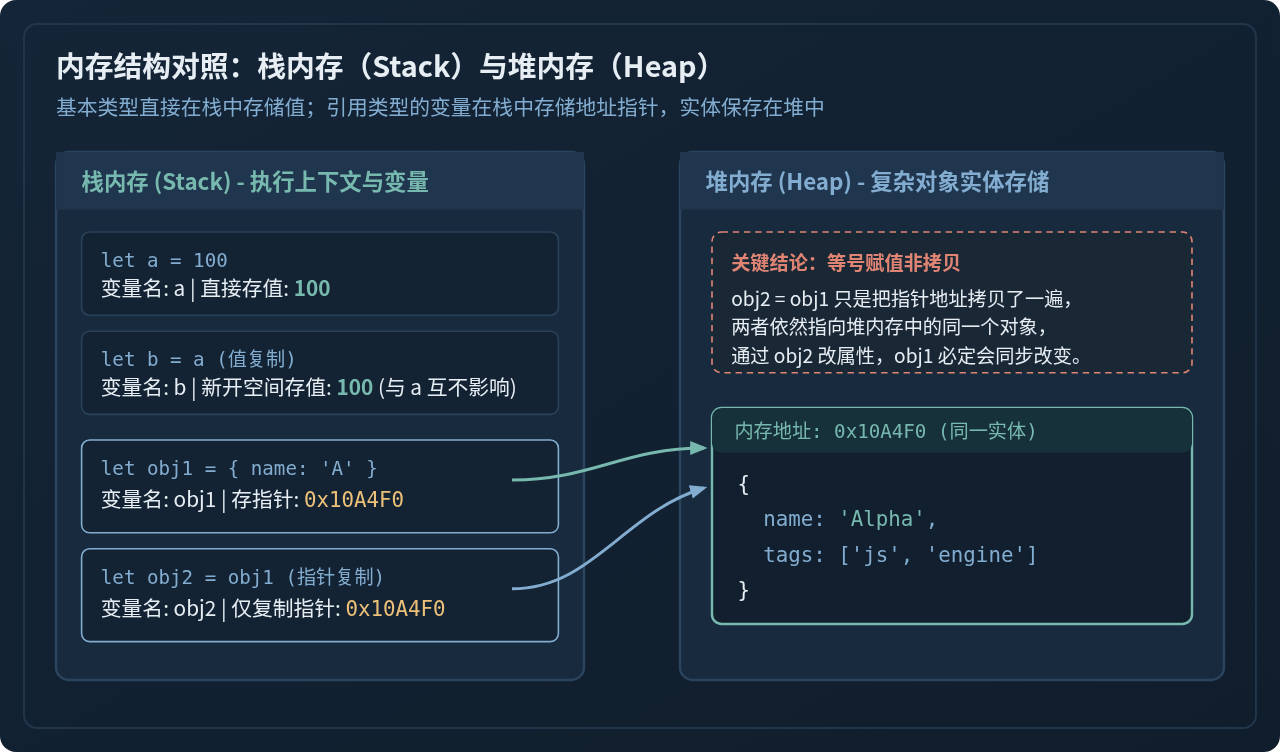
当执行基本类型变量的赋值时(如 let b = a;),引擎在栈内存中开辟全新单元,直接将 a 的二进制数值完整克隆写入 b。两者完全独立,后续对 b 的任何重新赋值都不会对 a 产生任何波及。这就是纯粹的值复制。
二、浅拷贝(Shallow Copy):机制剖析与常见实现
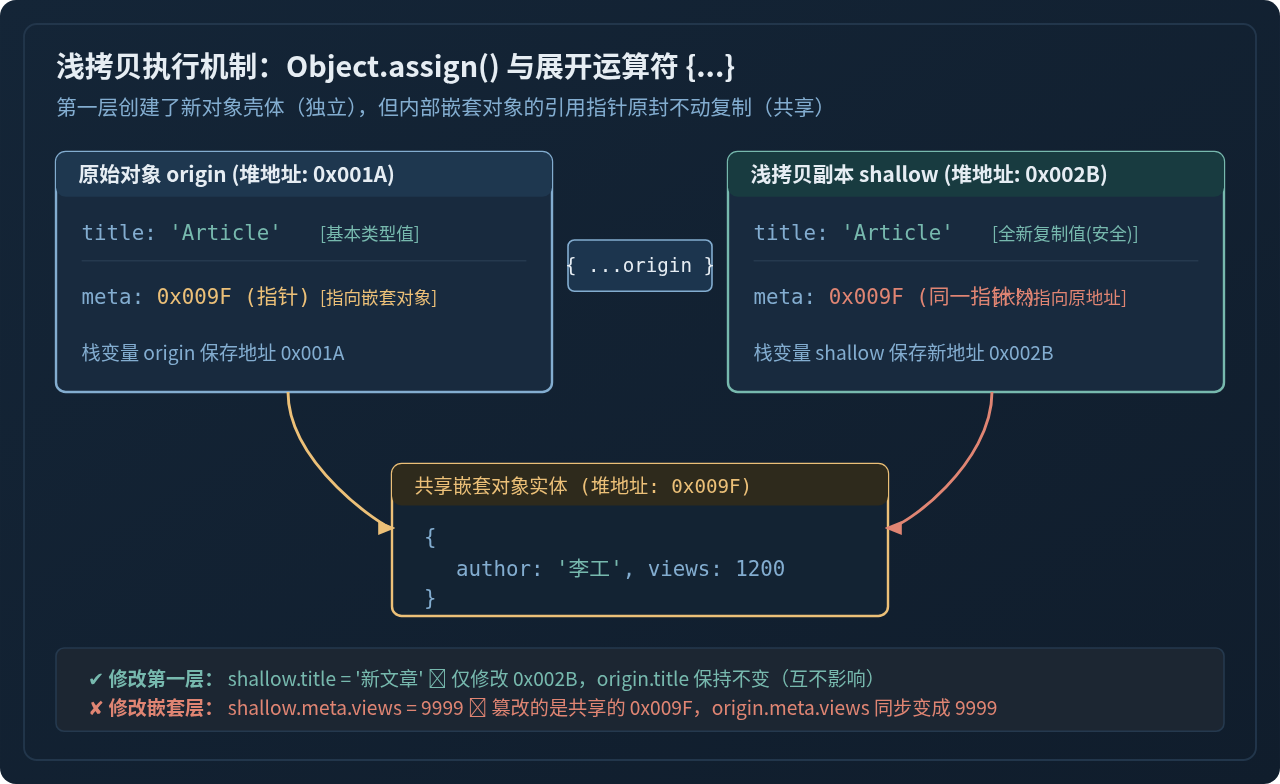
所谓浅拷贝,是指创建一个全新的对象或数组,并遍历原对象的第一层可枚举属性进行复制。它的边界非常明确:
- 对于第一层的基本类型属性,执行值复制,在新对象中写入独立的数值;
- 对于第一层的引用类型属性,执行指针复制,新对象对应的属性仅仅拷贝了内存地址,与原对象共同指向同一个堆内存实体。
常见浅拷贝实现方式
在现代 JavaScript 中,实现浅拷贝的方式简单且多样:
// 1. 展开运算符(Spread Operator)——最常用
const objCopy = { ...originObj };
const arrCopy = [ ...originArr ];

// 2. Object.assign() 方法
const assignCopy = Object.assign({}, originObj);

// 3. 数组原型方法
const sliceArr = originArr.slice();
const concatArr = originArr.concat();
const fromArr = Array.from(originArr);
代码实测与行为验证
我们通过一段具体的示例代码来验证浅拷贝的隔离边界:
const source = {
  id: 101,
  title: "架构指南",
  meta: {
    author: "张工",
    stars: 50
  }
};

// 执行浅拷贝
const shallow = { ...source };

// 1. 修改第一层基本类型:完全安全
shallow.title = "前端深度解析";
console.log(source.title); // 输出示例: "架构指南" (原对象未受影响)

// 2. 修改嵌套引用类型:产生副作用
shallow.meta.stars = 999;
console.log(source.meta.stars); // 输出示例: 999 (原对象被同步修改!)
浅拷贝的执行速度极高,仅需遍历一次第一层键值即可完成,内存占用也非常小。因此,如果待操作的数据是完全扁平的单一层级结构,浅拷贝是性能最佳、代码最优雅的理想选择。
三、深拷贝(Deep Copy):实现路径与关键难题
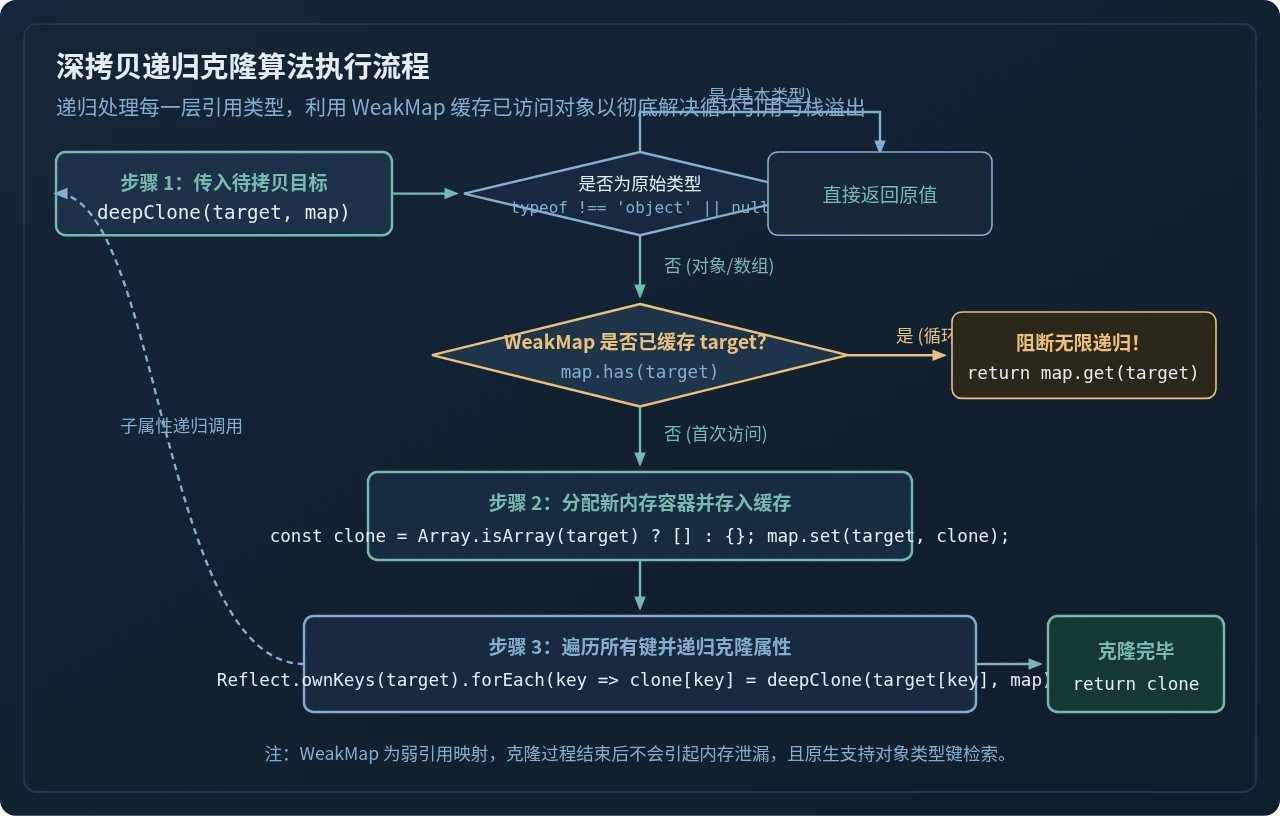
深拷贝的目标是切断原对象与其副本之间所有层级的内存关联。它会沿着对象的属性树一路递归向下,凡是遇到引用类型(对象、数组),就在堆内存中全新分配一块独立的存储空间并递归克隆其内部属性,直到整棵对象树的所有分支全部完成独立复制。
深拷贝后的副本与原始对象是两棵完全镜像但彼此独立的“数据树”,在任何层级对任何属性的修改都绝不会产生任何副作用。
实现方案一:JSON 序列化与反序列化
在简单的业务场景中,很多开发者会使用 JSON.parse(JSON.stringify(obj)) 实现快速深拷贝:
const deep = JSON.parse(JSON.stringify(origin));- 属性静默丢失:值为
undefined、Function或Symbol的属性在序列化后会被直接忽略剔除。 - 日期类型退化:
Date对象会被转换为 ISO 字符串,无法还原为原生的日期实例。 - 正则与错误类型失真:
RegExp和Error对象会被序列化成空对象{}。 - 特殊数值转换异常:
NaN、Infinity和-Infinity会被强制转换为null。 - 循环引用直接崩溃:如果对象内部存在自引用或环形引用(例如
obj.self = obj),会直接抛出TypeError: Converting circular structure to JSON导致程序崩溃。
实现方案二:现代浏览器原生 API structuredClone()
从 ECMAScript 2022 及 HTML 规范更新开始,各大主流浏览器(Chrome 98+、Firefox 94+、Safari 15.4+)以及 Node.js 17+ 原生内置了 structuredClone() 全局函数:
const original = {
  date: new Date(),
  regex: new RegExp("^test$", "g"),
  map: new Map([["k", "v"]]),
  set: new Set([1, 2, 3])
};

// 原生结构化克隆
const cloned = structuredClone(original);
structuredClone() 采用了底层的结构化克隆算法,原生支持 Date、RegExp、Map、Set、ArrayBuffer 以及循环引用处理,性能优于纯 JS 解释执行的递归函数。但需注意:它不允许克隆函数、DOM 节点以及带有 getter/setter 的特殊原型对象,遇到此类属性时会抛出 DataCloneError。
实现方案三:手写完备深拷贝(WeakMap 解决循环引用)
在底层工具库或需要兼顾旧环境与复杂自定义对象的生产场景中,手写递归深拷贝是最可靠的方案。关键在于引入 WeakMap 建立原对象与克隆对象的映射缓存,在进入每个嵌套节点前优先检查缓存,以此避免死循环:
/**
 * 完备深拷贝实现
 * @param {*} target 待拷贝目标
 * @param {WeakMap} hash 缓存映射表,防止循环引用导致栈溢出
 * @returns {*} 完全隔离的深度克隆副本
 */
function deepClone(target, hash = new WeakMap()) {
  // 1. 如果是基本类型或 null,直接返回原值
  if (target === null || typeof target !== 'object') {
    return target;
  }

  // 2. 特殊引用类型单独实例化处理
  if (target instanceof Date) return new Date(target);
  if (target instanceof RegExp) return new RegExp(target.source, target.flags);

  // 3. 检查缓存:命中已克隆过的对象,直接返回缓存引用,消除循环引用风险
  if (hash.has(target)) {
    return hash.get(target);
  }

  // 4. 保持原型链与构造器,初始化新数组或新对象
  const cloneTarget = new target.constructor();
  hash.set(target, cloneTarget);

  // 5. 处理 Map 类型
  if (target instanceof Map) {
    target.forEach((val, key) => {
      cloneTarget.set(deepClone(key, hash), deepClone(val, hash));
    });
    return cloneTarget;
  }

  // 6. 处理 Set 类型
  if (target instanceof Set) {
    target.forEach(val => {
      cloneTarget.add(deepClone(val, hash));
    });
    return cloneTarget;
  }

  // 7. 使用 Reflect.ownKeys 获取包括 Symbol 及普通属性在内的所有自有键
  Reflect.ownKeys(target).forEach(key => {
    cloneTarget[key] = deepClone(target[key], hash);
  });

  return cloneTarget;
}
四、对比总结与生产环境选型指南
面对具体的业务开发,并不是所有场景都要无脑使用深拷贝。深拷贝需要递归遍历整棵对象树并在堆中大量分配新内存,其 CPU 计算开销与内存占用显著高于浅拷贝。合理的架构应当在“数据修改隔离”与“运行性能”之间取得平衡。
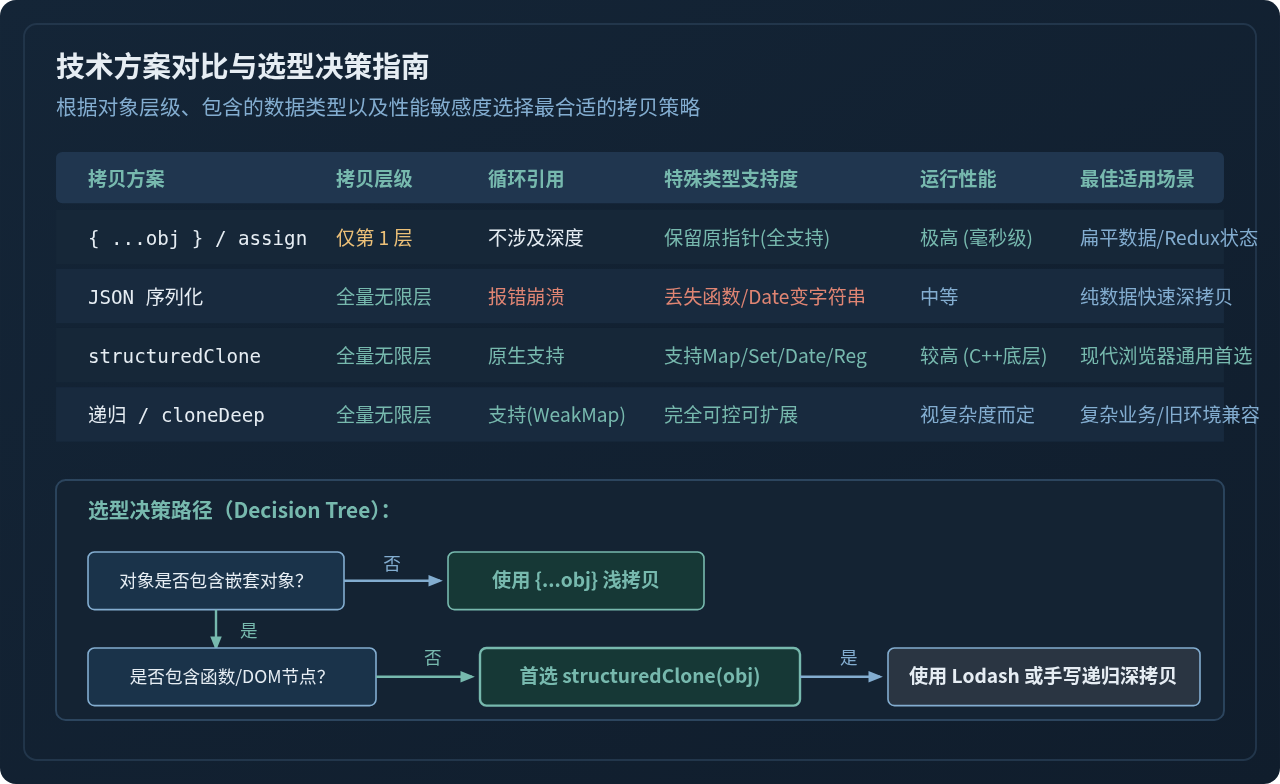
横向对比决策表格
| 方案类型 | 代表性 API | 拷贝深度 | 循环引用支持 | 适用典型场景 |
|---|---|---|---|---|
| 浅拷贝 | { ...obj } / Object.assign() |
仅第 1 层 | 不涉及深度处理 | 组件 Props 解构、Redux 不可变数据浅更新、扁平配置项合并 |
| 简易深拷贝 | JSON.parse(JSON.stringify()) |
全量深层 | 抛出 TypeError 异常 | 纯 JSON 结构数据的快速脱敏与快照存储 |
| 原生结构化深拷贝 | structuredClone() |
全量深层 | 原生内部支持 | 现代浏览器业务数据全量复制、复杂表单状态备份 |
| 完备递归深拷贝 | Lodash.cloneDeep / 自定义递归 |
全量深层 | 通过 WeakMap 映射支持 | 包含特殊函数或自定义类的复杂状态树、低版本浏览器环境 |
避坑建议与工程守则
- 区分状态更新粒度:在 React 或 Vue 等现代前端框架中,由于框架依赖对象的引用变动(如浅层比较
Object.is)触发重新渲染,滥用深拷贝会不仅导致过度的垃圾回收(GC),还可能打破精准更新机制。对于浅层状态变化,优先使用浅拷贝展开更新受影响的属性。 - 优先使用原生 API:在现代 Node.js 与主流浏览器支持度已达标的生产项目中,应优先选用
structuredClone(),避免引入冗余的第三方体积包。 - 敏感边界提前防御:当拷贝来源于外部第三方输入或用户表单的未知深度对象时,严禁使用裸露的
JSON.stringify,必须做好try...catch或使用防环形引用的深拷贝算法,防止内存爆栈导致主线程卡死。
JS数组取最大值:Math.max配合展开运算符的用法与限制
2026-11-20 17:33:00
轻量级 JS 库实现简单 Excel 导出的代码示例
2026-11-20 17:24:01
Object.keys、getOwnPropertyNames与Reflect.ownKeys统计对象长度对比
2026-11-20 17:15:00
JavaScript私有变量无法被JSON.stringify序列化的原因与解决
2026-11-20 16:54:58
JS怎么对对象数组中的字符串属性进行排序?
2026-11-20 16:13:06