JS同时求多个数组公共交集的方法
深入解析在 JavaScript 中同时求多个数组公共交集的实用方法。讲解 Array.reduce 配合 Set 的递推收敛方案、短数组锚定短路优化、现代 ES2024 Set.prototype.intersection 原生规范以及复杂对象数组的求交集实践。
假设你正在开发一套多维度权限管理系统,某个用户同时被分配了“业务运维”、“数据审计”和“区域主管”三个角色。每个角色在数据库中对应一组权限代码数组,系统需要迅速计算出该用户在三套角色体系下同时拥有的“核心通用权限”。又或者在电商多标签检索场景中,需要找出同时被打上“新品上架”、“热销推荐”与“限时包邮”三个标签的共有商品 ID。这些业务诉求在本质上都是同一个算法问题:如何高效求出任意 N 个数组的公共交集。
在 JavaScript 中,求两个数组的交集通常只需一次 filter 即可搞定,但当参与计算的数组增加到 3 个、5 个甚至成百上千个时,如果简单地使用多层嵌套循环或连环使用 Array.prototype.includes,时间复杂度会急剧恶化。本文将从实用基准方案出发,逐步解析 reduce 配合 Set 的递推收敛模式、面对极度不均数据时的短数组锚定优化,以及最新的 ES2024 原生集合方法与对象数组交集处理方案。
一、多数组公共交集的数学本质与推导机制
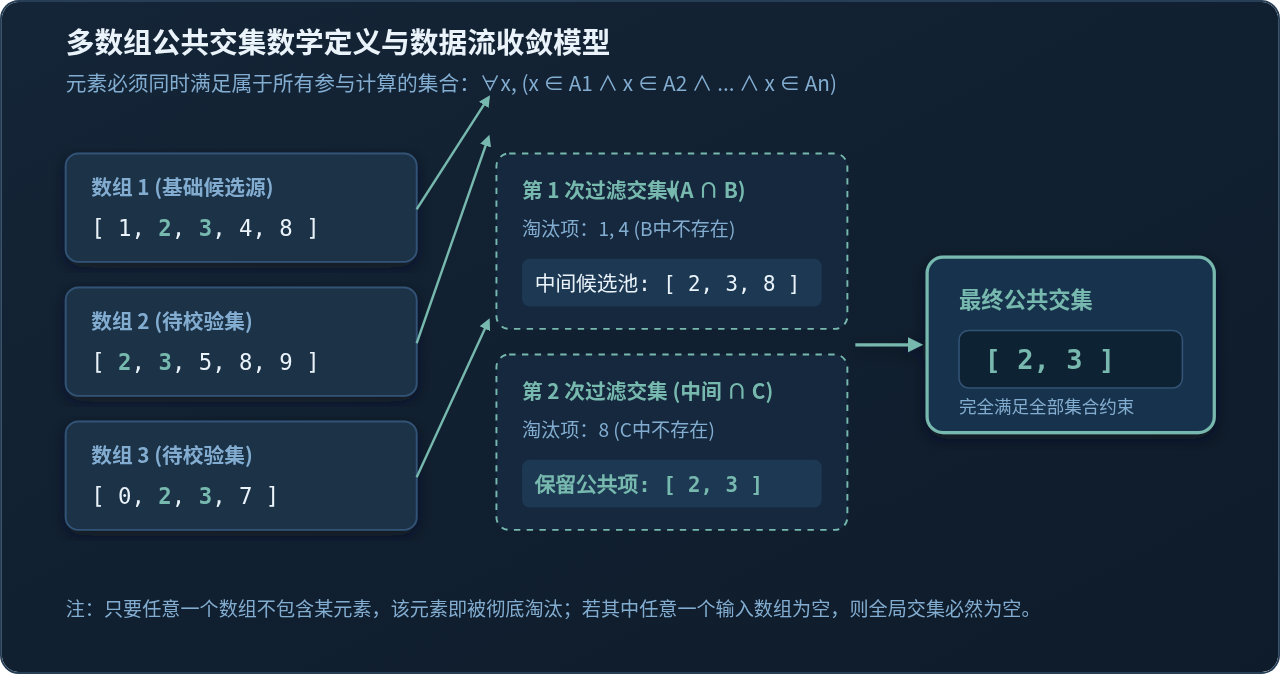
从数学集合论的角度来看,求多个集合 A1, A2, ..., An 的公共交集具有结合律与交换律:
A1 ∩ A2 ∩ A3 ∩ ... ∩ An = ((...((A1 ∩ A2) ∩ A3) ...) ∩ An)
这一数学性质直接决定了我们在代码中的求解策略:流式递推(Reduce 模式)。即我们可以先选定一个基准集合作为候选结果池,然后依次将其与下一个集合求交集,候选池在每一次交集运算后都会单调缩窄或保持不变,直到遍历完所有输入数组。
在推导过程中需要牢记以下两个核心结论:
- 一票否决权:只要候选元素在任意一个数组中缺失,该元素在后续计算中就不可能复活,应立即被淘汰。
- 空集短路:如果输入参数中存在任意一个空数组
[],或者递推过程中候选池提前归零,则全局交集必然为空数组[],无需继续比对剩余数组。
二、实用基础解法:reduce 配合 Set.has
这是目前各主流前端项目及 Node.js 业务中最推荐的通用写法。它兼顾了语法的极致简练与优秀的运行效率。
1. 完整实现代码
/**
 * 获取任意多个数组的公共交集(基础通用版)
 * @param {...Array<any>} arrays 待计算交集的数组列表
 * @returns {Array<any>} 去重后的公共交集数组
 */
function getIntersection(...arrays) {
  // 边界情况 1:未传入任何参数,直接返回空数组
  if (arrays.length === 0) {
    return [];
  }

  // 边界情况 2:如果其中任意一个数组为空,公共交集必然为空
  if (arrays.some(arr => !arr || arr.length === 0)) {
    return [];
  }

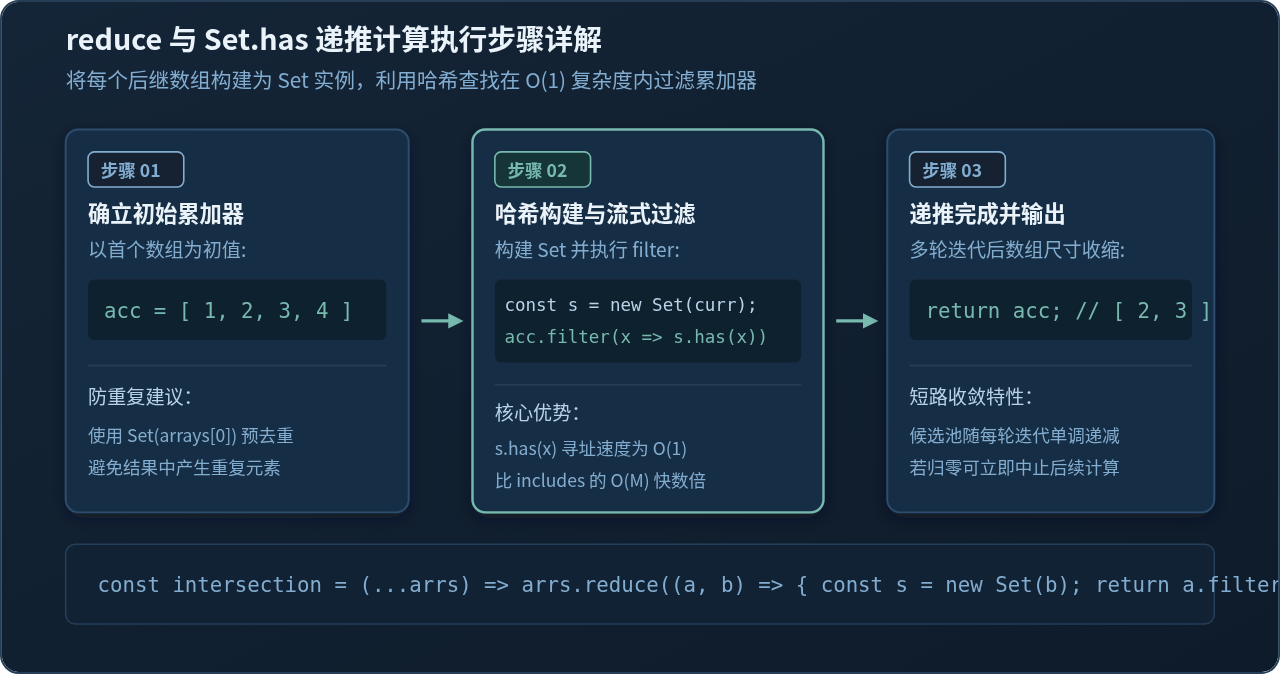
  // 使用 reduce 进行流式递推收敛
  // 使用 new Set(arrays[0]) 对首个基准数组去重,避免输出重复结果
  const initialBase = Array.from(new Set(arrays[0]));

  return arrays.slice(1).reduce((accumulator, currentArray) => {
    // 将当前遍历的数组转为 Set,获得 O(1) 的查询时间复杂度
    const currentSet = new Set(currentArray);

    // 仅保留存在于当前 Set 中的候选元素
    return accumulator.filter(item => currentSet.has(item));
  }, initialBase);
}

// 示例验证:
const listA = [1, 2, 3, 4, 2];
const listB = [2, 3, 5, 8];
const listC = [2, 3, 7, 9];

console.log(getIntersection(listA, listB, listC));
// 输出结果:[ 2, 3 ]
2. 为什么必须将比较数组转为 Set?
很多初学者会习惯写出如下看似简短的代码:
// 性能隐患的反面教材:勿在循环内部使用 includes
arrs.reduce((acc, curr) => acc.filter(x => curr.includes(x)));
虽然语法正确,但 Array.prototype.includes 在底层是线性遍历,查找单个元素的时间复杂度为 O(M)(M 为当前数组长度)。如果累加器有 N 个元素,每一次过滤就需要进行 N × M 次比较。而将 curr 封装为 Set 后,Set.prototype.has 基于哈希表寻址,平均查找复杂度为常数级 O(1)。即使加上构建 Set 的一次性 O(M) 开销,总体复杂度也从乘积关系降低到了求和关系,对于稍大规模的数据集性能提升可达数十倍。
三、性能升级:短数组锚定与短路求值策略
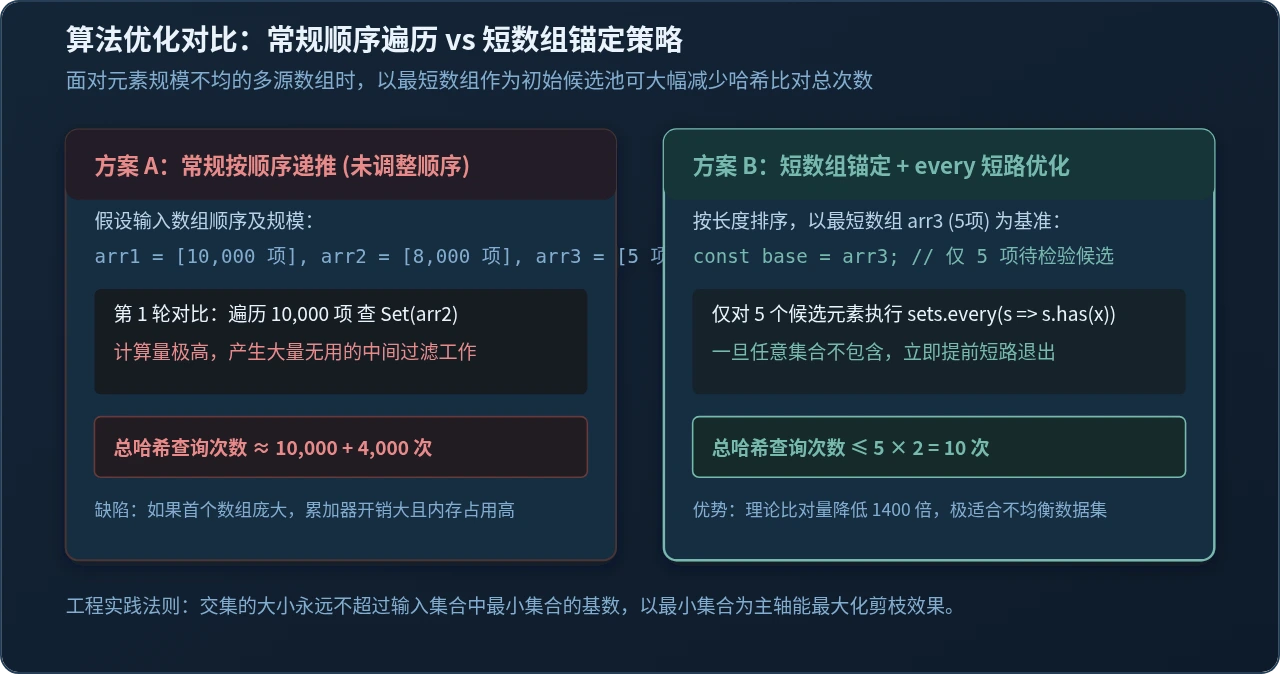
虽然基础的 reduce 写法已足够高效,但在真实生产环境中,参与计算的数组规模往往相差悬殊。例如:
- 数组 A:包含 100,000 个全量系统商品 ID;
- 数组 B:包含 50,000 个在售商品 ID;
- 数组 C:包含仅 4 个当前特惠推荐的商品 ID。
如果直接按照传参顺序递推,以数组 A 作为初始累加器,程序在第一轮就要用 100,000 个元素去检索集合 B,这造成了极其庞大且不必要的计算量与内存临时对象分配。
1. 短数组锚定核心思路
因为公共交集的元素上限受制于最短的那一个数组,所以最优策略是:先找出长度最短的数组作为候选池锚点,并将其余所有较长数组构造成 Set。然后遍历最短数组中的非重复元素,利用 Array.prototype.every 进行逐一检验。
2. 优化实现代码
/**
 * 高性能版多数组公共交集(短数组锚定 + every 短路优化)
 * 专为规模悬殊或较大数据集设计
 */
function getFastIntersection(...arrays) {
  if (arrays.length === 0) return [];

  // 快速排空:只要有一个数组为空,交集必然为空
  for (let i = 0; i < arrays.length; i++) {
    if (!arrays[i] || arrays[i].length === 0) return [];
  }

  // 如果仅传入一个数组,直接对其去重返回
  if (arrays.length === 1) {
    return Array.from(new Set(arrays[0]));
  }

  // 1. 按数组长度升序排列(浅拷贝引用,不污染原数组)
  const sortedArrays = [...arrays].sort((a, b) => a.length - b.length);
  const shortest = sortedArrays[0];
  const otherArrays = sortedArrays.slice(1);

  // 2. 将剩余的所有较长数组提前转化为 Set 实例
  const otherSets = otherArrays.map(arr => new Set(arr));

  // 3. 对最短数组去重,作为唯一的检验样本源
  const uniqueCandidates = new Set(shortest);
  const result = [];

  // 4. 逐一检验候选元素,借助 every 实现短路退出
  for (const item of uniqueCandidates) {
    // 只要在任意一个集合中不存在,立即中止检查下一个集合
    if (otherSets.every(s => s.has(item))) {
      result.push(item);
    }
  }

  return result;
}
otherSets.every(s => s.has(item)) 具备天然的短路求值(Short-circuit Evaluation)特性:一旦在第一个长数组的 Set 中未发现 item,它便会立即返回 false,根本不会对后续的集合发起无意义的哈希查询。
四、现代规范:ES2024 原生 Set.prototype.intersection
ECMAScript 2024 官方正式引入了集合操作提案(Set Methods),为 Set 原型链增加了 intersection、union、difference 等原生方法。如果你的项目运行在较新的运行环境中(如 Node.js 22+、Chrome 122+、Safari 17+ 等),可以直接利用标准内建方法完成求交集操作。
/**
 * 基于 ES2024 Set 原生方法的多数组交集实现
 */
function getES2024Intersection(...arrays) {
  if (arrays.length === 0) return [];
  if (arrays.some(arr => !arr || arr.length === 0)) return [];

  // 将所有数组转为 Set
  const sets = arrays.map(arr => new Set(arr));

  // 利用原生 Set.prototype.intersection 逐步折叠
  const intersectedSet = sets.reduce((accumulatedSet, currentSet) => {
    return accumulatedSet.intersection(currentSet);
  });

  return Array.from(intersectedSet);
}
原生 intersection 由 JavaScript 引擎(如 V8)在底层 C++ 实现,不需要由 JavaScript 虚拟机逐项执行回调函数,具备更好的指令集执行效率。但在遗留浏览器(如低版本 Chrome 或旧版微信内置浏览器)中需要引入 core-js 进行 Polyfill。
五、特殊场景:对象数组与唯一属性求交集
在实际企业级业务中,前端从后端接口获取的往往不是纯数字或字符串数组,而是带有唯一标识字段(如 id 或 uuid)的对象数组:
const groupA = [{ id: 1, name: 'Alice' }, { id: 2, name: 'Bob' }];
const groupB = [{ id: 2, name: 'Bob' }, { id: 3, name: 'Charlie' }];
由于 JavaScript 中对象比较的是引用地址({ id: 2 } !== { id: 2 }),直接将其传入 new Set() 无法识别相同 ID 的数据对象。此时必须通过“主键提取器”或 Map 来建立映射。
/**
 * 依据指定属性 key 或自定义函数求对象数组公共交集
 * @param {string|Function} keyProp 唯一键名或提取函数
 * @param {...Array<Object>} arrays 对象数组列表
 */
function getObjectIntersectionBy(keyProp, ...arrays) {
  if (arrays.length === 0) return [];
  if (arrays.some(arr => !arr || arr.length === 0)) return [];

  // 统一定义提取 key 的辅助函数
  const getKey = typeof keyProp === 'function'
    ? keyProp
    : item => item?.[keyProp];

  // 1. 以第一个数组建立 Map,保留原始对象引用
  const baseMap = new Map();
  for (const item of arrays[0]) {
    const k = getKey(item);
    if (k !== undefined && !baseMap.has(k)) {
      baseMap.set(k, item);
    }
  }

  // 2. 将后续所有数组转为只包含 key 的 Set 列表
  const otherKeySets = arrays.slice(1).map(arr => {
    return new Set(arr.map(getKey));
  });

  // 3. 过滤 baseMap,仅保留其 key 在所有后续 Set 中均存在的原始对象
  const result = [];
  for (const [key, originalItem] of baseMap.entries()) {
    if (otherKeySets.every(set => set.has(key))) {
      result.push(originalItem);
    }
  }

  return result;
}

// 业务调用示例:
const users1 = [{ id: 101, name: '张三' }, { id: 102, name: '李四' }];
const users2 = [{ id: 102, name: '李四' }, { id: 103, name: '王五' }];
const users3 = [{ id: 102, name: '李四' }, { id: 105, name: '钱六' }];

const commonUsers = getObjectIntersectionBy('id', users1, users2, users3);
console.log(commonUsers);
// 输出结果:[ { id: 102, name: '李四' } ]
六、方案选型与边界异常避坑指南
为了让算法在各种边缘条件下始终保持健壮,以下是选型决策依据与常见边界排查清单:
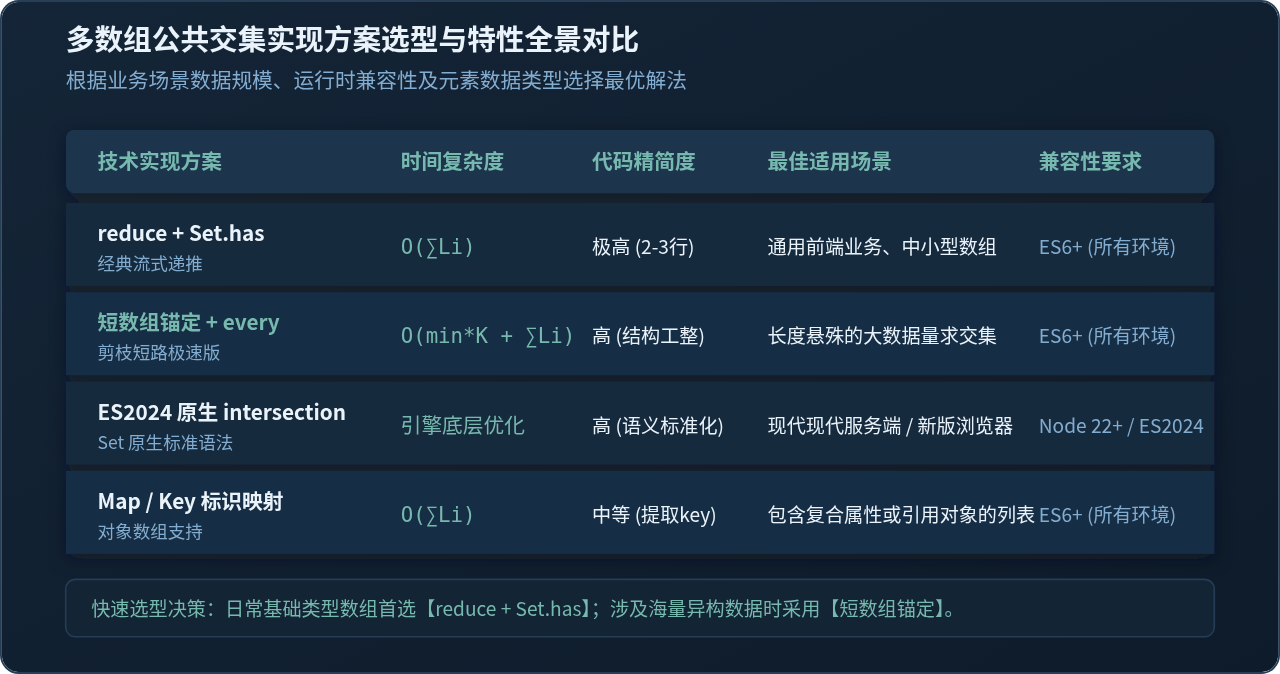
1. 方案选型综合评估
| 技术方案 | 时间复杂度 | 空间复杂度 | 优点 | 缺点 / 限制 |
|---|---|---|---|---|
| reduce + Set.has | O(∑Li) | O(max Li) | 代码简练直观,支持所有 ES6+ 运行环境 | 当首个数组极长而后继数组极短时存在冗余过滤 |
| 短数组锚定 + every | O(min L · K + ∑Li) | O(∑Li) | 数据规模差异大时比对次数最少,支持提前短路 | 需要对数组进行预排序和全量 Set 转换 |
| ES2024 原生 intersection | 引擎底层优化 | O(∑Li) | 标准化语言原生语义,代码高度声明式 | 旧版浏览器及 Node.js < 22 环境需要 Polyfill |
| Map 属性键值提取 | O(∑Li) | O(∑Li) | 支持带有业务属性的复杂对象数组与自定义规则 | 需指定键名,内存占用稍高于基础类型集合 |
2. 常见边界与陷阱排查
- 输入数组内部存在重复元素:如果传入的数组为
[1, 1, 2]与[1, 2],普通的filter可能会输出[1, 1, 2]。根据集合论交集定义,应在初始候选数组阶段通过new Set(arr)进行预去重,保证输出的每个公共交集项只出现一次。 - 包含特殊值 NaN:JavaScript 中传统的
arr.indexOf(NaN)会返回-1,导致无法匹配自身;但Set.prototype.has(NaN)在规范中判定NaN彼此相等,使用Set能自动正确处理NaN的交集计算。 - 传入非数组或空参数:封装公共工具库函数时,应严格通过
Array.isArray()检验输入项,或者通过解构默认值处理参数缺失,杜绝因对undefined调用方法引发的白屏报错。
日常前端业务(如几十到上千条数据的筛选、角色标签过滤)直接采用 reduce + Set.has 方案;如果在处理日志分析、报表比对等海量大数据或长度差异悬殊的场景,建议采用 短数组锚定 + 短路求值 策略以榨干 CPU 性能。
JavaScript Map常用方法详解:set、get、has与delete
2026-11-19 08:08:03
JavaScript闭包经典代码示例与内存泄漏风险解析
2026-11-18 23:55:33
IE11找不到JavaScript设置选项怎么办
2026-11-18 21:18:33
JS字符串反转:split('').reverse().join('')的标准用法与局限
2026-11-18 20:06:22
JavaScript原生实现颜色相似度计算:RGB欧氏距离算法详解
2026-11-18 19:57:18