JS字符串反转:split('').reverse().join('')的标准用法与局限
深入解析 JavaScript 中常用链式调用 str.split('').reverse().join('') 反转字符串的标准用法、执行机制与时空开销,并详细分析其在处理 UTF-16 代理对 Emoji、组合音标字符时的严重局限与现代标准解决方案。
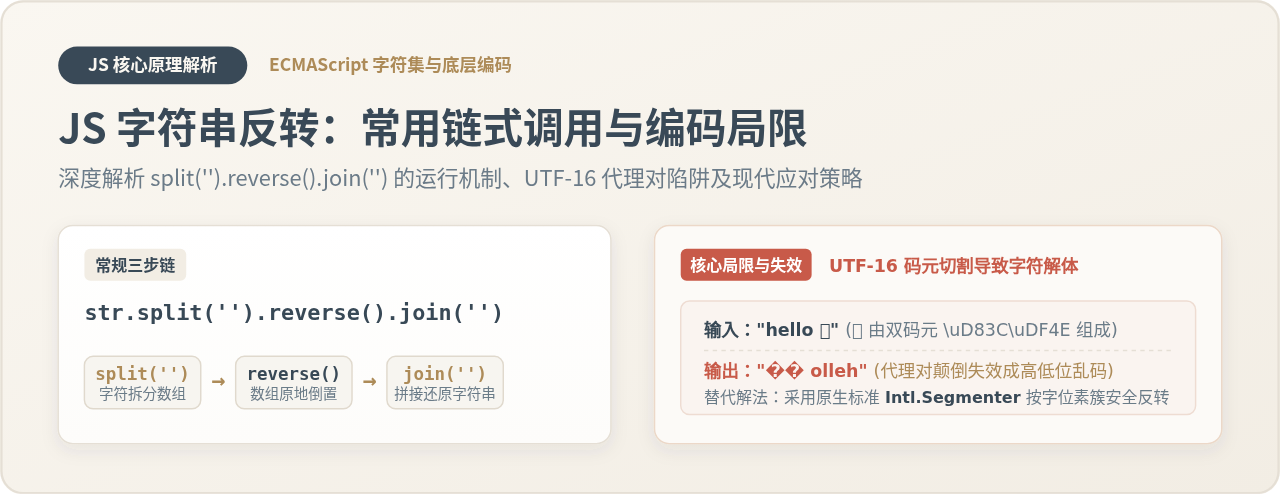
str.split('').reverse().join('')。这种三步链式调用直观高效,能够完美处理纯英文字符、数字和常见 ASCII 文本;但当面对 Emoji 表情(UTF-16 代理对)、变音符号或复杂组合字符时,它会暴露出严重的编码截断与字符错位缺陷。本文将从执行机制、内存变化、底层编码根源及现代原生方案四个维度,完整剖析这一写法的标准用法与技术边界。
一、标准用法:三步链式调用的基本形式与完整示例
JavaScript 的基本数据类型 String 是不可变值(Immutable),其原型链上并没有直接提供类似 str.reverse() 的就地修改方法。因此,开发者通常需要借助数组的 Array.prototype.reverse() 方法完成反转,再将数组元素拼回字符串。
最标准的实现代码如下所示:
JavaScript标准三步调用示例function reverseStringClassic(str) {
  if (typeof str !== 'string') {
    throw new TypeError('参数必须是字符串类型');
  }
  return str.split('').reverse().join('');
}

// 验证示例
const input1 = "hello";
console.log(reverseStringClassic(input1)); // 输出: "olleh"

const input2 = "JavaScript 2026";
console.log(reverseStringClassic(input2)); // 输出: "6202 tpircSavaJ"

const input3 = "上海自来水来自海上";
console.log(reverseStringClassic(input3)); // 输出: "上海自来水来自海上" (回文验证通过)
在上述代码中,reverseStringClassic 接收一个字符串,完成输入类型守卫后,依次调用三个方法。对于常规单词、数字序列或由单字构成的基础汉字文本,此方法语法精炼,无需手动编写复杂的索引递减循环。
二、分步推导:三步链式的底层运作与时空开销
为了准确评估该写法的运行性能,必须逐一拆解这三个原生方法在引擎内部的具体行为:
-
第一步
str.split(''):以空字符串作为分隔符对原始字符串进行切片。V8 等 JavaScript 引擎会扫描字符串缓冲区,为每个字符分配一个独立的字符串对象并装入全新创建的Array堆内存中。这个过程需要遍历整个字符串,时间复杂度为 O(n),并且产生 O(n) 的数组内存分配开销。 -
第二步
Array.prototype.reverse():对刚生成的临时数组执行原地翻转(In-place reversal)。引擎通过首尾双指针向中心移动,依次交换对称位置的元素指针,交换次数约为 n/2。该方法不分配额外的主数组空间,时间复杂度为 O(n)。 -
第三步
Array.prototype.join(''):以空字符串作为连接符,遍历逆序后的数组,将所有元素按序拷贝到一个全新分配的连续字符串缓冲区中,最终返回新字符串。遍历与内存聚合的时间复杂度同样为 O(n)。
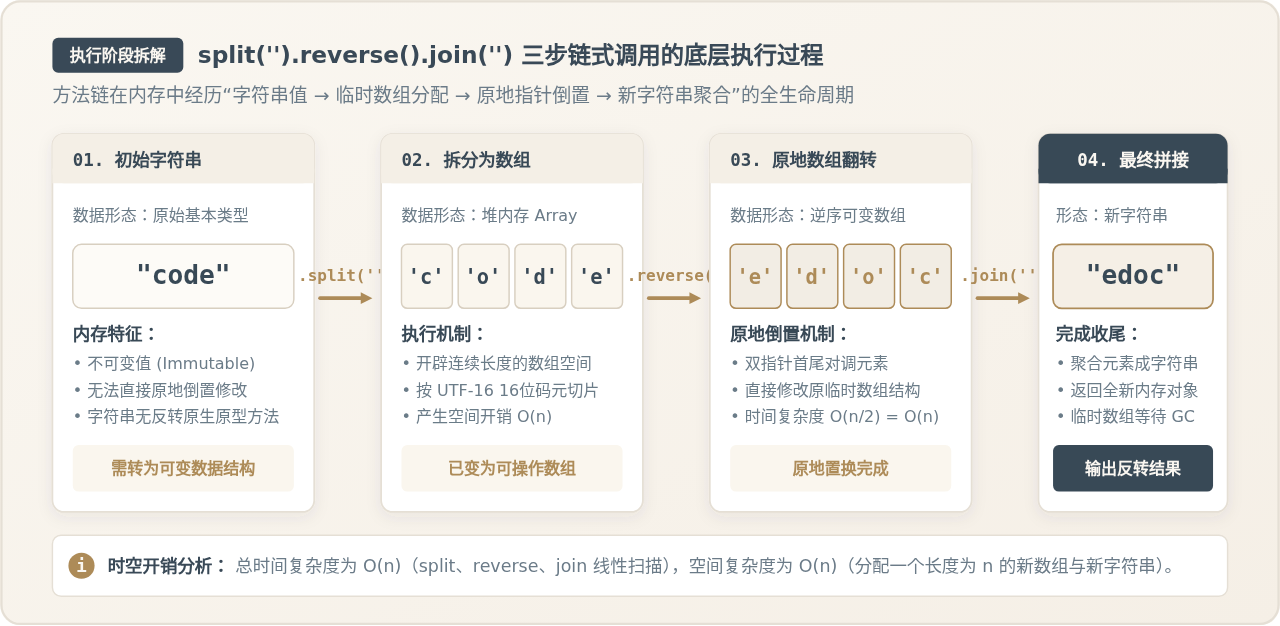
性能总结:该链式调用的整体时间复杂度为严格的 O(n),空间复杂度同样为 O(n)。在执行过程中,它隐式创建了一个长度为 n 的中间数组对象,该中间对象在方法执行完毕后便失去引用,沦为垃圾回收(GC)的目标。在极高频调用(如高并发文本清洗循环)中,频繁创建与销毁中间数组会加重引擎垃圾回收器的瞬时压力。
三、局限性根源:JavaScript 字符串的 UTF-16 本质
split('').reverse().join('') 最大的技术隐患并非性能,而是字符编码的破坏性截断。许多初学者误以为 split('') 会将字符串拆分成“一个个人眼可见的文字或符号”,但 ECMAScript 规范定义中的逻辑并非如此。
1. 码元(Code Unit)与码点(Code Point)的差异
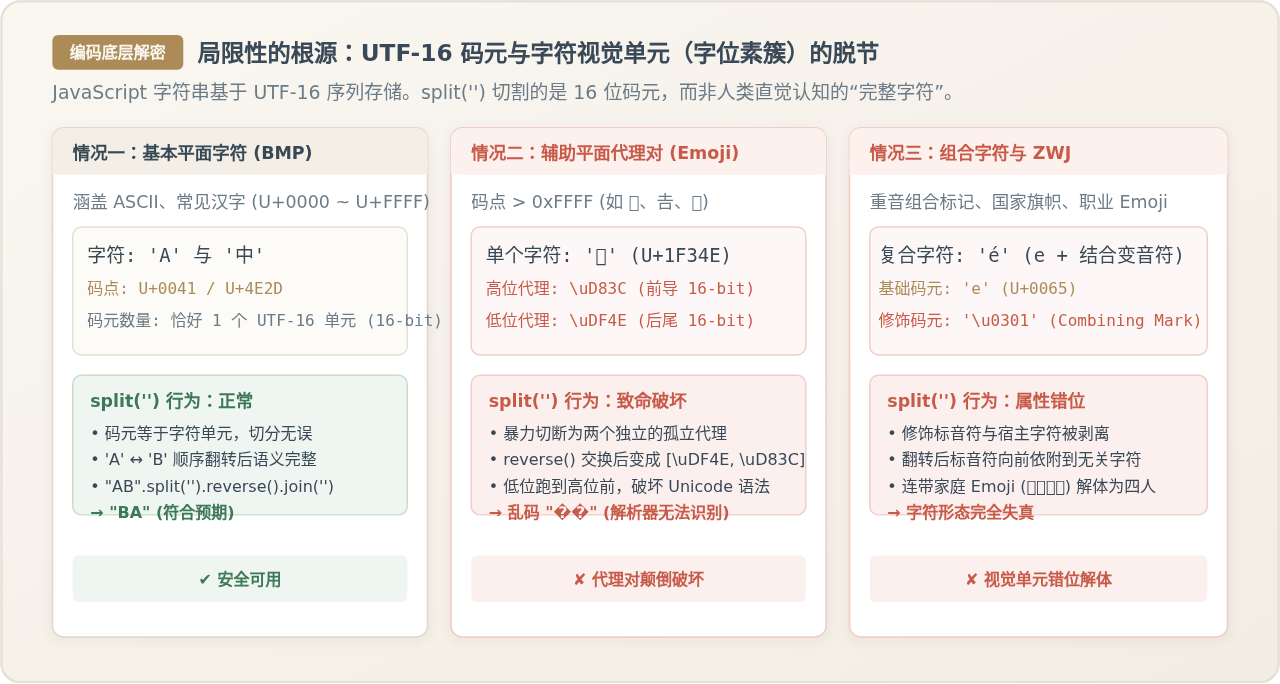
在 ECMAScript 内部,字符串被严格定义为16 位无符号整数序列(UTF-16 编码单元,即 Code Unit)。每个编码单元占用 2 字节(16-bit):
-
基本多语言平面(BMP,码点范围 U+0000 到 U+FFFF):涵盖了标准 ASCII 字符、希腊字母、常见汉字等。这些字符在 UTF-16 中刚好占用 1 个码元。调用
split('')时,1 个码元被当作 1 个数组元素,因此能正常翻转。 -
辅助平面(SMP,码点范围 U+10000 到 U+10FFFF):涵盖现代广泛使用的 Emoji 表情符号(如 🍎、🚀、🎉)以及生僻汉字(如“𠮷”)。因为 16 位二进制无法容纳大于
0xFFFF的数值,UTF-16 规范引入了代理对(Surrogate Pairs)机制,使用两个连续的 16 位码元拼接表示一个字符:前导的高位代理(High Surrogate,范围0xD800 ~ 0xDBFF)和后尾的低位代理(Low Surrogate,范围0xDC00 ~ 0xDFFF)。
2. 致命破坏:代理对顺序颠倒与乱码
当执行 "🍎".split('') 时,split('') 盲目地按照 16 位码元切刀,把原本不可分割的 \uD83C\uDF4E 暴力拆成了两个孤立的半代理元素:["\uD83C", "\uDF4E"]。
随后的 reverse() 将数组颠倒为 ["\uDF4E", "\uD83C"]。注意:此时低位代理 \uDF4E 被错误地排在了高位代理 \uD83C 前面!这彻底违背了 UTF-16 规范的语法结构。当 join('') 将它们拼回字符串交给渲染器解析时,引擎无法将其识别为合法字符,最终只能渲染为 Unicode 替换字符(显示为形如 �� 的乱码)。
四、踩坑现场:三类典型场景的代码实测
在真实业务场景中,一旦涉及富文本内容、用户昵称、国际化多语言或聊天表情,直接使用经典三步法就会产生意想不到的错误。以下是三类最具代表性的失效场景:
场景 1:Emoji 表情与生僻字(代理对破损)
JavaScript测试 1:代理对反转失效const emojiText = "A🍎B";
// 🍎 的 UTF-16 编码由双码元组成: \uD83C\uDF4E
const badResult = emojiText.split('').reverse().join('');

console.log(badResult);
// 实际输出: "B\uDF4E\uD83CA" 乱码显示为 "B��A"
// 预期结果本应为: "B🍎A"

// 同样的问题发生于生僻字:
const rareChar = "𠮷野家"; // '𠮷' 为辅助平面汉字 (码点 U+20BB7,双码元)
console.log(rareChar.split('').reverse().join(''));
// 输出: "家野��" ('𠮷' 代理对被倒置破坏)
场景 2:重音符与组合变音标记(Combining Diacritical Marks)
在西欧语言(如法语、西班牙语、德语)中,许多字符由基础英文字母与附加的修饰标音符组合而成。例如小写字母 é 可以由基础字符 e(U+0065)与组合尖音符 \u0301(U+0301)组合而成。
JavaScript测试 2:组合变音标记错位const accentStr = "cafe\u0301"; // 视觉呈现为 "café"
const reversedAccent = accentStr.split('').reverse().join('');

console.log(reversedAccent);
// 实际输出: "\u0301efac" 渲染为 "́efac"
// 变音符号脱离了原主 'e',移到了首位,导致视觉与语义完全错乱
场景 3:复合表情(零宽连接符 ZWJ 与肤色修饰符)
现代移动端支持丰富的复合表情,例如家庭表情 👨👩👧👦 实际上由四个人物表情通过 3 个不可见的零宽连接符(Zero-Width Joiner,\u200D)串联而成;又如挥手表情 👋🏽 是由基础手势加上特定肤色修饰符构成的。
JavaScript测试 3:ZWJ 复合 Emoji 解体const family = "👨👩👧👦";
console.log(family.length); // 长度高达 11 个 UTF-16 码元!
const brokenFamily = family.split('').reverse().join('');
console.log(brokenFamily);
// 输出: 乱码串并且表情彻底解体为分散符号,失去原有合体表现"hello" 或 "abc" 等纯英文输入,split('').reverse().join('') 能够 100% 跑通测试套件,导致这种潜在的编码 Bug 被悄悄带到生产环境,直到真实用户输入 Emoji 触发乱码或数据校验报错时才被发现。
五、方案演进与对比:从 ES6 迭代器到现代标准 Intl.Segmenter
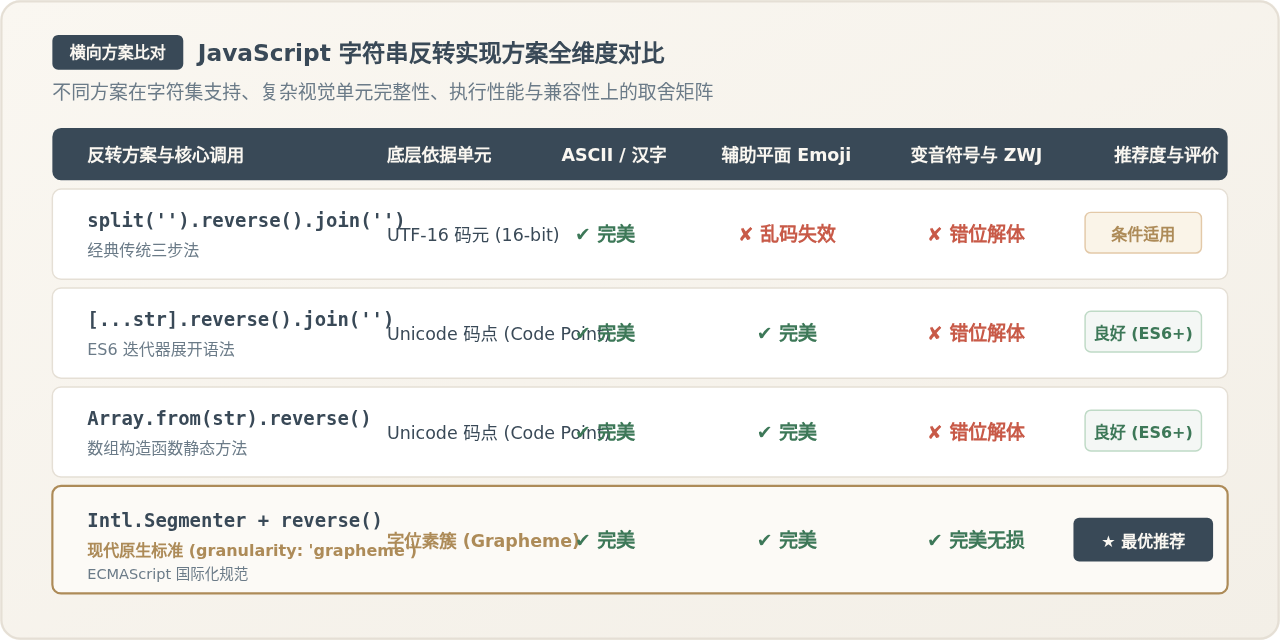
面对传统写法的局限,前端社区先后出现了多种改良方案。不同方案在不同抽象层级上工作,效果和兼容性各有差异。
1. ES6 展开运算符 / Array.from:解决单个代理对(码点级)
ES6 规范为字符串引入了默认的迭代器(Symbol.iterator)。字符串迭代器能够识别 UTF-16 代理对,并按真正的 Unicode 码点(Code Point) 进行迭代。因此,使用扩展运算符 [...str] 或 Array.from(str) 可以正确保留单个 Emoji:
JavaScriptES6 码点级安全反转function reverseByCodePoint(str) {
  return [...str].reverse().join('');
}

console.log(reverseByCodePoint("hello 🍎")); // 输出: "🍎 olleh" (成功保留单个 Emoji)
console.log(reverseByCodePoint("𠮷野家"));   // 输出: "家野𠮷" (成功保留生僻字)
局限:[...str] 只能解决独立代理对问题,由于变音符组合以及 ZWJ 是由多个独立的 Unicode 码点组合而成的,码点级的展开依然会将它们拆开,因此反转 "cafe\u0301" 或 "👨👩👧👦" 依然会错位解体。
2. 现代规范标准:Intl.Segmenter(字位素簇级,最权威解法)
在现代 ECMAScript 规范中,浏览器与 Node.js 引入了官方的国际化分词 API —— Intl.Segmenter。通过指定粒度为 granularity: 'grapheme'(字位素簇,即人类感官认知中的“单个完整字符”),引擎能够在底层完整遵循 Unicode UAX #29 文本分词标准:
JavaScript现代标准原生字位素反转function reverseGraphemeClusters(str, locale = 'en') {
if (typeof Intl !== 'undefined' && Intl.Segmenter) {
const segmenter = new Intl.Segmenter(locale, { granularity: 'grapheme' });
const segments = Array.from(segmenter.segment(str), s => s.segment);
return segments.reverse().join('');
}
// 降级方案:若宿主不支持 Intl.Segmenter 则降级至 ES6 展开
return [...str].reverse().join('');
}
// 验证全部复杂场景
console.log(reverseGraphemeClusters("hello 🍎")); // "🍎 olleh" (正确)
console.log(reverseGraphemeClusters("cafe\u0301")); // "éfac" (尖音符完整吸附在 e 上)
console.log(reverseGraphemeClusters("👨👩👧👦 rock")); // "kcor 👨👩👧👦" (家庭复合表情整体翻转,无解体)Intl.Segmenter 目前已全面支持现代主流运行环境,包括 Chrome 87+、Edge 87+、Safari 14.1+、Firefox 125+ 以及 Node.js 16.0+。它是目前无需任何第三方依赖、完全由底层 C++ 引擎驱动的最精确反转方案。
六、生产环境选型决策与黄金准则
在实际工程开发中,并不存在“所有场景必须一刀切”的方案。选型的关键在于明确被处理数据的安全边界:
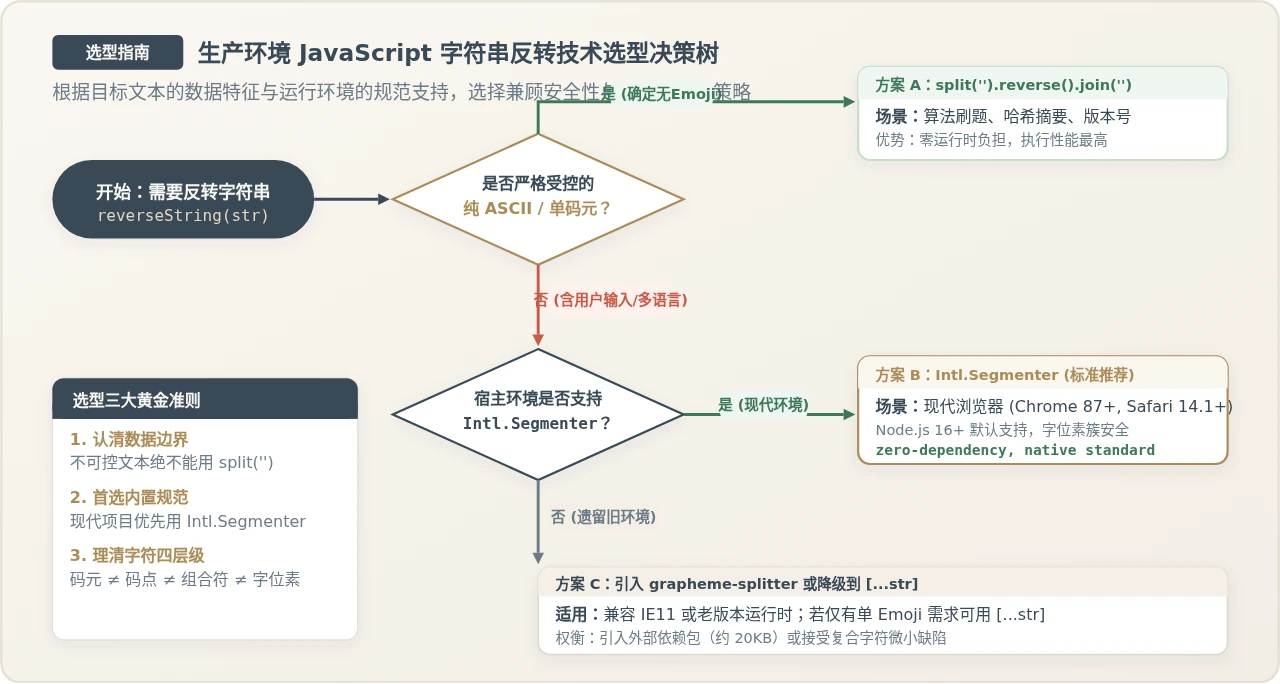
| 应用场景 | 推荐方案 | 核心依据 |
|---|---|---|
| 纯受控字符串 / 算法刷题 (如验证数字回文、哈希串反转、URL 处理) |
split('').reverse().join('') |
性能极优 保证无 Emoji,代码极其精炼,兼容所有浏览器与运行时。 |
| 现代通用 Web / Node.js 业务 (用户昵称、聊天消息、评论反转、富文本) |
Intl.Segmenter + reverse() |
原生安全 零第三方依赖,彻底规避 UTF-16 代理对和复杂字位素簇解体乱码。 |
| 旧项目维护 / 跨端老旧宿主 (需兼容旧版 iOS WebView、早期嵌入式环境) |
[...str].reverse().join('')或引入 grapheme-splitter |
通过 Polyfill 或轻量三方库弥补老旧引擎对复杂字位素簇切分的缺失。 |
技术启示:牢记字符串的“四层认知”
深入理解 split('').reverse().join('') 的局限性,本质上是建立对现代计算机字符集的多层认知体系:
- 码元层(Code Unit,16位):
str.length和str.split('')统计和操作的都是它。它只是底层存储单元,不能等同于字符。 - 码点层(Code Point):Unicode 分配的绝对唯一编号。
[...str]和String.fromCodePoint()工作在这一层,能够保护单个 Emoji。 - 组合标记层(Combining Characters):多个码点通过组合规则修饰同一个基字符。
- 字位素簇层(Grapheme Cluster):人类视觉感官中不可分割的一个显示单元。
Intl.Segmenter工作在这一层,也是所有自然语言处理与排版渲染的真实基石。
JavaScript原生实现颜色相似度计算:RGB欧氏距离算法详解
2026-11-18 19:57:18
JavaScript使用Fetch API发起HTTP请求与处理JSON数据
2026-11-18 17:45:55
JS手机号正则是否允许空格或+86前缀的处理技巧
2026-11-18 17:13:28
JS数组reduce方法详解:从累加到复杂数据转换
2026-11-18 16:03:06
JS Map遍历时删除元素安全吗?注意事项与正确做法
2026-11-18 14:18:31