JS使用FileReader读取文本出现乱码怎么解决
详细讲解JavaScript中使用FileReader读取文本文件(如TXT、CSV)出现中文乱码的原因及解决方法。涵盖指定readAsText编码参数、借助TextDecoder实现UTF-8与GBK智能探测等实用方案与关键机制对比。
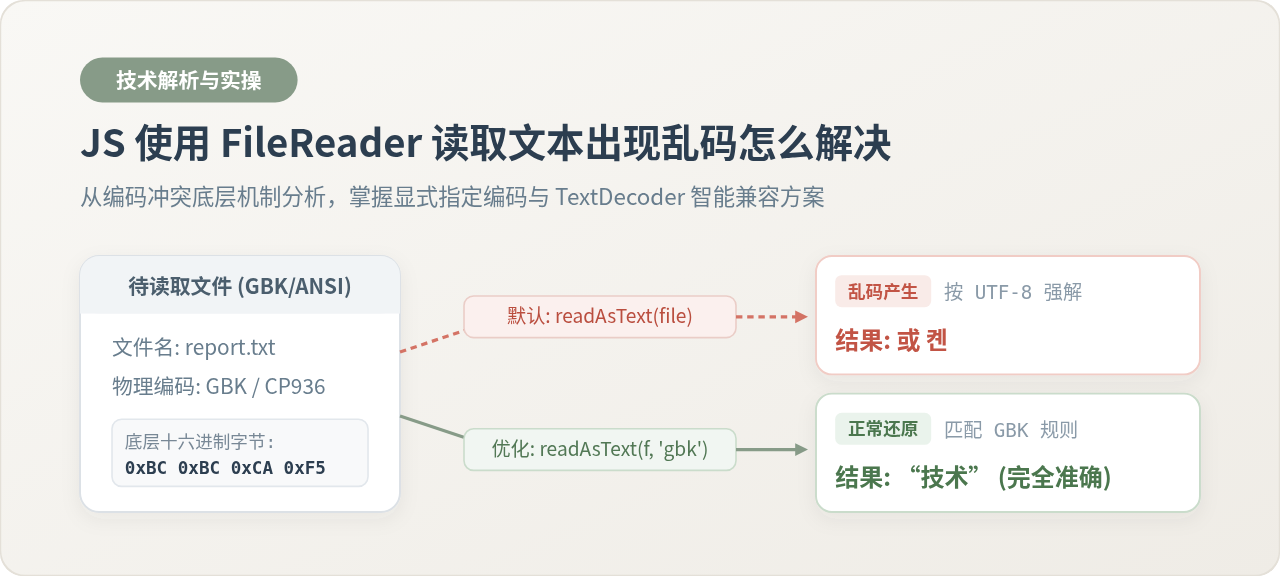
FileReader 读取本地文本文件(如 .txt 或 .csv)时出现中文乱码,核心原因在于 readAsText() 方法在未显式传参时默认采用 UTF-8 解码,而许多 Windows 记事本文件或 Excel 导出的 CSV 文件实际采用的是 GBK(ANSI) 编码。解决这一问题的最直接办法是在调用时传入编码参数 reader.readAsText(file, 'gbk');若需要面向多来源未知编码的通用上传场景,则应结合 readAsArrayBuffer 与现代 TextDecoder 实现先试探 UTF-8 并在失败时自动回退 GBK 的智能兼容机制。
一、为什么 FileReader 读取文本会出现乱码?
计算机在磁盘上保存文件时,本质上只记录一长串由十六进制表示的二进制字节流(Byte Stream)。文字到底以什么字节存储、读取时又如何把字节转换回可读的文字,完全取决于所使用的“字符编码映射表”。
当在前端代码中使用 FileReader 对象的 readAsText(blob, [encoding]) 读取文件时,如果省略了第二个参数,浏览器规范规定默认使用 'utf-8' 字符集进行解码。
然而在中文 Windows 系统环境中,许多常见的文本文件并非以 UTF-8 存储:
- 系统记事本:历史版本的 Windows 记事本默认以 ANSI 编码保存文本,在简体中文环境下即为 GBK / CP936 编码。
- Excel 导出的 CSV 文件:在简体中文版 Microsoft Excel 中直接“另存为 CSV”,默认保存的编码通常也是 ANSI(GBK),并非标准 UTF-8。
- 传统业务系统导出文件:部分银行、企业内部系统导出的报表文本长期采用 GB2312 或 GBK 规范。
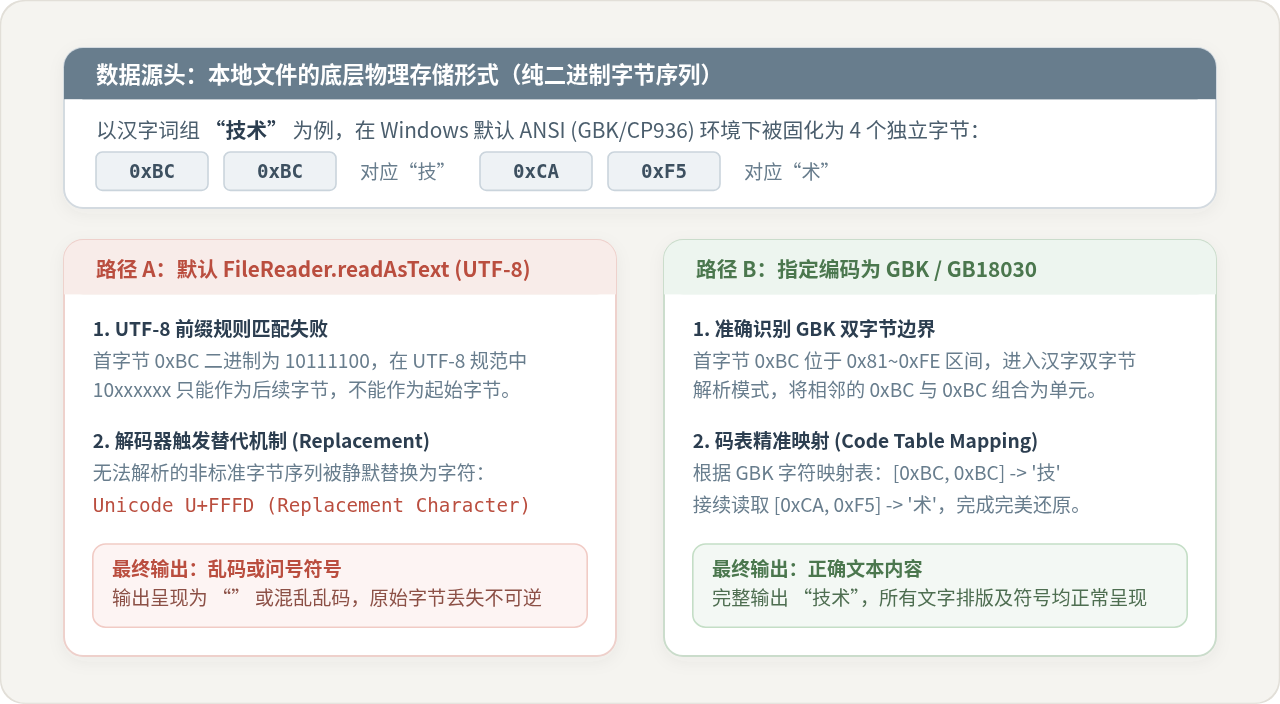
在编码机制上,GBK 采用双字节表示一个汉字,其首字节范围通常落在 0x81 ~ 0xFE 之间。而 UTF-8 采用 1 至 4 字节的变长表示,若首字节位于 0x80 ~ 0xBF,在 UTF-8 规范中属于非法的首字节序列(该范围在 UTF-8 中仅允许作为多字节字符的后续字节)。当 UTF-8 解码器遇到不符合语法规则的字节时,无法成功映射为 Unicode 字符,浏览器就会将这些非法字节替换为 U+FFFD(即带问号的黑色菱形符号 )或者错位拼成无法识别的生僻符号,从而形成了所谓的“乱码”。
二、基础解决方案:显式指定 readAsText 编码参数
如果业务场景明确,例如这是企业内部专用的系统,或者读者很清楚用户上传的都是来自 Excel 默认导出的 CSV 文件,最快、最直接的做法就是为 readAsText 传入编码名称。
1. 完整实现代码
// 监听文件上传控件
const fileInput = document.querySelector('#fileInput');

fileInput.addEventListener('change', (event) => {
  const file = event.target.files[0];
  if (!file) return;

  const reader = new FileReader();

  // 当文件加载完成后触发
  reader.onload = (e) => {
    const textContent = e.target.result;
    console.log('读取成功,文本内容:', textContent);
    document.querySelector('#preview').textContent = textContent;
  };

  reader.onerror = (err) => {
    console.error('文件读取失败:', err);
  };

  // 关键步骤:显式传入 'gbk' 编码参数
  reader.readAsText(file, 'gbk');
});'gbk'、'gb2312' 还是 'GB18030',底层都会自动规范化并映射至容纳字符更全面的 GB18030 解码表,因此能够无缝兼容各类 GBK 和繁体、生僻汉字。
2. 显式指定参数的局限性
这种直接传参的方式虽然只有一行修改,但它建立在“已知文件必须是 GBK”的假设上。如果用户上传的是一个标准的 UTF-8 文本文件,强制使用 'gbk' 参数解码,原本正常的 UTF-8 文本反而会被按 GBK 双字节错误切分,变成另一种形式的乱码。因此,面对用户任意上传文件的开放场景,需要更灵活的自动探测方案。
三、进阶应对:借助 TextDecoder 实现编码智能探测与回退
在面对未知来源的文本时,理想的逻辑是:优先尝试使用现代标准 UTF-8 解码,如果发现字节不合法,则自动回退到 GBK 解码。
为什么不能直接调用两次 readAsText 呢?因为 readAsText 在遇到非法字符时只会默默替换为 ,并不会触发 onerror 报错,程序无法通过 try-catch 得知其解码失败。此外,再次读取需要重新触发磁盘或内存 I/O,效率较低。
现代浏览器提供了原生的 TextDecoder API,支持在构造时传入 { fatal: true } 配置项。当解码器遇到无法解析的字节序列时,会主动抛出 TypeError 异常,这为精准捕获解码失败提供了基础。
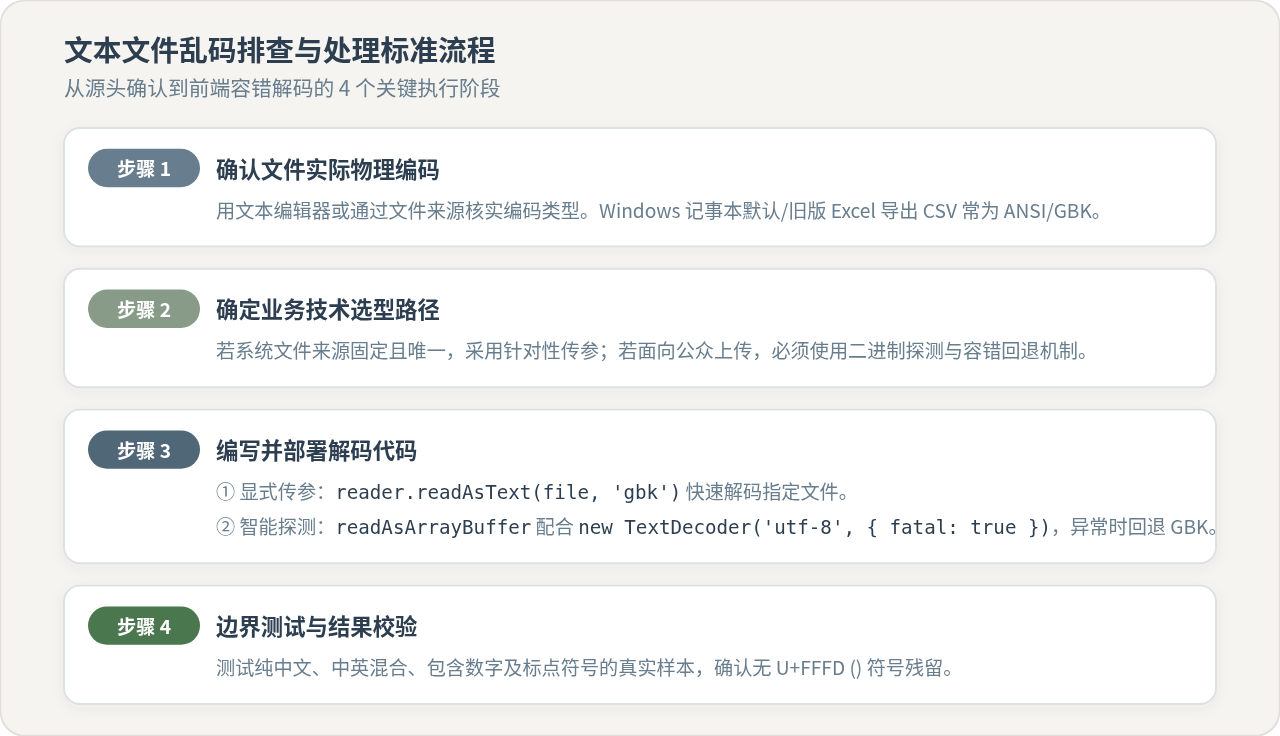
1. 智能兼容解码实现方案
首先通过 FileReader.readAsArrayBuffer(file) 将物理文件一次性读入为原始二进制缓冲区(ArrayBuffer),接着对内存数据进行智能试探:
/**
 * 将 ArrayBuffer 智能解码为字符串(优先 UTF-8,报错回退 GBK)
 * @param {ArrayBuffer} buffer - 文件原始二进制内存
 * @returns {string} 解码后的正确文本
 */
function smartDecodeBuffer(buffer) {
  // 1. 先检查是否包含 UTF-8 BOM 标识 (EF BB BF)
  const uint8View = new Uint8Array(buffer);
  if (uint8View.length >= 3 && uint8View[0] === 0xEF && uint8View[1] === 0xBB && uint8View[2] === 0xBF) {
    // 带有 UTF-8 BOM,剥离前 3 个字节后按 UTF-8 解码
    const decoder = new TextDecoder('utf-8');
    return decoder.decode(uint8View.subarray(3));
  }

  // 2. 使用 fatal: true 模式试探 UTF-8
  try {
    const utf8Decoder = new TextDecoder('utf-8', { fatal: true });
    return utf8Decoder.decode(buffer);
  } catch (err) {
    // 抛出 TypeError 说明字节流不符合 UTF-8 规范,自动回退到 GBK
    console.warn('检测到非标准 UTF-8 字节,自动回退至 GBK 解码...');
    const gbkDecoder = new TextDecoder('gbk', { fatal: false });
    return gbkDecoder.decode(buffer);
  }
}

// 业务调用示例
const fileInput = document.querySelector('#fileInput');
fileInput.addEventListener('change', (e) => {
  const file = e.target.files[0];
  if (!file) return;

  const reader = new FileReader();
  reader.onload = (event) => {
    const arrayBuffer = event.target.result;
    const finalText = smartDecodeBuffer(arrayBuffer);
    console.log('解析结果:', finalText);
  };

  // 关键:读取为 ArrayBuffer 而非直接转换 Text
  reader.readAsArrayBuffer(file);
});
这套方案的优势在于:全过程只执行一次磁盘 I/O,保存在内存中的 ArrayBuffer 可以被无损重复读取,通过抛错机制百分之百避开把 GBK 误认成 UTF-8 的情况,实现对两类常见文本的全面兼容。
四、两类解决策略的关键机制差异对比
为了在实际开发中做出准确的技术选型,我们需要把直接使用 FileReader.readAsText(file, enc) 与 ArrayBuffer + TextDecoder 两种方案置于同一条件下进行对比。理解它们的差异为什么重要,能帮助我们避免陷入过度封装或容错不足的陷阱。
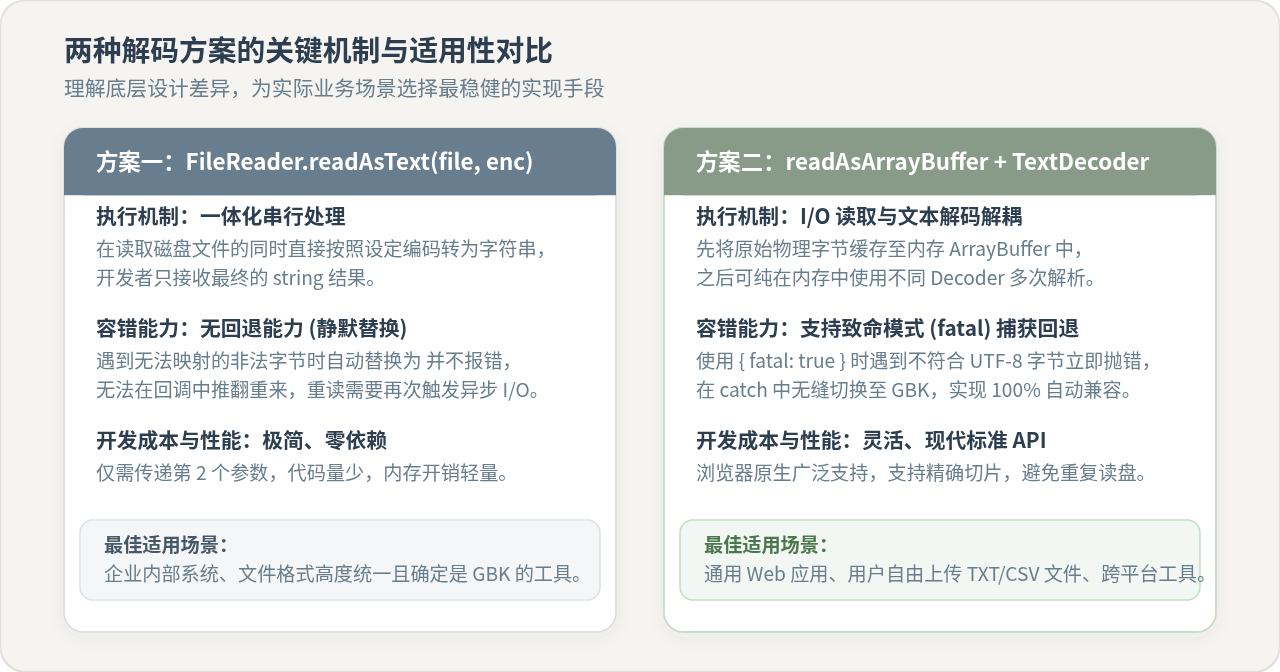
| 对比维度 | 原生 readAsText(file, enc) | ArrayBuffer + TextDecoder 智能方案 |
|---|---|---|
| 处理阶段 | 读取 I/O 与字符串解码强耦合,一次完成 | 读取二进制与内存字符串解码彻底解耦 |
| 错误控制 | 静默替换非法字节为 ,无异常可供捕获 | 支持 fatal: true,非法字节主动抛出异常 |
| 多编码适应 | 单向固定,若判断失误需重新异步读盘 | 内存数据可反复重试,实现毫秒级回退与试探 |
| BOM 头处理 | 由浏览器内部静默过滤,无法精细控制偏移 | 可在二进制层面精准识别并剥离特定 BOM 字节 |
| 代码复杂度 | 极低,仅需配置调用参数 | 中等,需配合辅助解码函数 |
| 典型适用环境 | 内部工具、文件来源统一的专用业务系统 | 面向大众用户上传、文件格式多样的通用 Web 页面 |
这种差异的关键影响在于故障发生后的恢复成本:使用 readAsText 一旦解码错误,得到的字符串是不可挽回的破损文本;而保留原始 ArrayBuffer 则保留了文件 100% 的原始字节状态,赋予了代码在内存中重新纠错的完整主动权。
五、常见误区与避坑指南
1. 误区一:试图在得到乱码字符串后再通过 JS 进行“转码修复”
encodeURIComponent、decodeURI 或 escape 试图“把乱码转回正常文字”,这是完全不可行的!
正如前文原理图所阐明,当原有的 GBK 字节被 UTF-8 解码器判定为非法字节并替换为 Unicode U+FFFD()后,原有的原始字节信息已经在内存中被丢弃并覆写。一个问号字符无法还原出原本是哪个汉字,因此字符编码转换必须发生在“从二进制字节转换成字符”的时刻,不可逆的事后修补没有任何效果。
2. 误区二:认为带 UTF-8 后缀或扩展名为 CSV 的文件必定是 UTF-8
许多用户在使用办公软件时,只是简单把 .txt 重命名为 .csv,或者在 Excel 中直接点击保存。Excel 默认生成的 CSV 在 Windows 下普遍为 ANSI 编码。不能仅仅根据文件扩展名就武断决定解码规则,必须通过上述方案给予充分的编码兼容。
3. 误区三:混淆浏览器 FileReader 与 Node.js 的 Buffer API
在 Node.js 服务端环境中,我们可以直接使用 iconv-lite 或内置的 fs.readFile 处理各类编码;而在纯浏览器端,由于安全与沙箱限制,必须依赖浏览器开放的 FileReader 与 Web 标准的 TextDecoder API,无须也不建议额外引入体积庞大的第三方转码库。
六、技术选型与最佳实践决策指南
在实际项目落地时,可根据以下决策路径选择最适配的解决手段:
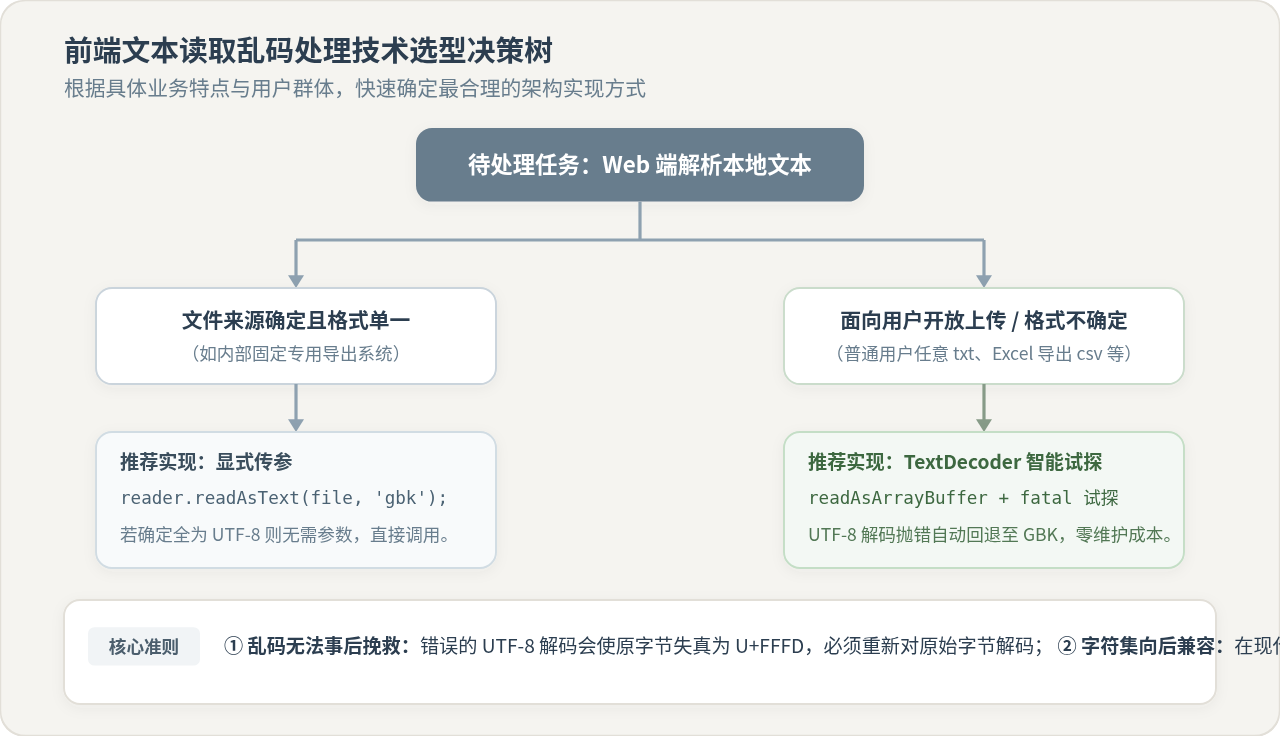
归纳总结为以下三条实践准则:
- 如果是专有内部系统:直接使用
reader.readAsText(file, 'gbk')。简单稳定,不需要引入额外的解析函数。 - 如果是开放式公共功能:优先使用
readAsArrayBuffer结合TextDecoder试探逻辑。先尝试 UTF-8 并在捕获到异常时自动回退至 GBK,能够解决绝大部分日常办公文件上传乱码问题。 - 验证阶段切记覆盖多样本:测试时不要只测单字或纯中文,应准备包含“纯 ASCII 英文”、“中英混合”、“中文全角标点”以及“Windows 记事本另存为各编码”的测试样本,确认无遗留乱码后再正式发布。
怎么用JS强制刷新页面以忽略浏览器缓存
2026-11-18 22:09:36
浏览器控制台怎么调试Web前端JavaScript报错
2026-11-18 21:39:22
JS判断移动端与CSS媒体查询该怎么选择
2026-11-18 20:53:40
JS事件捕获与冒泡的区别:执行顺序与适用场景对比
2026-11-18 19:33:42
怎么用JavaScript监听滚动或窗口变化动态调整CSS样式
2026-11-18 16:57:57