怎么用JS强制刷新页面以忽略浏览器缓存
详细讲解如何通过JavaScript强制刷新网页以忽略浏览器缓存,剖析location.reload(true)的失效原因与现代标准规范,提供基于URL时间戳与Service Worker清理的完整高可用方案。
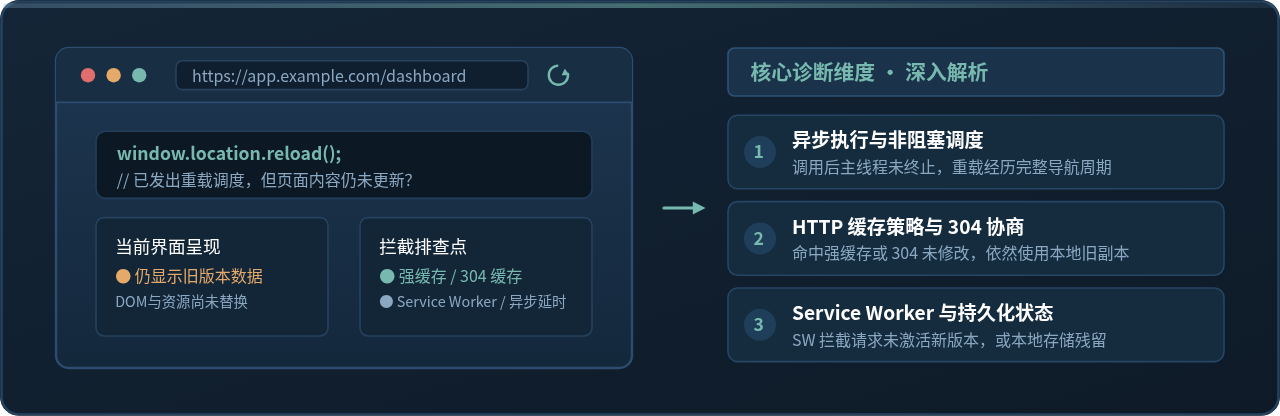
假设你刚刚在服务器上部署了一个修复紧急缺陷的静态页面版本,或者更新了某项前端配置数据。当读者或客服人员反馈“页面依然显示旧数据”时,你希望在前端代码中主动触发一次重新加载,让用户无需手动打开开发者工具去点击“清空缓存并硬性重新加载”,就能直接看到最新的界面。
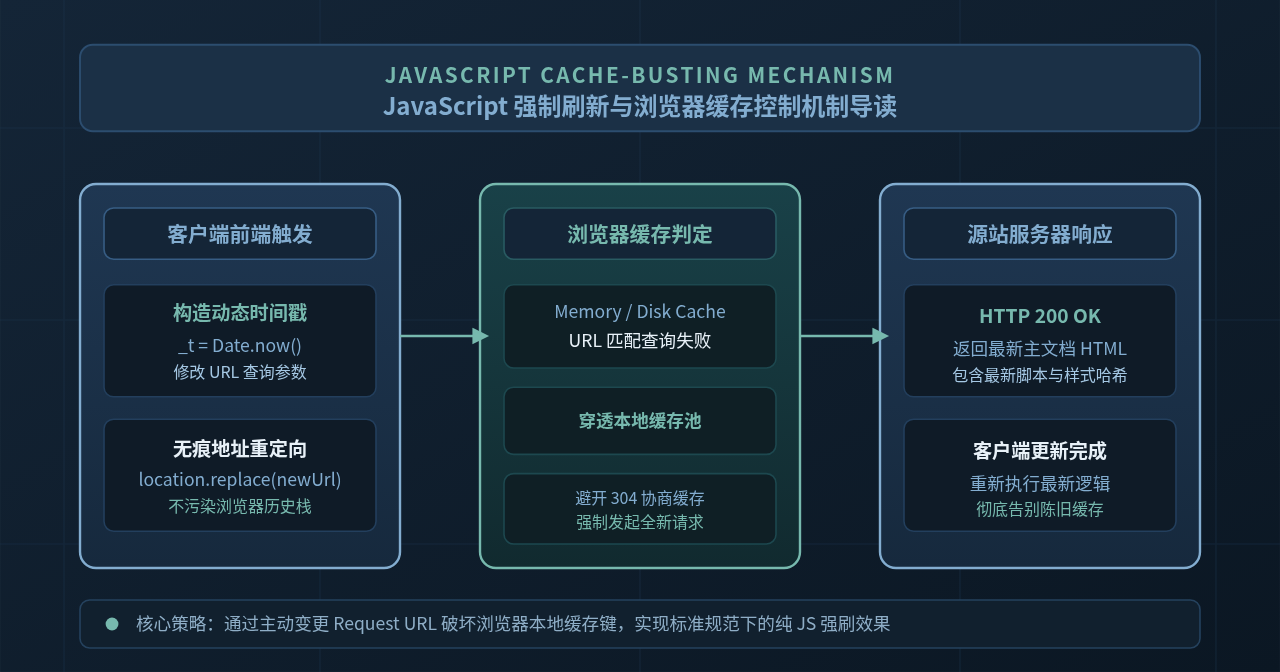
很多前端开发者在初次遇到该需求时,往往会立刻想到调用 location.reload(true)。然而在现代浏览器中,这一方法已经不再起效——它并不会像快捷键 Ctrl + F5 那样彻底清理缓存。在现代 JavaScript 中,最可靠且符合标准的强制刷新方式,是通过在当前页面 URL 中注入或更新动态时间戳查询参数(Cache-Busting),配合 window.location.replace() 重新导航。这一方案能使浏览器将当前访问判定为全新请求,从而绕过所有本地存储的强缓存。
一、浏览器刷新类型与缓存命中链路
要搞清楚为什么常规的 JavaScript 刷新无法更新页面,首先需要理解浏览器在面对不同刷新动作时的网络栈处理机制。
现代浏览器内部维护着多级缓存结构:内存缓存(Memory Cache)、磁盘缓存(Disk Cache)以及协商缓存(通过 HTTP 响应头中的 ETag 和 Last-Modified 进行校验)。当网页发出资源请求时,浏览器会优先检查是否存在尚未过期的强缓存(由 Cache-Control: max-age 或 Expires 控制)。只要强缓存命中,浏览器甚至根本不会向服务器发送任何网络数据包,而是直接从本地内存或硬盘中读取。
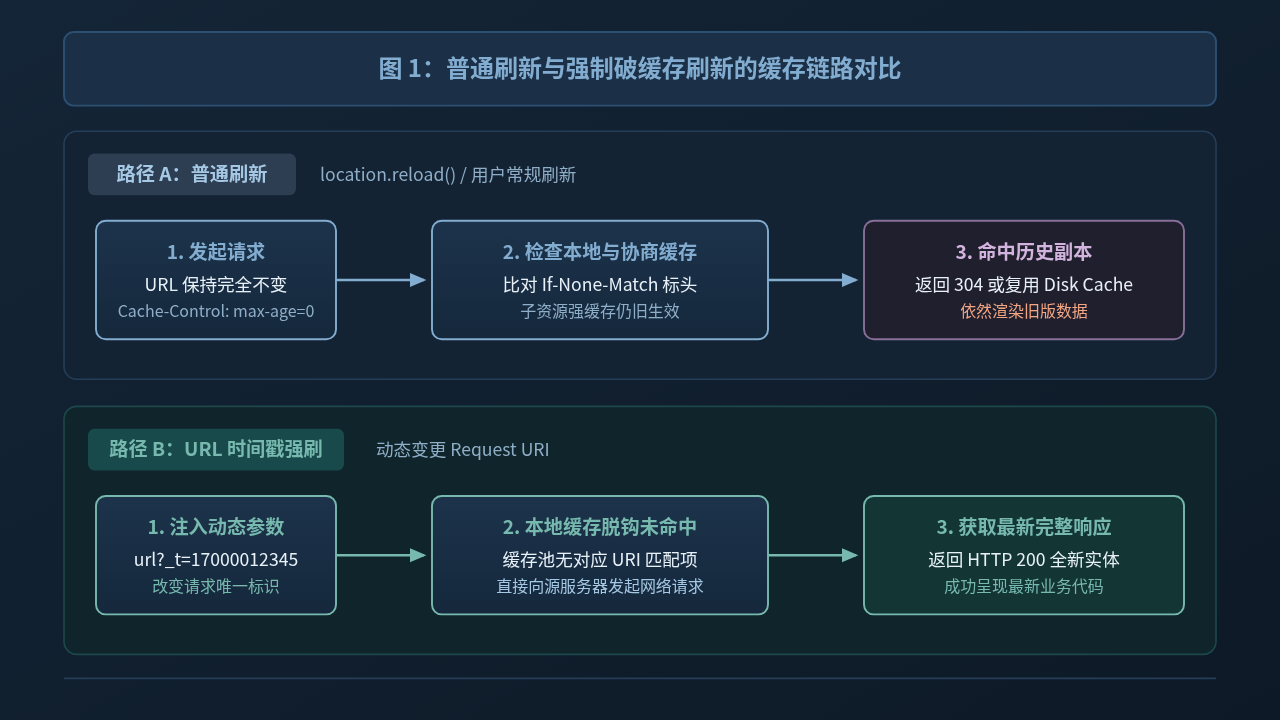
- 常规刷新(F5 / location.reload()):浏览器会将主 HTML 文档的请求头加上
Cache-Control: max-age=0,向服务器询问主文档是否变更(协商缓存)。如果服务器返回304 Not Modified,主文档将继续使用本地副本;同时,页面内部引用的 JS、CSS、图片等静态子资源,仍可能直接沿用原有的 Disk Cache,导致页面呈现不出最新修改。 - 硬性重新加载(Ctrl + F5 / Cmd + Shift + R):这是浏览器提供给用户的专属高级操作。浏览器会发送
Cache-Control: no-cache和Pragma: no-cache标头,明确要求沿途各级代理与本地存储忽略所有已有缓存,重新下载全部资源。
二、为什么 location.reload(true) 在现代浏览器中失效了
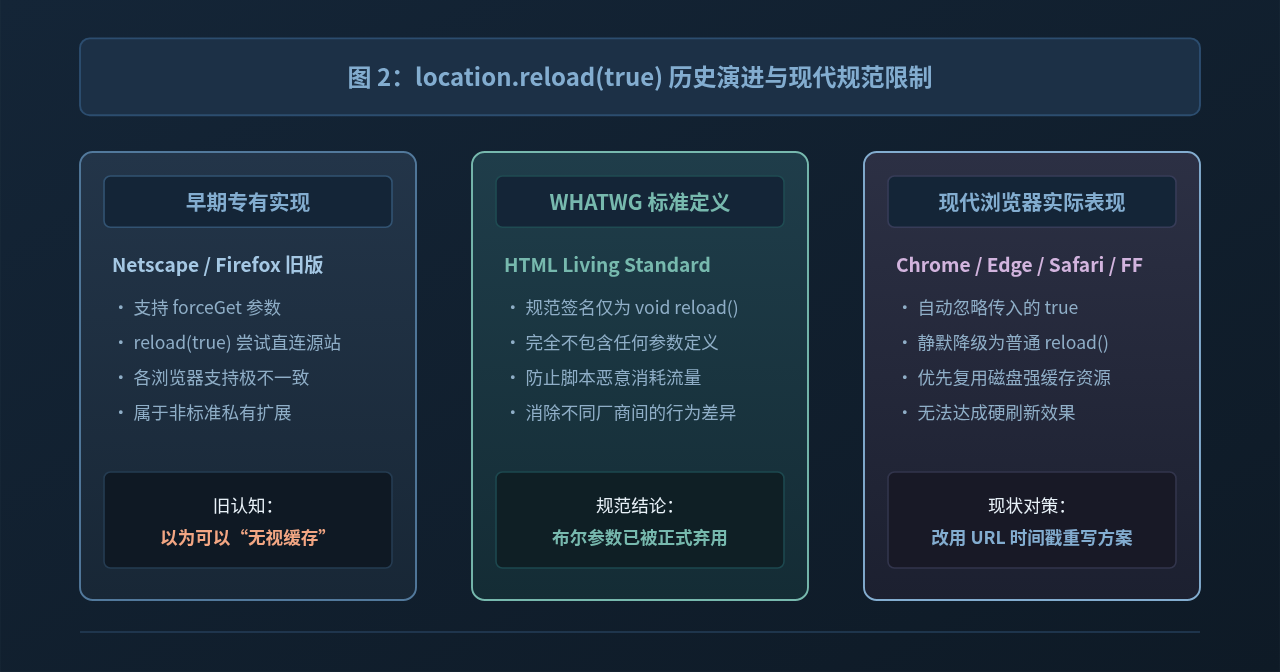
在早期网络开发时代,不少教程会指导读者使用 location.reload(true) 来绕过缓存。这个布尔值参数最早源于 Netscape Navigator,后来被旧版 Mozilla Firefox 作为非标准私有属性延续了下来(其内部命名为 forceGet)。当时的含义是:若传值为 true,则要求浏览器绕过本地缓存直接向服务器发起 GET 请求;若省略或传值为 false,则允许读取缓存。
然而,在 W3C 以及当前的 WHATWG HTML Living Standard(HTML 标准规范) 中,Location 接口下的 reload() 方法定义非常明确:
[Exposed=Window]
interface Location {
  ...
  void reload();
};这意味着在标准规范中,reload() 根本不接受任何参数。各主流浏览器厂商(Google Chrome / Chromium、Apple Safari WebKit、新版 Mozilla Firefox)在统一标准的过程中,先后取消了对该参数的支持:
- 静默忽略参数:你在现代浏览器中执行
location.reload(true)时,浏览器虽然不会抛出语法错误,但会在引擎内部完全忽略传入的true,其实际运行效果与调用location.reload()完全等同。 - 安全与流量限制:如果允许任意网页脚本都能随意发起等同于“硬刷新”的昂贵请求,恶意网站便可利用循环脚本瞬间消耗用户大量移动蜂窝网络流量并加大服务端负载,因此规范有意将硬刷新权限限制在用户终端界面本身。
三、现代核心实战方案:URL 时间戳破除缓存法(Cache-Busting)
既然原生 API 不再支持硬刷新,我们便可以通过网络协议层面的缓存寻址规则来解决问题。
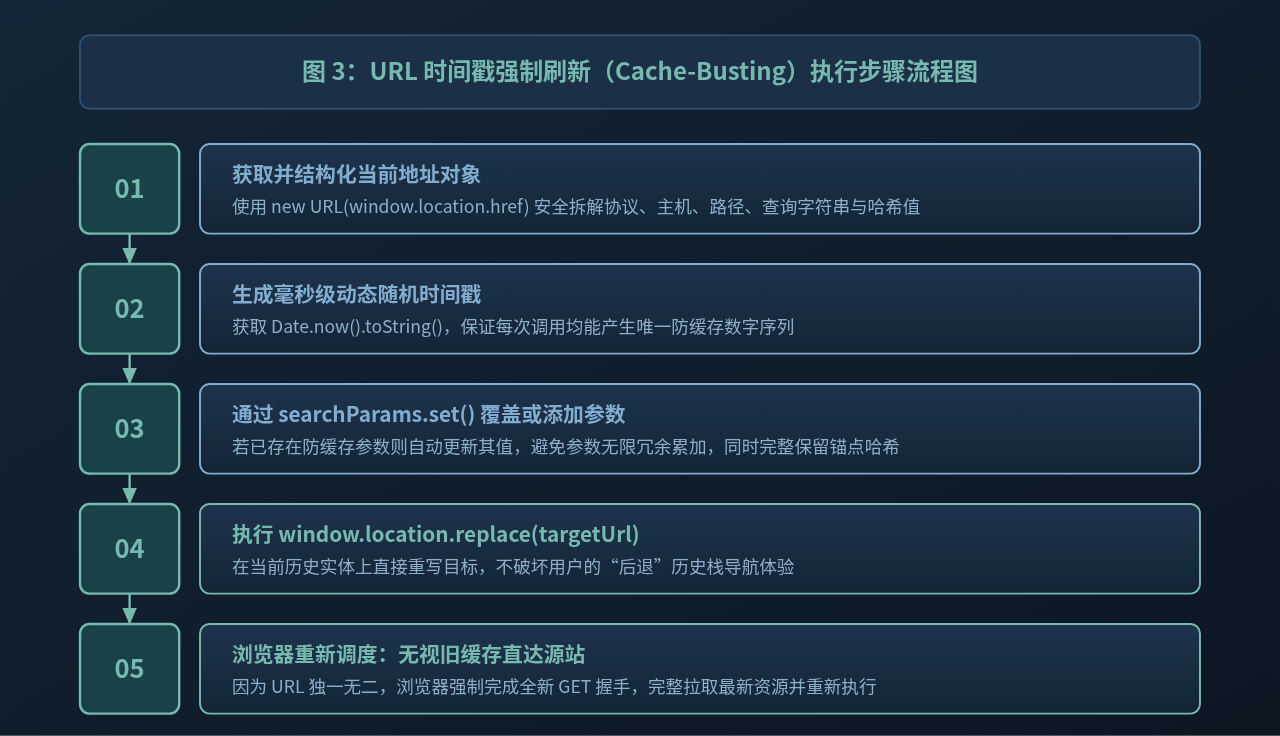
浏览器在判定一个资源是否已被缓存时,其主键(Cache Key)通常是完整的请求 URL(包括协议、域名、端口、路径以及 Query 查询字符串)。如果向 URL 的末尾增加一个带有当前时刻毫秒数的时间戳参数(例如 ?_t=1700000000000),对浏览器而言,这个 URL 便是一个从来没有被请求过的“全新地址”。
1. 方案设计关键要点
在编写该函数时,不能草率地使用字符串拼凑(例如直接拼接 window.location.href + '?t=' + Date.now()),因为这会带来以下缺陷:
- 如果页面 URL 原本就带有
?id=123等查询参数,直接用?会造成 URL 格式语法损坏。 - 如果页面原本带有
#anchor哈希锚点,简单拼接会导致参数被错置于锚点之后,服务端根本无法接收。 - 若重复触发多次,会导致 URL 末尾堆叠多个
_t=...&_t=...冗余项。 - 使用
window.location.href = ...会向浏览器的前进/后退历史记录中追加一条新记录,用户点击“后退”按钮时会回到上一个带旧时间戳的页面,产生恶劣的操作体验。因此必须使用window.location.replace()来原地替换当前历史记录。
2. 完整的生产级封装代码
以下是具备完整边界检查与兼容性处理的纯 JavaScript 解决方案。你可以直接将其放置在通用工具库或业务页面脚本中:
/**
 * 强制刷新当前页面并忽略浏览器缓存
 * @param {string} [paramName='_nocache'] - 防缓存的查询参数名称
 */
function forceReloadPage(paramName = '_nocache') {
  try {
    // 1. 构建当前完整的 URL 对象
    const currentUrl = new URL(window.location.href);

    // 2. 注入或更新当前毫秒级时间戳
    const timestamp = Date.now().toString();
    currentUrl.searchParams.set(paramName, timestamp);

    // 3. 使用 replace 原地重写当前历史条目,避免用户点击后退时产生死循环
    window.location.replace(currentUrl.toString());
  } catch (error) {
    // 降级兜底:在极端老旧或受限环境下,如果不支持 URL 构造函数,则进行简易字符串替换
    const baseUrl = window.location.href.split('#')[0];
    const hash = window.location.hash || '';
    const separator = baseUrl.includes('?') ? '&' : '?';
    const fallbackUrl = baseUrl + separator + paramName + '=' + Date.now() + hash;
    window.location.replace(fallbackUrl);
  }
}假设你当前的页面地址是 https://example.com/dashboard?filter=active#section-2,在控制台或业务事件中执行 forceReloadPage('_t') 后:
- 浏览器重载的目标地址为:
https://example.com/dashboard?filter=active&_t=1700001234567#section-2 - 原有的
filter=active和#section-2锚点被完好无损地保留下来。 - 若后续再次触发强刷,参数会自动刷新为最新的毫秒值,不会产生类似
_t=111&_t=222的重复脏参数。
四、进阶场景:Service Worker 与离线缓存的彻底重置
如果你的 Web 应用采用了现代渐进式 Web 应用(PWA)架构,或者项目中配置了 Service Worker,那么即使在 URL 后面附加了时间戳,刷新时仍然可能遇到旧内容!
这是因为 Service Worker 的运行优先级高于浏览器的常规网络缓存。一旦它的 fetch 事件监听器配置了“Cache First(缓存优先)”或针对 HTML 文档匹配策略做了无参数匹配(忽略 query string),请求就会在到达网络层之前被 Service Worker 直接截获,并从 CacheStorage 中返回旧版本。
对于存在 Service Worker 的项目,如果需要彻底执行前台强制重置,必须在重载之前:先注销已注册的 Service Worker 实例,并清空 Cache Storage 离线缓存表,最后再执行时间戳重载。
/**
 * 彻底清除 Service Worker 与本地离线缓存后执行强制重载
 */
async function hardResetAndReload() {
  // 1. 注销所有活跃的 Service Worker 注册对象
  if ('serviceWorker' in navigator) {
    try {
      const registrations = await navigator.serviceWorker.getRegistrations();
      for (const registration of registrations) {
        await registration.unregister();
      }
    } catch (e) {
      console.warn('注销 Service Worker 失败:', e);
    }
  }

  // 2. 清空 CacheStorage 中的所有离线资源缓存
  if ('caches' in window) {
    try {
      const cacheNames = await caches.keys();
      for (const name of cacheNames) {
        await caches.delete(name);
      }
    } catch (e) {
      console.warn('清空 CacheStorage 失败:', e);
    }
  }

  // 3. 执行 URL 时间戳强制跳转
  forceReloadPage('_reset');
}
五、工程化与多层防护总结
在实际生产工程中,通过纯前端 JavaScript 修改 URL 进行强制刷新,多用于用户主动反馈白屏/版本落后时的应急修复手段或版本更新弹窗中的“立即更新”按钮逻辑。要从根本上规避“页面不更新”的问题,应当建立前后端协同的多层防护体系。
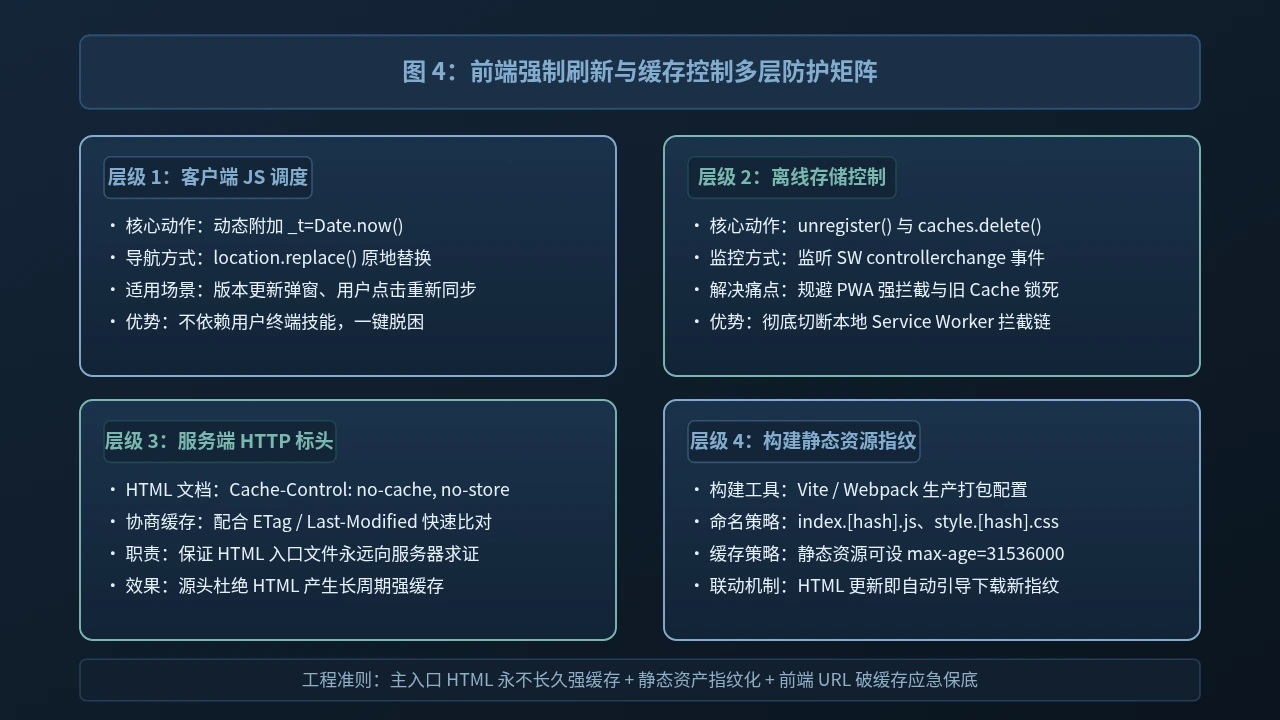
缓存与强制刷新常见方案对比
| 方案 | 实现方式 | 现代浏览器支持度 | 缓存穿透效果 | 综合推荐建议 |
|---|---|---|---|---|
| location.reload(true) | 传参布尔值 true |
参数已废弃并被忽略 | 极差(等同于普通刷新,复用强缓存) | 不推荐使用,属历史残留误区 |
| URL 时间戳法(本文推荐) | 修改查询参数并 location.replace() |
所有主流浏览器 100% 兼容 | 优秀(改变 Request URI 彻底穿透) | 强烈推荐,前端实现成本低且最可靠 |
| 清理 SW + CacheStorage | 异步注销 SW 并清空离线缓存 | 现代支持 Promise/PWA 的环境 | 彻底(解决离线拦截问题) | PWA / 含有离线配置的项目必备配套 |
| 服务端 Cache-Control | Nginx 配置 no-cache, no-store |
HTTP 协议通用标准 | 完美(主 HTML 永远保持最新) | 架构必备,从源头根治页面缓存 |
六、注意事项与易错提醒
- 不要频繁在常规逻辑中无条件调用强刷函数:如果在页面一加载完成时就自动执行带时间戳的强刷,会导致页面陷入死循环刷新,进而耗尽用户流量并导致浏览器崩溃。强制刷新必须绑定在明确的触发条件之后(例如:捕获到接口返回特定版本号过期标识、或者用户在更新通知栏中手动点击了“确认重载”按钮)。
- 避免滥用
location.href = ...:前文已经强调,给location.href赋值会向浏览历史栈推入新纪录。如果连续刷新两次,用户在点击后退按钮时会依次退回旧时间戳页面,导致“后退失灵”。务必优先选用location.replace()。 - 服务端 CDN 与反向代理缓存考量:如果你的静态资源部署在 Cloudflare、七牛云或腾讯云 CDN 上,默认情况下绝大多数 CDN 会将 Query 字符串视为不同资源(Query String Caching)。这也意味着 URL 附加时间戳不仅能穿透客户端浏览器缓存,还能穿透中间 CDN 的边缘节点缓存,直接回源拉取最新部署。
JS使用FileReader读取文本出现乱码怎么解决
2026-11-18 22:19:59
浏览器控制台怎么调试Web前端JavaScript报错
2026-11-18 21:39:22
JS判断移动端与CSS媒体查询该怎么选择
2026-11-18 20:53:40
JS事件捕获与冒泡的区别:执行顺序与适用场景对比
2026-11-18 19:33:42
怎么用JavaScript监听滚动或窗口变化动态调整CSS样式
2026-11-18 16:57:57