

JS怎么从HTML字符串中移除标签提取纯文本
详细讲解在JavaScript中从HTML字符串移除所有标签并提取纯文本的方法。涵盖浏览器环境DOMParser最佳实践、正则表达式的边界与陷阱、Node.js服务端处理方案以及实体解码与换行控制。
DOMParser 创建独立脱机文档,剔除 <script> 与 <style> 干扰节点后读取 textContent;在轻量受限场景下可配合实体转换表使用多阶正则表达式;在 Node.js 服务端,则应借助专门的 cheerio 或 html-to-text 虚拟解析引擎。
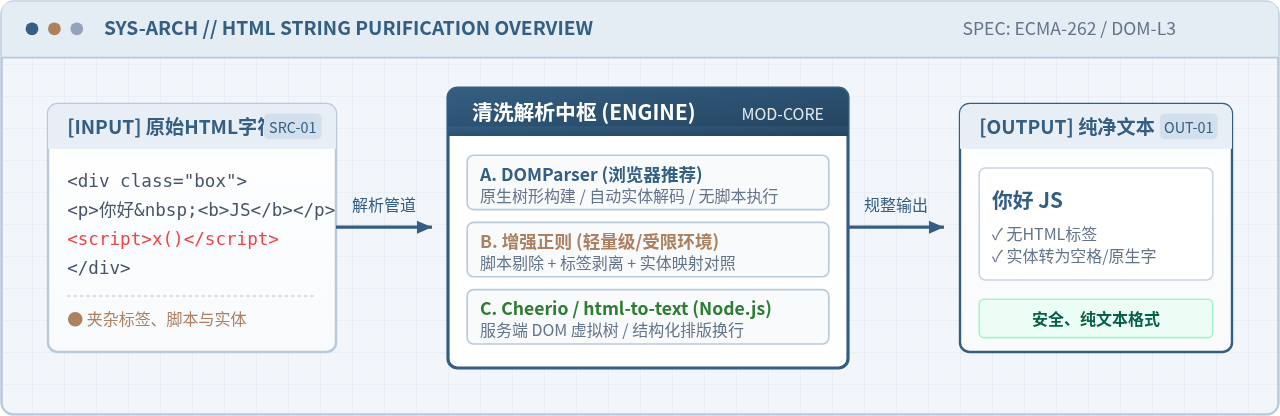
一、浏览器标准解法:使用 DOMParser 提取纯文本
在浏览器环境中,很多初学者会习惯创建一个虚拟 div 元素,通过 div.innerHTML = htmlString 赋值后再读取 div.innerText。这种做法存在不可忽视的安全隐患与性能缺陷:如果字符串中包含恶意载荷或带有 onerror 的外部图片标签,在某些特殊情况下可能引发非预期的网络请求甚至代码注入;同时频繁触发真实页面渲染树的计算也会降低运行效率。
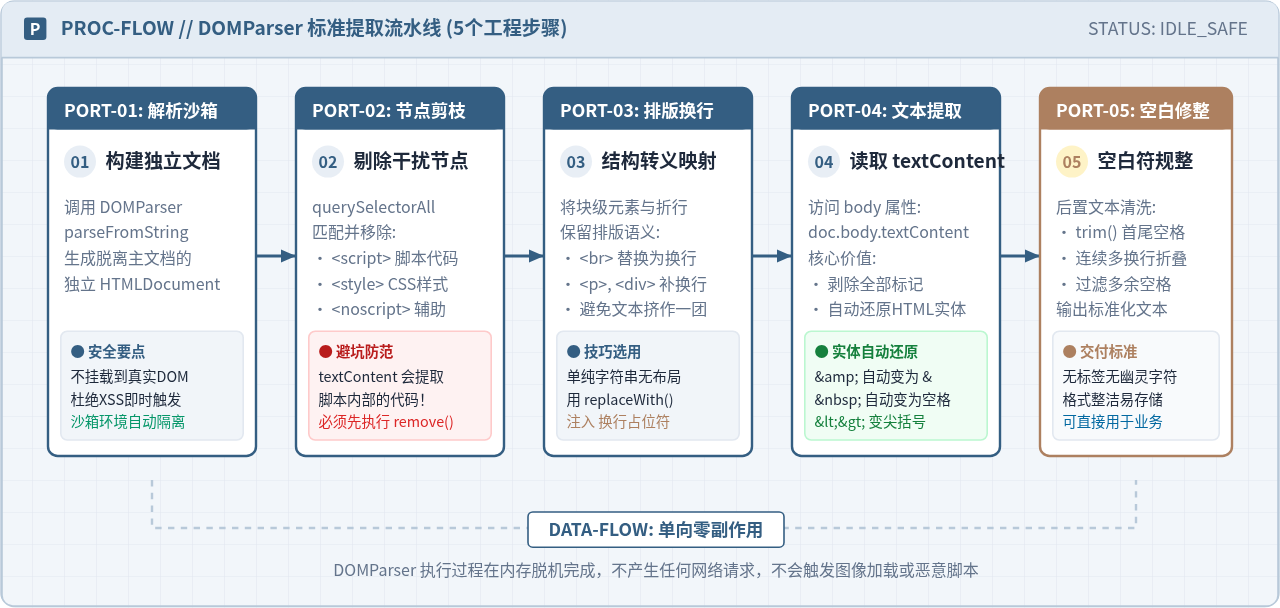
现代浏览器提供了原生沙箱解析器 DOMParser。它能直接将字符串构建为独立的脱机文档对象(Disconnected HTMLDocument),在此过程中不会执行任何内联脚本,也不会发起媒体资源加载。
1. 完整实现代码
一个健壮的提取函数不仅需要剥离 HTML 标签,还必须妥善处理以下三项细节:
- 移除不可见内容:
<script>与<style>标签内部的代码属于程序逻辑与样式描述,不能作为纯文本内容被读取出来。 - 保留段落换行:将
<br>以及块级容器(如<p>、<div>)替换为自然换行符,避免不同行文字粘贴成整句。 - 还原实体字符:浏览器在解析 DOM 文本节点时,会自动把
&、<、 等实体解码为人类可读的原生字符。
/**
 * 从 HTML 字符串中安全移除标签并提取纯文本
 * @param {string} htmlString - 包含标签的原始 HTML 字符串
 * @returns {string} 规整后的纯文本内容
 */
function extractTextFromHTML(htmlString) {
  if (!htmlString || typeof htmlString !== 'string') {
    return '';
  }

  // 1. 创建独立的脱机解析器,生成隔离的 HTML 文档
  const parser = new DOMParser();
  const doc = parser.parseFromString(htmlString, 'text/html');

  // 2. 剪枝处理:移除脚本、样式等非内容性标签,防止其代码文本泄露
  const noisyElements = doc.body.querySelectorAll('script, style, noscript, svg');
  noisyElements.forEach(element => element.remove());

  // 3. 换行语义补齐:将 <br> 替换为换行符
  const lineBreaks = doc.body.querySelectorAll('br');
  lineBreaks.forEach(br => br.replaceWith('\n'));

  // 4. 提取纯文本:textContent 自动剥除所有标签,并完成 HTML 实体解码
  const rawText = doc.body.textContent || '';

  // 5. 空白字符规整:去除行首行尾空白,折叠连续多余空行
  return rawText
    .replace(/\r\n|\r/g, '\n')      // 统一换行符
    .replace(/[ \t]+/g, ' ')           // 合并连续水平空格
    .replace(/\n\s*\n/g, '\n')       // 合并连续空行
    .trim();
}
2. 运行示例与结果对比
我们提供一个包含脚本注入、样式块、换行标签和实体字符的综合测试用例:
// 模拟测试输入:含脚本、样式、块级段落及实体编码
const sampleHTML = `
<div class="article-content">
<h2>JavaScript 核心指南</h2>
<style>.article-content { font-size: 14px; }</style>
<p>学习前端开发,<strong>安全第一</strong>。<br>版本 >= ES6 & 规范。</p>
<script>console.log("敏感执行脚本");</script>
</div>
`;
const result = extractTextFromHTML(sampleHTML);
console.log(result);
/*
输出结果:
JavaScript 核心指南
学习前端开发,安全第一。
版本 >= ES6 & 规范。
*/从输出中可以看出,<script> 与 <style> 内部的代码被彻底剔除, 转换为空格,>= 与 & 正确还原为 >= 和 &,同时 <br> 保持了正确的换行形态。
二、正则表达式方案:适用场景与致命陷阱
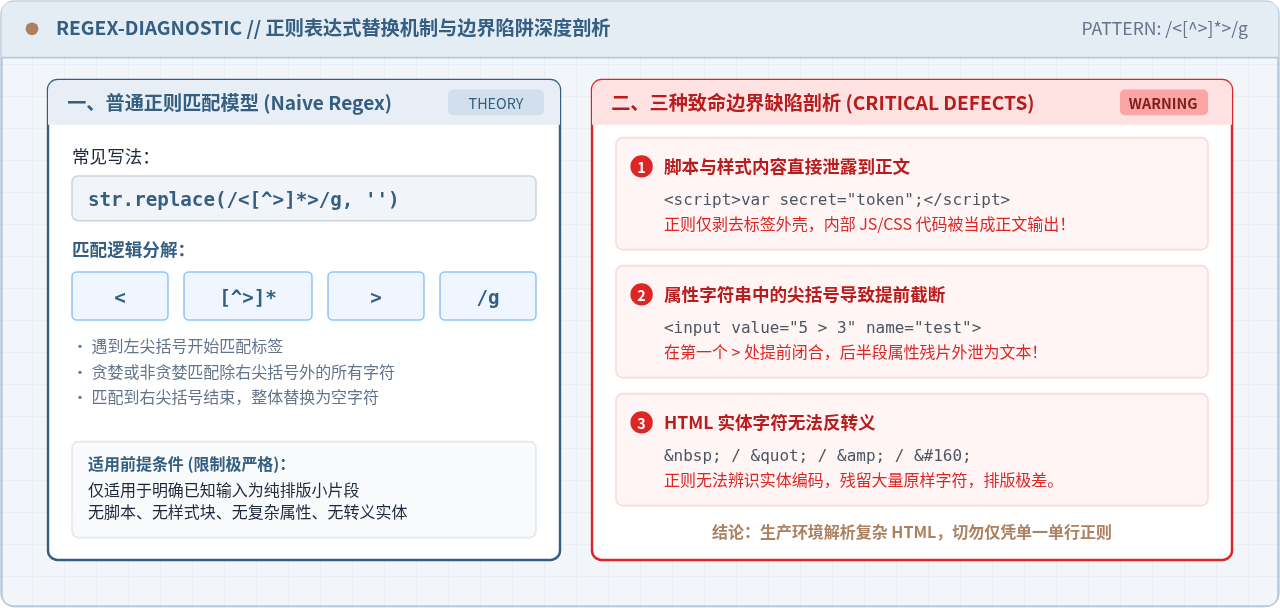
在部分简单的业务场景或资源受限的微服务工具函数中,开发者往往希望使用无外部依赖的正则表达式完成标签剥离。常见的简单写法如下:
const naiveText = html.replace(/<[^>]*>/g, '');这种纯粹基于模式匹配的替换在应对规则极其简单、由受信任系统生成的简短富文本时确实开销极小。然而,若将其直接应用于通用或用户输入的 HTML 字符串,会暴露三个无法逾越的缺陷:
1. 脚本与样式外泄:标签本身被剥离后,<script>var token="123";</script> 内部的 JavaScript 代码会直接暴露并拼接入正文中。
2. 属性内尖括号逃逸:如遇到带有属性比较值的标签 <input value="a > b">,正则会在第一个 > 处提前结束匹配,将后半段属性字符串错当成正文输出。
3. HTML 实体无法还原:&、<、" 以及数字实体   依然保持编码字符串形态,无法被阅读和分词。
增强型多阶段正则替换流水线
如果出于性能或环境限制必须使用纯正则,需要采用多步替换流水线:先剔除全量脚本和样式,再剥离标签,最后通过实体映射表进行反转义。
function extractTextRegex(htmlString) {
if (!htmlString || typeof htmlString !== 'string') return '';
// 1. 预先清除 <script> 与 <style> 及其内部包含的所有文本
let text = htmlString
.replace(/<script\b[^<]*(?:(?!<\/script>)<[^<]*)*<\/script>/gi, '')
.replace(/<style\b[^<]*(?:(?!<\/style>)<[^<]*)*<\/style>/gi, '');
// 2. 将 <br> 及常见块级闭合标签转换为换行占位
text = text.replace(/<br\s*\/?>/gi, '\n')
.replace(/<\/(p|div|h[1-6]|li)>/gi, '\n');
// 3. 移除剩余的所有 HTML 标签
text = text.replace(/<[^>]+>/g, '');
// 4. 常见 HTML 实体基础反转义映射
const entityMap = {
' ': ' ',
'&': '&',
'<': '<',
'>': '>',
'"': '"',
''': "'",
'—': '—'
};
text = text.replace(/&(nbsp|amp|lt|gt|quot|#39|mdash);/g, match => entityMap[match] || match);
// 5. 收尾修剪
return text.replace(/[ \t]+/g, ' ').replace(/\n\s*\n/g, '\n').trim();
}三、服务端 Node.js 环境的处理方案
在 Node.js 环境或无头运行的服务端函数中,全局作用域下并不存在 window 或 DOMParser 对象。如果在服务端直接调用,会抛出 ReferenceError: DOMParser is not defined。针对服务端,业界通常采用以下两套成熟的工程方案:
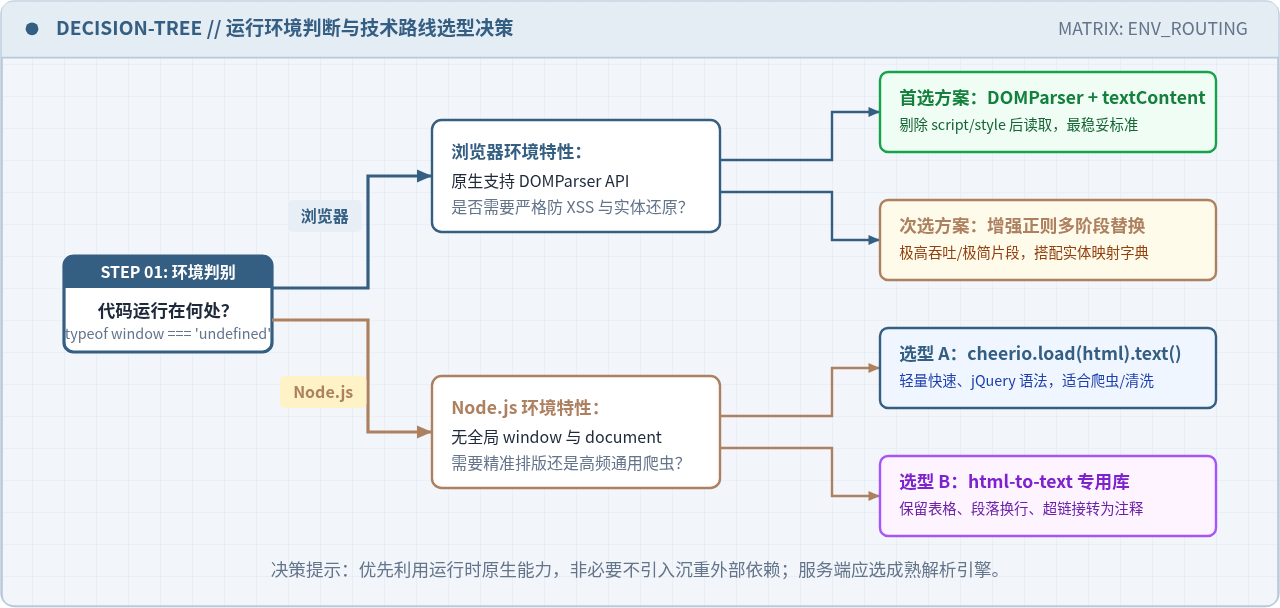
方案一:使用 Cheerio(高性能虚拟 DOM 树)
cheerio 基于 parse5 与 htmlparser2,专为服务端设计。它提供了与 jQuery 高度一致的 API,解析速度极快且完全不会执行任何页面脚本。
// 需先安装依赖: npm install cheerio
const cheerio = require('cheerio');

function extractWithCheerio(htmlString) {
  if (!htmlString) return '';

  // 载入 HTML 片段
  const $ = cheerio.load(htmlString);

  // 移除干扰节点
  $('script, style, noscript').remove();

  // 换行语义转换
  $('br').replaceWith('\n');
  $('p, div, h1, h2, h3, h4, h5, h6, li').each((_, el) => {
    $(el).append('\n');
  });

  // 提取纯文本并规整
  return $.text()
    .replace(/[ \t]+/g, ' ')
    .replace(/\n\s*\n/g, '\n')
    .trim();
}
方案二:使用 html-to-text(格式化文本生成器)
如果应用场景对最终纯文本的排版有严格要求,例如需要将 HTML 邮件转换为整洁的纯文本备用内容,或者将带表格的文章提取为对齐的文本行,专门的 html-to-text 库是最佳选择:
// 需先安装依赖: npm install html-to-text
const { compile } = require('html-to-text');

// 预编译转换器配置
const converter = compile({
  wordwrap: 130,
  selectors: [
    { selector: 'a', options: { ignoreHref: true } },       // 仅保留超链接文字,忽略URL
    { selector: 'img', format: 'skip' },                     // 跳过图片
    { selector: 'script', format: 'skip' },                  // 跳过脚本
    { selector: 'style', format: 'skip' }                    // 跳过样式
  ]
});

const plainText = converter('<p>段落一</p><p>段落二</p>');
console.log(plainText);
// 输出:
// 段落一
//
// 段落二
四、关键工程边界与细节处理
1. 为什么不能直接使用 innerText
在浏览器中,Element.innerText 虽然能够考虑部分 CSS 换行属性,但它有一个根本限制:innerText 依赖浏览器的布局引擎(Layout Engine)。如果元素尚未挂载到真实的页面 DOM 树中(即脱机节点),不同浏览器对其样式的推断行为可能不一致;此外,频繁触发排版重绘(Reflow)会对批量文本处理带来数倍的性能损耗。相比之下,textContent 属于轻量级的纯 DOM 树遍历,性能高且跨浏览器行为完全一致。
2. 特殊字符与连续空格的折叠
HTML 规范默认会将代码中的连续空格与回车折叠为一个空格。提取为纯文本后,通常建议使用正则进行一次清洗,将多余的横向制表符和连续空格压缩为单个空格,并把两个以上的换行符压缩为双换行,使输出结果符合标准文本排版习惯。
五、全场景技术选型对比与总结
为了帮助开发者根据项目实际运行环境与性能指标进行理性决策,下表总结了各方案的核心参数:
| 技术方案 | 运行环境 | 安全性保障 | 实体还原 | 排版保持能力 | 性能表现 |
|---|---|---|---|---|---|
| DOMParser + textContent | 浏览器原生 | 极高(沙箱隔离) | 浏览器原生自解码 | 良好(通过节点替换) | 优(原生 C++ 核心) |
| 增强正则表达式流水线 | 跨环境通用 | 中(需手工防注入) | 需维护实体字典 | 较弱(扁平替换) | 极高(微秒级吞吐) |
| Cheerio | Node.js 服务端 | 极高(无脚本执行) | 自动完全解码 | 良好(支持 DOM 操作) | 优(轻量虚拟树) |
| html-to-text | Node.js 服务端 | 极高 | 自动完全解码 | 卓越(表格/列表对齐) | 中等(含排版算法) |
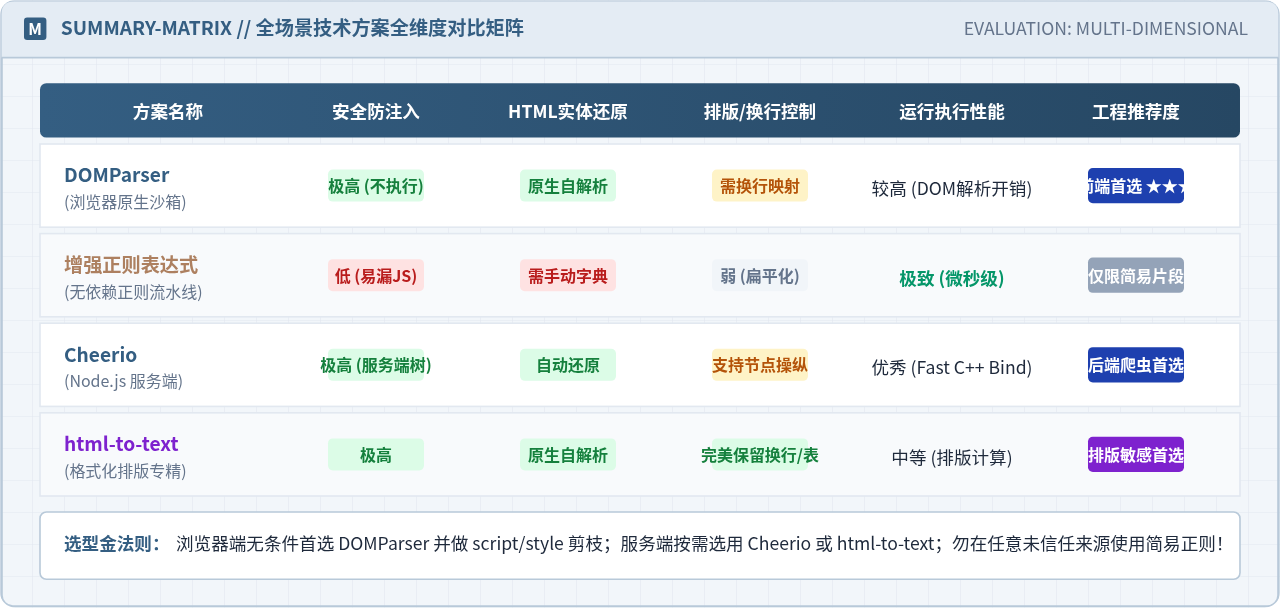
总结选型指导:
- 若在现代浏览器前端,请直接采用封装好的
DOMParser流程,先移除script/style,再取textContent,兼顾安全性、实体还原和格式规范。 - 若在Node.js 爬虫或接口处理中,直接引入
cheerio作为解析中枢,既能防范脚本外泄,又保留了灵活的节点修整能力。 - 对于由明确内部模板生成的极简文本片段,若对执行吞吐有极致要求,可采用经过严格转义增强的正规化正则流水线。
在浏览器前端运行JavaScript汇编器并可视化执行结果
2026-11-18 19:28:34
JS检测浏览器时怎么处理User-Agent伪造问题
2026-11-18 18:02:44
JavaScript怎么修改元素文字和背景颜色
2026-11-18 17:56:08
纯CSS3 Transform能否替代JS实现复杂抽奖转盘?
2026-11-18 17:32:53
JS中stopPropagation与preventDefault有什么区别
2026-11-18 17:12:13







