在浏览器前端运行JavaScript汇编器并可视化执行结果
详细讲解如何在纯前端浏览器环境中,使用原生JavaScript构建微型汇编器与虚拟机执行引擎,实现从汇编代码解析、两遍扫描编码到单步执行与寄存器、内存视图响应式可视化的完整实践方案。
在现代浏览器前端运行汇编语言并实时可视化执行状态,无需任何服务端编译器或重量级外部依赖。通过纯原生 JavaScript 实现“词法与两遍扫描汇编器(Assembler)”、“微型虚拟微架构引擎(Virtual Machine)”以及“基于 DOM 增量绑定的响应式看板(Visual Dashboard)”,开发者即可在浏览器中完成从文本源码到二进制字节码的毫秒级编译,并通过可控时钟循环直观追踪程序计数器(PC)步进、寄存器数值跳变及内存阵列的读写热点。
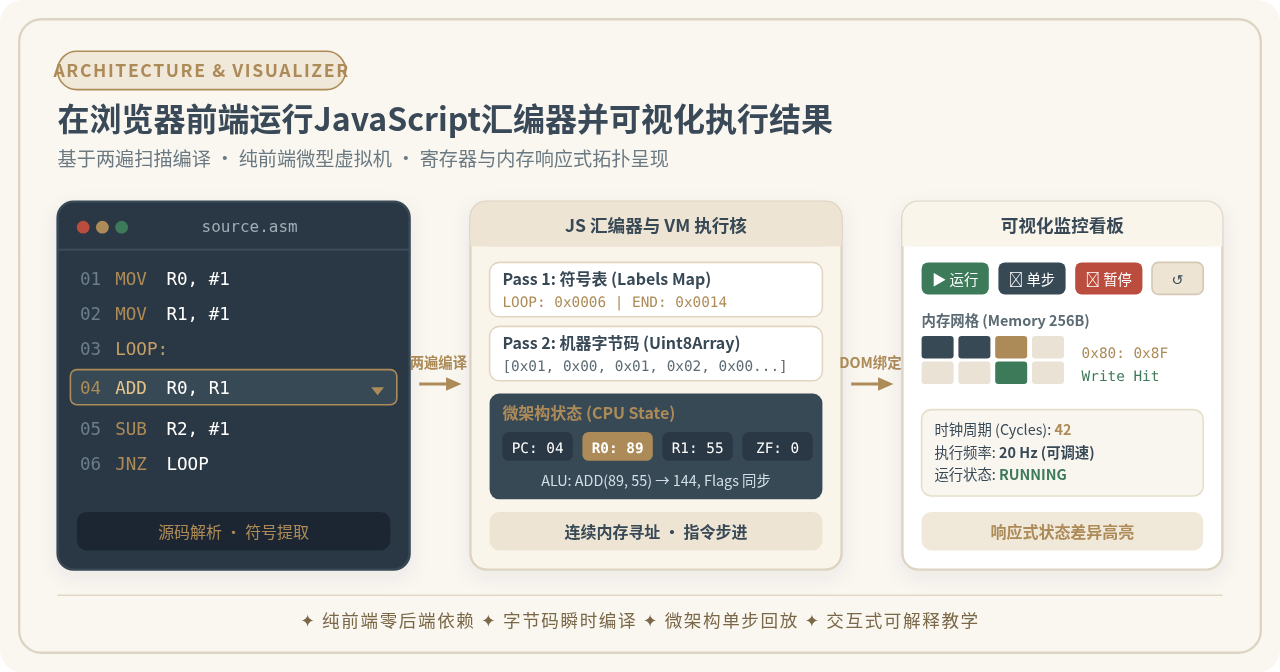
一、整体架构设计与微型指令集(ISA)定义
要在浏览器前端构建一套直观、可解释的汇编环境,首先必须定义一套结构简洁但具备典型计算机体系结构特征的微型指令集(ISA)。如果直接模拟 x86 或 ARM64 等现代复杂指令集,庞大的指令寻址模式和状态标志会使前端教学与可视化逻辑急剧膨胀,掩盖核心概念;而设计一个包含 4 个通用寄存器、常用寻址模式与标志位的微型体系,既能完整呈现冯·诺依曼架构的运算过程,又能确保执行流与渲染绑定的高内聚。
1.1 微架构组件规范
本系统的微架构模型包含以下基础运行组件:
- 通用寄存器(General Purpose Registers):
R0、R1、R2、R3,每个寄存器存放 8 位或 16 位整型数据,默认为无符号 8 位整型(范围 0 ~ 255)。 - 程序计数器(PC, Program Counter):保存当前正在执行或下一条指令的字节地址指针,初始值为
0x0000。 - 状态标志寄存器(Flags):包含零标志位
ZF(计算结果为 0 时置 1,否则置 0)和进位/借位标志位CF(发生溢出或借位时置 1)。 - 连续内存空间(Memory):使用原生
Uint8Array(256)分配 256 字节的连续线性地址空间。低地址段(0x00 ~ 0x7F)默认用于存储编译后的程序机器字节码,高地址段(0x80 ~ 0xFF)开放作为变量存储区与数据缓冲区。
1.2 指令助记符与机器操作码(Opcode)表
系统提供 8 条核心指令,涵盖数据移动、算术运算、条件比较、无条件/条件跳转及停机控制:
| 助记符 | 操作码 (Hex) | 支持寻址模式 | 功能语义说明 |
|---|---|---|---|
MOV dest, src |
0x01 |
Reg <= Imm, Reg <= Reg, Reg <= [Mem], [Mem] <= Reg | 数据传送指令:将源操作数的值写入目标寄存器或目标内存单元。 |
ADD dest, src |
0x02 |
Reg <= Reg, Reg <= Imm, Reg <= [Mem] | 加法指令:计算 dest + src 并写回 dest,更新 ZF 与 CF。 |
SUB dest, src |
0x03 |
Reg <= Reg, Reg <= Imm, Reg <= [Mem] | 减法指令:计算 dest - src 并写回 dest,更新 ZF 与 CF。 |
CMP a, b |
0x04 |
Reg vs Imm, Reg vs Reg | 比较指令:执行 a - b 算术减法但不保存结果,仅依据差值更新 ZF 和 CF。 |
JMP target |
0x05 |
Label / Imm (绝对地址) | 无条件跳转指令:将 PC 无条件修改为目标地址。 |
JZ target |
0x06 |
Label / Imm (绝对地址) | 条件跳转指令:若当前 ZF == 1 则跳转至目标地址;否则继续顺序执行。 |
JNZ target |
0x07 |
Label / Imm (绝对地址) | 条件跳转指令:若当前 ZF == 0 则跳转至目标地址;否则继续顺序执行。 |
HLT |
0xFF |
无操作数 | 停机指令:停止虚拟 CPU 的时钟周期循环,触发执行完成回调。 |
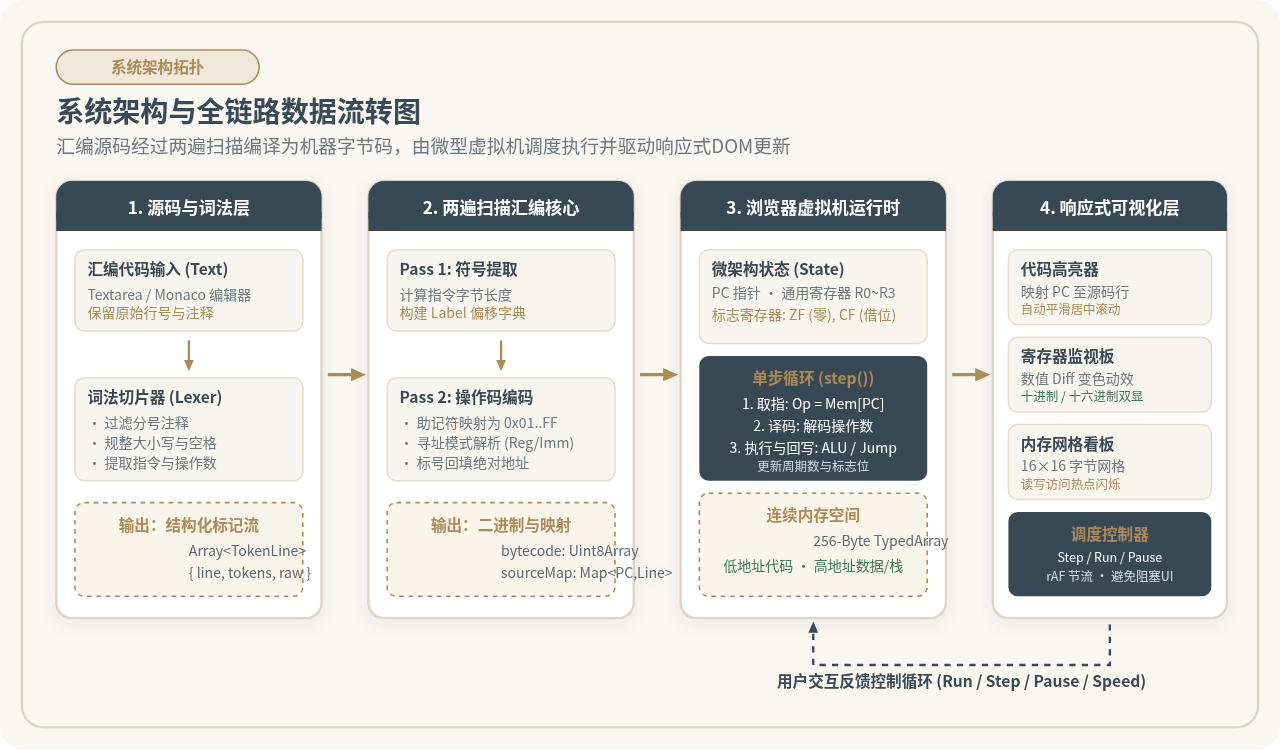
二、两遍扫描汇编器(Assembler)的纯前端实现
汇编器的职责是将人类可读的汇编代码文本转换为二进制机器码。编写纯前端汇编器面临的核心挑战是标号前向引用(Forward Referencing)——例如在第一行执行 JNZ FINISH,但 FINISH: 标号可能定义在第 20 行,解析第 1 行时该地址尚属未知。
业界解决前向引用的经典模式是“两遍扫描(Two-Pass Scanning)”:
- 第一遍扫描(Pass 1):逐行读取文本,剥离注释与多余空白。为每条指令计算预期的机器字节长度并累加偏移指针(PC Offset);当扫描到标号定义(如
LOOP:)时,记录当前偏移到符号表Map<Label, Offset>,同时建立源码行号与字节偏移的双向映射索引表(SourceMap)。 - 第二遍扫描(Pass 2):重新遍历规范化的指令流。此时所有标号的绝对内存地址均已在符号表中确定,汇编器将助记符转换为操作码(Opcode),将寄存器名、直接数值及内存寻址编码为操作数,将跳转标号直接替换为目标地址,最终生成定长的
Uint8Array字节流。
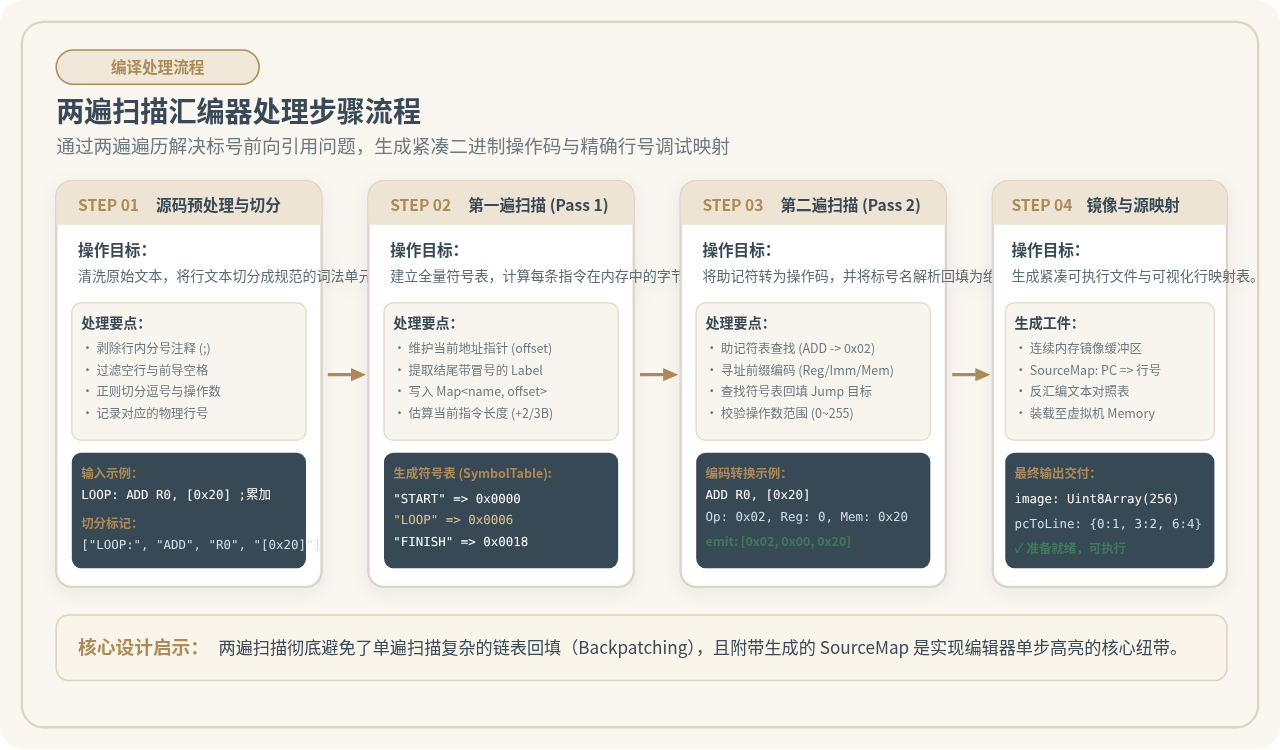
2.1 汇编器核心实现代码
以下为不依赖任何第三方解析库的纯 JavaScript 汇编器完整实现代码:
// 助记符与操作码映射表
const OPCODES = {
  MOV: 0x01,
  ADD: 0x02,
  SUB: 0x03,
  CMP: 0x04,
  JMP: 0x05,
  JZ:  0x06,
  JNZ: 0x07,
  HLT: 0xFF
};

// 寄存器编号映射
const REGISTERS = {
  R0: 0,
  R1: 1,
  R2: 2,
  R3: 3
};

// 操作数类型标志
const OPERAND_TYPE = {
  REG: 0,
  IMM: 1,
  MEM: 2
};

class MiniAssembler {
  constructor() {
    this.symbolTable = new Map();
    this.sourceMap = new Map(); // byteOffset -> sourceLineNumber
  }

  // 词法清洗与标记解析
  preprocess(sourceText) {
    const rawLines = sourceText.split('\n');
    const tokenizedLines = [];

    rawLines.forEach((raw, idx) => {
      const lineNum = idx + 1;
      // 剥离分号注释并去除头尾空格
      const clean = raw.split(';')[0].trim();
      if (!clean) return; // 忽略空行

      let lineContent = clean;
      let label = null;

      // 提取标号 (例如 "LOOP: MOV R0, #1" 或 "START:")
      const labelMatch = lineContent.match(/^([A-Za-z_][A-Za-z0-9_]*):\s*/);
      if (labelMatch) {
        label = labelMatch[1].toUpperCase();
        lineContent = lineContent.slice(labelMatch[0].length).trim();
      }

      let mnemonic = null;
      let operands = [];

      if (lineContent) {
        // 分割助记符与操作数
        const parts = lineContent.split(/[\s,]+/);
        mnemonic = parts[0].toUpperCase();
        operands = parts.slice(1).map(p => p.trim());
      }

      tokenizedLines.push({
        lineNum,
        label,
        mnemonic,
        operands,
        raw: clean
      });
    });

    return tokenizedLines;
  }

  // 第一遍扫描:构建符号表并计算字节步长
  pass1(tokens) {
    this.symbolTable.clear();
    let currentOffset = 0;

    for (const item of tokens) {
      if (item.label) {
        if (this.symbolTable.has(item.label)) {
          throw new Error(`第 ${item.lineNum} 行错误: 重复定义的标号 "${item.label}"`);
        }
        this.symbolTable.set(item.label, currentOffset);
      }

      if (item.mnemonic) {
        item.offset = currentOffset;
        // 计算指令所需字节数
        const byteLength = this.getInstructionLength(item.mnemonic, item.operands);
        currentOffset += byteLength;
        if (currentOffset > 256) {
          throw new Error(`第 ${item.lineNum} 行错误: 编译产物超出 256 字节内存空间上限`);
        }
      }
    }
  }

  // 计算单条指令长度(固定 3 字节或 1 字节)
  getInstructionLength(mnemonic, operands) {
    if (mnemonic === 'HLT') return 1;
    if (['JMP', 'JZ', 'JNZ'].includes(mnemonic)) return 2; // Opcode + 目标地址
    return 3; // Opcode + OpType/Reg + Operand2
  }

  // 第二遍扫描:指令编码与机器码输出
  pass2(tokens) {
    this.sourceMap.clear();
    const bytecode = [];

    for (const item of tokens) {
      if (!item.mnemonic) continue;

      this.sourceMap.set(item.offset, item.lineNum);
      const opcode = OPCODES[item.mnemonic];
      if (opcode === undefined) {
        throw new Error(`第 ${item.lineNum} 行错误: 未知指令 "${item.mnemonic}"`);
      }

      if (item.mnemonic === 'HLT') {
        bytecode.push(opcode);
        continue;
      }

      if (['JMP', 'JZ', 'JNZ'].includes(item.mnemonic)) {
        bytecode.push(opcode);
        const target = item.operands[0];
        let addr = 0;
        if (this.symbolTable.has(target)) {
          addr = this.symbolTable.get(target);
        } else if (!isNaN(parseInt(target, 10))) {
          addr = parseInt(target, 10);
        } else {
          throw new Error(`第 ${item.lineNum} 行错误: 无法解析跳转标号 "${target}"`);
        }
        bytecode.push(addr & 0xFF);
        continue;
      }

      // MOV, ADD, SUB, CMP 双操作数编码
      bytecode.push(opcode);
      const [destStr, srcStr] = item.operands;
      const [destType, destVal] = this.parseOperand(destStr);
      const [srcType, srcVal] = this.parseOperand(srcStr);

      // 编码寻址元数据 (高4位源类型,低4位目标类型/目标寄存器)
      const meta = (srcType << 4) | (destVal & 0x0F);
      bytecode.push(meta);
      bytecode.push(srcVal & 0xFF);
    }

    const resultBuffer = new Uint8Array(256);
    resultBuffer.set(bytecode, 0);
    return { bytecode: resultBuffer, length: bytecode.length, sourceMap: this.sourceMap };
  }

  parseOperand(opStr) {
    if (!opStr) return [0, 0];
    const upper = opStr.toUpperCase();
    if (upper in REGISTERS) {
      return [OPERAND_TYPE.REG, REGISTERS[upper]];
    }
    // 内存直接寻址 [0x80] 或 [128]
    if (opStr.startsWith('[') && opStr.endsWith(']')) {
      const inner = opStr.slice(1, -1).trim();
      const addr = inner.startsWith('0X') || inner.startsWith('0x')
        ? parseInt(inner, 16)
        : parseInt(inner, 10);
      return [OPERAND_TYPE.MEM, addr];
    }
    // 立即数 #10 或纯数字 10
    const cleanNum = opStr.startsWith('#') ? opStr.slice(1) : opStr;
    const num = cleanNum.startsWith('0X') || cleanNum.startsWith('0x')
      ? parseInt(cleanNum, 16)
      : parseInt(cleanNum, 10);
    return [OPERAND_TYPE.IMM, num];
  }

  assemble(sourceText) {
    const tokens = this.preprocess(sourceText);
    this.pass1(tokens);
    return this.pass2(tokens);
  }
}
三、虚拟机执行引擎与单步调度机制
前端虚拟机负责加载并运行机器字节码。在传统操作系统中,CPU 会以 GHz 级别的极高频率死循环执行指令;但在浏览器前端,如果直接使用 while(!halted) vm.step(),由于 JavaScript 属于单线程事件驱动模型,密集同步循环将立刻完全阻塞主渲染线程。用户不仅无法看到任何中间执行动画,浏览器还会触发“页面无响应”报警。
3.1 指令周期的微架构执行流程
虚拟机每个指令周期分为五个标准阶段:
- 取指(Fetch):根据当前
PC从内存数组取出操作码,临时指针递增。 - 译码(Decode):根据操作码类别读取后续的寻址元数据字节与参数操作数。
- 寻址读取(Read Operands):若源操作数为寄存器则直接取值,若为内存单元则触发内存总线读取。
- 执行(Execute):算术逻辑单元(ALU)进行运算或执行条件跳转判断,根据运算结果刷新
ZF与CF。 - 回写与视图同步(Writeback & Render):将计算结果写入目标寄存器或回写内存,更新
PC,并通过回调函数触发 DOM 增量渲染。
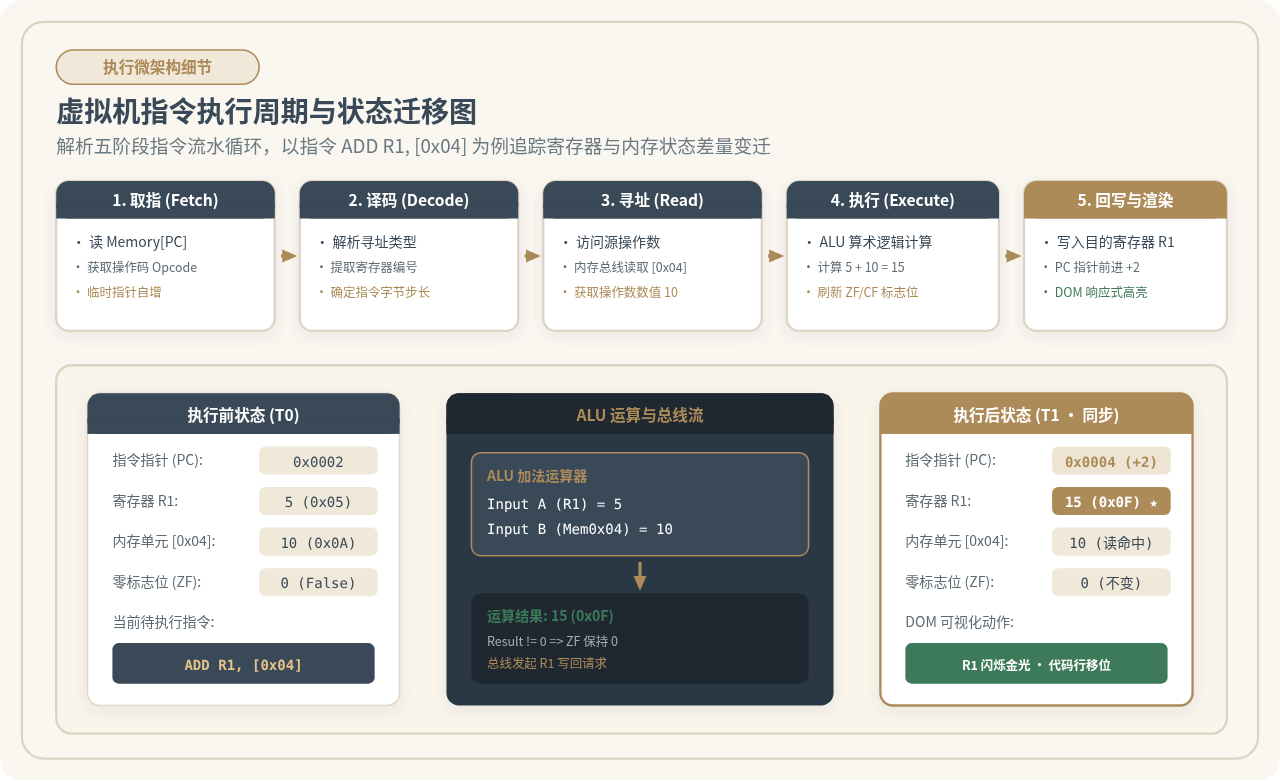
3.2 虚拟机核心实现代码
class MiniVM {
  constructor() {
    this.registers = new Uint8Array(4); // R0, R1, R2, R3
    this.memory = new Uint8Array(256);   // 256 字节连续物理内存
    this.pc = 0;                         // 程序计数器
    this.flags = { zf: false, cf: false };
    this.halted = false;
    this.cycles = 0;
    this.onStateChange = null;           // 状态更新回调
  }

  reset() {
    this.registers.fill(0);
    this.memory.fill(0);
    this.pc = 0;
    this.flags.zf = false;
    this.flags.cf = false;
    this.halted = false;
    this.cycles = 0;
  }

  load(bytecode) {
    this.reset();
    this.memory.set(bytecode);
  }

  // 单步执行核心
  step() {
    if (this.halted || this.pc >= 256) {
      this.halted = true;
      return false;
    }

    const startPC = this.pc;
    const opcode = this.memory[this.pc++];

    if (opcode === OPCODES.HLT) {
      this.halted = true;
      this.cycles++;
      this.notify(startPC, null, 'HLT');
      return false;
    }

    if (opcode === OPCODES.JMP || opcode === OPCODES.JZ || opcode === OPCODES.JNZ) {
      const targetAddr = this.memory[this.pc++];
      let taken = false;
      if (opcode === OPCODES.JMP) taken = true;
      else if (opcode === OPCODES.JZ && this.flags.zf) taken = true;
      else if (opcode === OPCODES.JNZ && !this.flags.zf) taken = true;

      if (taken) {
        this.pc = targetAddr;
      }
      this.cycles++;
      this.notify(startPC, null, 'JUMP');
      return true;
    }

    // 双操作数指令
    const meta = this.memory[this.pc++];
    const srcVal = this.memory[this.pc++];
    const srcType = (meta >> 4) & 0x0F;
    const destReg = meta & 0x0F;

    // 解析源操作数实际值
    let actualSrc = 0;
    if (srcType === OPERAND_TYPE.REG) {
      actualSrc = this.registers[srcVal];
    } else if (srcType === OPERAND_TYPE.IMM) {
      actualSrc = srcVal;
    } else if (srcType === OPERAND_TYPE.MEM) {
      actualSrc = this.memory[srcVal];
    }

    // 执行计算
    let diffInfo = { reg: destReg, prev: this.registers[destReg] };
    switch (opcode) {
      case OPCODES.MOV:
        this.registers[destReg] = actualSrc;
        break;
      case OPCODES.ADD: {
        const sum = this.registers[destReg] + actualSrc;
        this.flags.cf = sum > 255;
        this.registers[destReg] = sum & 0xFF;
        this.flags.zf = this.registers[destReg] === 0;
        break;
      }
      case OPCODES.SUB: {
        const diff = this.registers[destReg] - actualSrc;
        this.flags.cf = diff < 0;
        this.registers[destReg] = diff & 0xFF;
        this.flags.zf = this.registers[destReg] === 0;
        break;
      }
      case OPCODES.CMP: {
        const cmpDiff = this.registers[destReg] - actualSrc;
        this.flags.cf = cmpDiff < 0;
        this.flags.zf = (cmpDiff & 0xFF) === 0;
        break;
      }
    }

    this.cycles++;
    this.notify(startPC, diffInfo, 'EXEC');
    return true;
  }

  notify(lastPC, diff, action) {
    if (typeof this.onStateChange === 'function') {
      this.onStateChange({
        pc: this.pc,
        lastPC,
        registers: Array.from(this.registers),
        flags: { ...this.flags },
        memory: this.memory,
        cycles: this.cycles,
        halted: this.halted,
        diff,
        action
      });
    }
  }
}
四、响应式可视化看板的构建与数据绑定
前端可视化看板的质量决定了调试与教学的实际可用性。一个完备的汇编可视化看板包含四个相互联动的子系统:
- 代码行联动高亮(Source Synchronizer):利用汇编器生成的
sourceMap,在每次 VMstep()之后,将lastPC映射回物理行号,为对应的 DOM 节点添加高亮类名,并调用scrollIntoView({ behavior: 'smooth', block: 'nearest' })保持指针始终在可视区域内。 - 寄存器与标志位动态监视板:以卡片形式展示
R0 ~ R3、PC、ZF和CF。当某寄存器数值发生改变时,触发渐变发光动画(Pulse Animation),并将十进制与十六进制数值同步呈现。 - 内存矩阵热点检查器(Memory Grid Inspector):将 256 字节线性内存映射为 16×16 网格。针对当前指令读取或写入的内存地址,即时渲染访问热点色彩,直观区分静态代码段与动态数据段。
- 可调速调度控制器(Scheduler Controller):基于
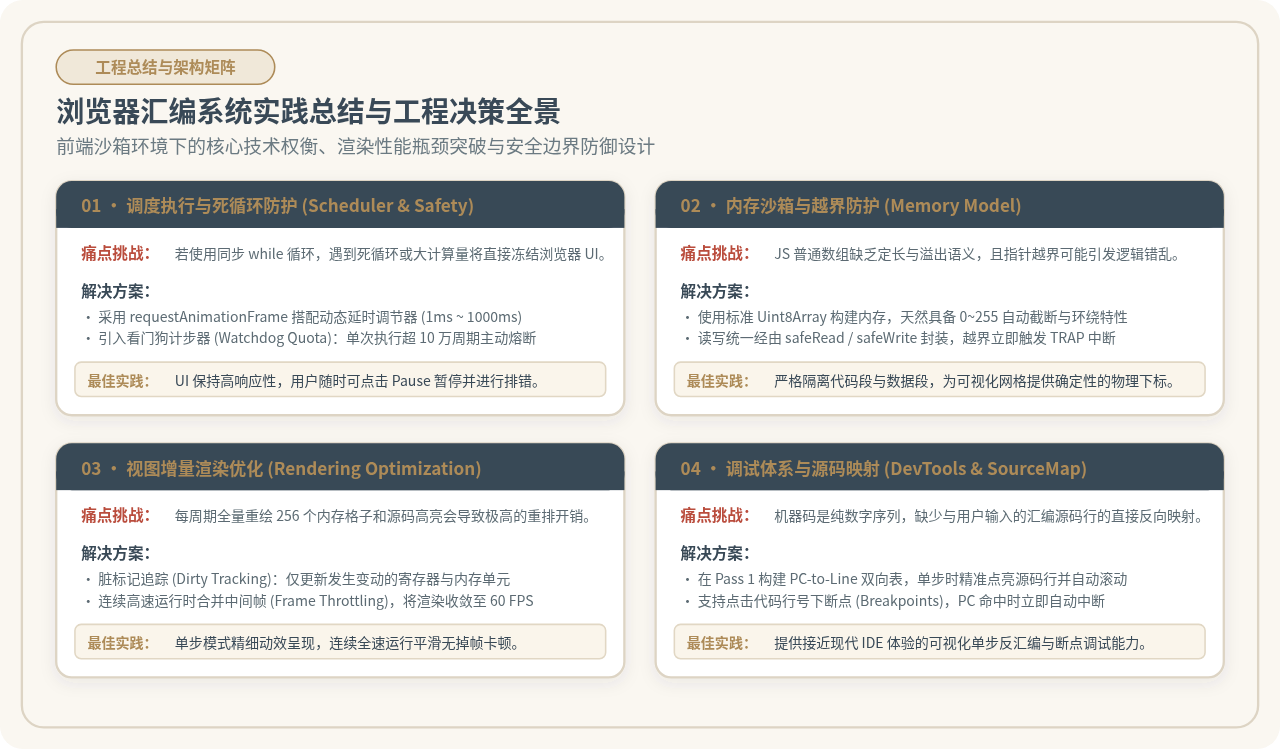
requestAnimationFrame结合时间节流阀,支持“单步步进(Step)”、“连续运行(Run)”、“暂停(Pause)”以及从 1 Hz 到 60 Hz 的无级调速。
五、完整集成实现与实测运行沙箱
以下为整合了代码输入、实时两遍汇编、单步/连续执行调度以及 DOM 状态可视化的自包含交互组件。你可以直接在下方操作台体验斐波那契数列计算程序的汇编与执行过程:
六、边界场景处理与前端工程注意事项
汇编程序极易因跳转条件设置错误出现无休止死循环(例如遗漏了 SUB 导致 JNZ 永远成立)。在前端实现连续执行时,必须设置单次执行周期的熔断阈值(如默认限制 100,000 次时钟周期)。一旦超过限额,虚拟机会主动触发停机并弹出警告,彻底消除标签页卡死风险。
当执行速率超过 100 Hz 时,若每一步都强制刷新全部 DOM 节点,浏览器的布局引擎(Reflow / Repaint)会承受巨大开销。工程实践推荐采用增量脏标记(Dirty Tracking)策略:仅在数值变化的寄存器节点上触发 class 变动;在连续全速运行模式下,可将每秒数百次的微指令合并为每 16ms(60 FPS)刷新一次最新状态快照。
3. 内存越界拦截与非法操作码 Trap
JavaScript 的 Uint8Array 下标访问如果超出范围,其默认行为是返回 undefined 并静默忽略写入,这与真实硬件产生总线错误(Bus Error)的机制严重相悖。
因此,虚拟机底层应将内存读写抽象为具备严格边界检查的函数:
safeRead(addr) {
  if (addr < 0 || addr >= 256) {
    this.halted = true;
    throw new RangeError(`硬件中断 TRAP: 非法内存越界读取 0x${addr.toString(16).toUpperCase()}`);
  }
  return this.memory[addr];
}

safeWrite(addr, val) {
  if (addr < 0 || addr >= 256) {
    this.halted = true;
    throw new RangeError(`硬件中断 TRAP: 非法内存越界写入 0x${addr.toString(16).toUpperCase()}`);
  }
  this.memory[addr] = val & 0xFF;
}
4. 大规模运算场景下的 Web Worker 解耦演进
本文介绍的主线程执行器非常适合教学演练与算法单步微观分析。如果未来需要模拟数十万行代码的大型指令系统,最佳演进方案是将 MiniVM 的运算循环移入独立 Web Worker 线程,利用 SharedArrayBuffer 或批量 postMessage 将寄存器差异传递给主线程渲染。这样能实现计算与视觉呈现的物理级绝对解耦,在保障极致运算性能的同时,维持 UI 界面的极致丝滑。
JS怎么从HTML字符串中移除标签提取纯文本
2026-11-18 18:58:39
JS检测浏览器时怎么处理User-Agent伪造问题
2026-11-18 18:02:44
JavaScript怎么修改元素文字和背景颜色
2026-11-18 17:56:08
纯CSS3 Transform能否替代JS实现复杂抽奖转盘?
2026-11-18 17:32:53
JS中stopPropagation与preventDefault有什么区别
2026-11-18 17:12:13