

JS读取表格数据时怎么跳过表头和空行
深入讲解在JavaScript中读取网页HTML表格及二维数据矩阵时,如何精准跳过表头行并彻底过滤各类可见及不可见空行,提供完整代码示例与边界处理最佳实践。
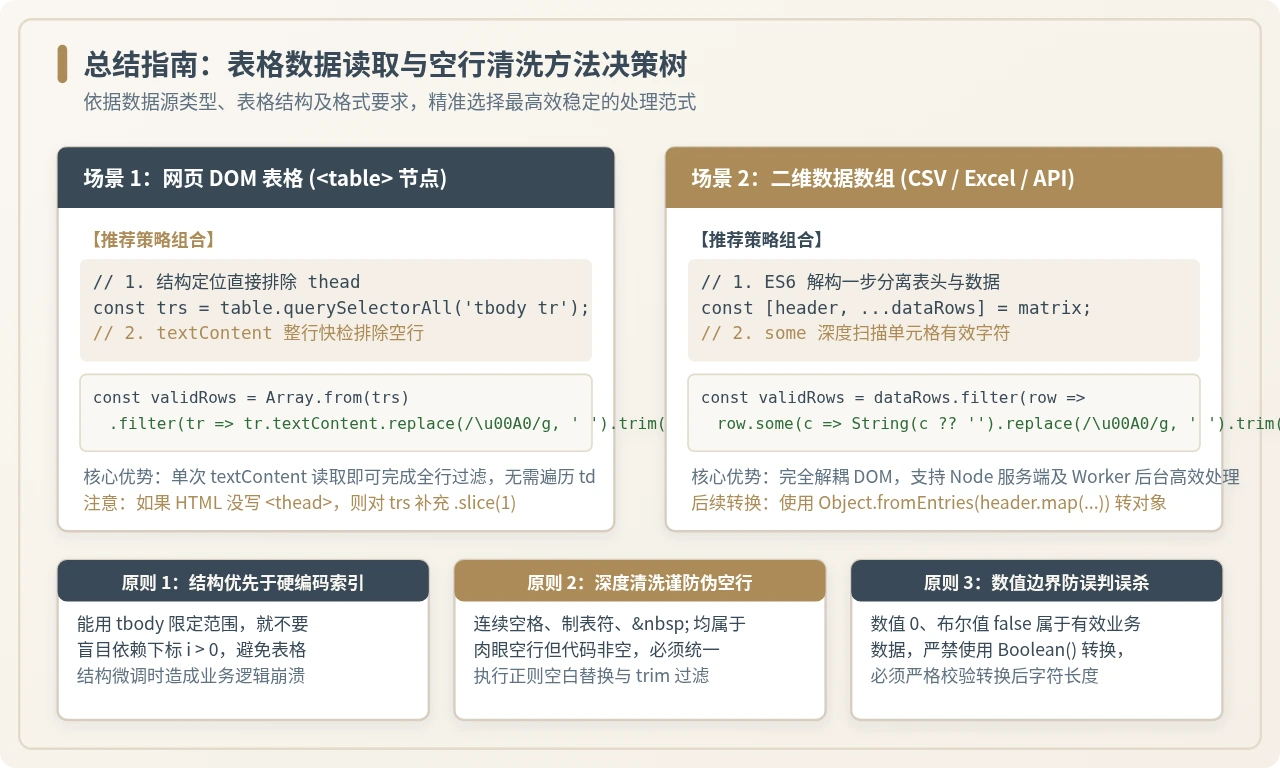
table.querySelectorAll('tbody tr') 锁定数据行,从结构上天然绕过 <thead>;若处理二维数组或 CSV,则使用 slice(1) 或数组解构直接剥离首行。对于空行,绝不能只判断单元格数量,必须将单元格文本转换并去除不换行空格( )等不可见字符后,借助 Array.prototype.some() 确认整行是否包含至少一个有效字符,全为空则直接剔除。
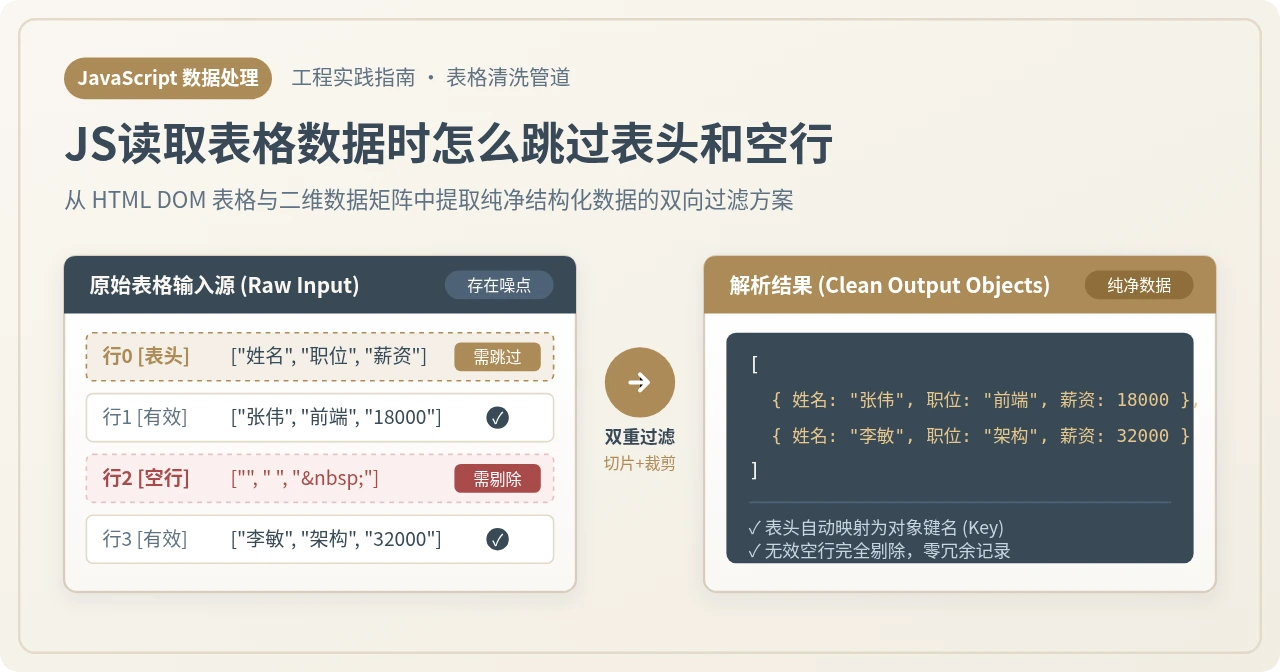
一、为什么常规读取容易混入表头与伪空行
在前端数据导入、网页抓取或报表导出场景中,读取表格通常面临两种数据源:一种是存在于网页文档中的 <table> DOM 节点,另一种则是经由 CSV、Excel(如 SheetJS)解析后存放在内存中的二维数组。
很多开发者在初次实现时,往往习惯直接遍历全部行(例如使用 table.rows 或 for 循环遍历数组)。这种做法极易产生两个典型缺陷:
- 误把表头当成数据对象保存:表格的第一行通常是字段名称(如“姓名”、“手机号”、“部门”),如果直接转换,这行字段名就会被当成一条普通员工记录存入数据库或状态树中。
- 漏网的“伪空行”:在 Excel 录入或 HTML 渲染时,表格末尾或中间经常残留只包含普通空格、制表符、
(不换行空格)甚至空<span>的行。这类行虽然肉眼看起来空无一物,但在 JavaScript 中每个单元格的值都是由空格组成的非空字符串,简单的row.length > 0或Boolean(val)根本无法将其识别为无效行。
因此,一个成熟的表格读取流程,必须把“表头剔除”和“内容深度检验”作为两条正交的逻辑管线来实施。
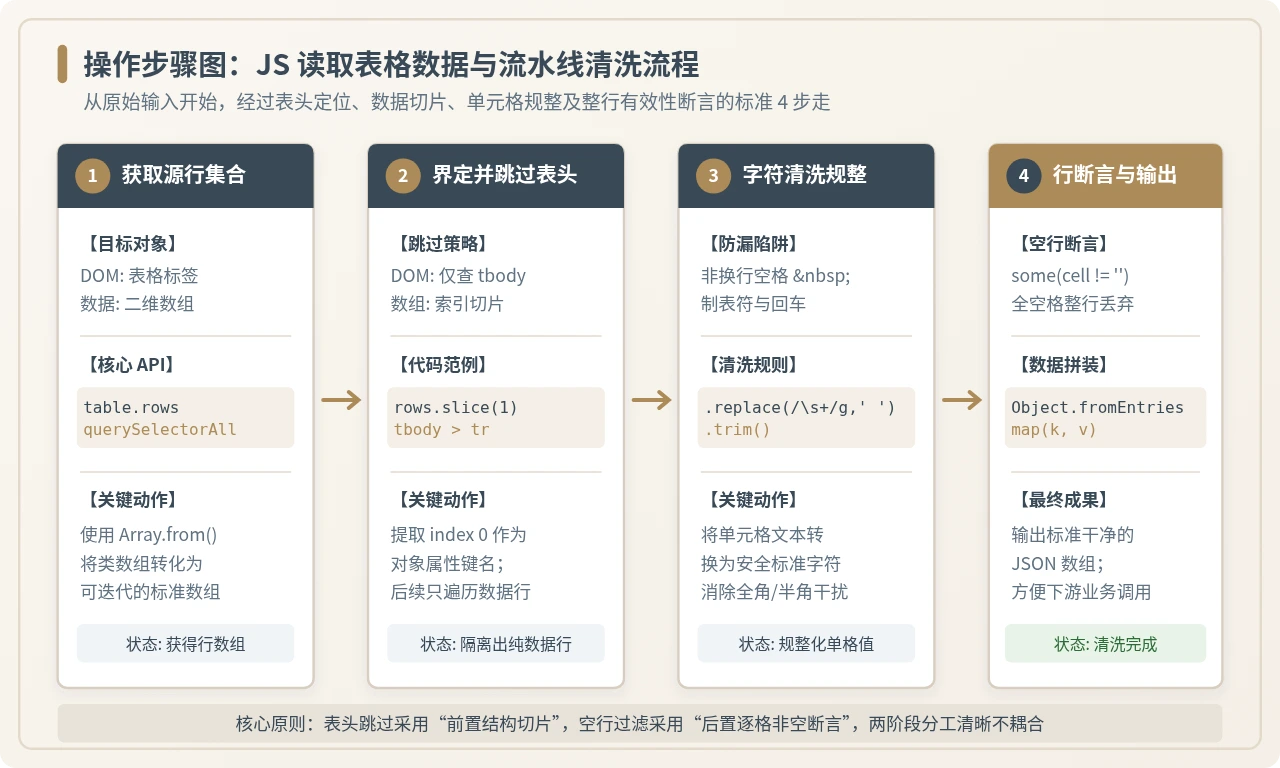
二、场景一:读取网页 HTML DOM 表格
当数据来源于当前页面上的 <table> 元素时,最优雅的跳过表头方案是利用 HTML 语义化标签从 DOM 结构层直接隔离。
1. 推荐方案:使用选择器精准抓取 tbody 行
标准的 HTML 表格结构中,表头通常放置在 <thead> 内部的 <tr> 中,而实际数据则位于 <tbody>。此时,只需通过 CSS 选择器 tbody tr,即可在获取元素集合时天然避开表头,完全省去后续对索引下标的判断。
/**
 * 从 HTMLTableElement 读取有效数据行并转为对象数组
 * @param {HTMLTableElement} table - 目标表格DOM节点
 * @returns {Array<Object>} 清洗后的数据对象列表
 */
function readHtmlTable(table) {
  // 1. 提取表头文本作为对象的键名 (Key)
  const headerCells = table.querySelectorAll('thead th, thead td');
  const headers = Array.from(headerCells).map(th => th.textContent.trim());

  // 兜底:如果 HTML 没有书写 thead,则从第一行 tr 提取表头
  const allRows = Array.from(table.rows);
  const effectiveHeaders = headers.length > 0
    ? headers
    : Array.from(allRows[0]?.cells || []).map(c => c.textContent.trim());

  // 2. 锁定数据行:优先提取 tbody 内的行;若无 tbody,则通过 slice(1) 跳过首行
  const hasThead = table.tHead !== null && headers.length > 0;
  const dataRows = hasThead
    ? Array.from(table.querySelectorAll('tbody tr'))
    : allRows.slice(1);

  // 3. 过滤空行并映射为结构化对象
  return dataRows
    .filter(tr => {
      // 将不换行空格(\u00A0)替换为普通空格,并去除前后空白
      const text = tr.textContent.replace(/\u00A0/g, ' ').trim();
      // 如果整行文本经过 trim 后长度为 0,说明是纯空行,予以过滤
      return text.length > 0;
    })
    .map(tr => {
      const cells = Array.from(tr.cells);
      const rowData = {};
      effectiveHeaders.forEach((key, index) => {
        // 获取单元格文本并清理多余空白
        const cellValue = cells[index]
          ? cells[index].textContent.replace(/\u00A0/g, ' ').trim()
          : '';
        rowData[key || `col_${index}`] = cellValue;
      });
      return rowData;
    });
}tr.textContent.trim() 的效率远高于遍历当前行的每一个 <td>。因为 tr.textContent 会一次性获取所有子节点文本的拼接结果,如果拼接后的字符串经过去噪后为空,即可立即断定整行为空。
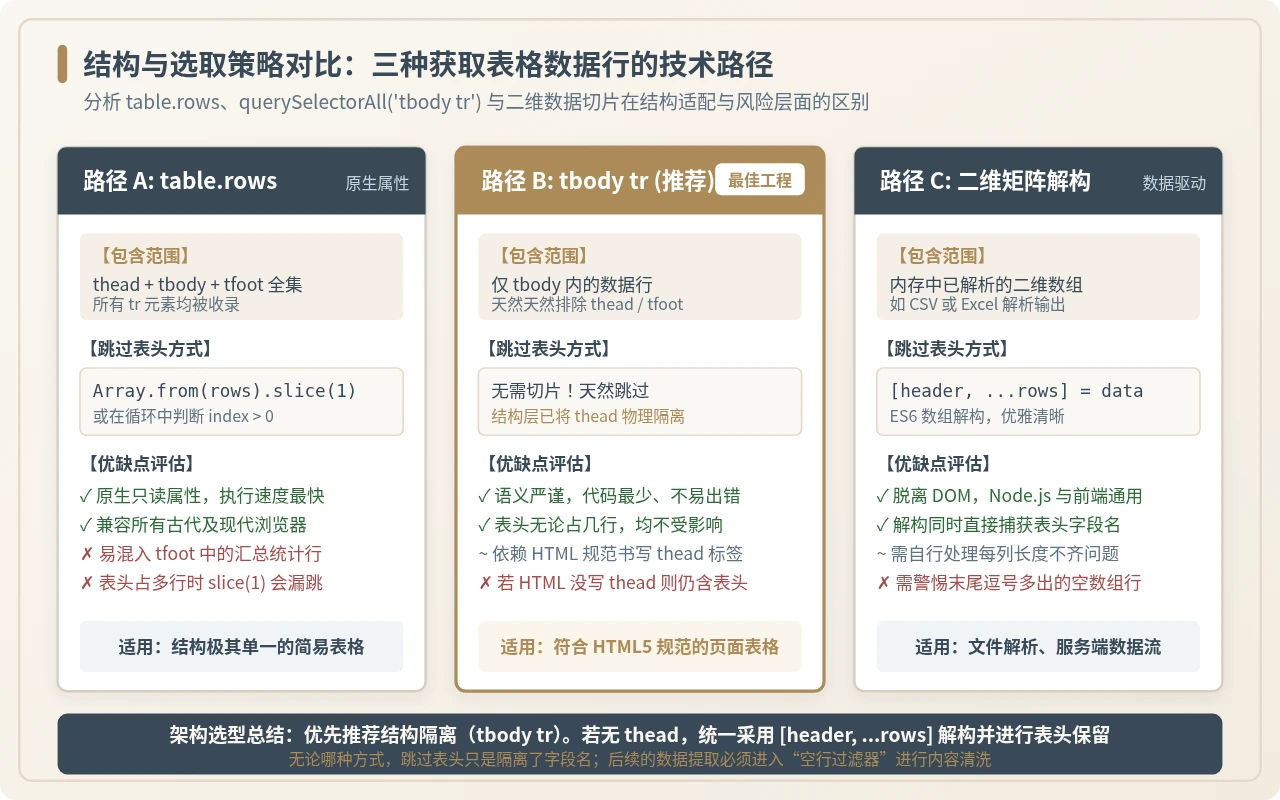
三、场景二:处理二维数组与 CSV/Excel 解析数据
当使用前端库(如 PapaParse 解析 CSV,或 xlsx/SheetJS 读取工作表)时,数据通常以二维数组 Array<Array<any>> 的形态呈现。
1. 跳过表头的标准范式:ES6 数组解构与 slice(1)
在二维数组中,首行即索引为 0 的元素必然是表头数组。推荐使用 ES6 的解构赋值语法,一条语句即可同时完成保存表头键名与剥离数据体两个目标:
// 原始二维数组示例(含表头、正常行与连续空格行)
const rawSheetData = [
  ["姓名", "部门", "考核得分"],          // 索引 0: 表头
  ["张三", "研发部", "95"],              // 索引 1: 有效数据行
  ["", "   ", "\u00A0"],                 // 索引 2: 伪空行(空格与不可见字符)
  ["李四", "运营部", "88"],              // 索引 3: 有效数据行
  [],                                    // 索引 4: 物理空数组
  ["", "", ""]                           // 索引 5: 空字符串行
];

// 1. 利用数组解构同时获取表头与待处理行
const [headerRow, ...dataRows] = rawSheetData;

console.log(headerRow); // ["姓名", "部门", "考核得分"]
console.log(dataRows.length); // 5 (已剥离表头)
2. 深度过滤空行:借助 some() 进行全格非空判定
面对二维数组,很多同学会尝试写出 dataRows.filter(row => row.length > 0),但这只能过滤掉上述示例中第 4 行的物理空数组 [],而对于第 2 行和第 5 行这种内部全为空字符串的数组毫无拦截效果。
正确的断言逻辑是:一行数据只有当它“至少存在一个单元格包含有效字符”时,才是合法数据行。在 JavaScript 中,这正是 Array.prototype.some() 的最佳舞台:
/**
 * 清洗二维数组数据并生成干净的对象数组
 * @param {Array<Array<any>>} matrix - 包含表头的二维数据矩阵
 * @returns {Array<Object>}
 */
function cleanMatrixData(matrix) {
  if (!Array.isArray(matrix) || matrix.length === 0) return [];

  // 1. 跳过并解构表头
  const [rawHeaders, ...rawRows] = matrix;
  const headers = rawHeaders.map(h => String(h ?? '').trim());

  // 2. 核心过滤器:跳过所有可见与隐性空行
  const cleanRows = rawRows.filter(row => {
    // 物理空数组直接排除
    if (!Array.isArray(row) || row.length === 0) return false;

    // 只要有任意一个单元格包含非空白内容,则保留该行
    return row.some(cell => {
      // 避免 null 或 undefined 报错,统一转字符串
      const str = String(cell ?? '')
        .replace(/\u00A0/g, ' ') // 替换非换行空格
        .trim();
      return str.length > 0;
    });
  });

  // 3. 映射为对象数组
  return cleanRows.map(row => {
    const item = {};
    headers.forEach((key, index) => {
      const rawValue = row[index];
      // 清洗每个单元格两端的不可见空白
      item[key || `field_${index}`] = typeof rawValue === 'string'
        ? rawValue.replace(/\u00A0/g, ' ').trim()
        : (rawValue ?? '');
    });
    return item;
  });
}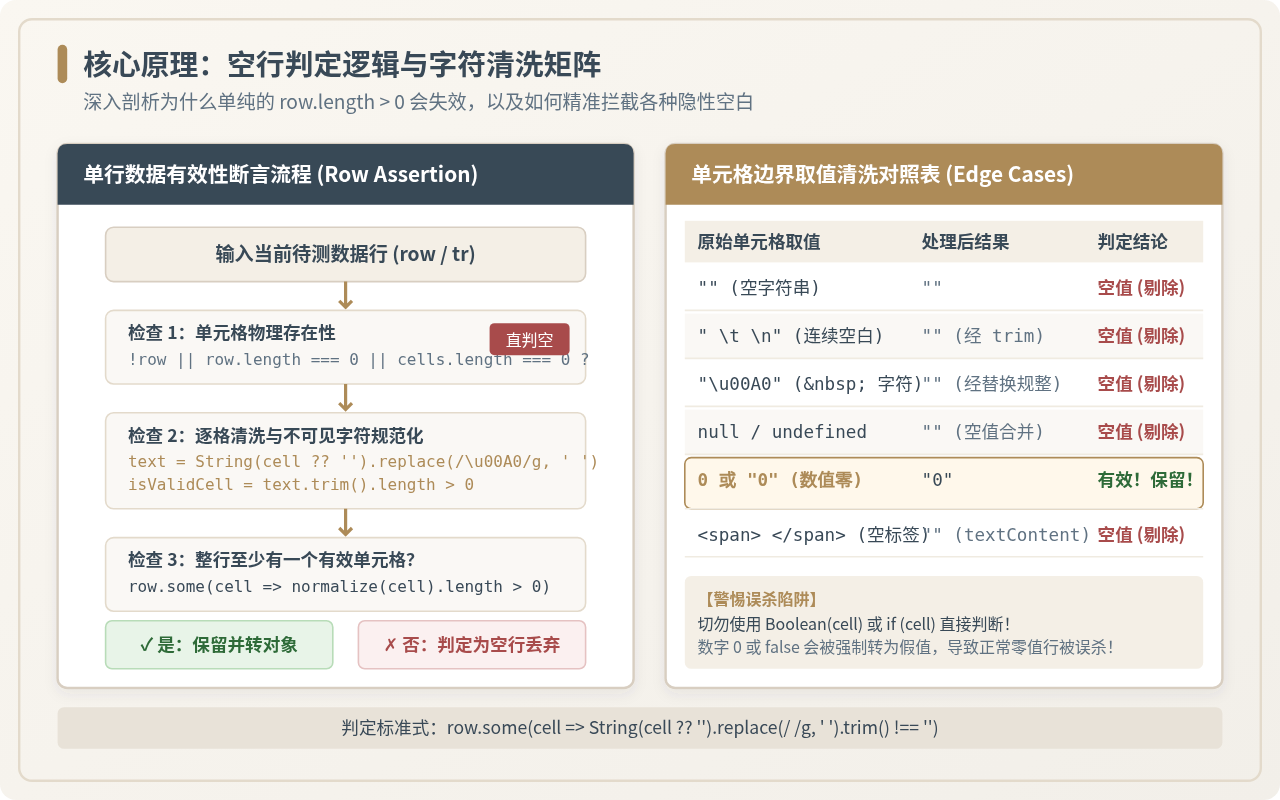
四、避坑指南:识别空行时的隐藏陷阱
在实际项目运维中,空行过滤看似简单,但如果不了解底层字符编码与数据类型,极易踩入以下三个高频暗坑:
1. “不换行空格”( 即 ) 的穿透
在网页中,富文本编辑器或网页排版经常使用 占位。当通过 textContent 读取时,它被转换为 Unicode 编码为 (Non-breaking space)的字符。在某些旧运行环境或严格正则中,普通的 \s 可能无法完全覆盖它。
稳妥做法:在执行 .trim() 之前,先行调用 .replace(/ /g, ' ') 将其归一化为标准的 ASCII 空格( ),然后再做去除。
2. 数字 0 与布尔值 false 的误杀
row.some(cell => Boolean(cell)) 或 row.some(Boolean)。这种写法在遇到数值时是灾难性的!
在财务报表或绩效表格中,单元格的值常常是数字 0(例如“欠款金额:0”、“缺勤天数:0”)。在 JavaScript 中,Boolean(0) 和 Boolean("") 都会计算为 false。如果一行记录中的所有数值列刚好全是 0,这种简写会直接把正常的业务数据当作空行暴力删除!
正确原则:始终通过 String(cell ?? '').trim().length > 0 或 cell !== '' && cell !== null && cell !== undefined 来断言,确保字符长度是唯一的判定标准。
3. 合并单元格(rowspan / colspan)产生的伪空行
当 HTML 表格存在纵向合并单元格 rowspan="2" 时,被合并的第二行在 DOM 结构中实际上缺少该列的 td 元素。如果不加判断直接按表头下标 row[index] 访问,后面的单元格就会发生错位,甚至导致整行被误判。对于合并单元格表格,建议在读取前建立坐标填充矩阵,或在业务层优先规范录入格式。
五、工程整合:开箱即用的通用表格解析函数
综合以上所有场景与防护边界,我们可以封装一个高兼容性的通用函数 extractTableData。它能够自动识别传入的目标是 HTML DOM 节点还是纯数据矩阵,并支持自定义跳过表头行数与空行过滤配置:
/**
 * 通用表格数据提取与清洗引擎
 * @param {HTMLTableElement | Array<Array<any>>} source - 表格DOM元素或二维数组
 * @param {Object} [options] - 配置参数
 * @param {number} [options.headerRows=1] - 表头所占行数,默认 1 行
 * @param {boolean} [options.skipEmptyRows=true] - 是否自动丢弃纯空行
 * @returns {Array<Object>} 最终清洗后的实体数组
 */
function extractTableData(source, options = {}) {
  const { headerRows = 1, skipEmptyRows = true } = options;
  let rawMatrix = [];

  // 1. 统一数据源:将 DOM 表格转化为二维字符矩阵
  if (typeof HTMLTableElement !== 'undefined' && source instanceof HTMLTableElement) {
    const allTrs = Array.from(source.rows);
    rawMatrix = allTrs.map(tr =>
      Array.from(tr.cells).map(cell => cell.textContent)
    );
  } else if (Array.isArray(source)) {
    rawMatrix = source;
  } else {
    throw new TypeError("extractTableData: source 必须是 HTMLTableElement 或二维数组");
  }

  if (rawMatrix.length <= headerRows) return [];

  // 2. 清洗辅助器:字符规范化
  const cleanStr = val => String(val ?? '').replace(/\u00A0/g, ' ').trim();

  // 3. 提取表头键名 (以表头最后一行为主键,或多行组合)
  const headerMatrix = rawMatrix.slice(0, headerRows);
  const keys = headerMatrix[headerRows - 1].map((key, i) => cleanStr(key) || `col_${i + 1}`);

  // 4. 切片剥离表头,获取纯数据行
  const candidateRows = rawMatrix.slice(headerRows);

  // 5. 管道化过滤与装配
  return candidateRows
    .filter(row => {
      if (!skipEmptyRows) return true;
      if (!Array.isArray(row) || row.length === 0) return false;
      // 只要有一个单元格清洗后长度大于 0,即保留
      return row.some(cell => cleanStr(cell).length > 0);
    })
    .map(row => {
      const record = {};
      keys.forEach((key, idx) => {
        record[key] = cleanStr(row[idx]);
      });
      return record;
    });
}
六、总结
在 JavaScript 中处理表格数据时,跳过表头与空行不应依赖松散的下标猜测,而应遵循明确的工程范式:
- 跳过表头:优先依赖结构(如
tbody tr);当结构不可用或面对数组时,统一使用slice(1)或 ES6 数组解构将表头与数据体分离,同时提取首行作为对象属性名。 - 跳过空行:摒弃简单的长度检查,必须经过“空值合并
?? ''”、“不可见字符替换trim()”三重规整后,使用some()保证整行存在有效文本。同时必须保留数值0等合法假值。
遵循这两层严密的清洗机制,即可确保读取到的数据具备完全的结构一致性,为后续的业务流转提供坚实可靠的数据质量基础。
Qwen Code TypeScript SDK v0.1.35 正式发布后,npm 能安装吗?
2026-11-17 20:22:21
JS怎么使用for循环遍历字符串字符
2026-11-17 19:45:10
JS封装健壮的首字母大写工具函数
2026-11-17 19:41:21
JS获取当前月份数值:为什么getMonth()需要加1
2026-11-17 19:11:50
怎么处理JavaScript Date对象的时区偏差与浏览器兼容性
2026-11-17 19:11:42







