

JS封装健壮的首字母大写工具函数
深入解析如何在JavaScript中封装一个健壮、生产可用的首字母大写工具函数,涵盖类型防御、UTF-16代理对处理、Intl字素拆分与国际化区域大写规则。
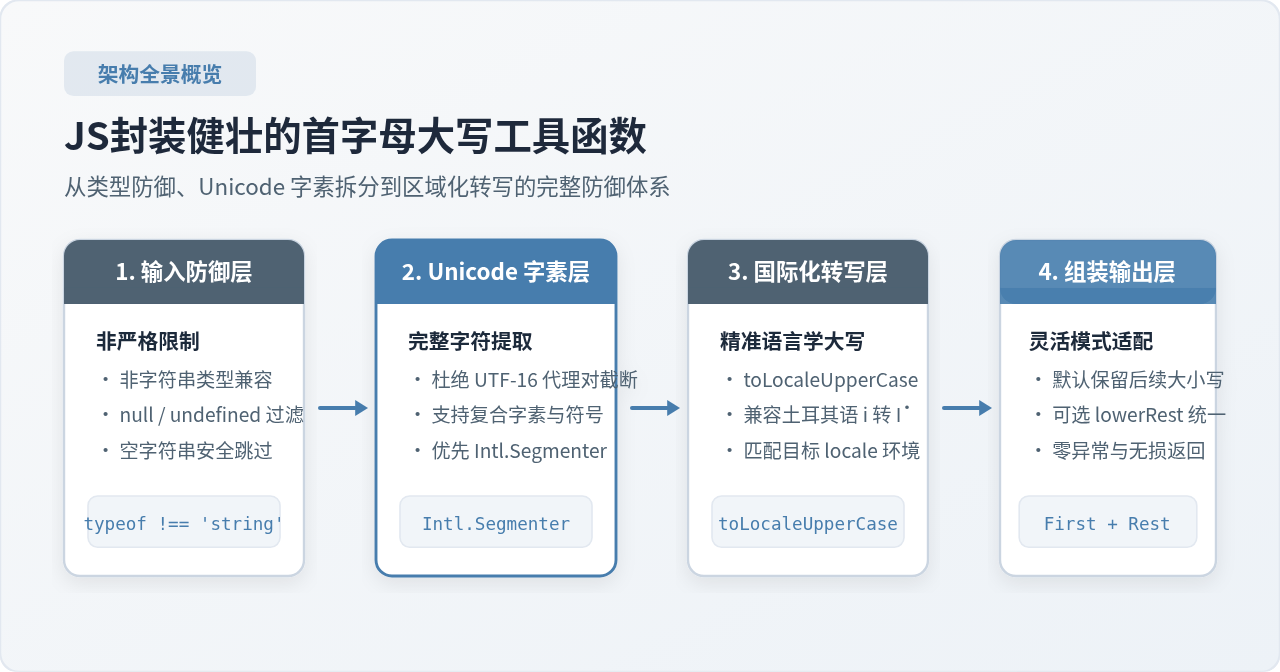
为什么常规的首字母大写写法不够健壮
很多开发者在日常编写代码时,习惯性写出如下所示的经典单行函数:
// 常见的简易实现方式
function capitalize(str) {
  return str[0].toUpperCase() + str.slice(1);
}
这种写法在测试数据完全为标准英文字符串(如 "hello")时运行良好,但在真实的工程化项目中,数据往往来自用户输入、多语言配置或第三方接口,此时简易写法会暴露出三个致命缺陷:
- 类型弱防御与空值崩溃:当入参为
null、undefined时,访问str[0]会直接抛出无法恢复的TypeError: Cannot read properties of undefined。若入参为非字符串类型(如数字、数组或布尔值),也会因缺乏.slice()方法而产生运行时中断。 - Unicode 代理对截断导致乱码:JavaScript 字符串内部基于 UTF-16 编码单元存储。基本多文种平面(BMP)外的字符(例如部分数学字母符号、生僻汉字、特殊表情符)占用两个 16 位码元(代理对)。使用下标
str[0]只截取到了高位代理,拼接str.slice(1)就会导致编码结构断裂,产生类似U+D835的破损乱码。 - 区域语言学大小写失效:标准的
toUpperCase()采用默认 Unicode 大小写映射,无法满足特定语言的拼写规范。例如在土耳其语(Turkish)和阿塞拜疆语中,小写字母i转为大写必须是带点号的İ(U+0130),若转为无点号的I则改变了词汇本身的语义。
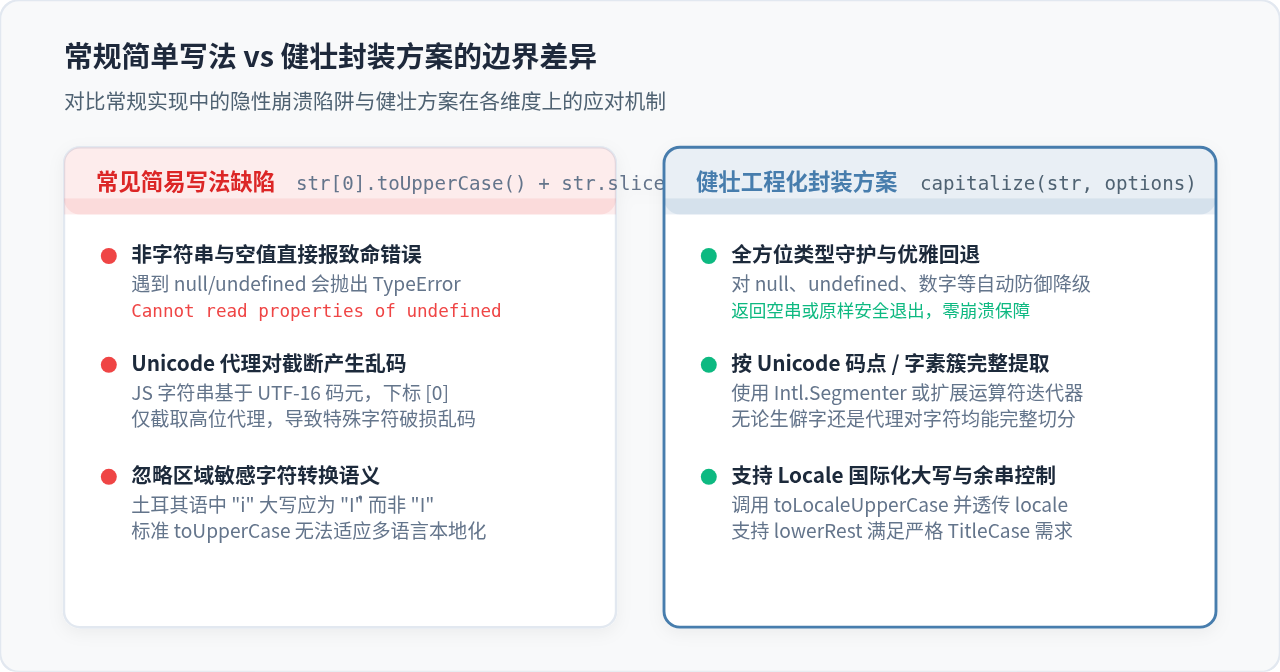
拆解构建健壮函数的关键步骤
要构建一个能够抵御所有边界异常的工具函数,必须按照由外及内的执行流水线进行模块化设计。每个阶段承担特定的校验与转换任务。
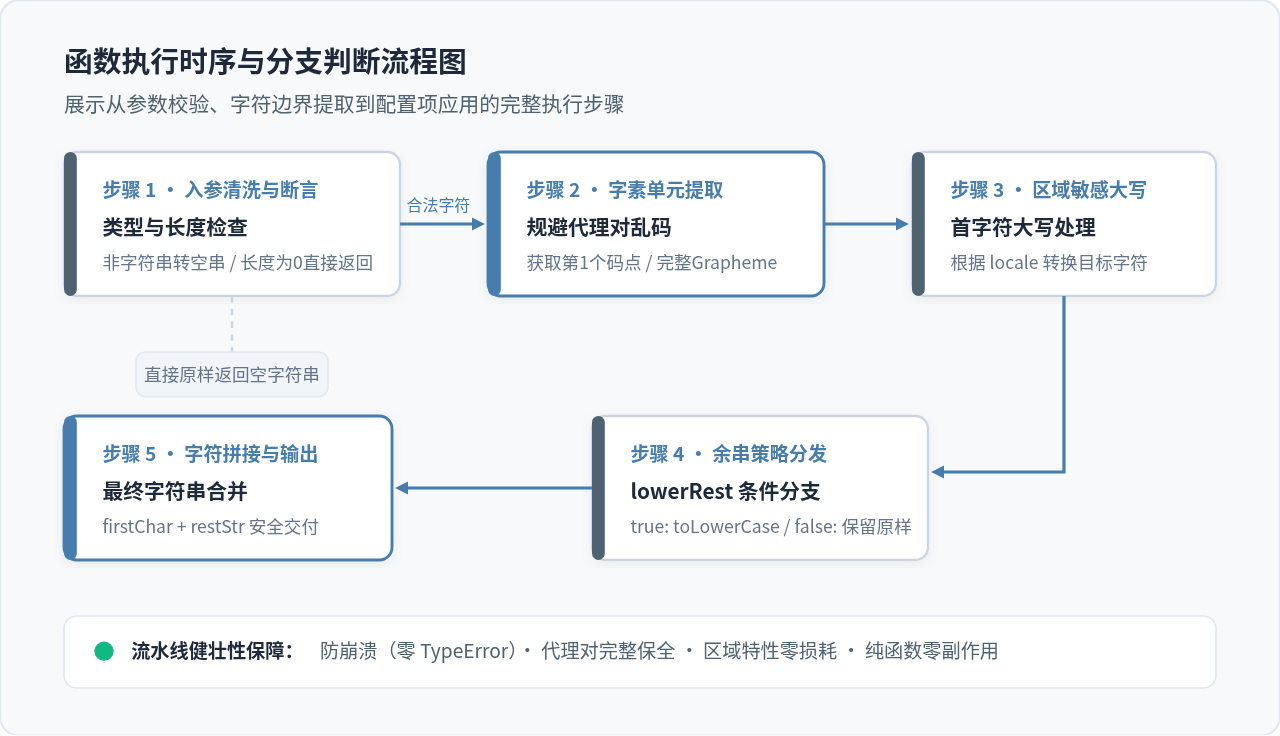
第 1 步:类型守护与短路优化
工具函数的第一道防线是保障调用绝对安全,无论外部传入何种参数,都不应当引发进程或组件树崩溃。对于非法入参,推荐遵循“优雅降级”原则:非字符串类型统一返回空字符串;空字符串则直接短路返回,避免执行后续冗余计算。
第 2 步:支持多码元的字符拆分
为了正确提取第一个“人类视觉意义上的字符”,不能依赖简单的索引访问 [0]。在现代 JavaScript 环境中,有以下两种安全提取方案:
- 迭代器解构(ES6+):字符串原生实现的迭代器按照 Unicode 码点(Code Point)遍历,通过
[...str]或Array.from(str)可以将高低代理对合并为一个独立的字符单元。 - 国际化字素分割器(Intl.Segmenter):对于包含结合符或更复杂的字素簇(Grapheme Cluster),现代浏览器的
Intl.Segmenter能实现标准语言学意义上的分词截取。在通用的工具函数中,扩展运算符已能覆盖绝大部分高码位字符。
第 3 步:区域敏感的大小写转换
调用 toLocaleUpperCase([locales]) 替代默认的 toUpperCase()。通过允许调用方显式传入 locale 参数,既能满足全球化国际化项目的排版准确性,又能在未传参时自动沿用当前执行环境的默认语言。
第 4 步:余串处理策略(lowerRest)
在设计 API 时,需要明确区分“仅改变首字母”与“严格首字母大写(Capitalize/TitleCase)”的区别。例如对于输入 "iPhone":
- 若保持其余字符原有大小写(默认行为),结果为
"IPhone",适合保留专有名词与缩写; - 若要求全词规范化,将后续字符强制转为小写(
lowerRest: true),结果为"Iphone"。通过配置项赋予调用方自主权。
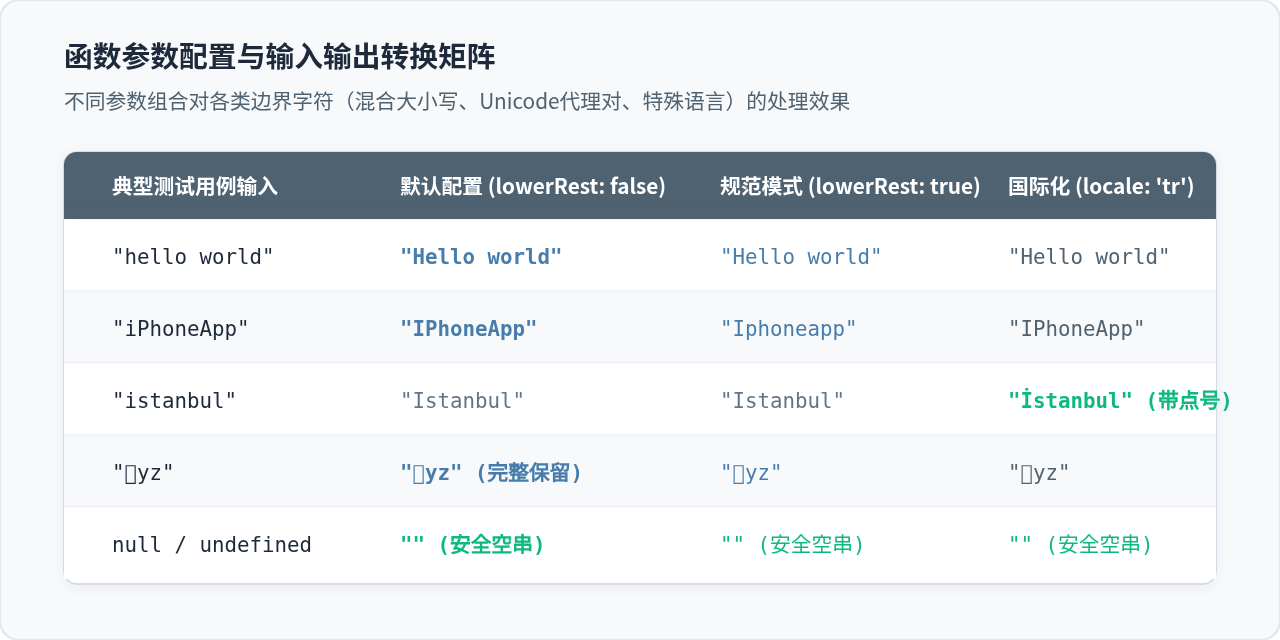
完整实现代码与使用范例
结合上述设计要求,下面给出兼具兼容性、高性能与健壮性的完整实现:
/**
 * 健壮的首字母大写工具函数
 * @param {unknown} input - 待处理的输入值
 * @param {Object} [options] - 配置选项
 * @param {boolean} [options.lowerRest=false] - 是否将除首字符外的其余字符强制转为小写
 * @param {string|string[]} [options.locale] - BCP 47 语言区域代码,如 'tr-TR'
 * @returns {string} 转换后的字符串
 */
function capitalize(input, options = {}) {
  // 1. 类型守护:非字符串或空值安全回退
  if (typeof input !== 'string') {
    return '';
  }

  // 2. 空字符串短路返回
  if (input.length === 0) {
    return '';
  }

  const { lowerRest = false, locale } = options;

  // 3. 利用字符串迭代器完整提取 Unicode 码点字符
  // 支持代理对字符(如数学斜体字母、Emoji等)完整保全
  const chars = [...input];
  const firstChar = chars[0];
  const restChars = chars.slice(1).join('');

  // 4. 区域敏感的首字母大写转换
  const upperFirst = locale !== undefined
    ? firstChar.toLocaleUpperCase(locale)
    : firstChar.toLocaleUpperCase();

  // 5. 根据 lowerRest 选项处理余下字符并拼接输出
  const processedRest = lowerRest
    ? (locale !== undefined ? restChars.toLocaleLowerCase(locale) : restChars.toLocaleLowerCase())
    : restChars;

  return upperFirst + processedRest;
}注意:该函数内部使用 [...input] 进行码点解构,能够完整保留所有的辅助平面字符。对于性能极度敏感的高频循环调用,若确认输入只为标准 ASCII 文本,可额外增加 ASCII 快速路径判断。
常见场景调用示例
// 基础常规场景
console.log(capitalize('hello')); // 输出: "Hello"
console.log(capitalize('world cup')); // 输出: "World cup"

// 异常类型防御
console.log(capitalize(null)); // 输出: "" (安全返回,不报错)
console.log(capitalize(undefined)); // 输出: ""
console.log(capitalize(12345)); // 输出: ""

// 混合大小写与 lowerRest 参数
console.log(capitalize('iPhone')); // 默认保持后续大小写: "IPhone"
console.log(capitalize('iPhone', { lowerRest: true })); // 规范化小写: "Iphone"

// 国际化区域支持(土耳其语 i 转换)
console.log(capitalize('istanbul')); // 默认环境输出: "Istanbul"
console.log(capitalize('istanbul', { locale: 'tr-TR' })); // 区域感知输出: "İstanbul" (首字母为带有上标点的 İ)

// Unicode 代理对字符
console.log(capitalize('𝒳yz')); // 输出: "𝒳yz" (首字符完整提取,无断裂乱码)
工程化落地与核查总结
封装一个基础工具函数往往最能体现代码库的工程成熟度。在实际项目中,基础字符串处理库被广泛用于数据展示层、表单回显、日志输出和国际化文案渲染中,任何隐蔽的崩溃点都会被上层调用无限放大。
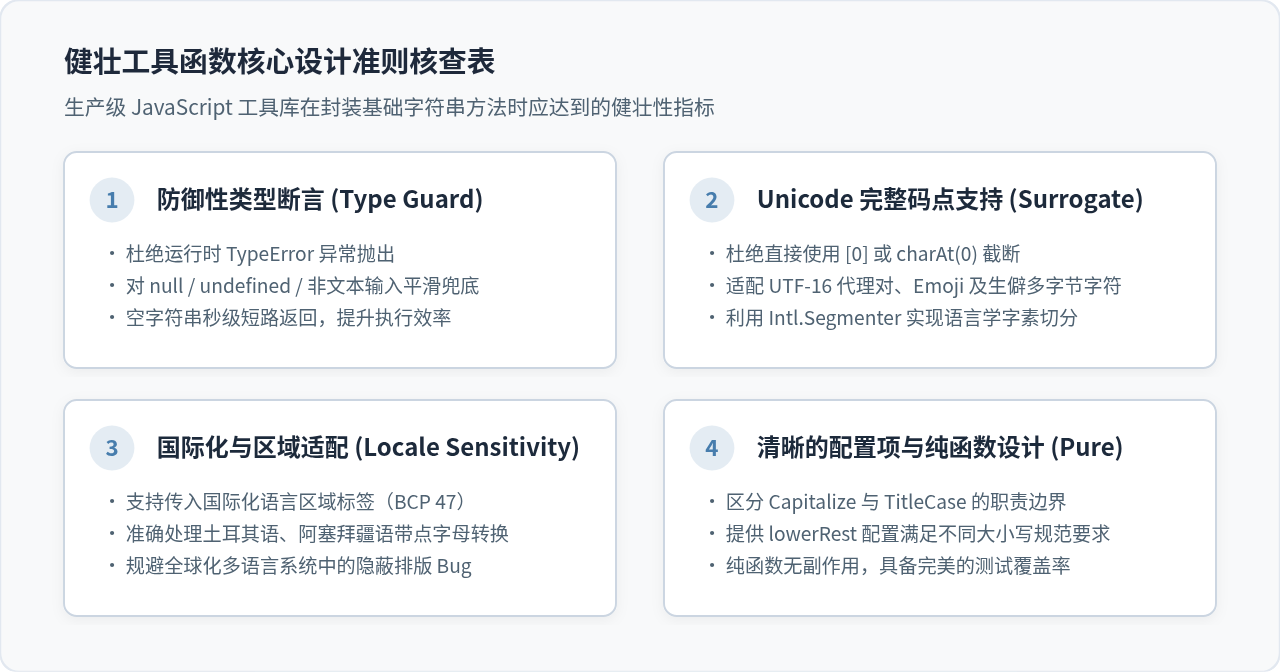
通过类型前置拦截、Unicode 码点完整解构、区域语言学感知以及合理的配置项默认值,我们既解决了原生 str[0] 写法的脆弱性,又保持了纯函数的轻量与高性能,为项目提供了真正值得信赖的底层能力。
JS怎么使用for循环遍历字符串字符
2026-11-17 19:45:10
JS获取当前月份数值:为什么getMonth()需要加1
2026-11-17 19:11:50
怎么处理JavaScript Date对象的时区偏差与浏览器兼容性
2026-11-17 19:11:42
JavaScript中定义数组的两种基本语法:字面量与构造函数
2026-11-17 18:55:48
JavaScript阻止表单默认提交并Ajax异步发送
2026-11-17 11:29:37







