

JS怎么使用for循环遍历字符串字符
深入讲解在JavaScript中使用for循环遍历字符串字符的实现方式,涵盖经典索引for循环、现代for...of循环、底层UTF-16编码机制与规避Emoji截断乱码的最佳实践。
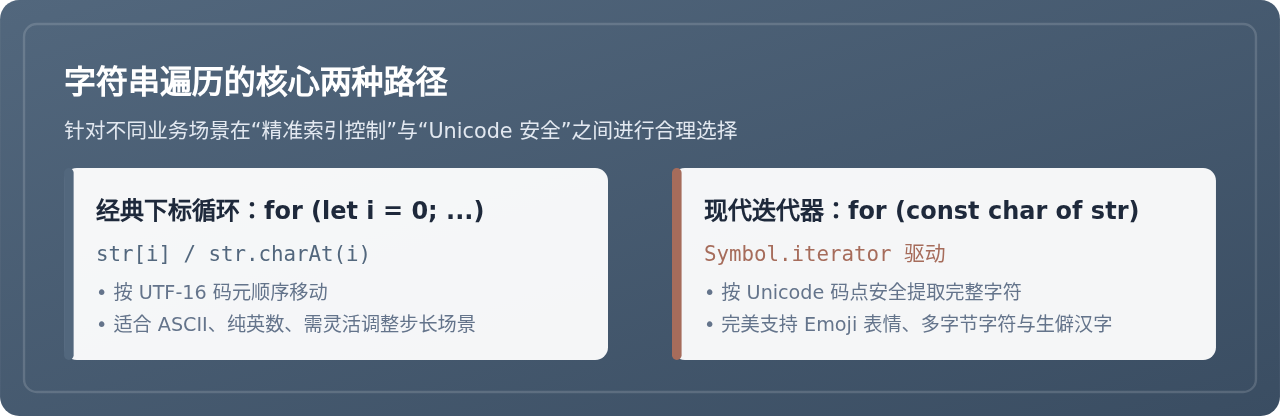
在 JavaScript 中,遍历字符串字符主要有两种核心方式:一种是借助字符串的 length 属性与数值下标的经典计数器 for 循环,另一种是 ES6 引入的原生迭代器 for...of 循环。前者适合需要获取下标索引或跳跃步长的场景,而后者则是日常业务中处理多国语言及表情符号(Emoji)的最安全首选。
一、经典计数器 for 循环(下标索引法)
这是 JavaScript 中最基础、兼容性最广的遍历方式。字符串在 JavaScript 中属于类数组结构(Array-like),每个字符都可以通过从 0 开始的整数下标进行访问。
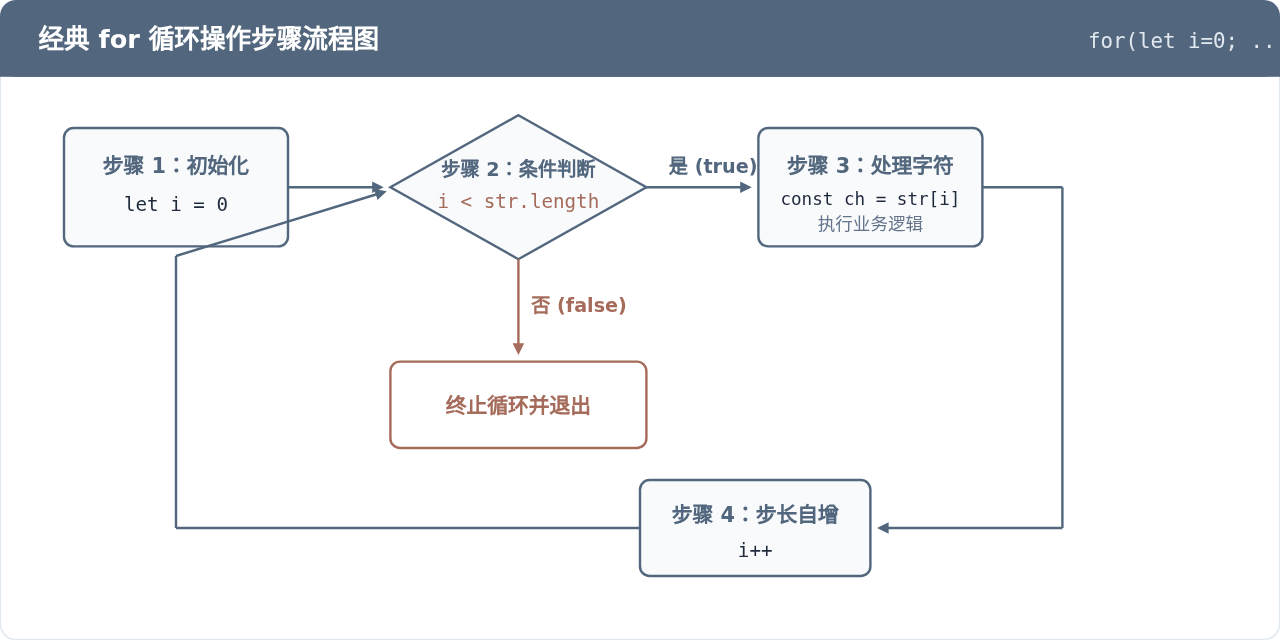
构建经典 for 循环只需三个关键要素:定义初始索引变量(let i = 0)、循环终止条件(i < str.length),以及每轮执行后的自增步长(i++)。在循环体内部,读取对应字符通常有两种写法:使用中括号属性访问器 str[i],或者调用原生方法 str.charAt(i)。
const text = "Hello JS";

for (let i = 0; i < text.length; i++) {
  const char = text[i];
  console.log(`索引 [${i}]: ${char}`);
}
索引 [1]: e
索引 [2]: l
索引 [3]: l
索引 [4]: o
索引 [5]:
索引 [6]: J
索引 [7]: S
str[i] 与 str.charAt(i) 的细微差别
在遍历中,这两种取值方式在绝大多数情况下表现一致,但在索引越界(例如访问小于 0 或大于等于 length 的位置)时存在差异:
str[i]在越界时会返回undefined,行为与常规数组取值保持统一。str.charAt(i)在越界时会返回空字符串"",是早期的标准 API。
在现代前端工程中,推荐直接使用更为简洁直观的 str[i]。如果需要提前终止循环或跳过某些字符,可以自由结合 break 与 continue 语句使用。
二、深入底层原理:UTF-16 编码与字符截断陷阱
如果仅处理纯英文字母(ASCII),经典 for 循环看起来无懈可击。然而在涉及中文生僻字或 Emoji 表情符号时,经典 for 循环往往会引发严重的 Bug。
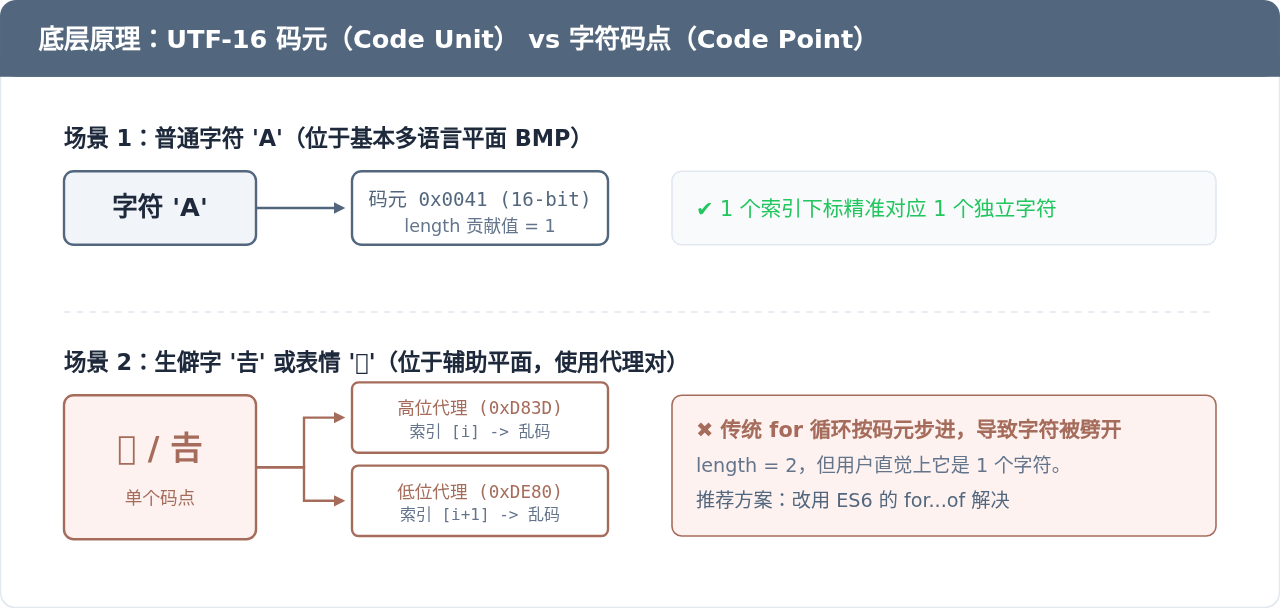
JavaScript 内部的字符串是由 16 位代码单元(Code Units,即 UTF-16 编码)组成的序列。
对于编码在 U+0000 到 U+FFFF 之间的基本多语言平面字符(如常见的英文、数字以及绝大部分常用汉字),一个字符刚好占用 1 个 16 位码元,因此 str.length 精确等于字符个数。
但是,超出该范围的辅助平面字符(例如生僻汉字“𠮷”或 Emoji 表情“🚀”)在 UTF-16 中必须使用一对 16 位码元表示,这种机制被称为代理对(Surrogate Pair)。此时,单个视觉字符的 length 会变成 2!
观察以下代码,当我们使用经典 str[i] 遍历包含表情符号的字符串时:
const str = "Hi🚀";
console.log("字符串长度:", str.length); // 输出 4,而不是 3!

for (let i = 0; i < str.length; i++) {
  console.log(`第 ${i} 次循环输出:`, str[i]);
}第 0 次循环输出: H
第 1 次循环输出: i
第 2 次循环输出: (高位代理,孤立乱码)
第 3 次循环输出: (低位代理,孤立乱码)
在上述输出中,火箭表情 🚀 被强行拆解成了两个无法独立显示的孤立代理字符(乱码问号)。如果程序将这些拆散的字符拼接或存库,会导致数据损坏甚至界面乱码。
三、现代 ES6 的 for...of 循环(Unicode 安全推荐)
为了彻底解决多字节字符被截断的问题,ECMAScript 2015 (ES6) 为字符串内置了迭代器协议(String.prototype[Symbol.iterator])。
使用 for...of 循环遍历字符串时,JavaScript 引擎会在底层按照 Unicode 码点(Code Point)进行寻址。如果遇到 UTF-16 的高低位代理对,迭代器会自动将其组装为一个完整的独立字符输出。
const greeting = "Hello! 🚀 欢迎";

for (const char of greeting) {
  console.log("字符:", char);
}
字符: e
字符: l
字符: l
字符: o
字符: !
字符:
字符: 🚀 (完美识别完整表情符号,无乱码)
字符:
字符: 欢
字符: 迎
在 for...of 中同时获取字符和序号
许多开发者坚持使用经典 for 循环的原因在于“需要知道当前字符的序号”。其实在 for...of 中完全可以兼顾这一需求。
方法 1:外部计数器(推荐,零内存额外分配)
const text = "A🚀B";
let index = 0;

for (const char of text) {
  console.log(`第 ${index} 个真实字符是: ${char}`);
  index++;
}
方法 2:结合扩展运算符与 entries()
const text = "A🚀B";

for (const [index, char] of [...text].entries()) {
  console.log(`序号: ${index}, 字符: ${char}`);
}
这种写法极为优美,不过请注意:[...text] 会在内存中创建一个临时字符数组,如果遍历数兆字节级别的超大文本,建议优先采用方法 1 的外部计数器以节省内存。
四、为什么不建议使用 for...in 循环遍历字符串
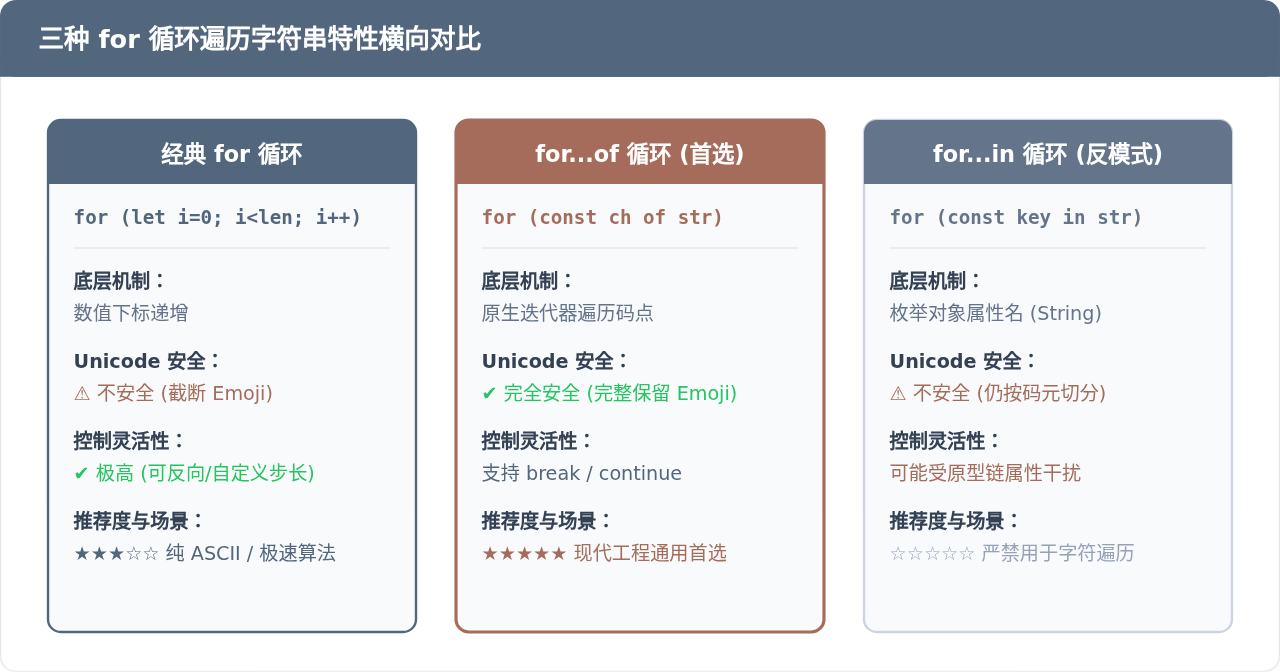
初学者容易混淆 for...in 与 for...of。必须明确指出:在任何情况下,都不应当使用 for...in 来遍历字符串字符。原因包括:
- 键名类型是字符串而非数值:
for...in循环变量获取到的是属性名字符串"0"、"1"、"2",而非数字0, 1, 2。如果拿它进行数值加减(如index + 1),会变成字符串拼接("01"),极易埋下计算隐患。 - 原型链污染风险:如果第三方库或项目代码在
String.prototype或Object.prototype上扩展了自定义方法,for...in也会将这些额外属性名称遍历出来。 - 顺序没有完全保障:虽然现代浏览器对整数索引属性有一定排序优化,但规范并未像
for...of那样严格保证按照字符流顺序遍历。
五、综合场景选型决策与最佳实践总结
在实际业务开发中,选择哪种方式取决于字符集来源、执行性能以及控制流的复杂度:
- 用户输入 / 国际化多语言文本:毫不犹豫选择
for...of。现代用户昵称、评论及国际化内容几乎必然含有表情包或生僻文字,使用for...of能够避免截断导致的不可逆乱码。 - 纯 ASCII 文本 / 紧密算法(如 Base64 编码、编译词法分析):如果能够确保输入字符均小于
0xFFFF,且需要反向遍历(如for (let i = len - 1; i >= 0; i--))或每次跳跃 2 个字节,经典for(i)循环更加直接高效。 - 需要立即中断循环:与
Array.prototype.forEach或map无法轻松 break 不同,for和for...of均支持通过break立即跳出循环,避免不必要的后续开销。
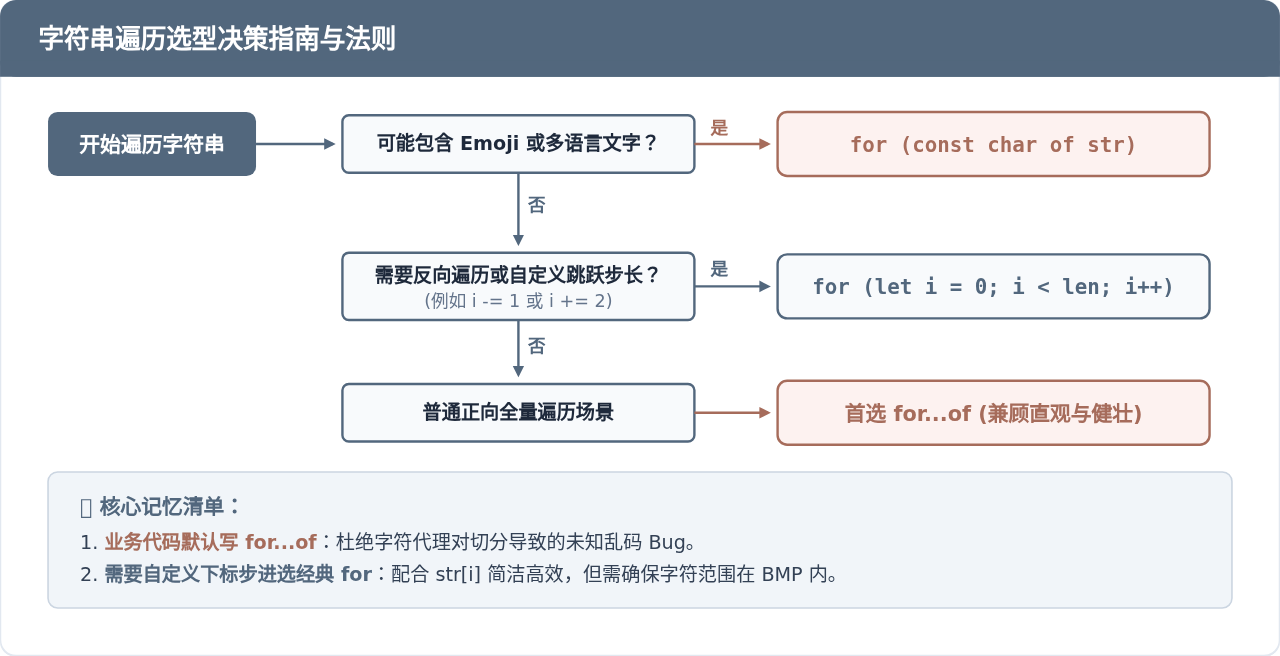
总结来说,如果你的场景是面对用户真实输入、API 返回的自然语言文本,请统一优先使用 for (const char of str);而在需要复杂步长计算、逆向检索或极高吞吐的算法内部,再选用经典 for (let i = 0; i < str.length; i++)。严格避开 for...in,即可在 JavaScript 字符串处理中兼顾安全性与运行效率。
JS封装健壮的首字母大写工具函数
2026-11-17 19:41:21
JS获取当前月份数值:为什么getMonth()需要加1
2026-11-17 19:11:50
怎么处理JavaScript Date对象的时区偏差与浏览器兼容性
2026-11-17 19:11:42
JavaScript中定义数组的两种基本语法:字面量与构造函数
2026-11-17 18:55:48
JavaScript阻止表单默认提交并Ajax异步发送
2026-11-17 11:29:37







