处理大规模树数据时JS遍历的性能优化策略
深入解析在JavaScript中处理数万至百万级大规模树数据时,遍历面临的调用栈溢出与主线程阻塞瓶颈。通过显式栈迭代、双指针队列、惰性生成器、时间分片调度以及Web Worker等工程化策略,实现高性能、零卡顿的树结构处理。
一、大规模树遍历的核心性能瓶颈
在企业级管理系统(如复杂组织架构树、物料清单BOM、权限规则树)或者低代码画布的节点树渲染中,树节点数量常常在数万到数十万不等。许多在几十个节点下运行良好的代码,在数据规模放大后会迅速暴露崩溃风险。这主要源于JavaScript运行时的两个底层限制:
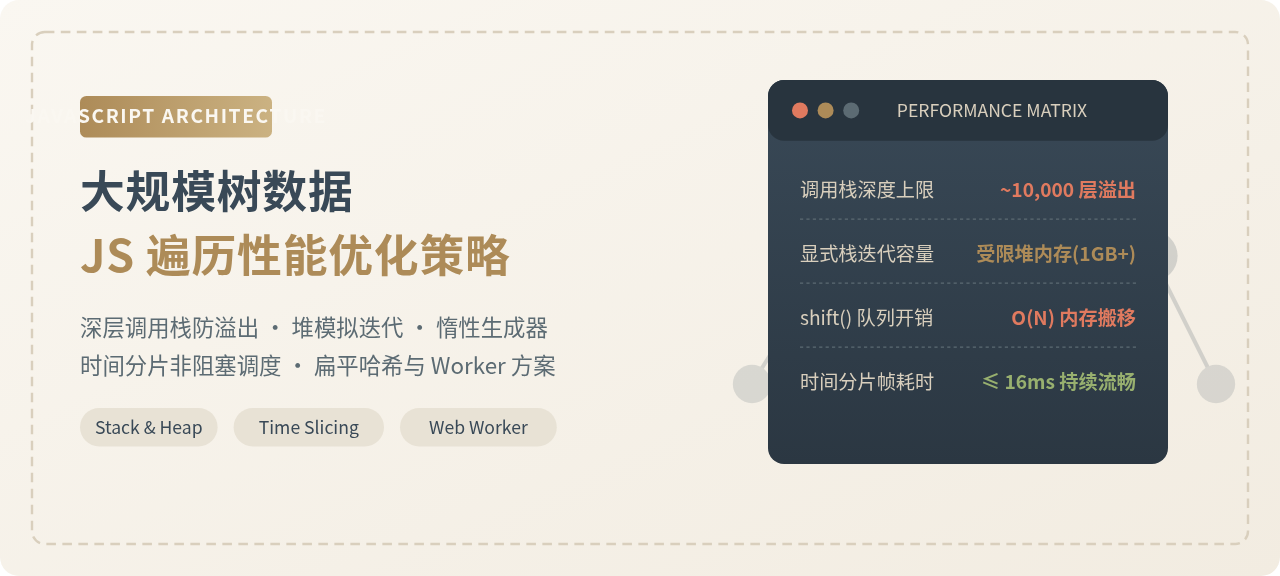
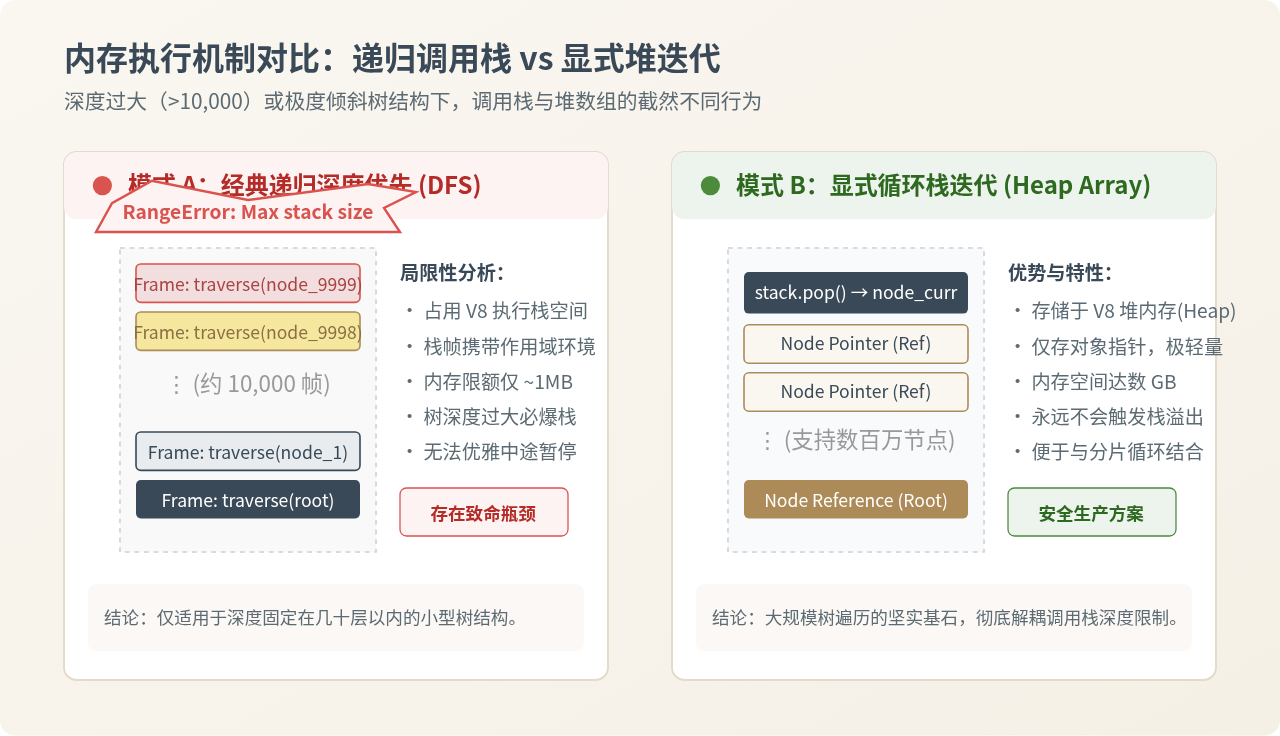
- 调用栈空间硬限制(Call Stack Limit): 在V8等现代JS引擎中,每个函数调用都会在调用栈上压入一个栈帧(Stack Frame),用来保存局部变量、参数和返回地址。V8对最大调用栈深度通常限制在约 10,000 层左右。一旦树的深度或倾斜度超出阈值,引擎将直接抛出不可恢复的
RangeError: Maximum call stack size exceeded错误。 - 主线程单线程阻塞(Main Thread Starvation): 浏览器的UI渲染、用户输入事件与JS代码执行共享同一个主线程。即使树的深度不高(不会爆栈),单次对数十万节点的深层遍历往往需要花费数百毫秒甚至数秒的纯CPU时间。期间没有任何事件循环心跳,浏览器无法响应用户的点击与滚动,导致严重的掉帧与页面假死。
- 垃圾回收与内存颠簸(GC Pressure): 遍历过程中如果频繁创建临时闭包、中间数组或使用低效的数组搬移操作,会瞬间产生大量短期内存对象,诱发引擎的频繁垃圾回收(Garbage Collection),让原本就紧张的执行耗时雪上加霜。
二、策略一:由递归转向显式栈与游标队列迭代
消除调用栈溢出最直接、彻底的工程手段,是用显式数组维护的堆栈(Heap Stack)模拟调用过程。由于堆内存的大小受宿主环境虚拟内存支配(通常至少在 1GB 以上),相较于仅有约 1MB 大小的调用栈,可容纳的节点数量提升了数个数量级。
1. 深度优先遍历(DFS)的显式栈实现
使用 stack.pop() 获取当前节点,并将当前节点的子节点按逆序压入栈中,即可在堆上完全复现先序遍历的逻辑:
/**
 * 健壮的显式栈深度优先遍历 (DFS)
 * 适用于超深倾斜树,彻底规避调用栈溢出
 */
function traverseDFSIterative(root, visitor) {
  if (!root) return;
  // 使用显式数组作为堆栈,仅存储节点对象引用
  const stack = [root];

  while (stack.length > 0) {
    const current = stack.pop();

    // 执行业务回调,如果返回 false 可支持提前终止
    const shouldContinue = visitor(current);
    if (shouldContinue === false) {
      break;
    }

    const children = current.children;
    if (children && children.length > 0) {
      // 逆序压栈,保证出栈时符合正常的从左至右先序顺序
      for (let i = children.length - 1; i >= 0; i--) {
        stack.push(children[i]);
      }
    }
  }
}
2. 广度优先遍历(BFS)避免 shift() 的游标优化
在广度优先遍历中,常规写法往往使用 queue.shift() 获取队首元素。然而在 JavaScript 引擎中,Array.prototype.shift() 是一个 O(N) 复杂度的操作,因为它每次都需要将底层连续内存数组中的所有剩余元素向前搬移一位。当队列中积压了数万个节点时,循环调用 shift() 会产生巨大的无谓内存搬移开销。
高性能的实现应该使用游标指针(Cursor Pointer)或自建链表队列,以 O(1) 的代价读取队首:
/**
 * 广度优先遍历 (BFS) 游标指针优化版
 * 避免频繁 shift() 带来的 O(N) 数组内存位移
 */
function traverseBFSOptimized(root, visitor) {
  if (!root) return;
  const queue = [root];
  let headIndex = 0; // 队首游标

  while (headIndex < queue.length) {
    const current = queue[headIndex];
    // 释放已访问节点的引用,方便垃圾回收
    queue[headIndex] = null;
    headIndex++;

    if (visitor(current) === false) {
      break;
    }

    const children = current.children;
    if (children && children.length > 0) {
      for (let i = 0; i < children.length; i++) {
        queue.push(children[i]);
      }
    }

    // 定期压缩队列数组,防止内存无限累积
    if (headIndex > 10000 && headIndex * 2 > queue.length) {
      queue.splice(0, headIndex);
      headIndex = 0;
    }
  }
}
三、策略二:大规模树遍历优化的实施路径
面对具体业务中的大树数据时,优化并非盲目套用最新潮的技术,而是根据具体的数据形态和交互属性采取阶梯式演进。建立明确的诊断指标能够避免过度工程化。
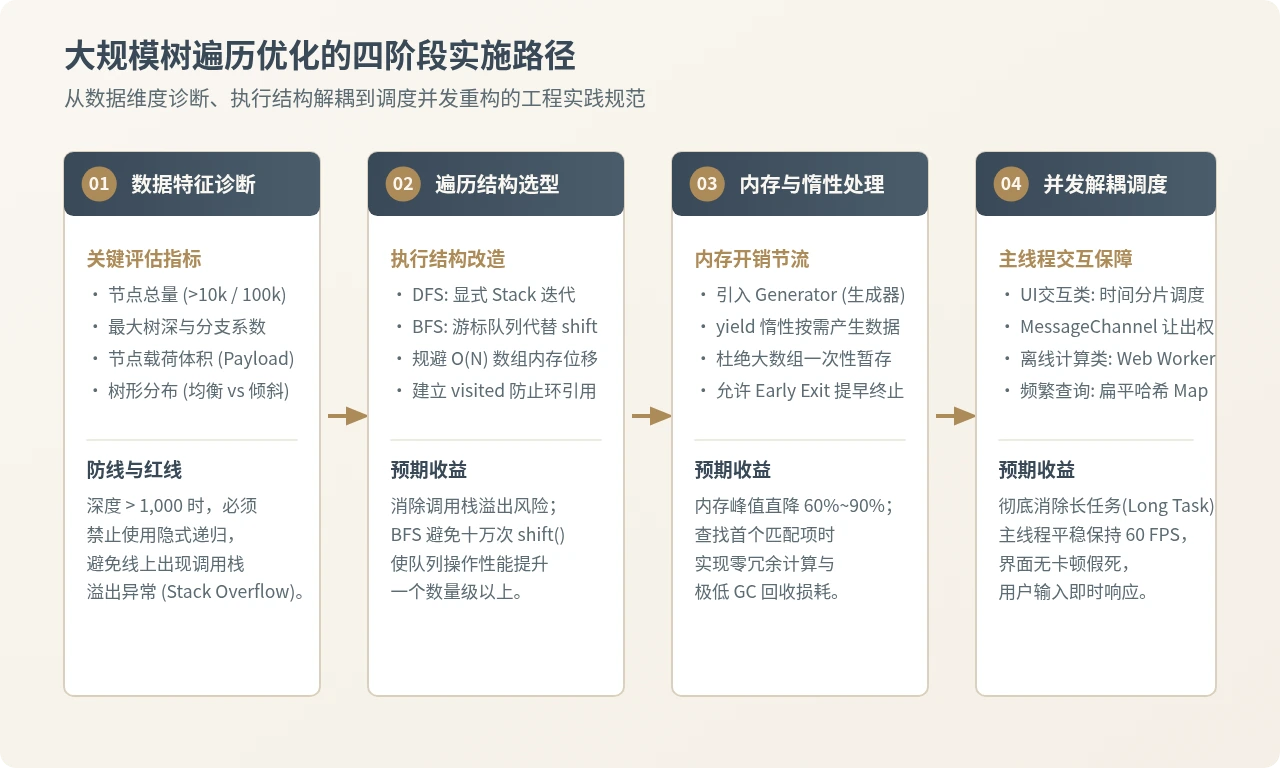
实施优化的第一道关卡是评估最大树深度与节点总数。当最大深度可能突破 1,000 时,必须立即将递归重构为显式栈;第二道关卡是判断是否需要立即全量产出。如果只是在全树中查找满足特定条件的少量目标,应当立即采用惰性流式计算;第三道关卡是评估单次遍历耗时是否超过 16 毫秒,一旦进入交互卡顿区,必须接入时间分片调度机制。
四、策略三:基于 Generator 生成器的惰性遍历
在很多搜索与过滤场景中,开发者习惯先写一个递归函数把所有匹配节点搜集到一个结果数组中返回(例如 nodes.push(item))。对于数十万节点的树,这种做法即使没有爆栈,也会在瞬间分配一个超大数组,占用大量内存。
使用 ES6 的生成器函数 function* 与 yield,可以将遍历过程转换为按需消费的惰性迭代器(Lazy Iterator)。在遍历进行时,只有当下游消费者请求下一个节点时,遍历逻辑才向前推进;一旦找到目标,break 退出循环即可立即终止遍历,不会产生任何多余节点的计算或存储开销。
/**
 * 基于 Generator 的惰性深度优先迭代器
 * 实现极低内存开销的流式遍历与零成本提前退出
 */
function* lazyTreeDFS(root) {
  if (!root) return;
  const stack = [root];

  while (stack.length > 0) {
    const current = stack.pop();

    // 按需交出控制权并产出节点
    yield current;

    const children = current.children;
    if (children && children.length > 0) {
      for (let i = children.length - 1; i >= 0; i--) {
        stack.push(children[i]);
      }
    }
  }
}

// 生产使用示例:在包含10万节点的树中查找首个符合条件的节点
function findFirstMatchingNode(treeRoot, targetId) {
  for (const node of lazyTreeDFS(treeRoot)) {
    if (node.id === targetId) {
      // 命中后立即返回,迭代器自动中断,后续9万多节点完全不被访问
      return node;
    }
  }
  return null;
}visited = new WeakSet()(或 Set(node.id)),在压入栈前校验是否已处理过,防止遍历进入无限死循环。
五、策略四:时间分片调度保障主线程交互
当业务确实需要对树上的所有节点进行全量统计、重新计算或格式转换,且耗时必然超过 50ms 时,任何纯同步遍历都会霸占主线程,导致浏览器无法执行绘制与事件回调。
时间分片(Time Slicing)的思路是将长任务分割为若干个小批次,每个批次执行约 5~10ms。通过 performance.now() 监控当前时间片的预算消耗,一旦达到阈值,就主动交出(yield)执行权,让浏览器在下一个事件循环周期中完成 UI 渲染和用户交互,再继续下一批次的遍历。
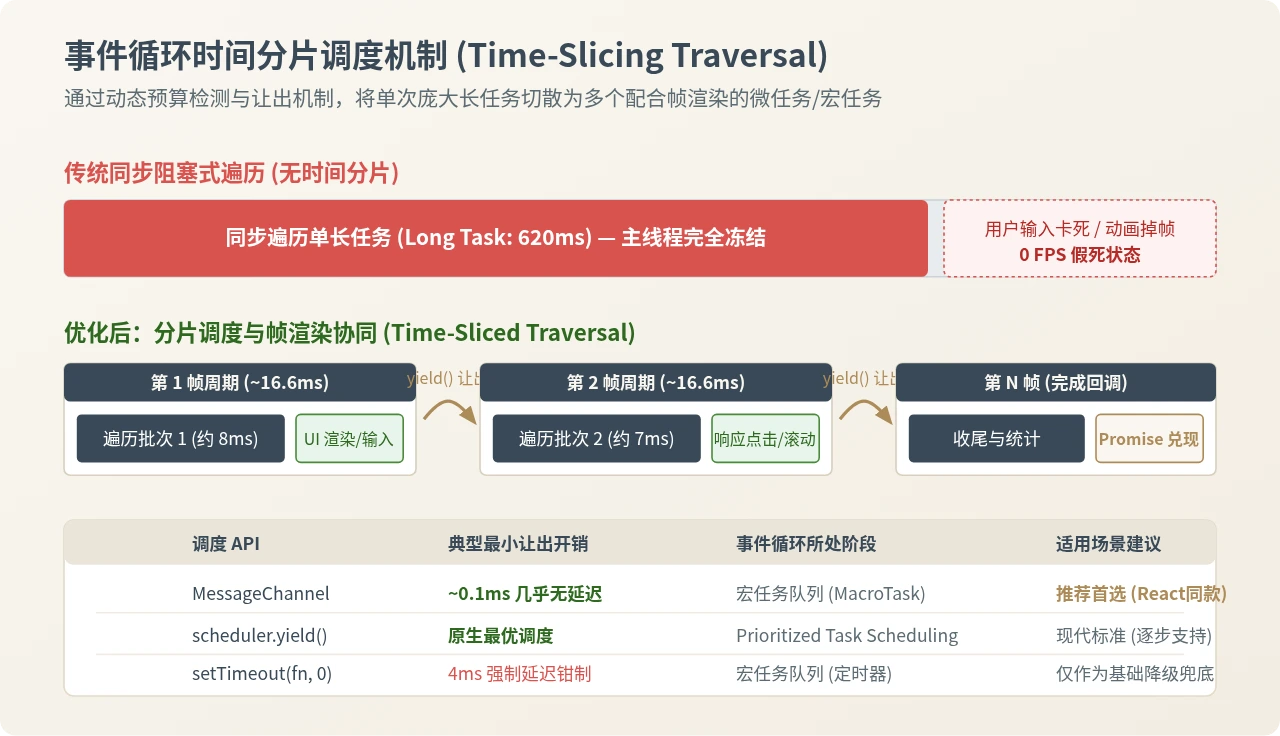
在现代浏览器中,让出控制权的最优方案是利用 MessageChannel 的宏任务机制(React 调度器同款实现),它相较于 setTimeout(fn, 0) 具有几乎为零的延迟开销(避免了浏览器的 4ms 嵌套定时器钳制):
/**
 * 现代高响应性时间分片树遍历调度器
 * 保证遍历庞大数据时,页面依然维持 60FPS 顺畅渲染
 */
function traverseWithTimeSlice(root, visitor, onProgress) {
  return new Promise((resolve) => {
    if (!root) {
      resolve();
      return;
    }

    const stack = [root];
    const channel = new MessageChannel();
    const FRAME_BUDGET = 8; // 每个时间片配额 8ms,预留充足时间给浏览器渲染
    let processedCount = 0;

    channel.port1.onmessage = () => {
      const startTime = performance.now();

      while (stack.length > 0) {
        // 如果当前时间片已经耗尽预算,中断当前循环,让出主线程
        if (performance.now() - startTime > FRAME_BUDGET) {
          if (onProgress) {
            onProgress(processedCount);
          }
          // 通知 port2 发送消息,在下一个宏任务周期继续唤醒
          channel.port2.postMessage(null);
          return;
        }

        const current = stack.pop();
        processedCount++;
        visitor(current);

        const children = current.children;
        if (children && children.length > 0) {
          for (let i = children.length - 1; i >= 0; i--) {
            stack.push(children[i]);
          }
        }
      }

      // 全部节点遍历完毕
      if (onProgress) onProgress(processedCount);
      resolve(processedCount);
    };

    // 启动首次调度
    channel.port2.postMessage(null);
  });
}
六、策略五:Web Worker 独立线程与数据扁平索引化
在极少数涉及海量离线计算的场景中(如 CAD 图纸的百万几何图元树拓扑计算、大型地理信息 GIS 树分析),时间分片虽然保障了界面不卡,但由于频繁让出主线程,总耗时反而会有轻微增加。此时可以考虑将整棵树的数据转移到 Web Worker 中执行。
在 Worker 中,遍历完全运行在独立系统线程中,哪怕单次占用 100% 的单核 CPU 运行 10 秒,主线程的前端界面也不会产生丝毫卡顿。需要注意的限制是:树数据通过 postMessage 传递时默认会执行结构化克隆(Structured Clone),若树体积超大,克隆传输本身会产生内存损耗。因此如果数据频繁读写,应优先在数据初始化阶段将树结构一次性扁平化(Flattening)为哈希映射表(Map):
/**
 * 读多写少场景下的索引降维:将大树扁平化为 Map 结构
 * 彻底消除后续多轮遍历开销,将任意深度的按 ID 查找降维至 O(1)
 */
function buildTreeMapIndex(root) {
  const idMap = new Map();
  const parentMap = new Map();
  const stack = [root];

  while (stack.length > 0) {
    const current = stack.pop();
    idMap.set(current.id, current);

    const children = current.children;
    if (children && children.length > 0) {
      for (let i = 0; i < children.length; i++) {
        parentMap.set(children[i].id, current.id);
        stack.push(children[i]);
      }
    }
  }

  return {
    getNodeById: (id) => idMap.get(id),
    getParentId: (childId) => parentMap.get(childId)
  };
}
七、优化策略选型与决策总结
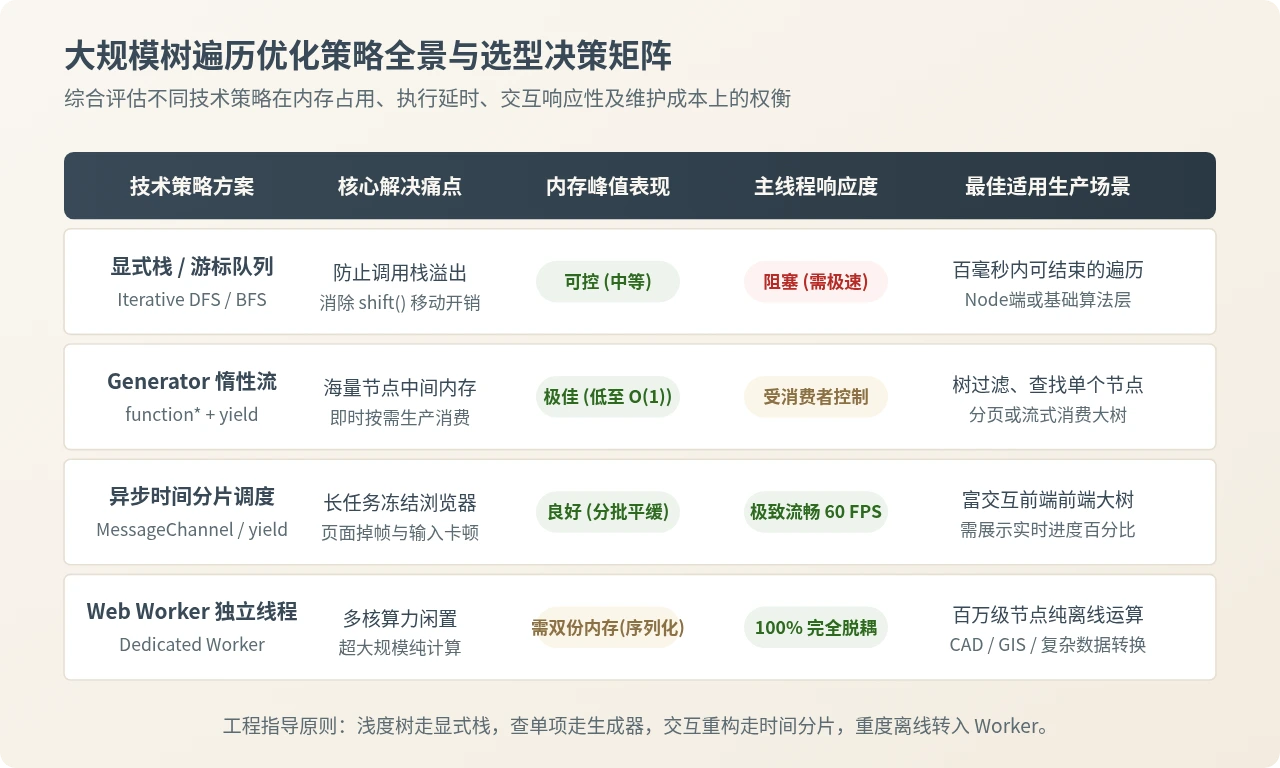
综合以上各类策略,在实际项目选型时,应该依据运行环境、响应性要求与数据规模建立清晰的技术选型矩阵:
| 策略方案 | 核心优势 | 潜在代价 | 推荐使用场景 |
|---|---|---|---|
| 显式循环栈 (DFS) | 彻底杜绝调用栈溢出,执行效率接近原生底层 | 依然在主线程同步运行,大计算仍可能阻塞 | 树深度超过 1,000 层,总耗时在 20ms 以内的运算 |
| 游标指针队列 (BFS) | 消除 shift() 的数组拷贝开销,吞吐量提升 5~10 倍 | 需要妥善维护游标索引与周期性清理废弃项 | 层级广度极大的企业组织架构或批量层级计算 |
| Generator 惰性流 | 内存开销仅为 O(1),支持查找单项即时退出 | 语法具有传染性,需使用 for...of 或手动 next() | 模糊匹配、首项查找、虚拟滚动分页懒加载 |
| 时间分片调度 | 维持主线程 60 FPS,彻底消除界面假死与掉帧 | 异步 Promise 封装,执行总耗时比纯同步略长 | 前端全量计算、图表渲染前统计、需展示进度条 |
| Web Worker 线程 | 完全脱离主线程,多核运算无视耗时 | 不可操作 DOM,需处理数据序列化克隆损耗 | 百万级离线纯计算、CAD/GIS 拓扑结构构建 |
在工程实践中,往往需要组合应用上述策略:以显式栈为底层基石替换一切深层递归;以生成器包裹实现流式检索;在面临长时间 UI 计算时接入时间分片。这种分层递进的架构能够让大型前端与 Node.js 应用程序在面对海量复杂树结构时,始终保持高度的健壮性与极致的流畅度。
Web端大规模流程图渲染卡顿怎么办?JavaScript性能优化策略
2026-11-16 14:27:27
JS本地缓存选型:localStorage、sessionStorage与IndexedDB的区别
2026-11-16 14:27:14
Claude Trading Skills怎样区分密钥日志修复与完整安全审查?
2026-11-16 12:59:34
用requestAnimationFrame优化JavaScript实时时间显示
2026-11-13 14:36:58
JavaScript中使用位运算(~~或|0)取整的原理与局限
2026-11-12 10:52:46