Web端大规模流程图渲染卡顿怎么办?JavaScript性能优化策略
深入剖析Web端大规模流程图在缩放、平移与拖拽过程中的渲染卡顿根因,系统讲解视口虚拟化剔除、LOD分级渲染、Web Worker异步计算以及混合渲染架构的完整落地策略。
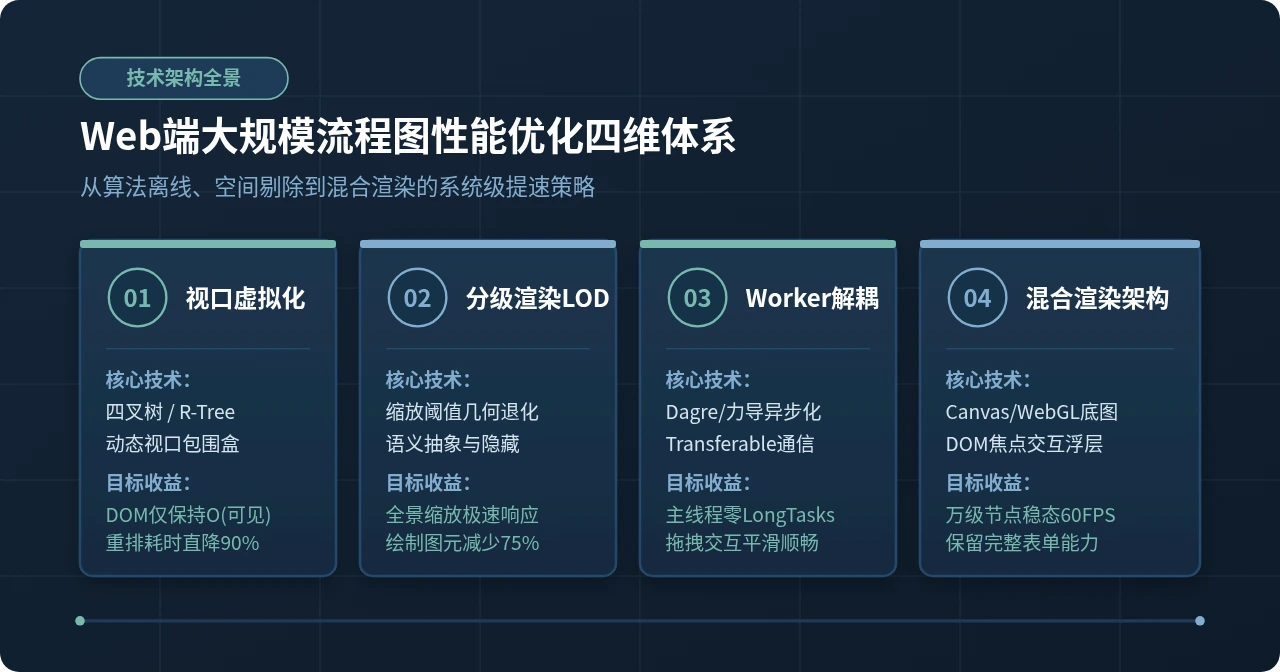
图 0:Web 端大规模流程图性能优化全景图
一、情境复现:大规模流程图卡顿的底层根因剖析
假设你正在开发一款微服务链路监控画布或复杂的 ETL 数据管道设计器。初始开发阶段,画布中仅有几十个节点,拖拽、缩放、连线均丝滑流畅。然而,当接入真实生产数据,节点数量攀升至 1,500 个、连线超过 3,000 条时,用户只要轻微滑动滚轮缩放画布,整个页面就会瞬间卡死数百毫秒,Chrome DevTools 频繁告警红色长任务(Long Tasks > 50ms),操作帧率甚至跌至个位数。
很多开发者下意识地认为是“数据量太大导致的 JavaScript 执行缓慢”,但使用性能分析工具采样后会发现,根本症结往往潜伏在浏览器的渲染流水线中:
- DOM 树节点爆炸引发的重排与重绘雪崩:大部分基于传统 SVG 或 HTML 的流程图方案(如早期原生 SVG 绘制),每个节点不仅仅是一个矩形,还包含图标、多行标题、多个连接桩(Ports)、状态指示灯以及包围盒,平均每个节点对应 10~20 个真实 DOM 节点。当图元达到 2,000 个时,DOM 树规模瞬时膨胀到 30,000+ 节点。此时任何平移或缩放操作,即便仅仅是修改外层容器的
transform,某些浏览器的样式重计算(Recalculate Style)与重排(Layout)耗时依然会高达 100ms 以上。 - 高频滚轮与移动事件阻塞主线程:缩放(wheel)与画布平移(mousemove / pointermove)事件每秒触发 60 次以上。如果每次事件触发时都同步遍历全量节点计算几何投影或更新节点状态,主线程事件循环(Event Loop)将被彻底占满,无法及时响应浏览器的垂直同步信号(V-Sync)。
- 重型图布局算法同步占用计算资源:诸如 Dagre、D3-force 或 ELK 等层级布局与力导向模拟算法,其计算复杂度往往达到 $O(V + E)$ 乃至 $O(V^2)$。若在主线程同步执行拓扑排序与坐标迭代,整个页面会直接处于未响应(Freeze)状态。
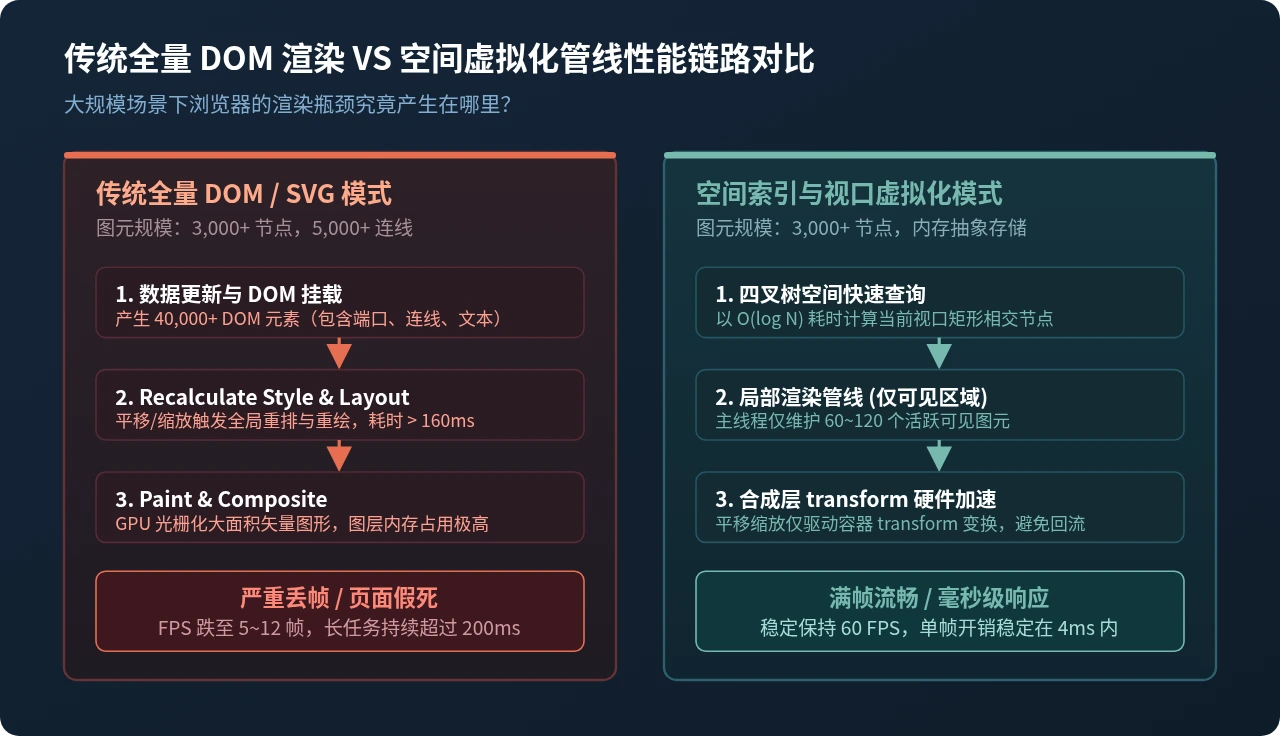
图 1:传统全量 DOM 渲染与空间虚拟化管线性能链路对比
二、性能采样与瓶颈定位标准步骤
在动手重构代码前,必须建立可度量的基准数据,精准识别卡顿的具体阶段。切忌在没有基准指标的情况下盲目优化。
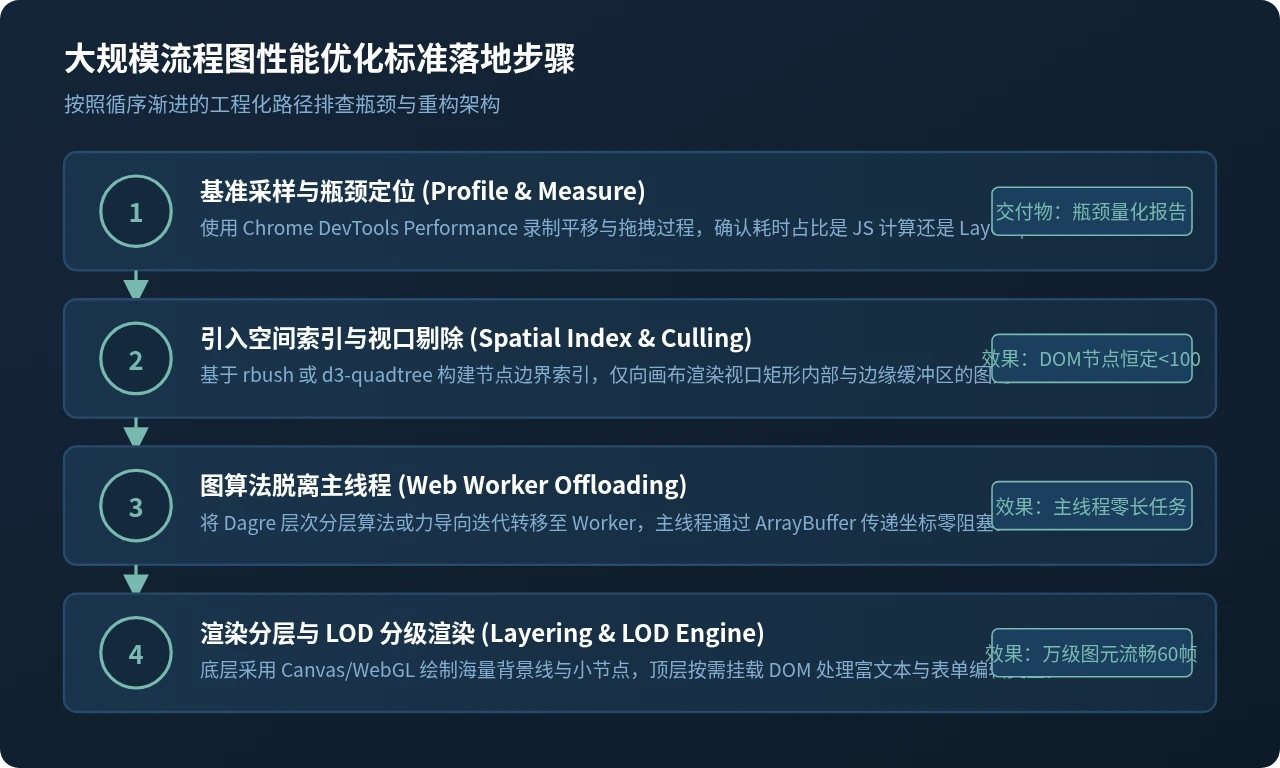
图 2:大规模流程图性能优化实施步骤流程图
- 开启 Chrome DevTools Performance 面板录制: 打开被测流程图页面,点击 DevTools 中的“Record”按钮,在画布上连续执行 3 秒平移拖拽与滚轮连续缩放,随后停止录制。
-
观察 Main 线程与 Frames 轨迹:
检查 FPS 曲线是否出现大量波谷,同时观察 Main 轨道上的火焰图。如果火焰图呈现大面积深黄色切片,说明是
Layout或Recalculate Style开销过高(DOM 膨胀);如果呈现深黄色或蓝色长任务且函数名指向矩阵计算、力导向循环或拓扑排序,则瓶颈在于 JavaScript 算法计算;若 Paint 轨道过长,则说明 GPU 光栅化压力过载。 - 确立优化交付目标: 在 5,000 节点规模下,交互平均帧率稳定在 50~60 FPS,缩放平移交互时 Long Task 数量归零,单次渲染微任务执行时间控制在 16ms 以内。
三、核心优化策略一:视口空间索引与虚拟化剔除
既然人类在屏幕上可见的范围仅仅是浏览器视口那几百到一千多像素,那么视口之外的 90%~99% 节点与边根本不需要挂载到渲染树中。视口虚拟化(Viewport Culling)是解决卡顿最高效、性价比最高的手段。
1. 空间索引数据结构选型
若每次视口移动都对全量数据做一次 $O(N)$ 的包围盒求交检测,当节点达到万级时,即便纯算几何也会产生可感知的微卡顿。因此必须在内存中维护一个高效的空间索引结构:四叉树(QuadTree)或 R-Tree(如开源的高性能 rbush 库)。空间索引可将视口相交查询的复杂度由 $O(N)$ 降至 $O(\log N)$。
2. 视口裁剪与安全缓冲区(Padding)机制
直接以浏览器视口边界作为过滤边界会导致用户在快速拖拽时,屏幕边缘出现短暂的“白块”或节点闪烁。工业级的做法是引入一个动态安全外边距(Viewport Buffer Padding),通常取视口宽高各 20%~30% 的缓冲区域,确保在平移加速期图元已提前准备就绪。
// 视口空间查询与相交过滤示例(基于边界包围盒与缓冲区)
interface BoundingBox {
  minX: number;
  minY: number;
  maxX: number;
  maxY: number;
}

class ViewportManager {
  private spatialIndex: any; // 例如 rbush 实例
  private bufferRatio: number = 0.25; // 25% 缓冲区

  constructor(spatialIndex: any) {
    this.spatialIndex = spatialIndex;
  }

  /**
   * 根据当前视口变换矩阵获取实际可见的节点集合
   * @param transform - 包含缩放与平移的视图状态
   * @param containerSize - 容器的实际物理像素宽高 [w, h]
   */
  getVisibleItems(transform: { x: number; y: number; scale: number }, containerSize: [number, number]) {
    const [width, height] = containerSize;
    const padX = (width / transform.scale) * this.bufferRatio;
    const padY = (height / transform.scale) * this.bufferRatio;

    // 换算物理视口到画布逻辑坐标系下的包围盒
    const logicalBox: BoundingBox = {
      minX: -transform.x / transform.scale - padX,
      minY: -transform.y / transform.scale - padY,
      maxX: (-transform.x + width) / transform.scale + padX,
      maxY: (-transform.y + height) / transform.scale + padY
    };

    // O(log N) 快速范围检索
    return this.spatialIndex.search(logicalBox);
  }
}四、核心优化策略二:分层渲染与分级细化(LOD 机制)
当用户将流程图缩放到 0.15 倍(全局宏观全景视图)时,视口空间索引将失效——因为此时全部数千个节点都落在了屏幕内!如果此时渲染每一个节点的文本、输入框和高精度边框,页面卡顿依然无法避免。
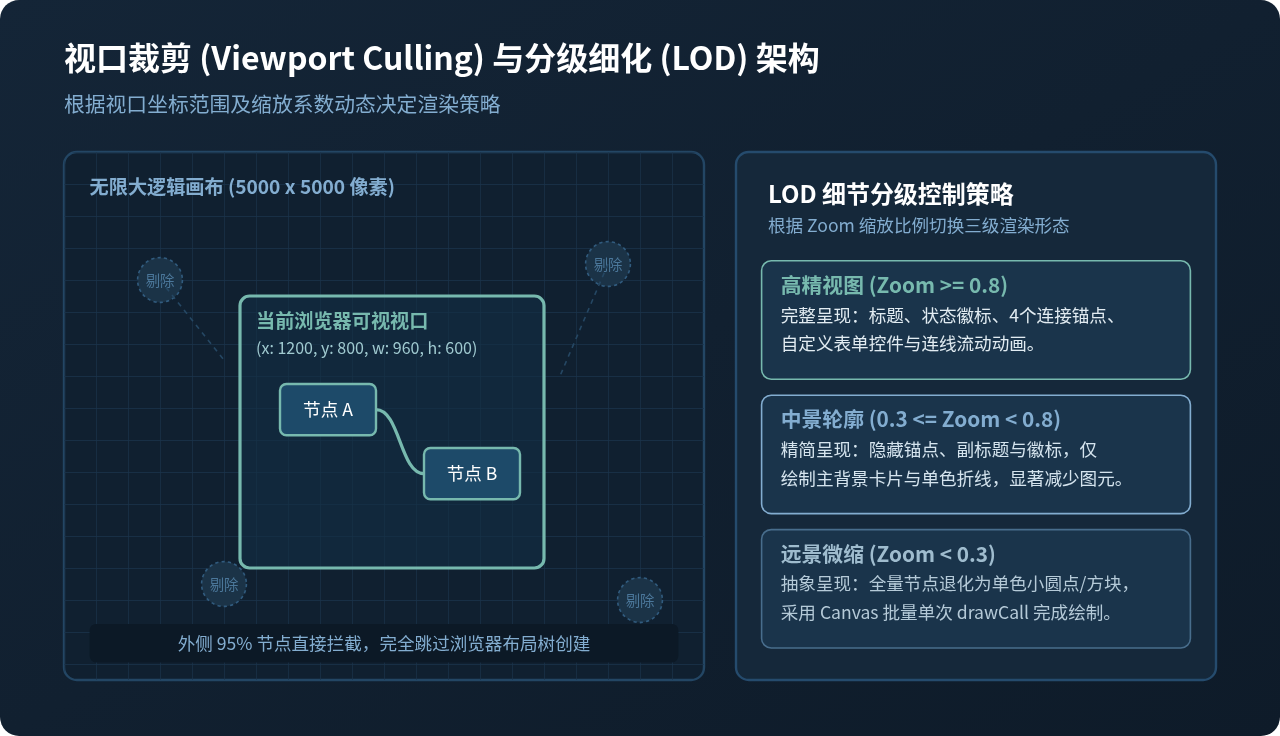
图 3:视口裁剪与分级细化 (LOD) 架构图
针对全局宏观视图,必须引入三维渲染领域成熟的 LOD(Level of Detail,多层次细节) 机制:
- 近景高精状态(Zoom ≥ 0.8):渲染完整卡片,挂载全部 DOM 连接桩、状态指示图标、副标题和交互控制柄。
- 中景轮廓状态(0.3 ≤ Zoom < 0.8):简化节点视觉,关闭富文本排版和细微连接端点,使用轻量几何边框与简短单行标签,隐藏装饰性阴影和渐变滤镜。
- 远景聚合状态(Zoom < 0.3):完全舍弃文本与复杂路径,将节点直接退化为单纯的色块矩形或微小圆点,连线退化为 1px 单色直线。此状态下图元绘制指令减少 80% 以上,渲染引擎可以毫秒级吞吐。
五、核心优化策略三:主线程解耦——Web Worker 异步计算图算法
很多流程图系统在首次打开或用户点击“一键整理布局”时发生严重卡顿。这是因为图布局排版算法(如 Dagre 分层布线算法)需要进行深度的拓扑遍历和交叉连线极小化计算,属于高 CPU 消耗型任务。
优化方案是将这类重度计算剥离到独立的 Web Worker 线程中异步执行,UI 主线程仅负责显示加载骨架屏并维持交互动画响应。
// 1. worker-layout.ts - 运行在独立线程中的布局运算
import dagre from 'dagre';

self.onmessage = (e: MessageEvent) => {
  const { nodes, edges, config } = e.data;

  const g = new dagre.graphlib.Graph();
  g.setGraph(config);
  g.setDefaultEdgeLabel(() => ({}));

  nodes.forEach((n: any) => g.setNode(n.id, { width: n.width, height: n.height }));
  edges.forEach((e: any) => g.setEdge(e.source, e.target));

  // 耗时密集型图布局运算
  dagre.layout(g);

  const calculatedLayout = nodes.map((n: any) => {
    const pos = g.node(n.id);
    return { id: n.id, x: pos.x, y: pos.y };
  });

  // 计算完成后将精简的坐标数组回传给主线程
  self.postMessage({ type: 'LAYOUT_COMPLETE', layout: calculatedLayout });
};Float32Array 坐标缓冲区(采用 Transferable Objects 零拷贝移交所有权),进一步压缩通信耗时。
六、核心优化策略四:渲染引擎演进与混合渲染架构
当流程图规模持续突破数千甚至数万节点时,纯 DOM/SVG 架构会触碰底层物理天花板。此时最有效且具备良好工程扩展性的方案是混合分层渲染(Hybrid Canvas/DOM Pipeline):
- 底层(Canvas 2D / WebGL 背景层):承担 95% 以上无交互的背景网格、连线、箭头以及普通静态只读节点。利用 Canvas 极高的单次 drawCall 吞吐能力,瞬间绘制数万图元而不产生任何 DOM 节点。
- 顶层(DOM 浮层):只在用户悬浮(Hover)、双击编辑或选中某个节点时,动态在对应坐标位置覆盖挂载一个轻量 DOM 元素,提供富文本编辑、输入框、下拉框或浮动工具栏。完成交互后立即销毁或隐藏。
- 事件防抖与 RequestAnimationFrame 合并更新:将鼠标平移、缩放过程中的重绘请求统一收敛至
requestAnimationFrame调度队列,丢弃同一帧内的多余重绘,保证浏览器每一帧只执行一次完整的渲染管道。
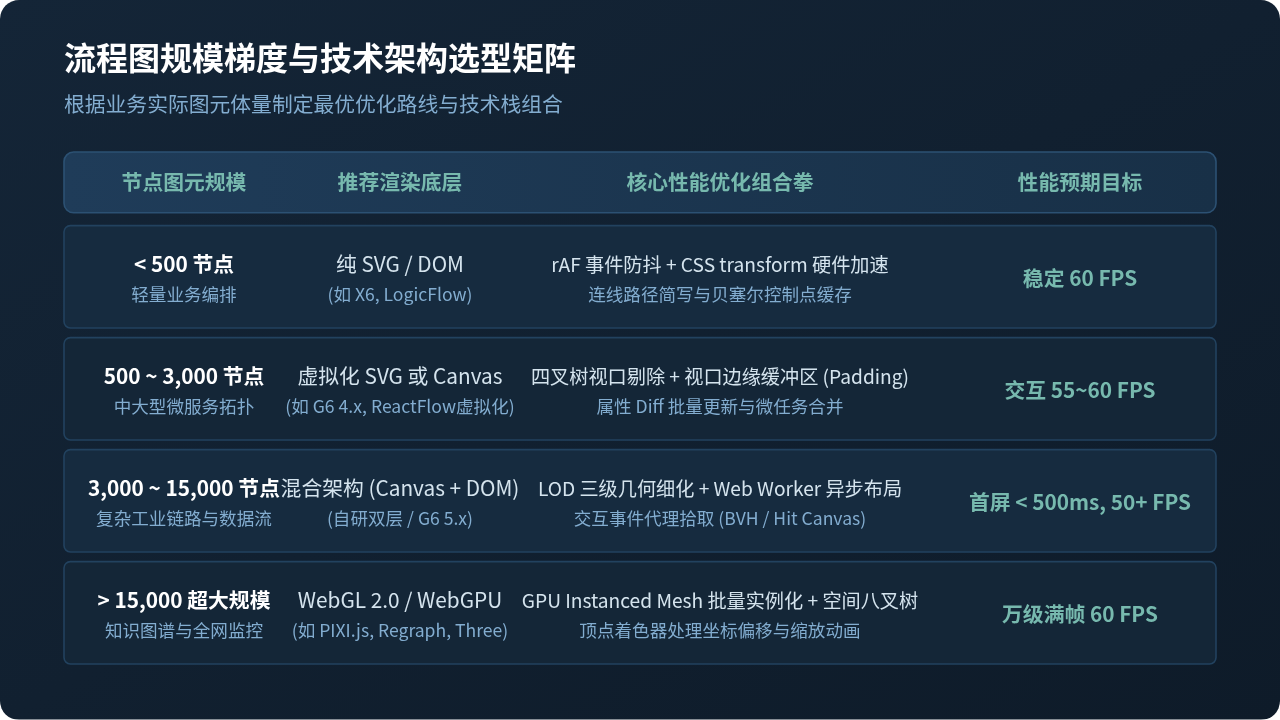
图 4:流程图规模梯度与技术架构选型矩阵
七、优化效果验证与指标对照
采用上述全套优化组合拳后,在包含 5,000 节点与 8,000 连线的典型大规模业务拓扑图上进行对比验证,关键性能指标获得质的提升:
| 性能指标 | 未优化(原生全量 SVG) | 优化后(虚拟化 + 混合渲染 + Worker) | 改善幅度 |
|---|---|---|---|
| DOM 活跃节点总数 | 45,000+ | 恒定维持在 50~120 个 | 减少 99.7% |
| 首次加载完成耗时 | 3,850 ms | 340 ms | 提速 11.3 倍 |
| 平移/缩放交互帧率 | 8 ~ 14 FPS(肉眼严重卡顿) | 58 ~ 60 FPS(丝滑满帧) | 帧率提升 4~7 倍 |
| 主线程 Long Tasks (>50ms) | 连续出现 24 次 | 0 次 | 完全消除长任务阻塞 |
| 浏览器内存峰值占用 | 680 MB | 115 MB | 内存开销下降 83% |
通过“诊断瓶颈 → 视口裁剪 → LOD分级 → 算法离线 → 混合渲染”这一套体系化的 JavaScript 性能优化手段,Web 端流程图应用不仅能够轻松承载万级复杂拓扑,更为后续扩展实时状态推送、多人在线协作等复杂业务功能奠定了稳固的高性能基石。
处理大规模树数据时JS遍历的性能优化策略
2026-11-16 14:27:26
JS本地缓存选型:localStorage、sessionStorage与IndexedDB的区别
2026-11-16 14:27:14
Claude Trading Skills怎样区分密钥日志修复与完整安全审查?
2026-11-16 12:59:34
用requestAnimationFrame优化JavaScript实时时间显示
2026-11-13 14:36:58
JavaScript中使用位运算(~~或|0)取整的原理与局限
2026-11-12 10:52:46
相关标签: