Node.js旧版本不支持Intl API时的中文排序方案
针对Node.js旧版本(Node 13之前)因默认Small-ICU导致Intl API与localeCompare中文排序退化为Unicode码点顺序的问题,深入分析故障根因,并提供运行时外挂Full-ICU数据、纯JS拼音转换与GBK编码序等完整实操解决方案与生产级降级架构。
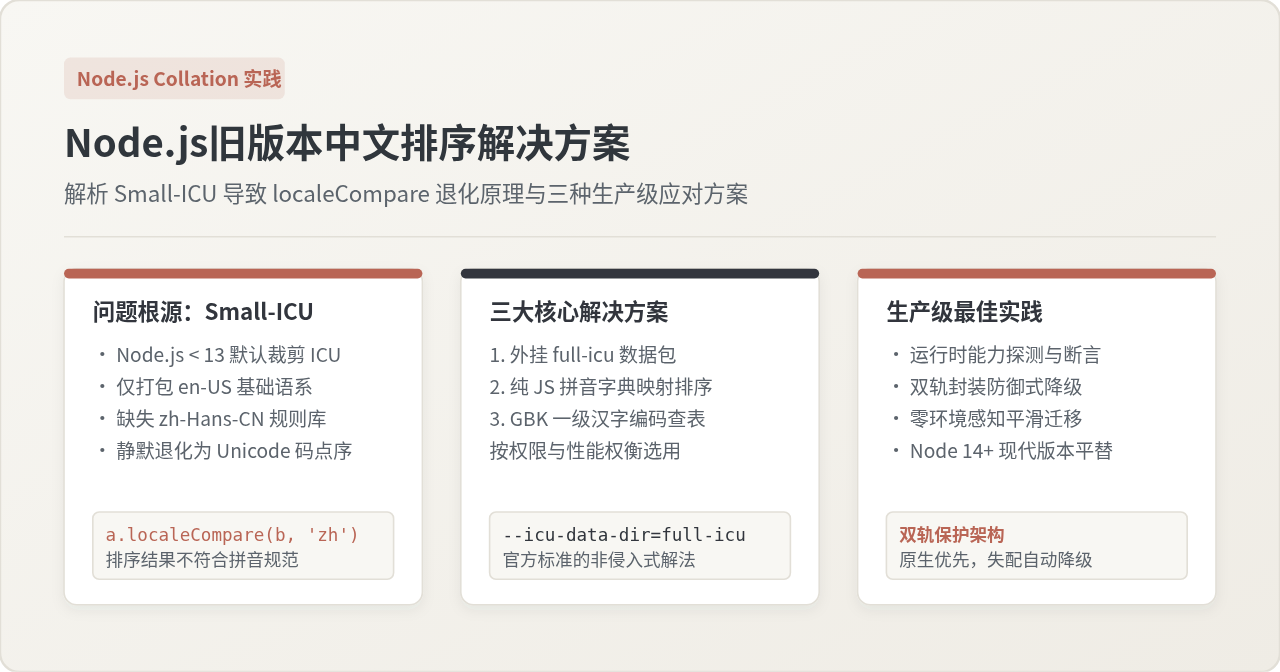
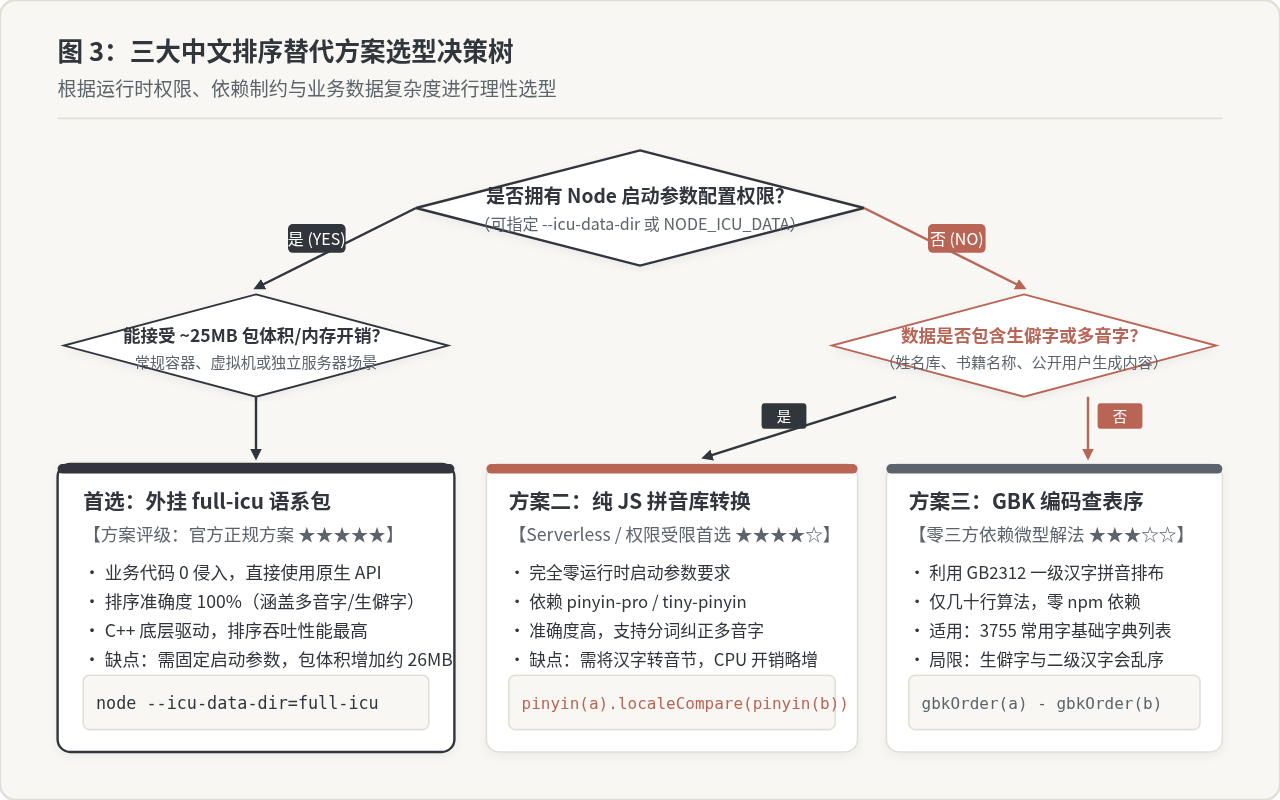
在早于 Node.js 13 的旧版本环境中(例如许多企业生产环境仍在维护的 Node.js 8、10、12 官方预编译二进制,以及更早期的 0.10、0.12 版本),调用 String.prototype.localeCompare 或 Intl.Collator 尝试对中文数组按拼音首字母字典序排序时,系统往往不会报错,而是静默退化为基于 UTF-16 Unicode 码点的原始数值大小进行排列。这会导致诸如“阿强”(A)因 Unicode 编码偏大而被错误排在“张三”(Z)之后。要让老旧环境具备符合汉语日常直觉的拼音排序能力,核心解决路径分为三类:拥有服务启动权限时挂载 full-icu 全量国际化语系数据;在 Serverless 等受限环境中采用纯 JavaScript 拼音库将汉字映射为音节后比对;以及针对基础汉字利用 GB2312/GBK 编码特性进行轻量化字节序比较。本文将逐一拆解其实现细节与工程落地方式。
一、问题根源与复现检测
ECMAScript 国际化规范(ECMA-402)定义了 Intl 对象,其中的 Intl.Collator 负责处理多语言文本的敏感度比对与本地化字典序排序。当在现代浏览器或较新版本的 Node.js 中执行带有 'zh-Hans-CN' 或 'zh-CN' 标记的比较时,底层引擎会依据 Unicode 常用语系数据仓库(CLDR)中定义的拼音规则完成权重推导。
但在 Node.js 13 之前,官方分发的预编译二进制包为了削减安装包体积(完整的 ICU 数据解压后会占用约 25MB 至 30MB 磁盘空间),默认采用 small-icu 模式编译,仅仅打包了英语(en-US)语系。当 JavaScript 引擎调用 a.localeCompare(b, 'zh-Hans-CN') 时,由于在本地找不到中文排序规则,V8 引擎并不会抛出运行时异常,而是执行“优雅降级”——退回系统根语系(Root Collation)。而根语系比对在缺乏对应规则时,实质上退化为了 UTF-16 字符码点值的纯数值大小比较。
const list = ['张三', '李四', '王五', '阿强'];

// 尝试使用中文语系 locale 规则排序
list.sort((a, b) => a.localeCompare(b, 'zh-Hans-CN'));

console.log('排序结果:', list);

// 打印首字符的 Unicode 码点以观察退化原因
list.forEach(item => {
  const code = item.charCodeAt(0).toString(16).toUpperCase();
  console.log(`${item}: U+${code}`);
});从输出中可以清晰看出,排序顺序完全由十六进制码点值 0x5F20 < 0x674E < 0x738B < 0x963F 决定。原本首字母为 A 的“阿强”被排在了最后一位,导致业务逻辑出现严重偏差。
为了在应用程序启动时主动识别当前 Node.js 运行时是否具备中文排序能力,可以使用如下轻量探针函数:
function hasChineseCollationSupport() {
  try {
    // 汉语拼音中:'阿'(ā) 必定排在 '八'(bā) 之前
    // 若退化为 Unicode 码点:'阿'(0x963F) > '八'(0x516B),结果将大于 0
    return '阿'.localeCompare('八', 'zh-Hans-CN') < 0;
  } catch (e) {
    // 在极早期的 Node.js 0.10 等无 Intl 环境中会触发异常
    return false;
  }
}

console.log('中文拼音排序支持状态:', hasChineseCollationSupport());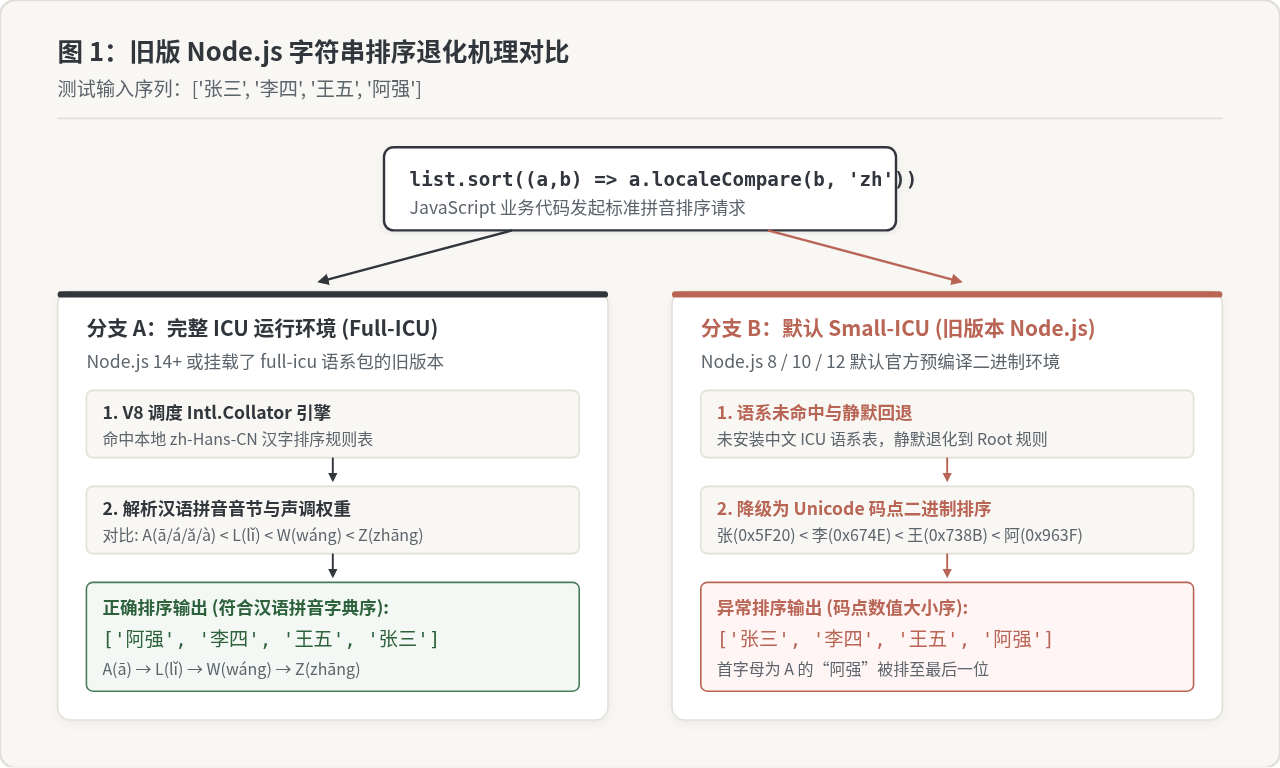
二、方案一:外挂 Full-ICU 数据包(官方标准路径)
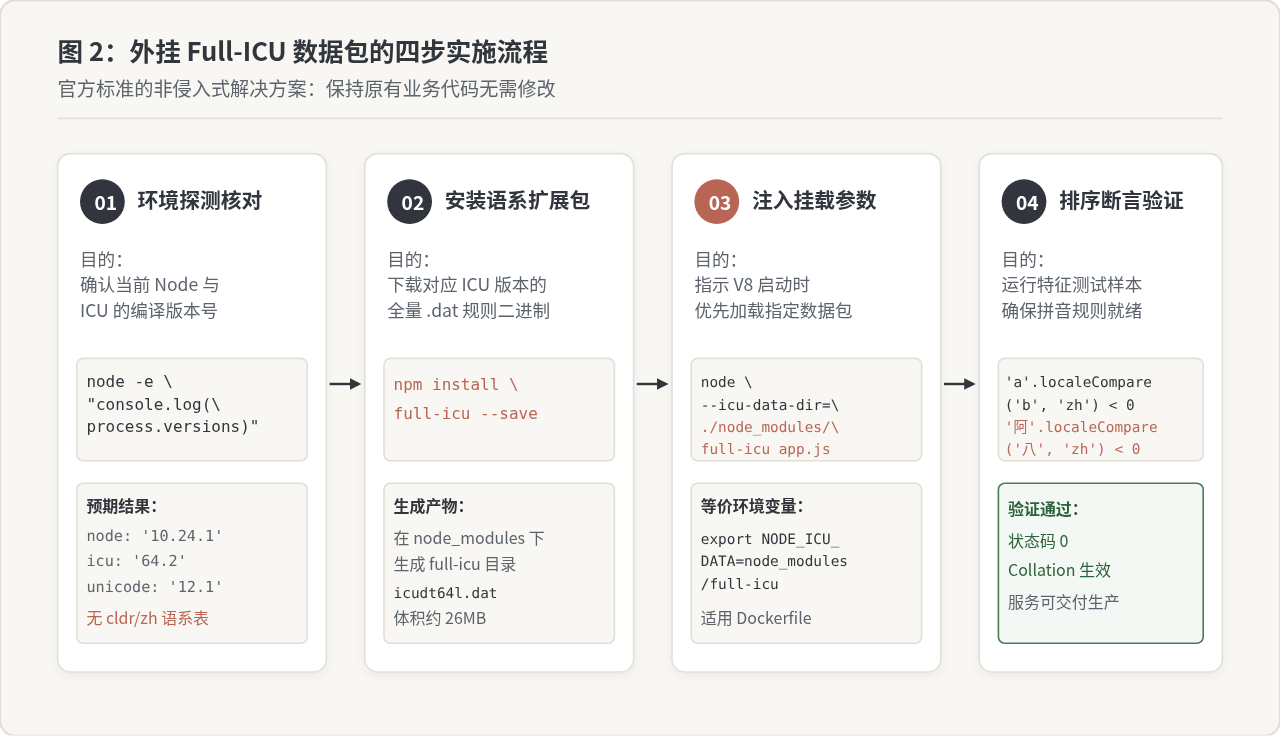
如果当前开发团队拥有对 Node.js 启动脚本、PM2 进程配置或 Docker 镜像 Dockerfile 的修改权限,且 Node.js 版本在 0.12 到 12 之间,官方推荐的最优解是直接外挂 full-icu 语系包。这一方案完全保留了标准 Intl.Collator 与 localeCompare 的调用语法,无需改动任何既有业务代码。
1. 安装 full-icu 依赖
在项目根目录下通过 npm 安装对应语系包。安装脚本会自动根据当前使用的 Node.js 和 ICU 大版本,下载匹配的预编译 .dat 二进制文件:
npm install full-icu --save2. 注入运行时挂载参数
旧版 Node.js 提供了两种外挂数据目录的机制:命令行选项 --icu-data-dir 和环境变量 NODE_ICU_DATA。开发者可根据部署形态选择合适方式:
方式 A:通过命令行参数指定(推荐用于 npm scripts)
{
  "scripts": {
    "start": "node --icu-data-dir=node_modules/full-icu app.js",
    "test": "node --icu-data-dir=node_modules/full-icu test/index.js"
  }
}
方式 B:通过环境变量注入(推荐用于 Docker 镜像或 PM2)
FROM node:10.24.1-alpine
WORKDIR /app
COPY package*.json ./
RUN npm install
COPY . .
# 注入 ICU 环境变量指针
ENV NODE_ICU_DATA=/app/node_modules/full-icu
CMD ["node", "app.js"]
方式 C:在代码入口处自动挂接(适用于无法传递命令行参数的特殊场景)
// 必须在任何业务逻辑或 Intl 调用之前执行
if (!process.env.NODE_ICU_DATA) {
  try {
    const path = require('path');
    const icuDir = path.resolve(__dirname, 'node_modules/full-icu');
    process.env.NODE_ICU_DATA = icuDir;
  } catch (err) {
    console.warn('自动挂载 full-icu 失败:', err.message);
  }
}

const app = require('./app');full-icu 二进制数据文件与 Node.js 内部编译的 ICU 主版本强绑定。如果项目后续升级了 Node.js 次版本或在不同操作系统间拷贝 node_modules,必须重新运行 npm rebuild full-icu 以避免版本不兼容导致启动失败。
三、方案二:基于纯 JavaScript 的拼音字典映射排序
在诸如 AWS Lambda、腾讯云 SCF 等无服务化(Serverless)计算环境,或者只读挂载的老旧运行时中,开发者往往无法随意自定义 Node.js 启动指令。此时,最稳健的做法是在应用代码层引入轻量级拼音转换模块,将汉字序列转换为标准拼音音节后再进行比较。
现代生态中有多个纯 JavaScript 编写的拼音处理库(例如 pinyin-pro 或体积更为紧凑的 tiny-pinyin),它们通过内置压缩后的常用字音节映射表,能够在毫秒级内完成文本到拼音的转换。
npm install pinyin-pro --saveconst { pinyin } = require('pinyin-pro');
/**
* 纯 JS 中文拼音排序比较器
* 支持中英文混排、纯数字排序与字符串属性字段提取
*/
function createPinyinComparator(options = {}) {
const key = options.key || null;
const ascending = options.order !== 'desc';
// 辅助函数:提取比对目标文本
const extractText = (item) => {
if (typeof item === 'string') return item;
if (item && key && typeof item[key] === 'string') return item[key];
return String(item || '');
};
// 内存音节缓存,避免在 O(N log N) 排序过程中重复调用拼音解析
const pinyinCache = new Map();
const getPinyin = (str) => {
if (pinyinCache.has(str)) return pinyinCache.get(str);
// toneType: 'none' 去除声调便于字母比较;v: true 规范 ü
const py = pinyin(str, { toneType: 'none', nonZh: 'consecutive', v: true });
pinyinCache.set(str, py);
return py;
};
return function (a, b) {
const textA = extractText(a);
const textB = extractText(b);
const pyA = getPinyin(textA);
const pyB = getPinyin(textB);
// 首先按拼音音节进行标准 ASCII 字母比较
let cmp = pyA.localeCompare(pyB);
// 当拼音相同时(同音不同字,例如“张”与“章”),退回汉字自身精确比对以保证排序稳定性
if (cmp === 0) {
cmp = textA.localeCompare(textB);
}
return ascending ? cmp : -cmp;
};
}
// 验证用例
const list = [
{ id: 1, name: '张三' },
{ id: 2, name: '李四' },
{ id: 3, name: '王五' },
{ id: 4, name: '阿强' },
{ id: 5, name: '白敬亭' }
];
list.sort(createPinyinComparator({ key: 'name' }));
console.log('拼音排序结果:', list.map(item => item.name));该方案的优势在于环境无关性,无论部署在 Node.js 8、10、还是浏览器端均能保证 100% 行为一致;同时支持根据上下文多音字词组(例如“重庆”识别为 chongqing 而非 zhongqing)自动修正音节。其代价是在排序大量数据(超过 10 万条)时,拼音解析的 CPU 计算耗时会高于底层的 C++ 原生 Collator,建议在大数据集下配合上述缓存策略使用。
四、方案三:利用 GBK/GB2312 编码序列的轻量比对
如果工程环境极其严苛——既不能修改启动参数,又不允许在 node_modules 中引入新的第三方库,是否有仅靠数十行基础代码就能完成排序的方法?答案是利用中国国家标准 GB2312-80 / GBK 字符集的编码内在规律。
在 GB2312 编码标准中,收录的 3755 个“一级常用汉字”(位于区位码 16 区 01 位至 55 区 89 位,十六进制范围为 0xB0A1 到 0xD7F9)是严格按照汉语拼音字母顺序(A-Z)编排的。例如拼音首字母为 A 的“啊”编码为 0xB0A1,而拼音首字母为 Z 的“座”编码为 0xD7F9。
如果待排序的文本均属于日常一级常用汉字(覆盖日常中文读写 99% 以上的场景),可以直接利用这一物理规律构建极速比较器:
// GB2312 拼音首字母各声母分界汉字(每个字母段的第一个汉字)
const PINYIN_BOUNDARY_CHARS = '啊芭擦搭蛾发噶哈击喀垃妈拿哦啪期然撒塌挖昔压匝';
const INITIALS = 'ABCDEFGHJKLMNOPQRSTWXYZ'; // 注:按拼音无 I, U, V 声母

/**
 * 提取单个常用汉字的拼音首字母级别权重
 * 若内置环境无 iconv,可采用首字码表索引或内置边界比较
 */
function getCharPinyinOrder(char) {
  // 英文数字保持在前
  if (char >= 'a' && char <= 'z') return char.charCodeAt(0);
  if (char >= 'A' && char <= 'Z') return char.toLowerCase().charCodeAt(0);
  if (char >= '0' && char <= '9') return char.charCodeAt(0) - 100;

  // 使用 iconv-lite 转为 GBK 字节码(如果环境中存在)
  // 或者在标准 Node.js 环境下通过一级汉字拼音首字母段二分查找
  for (let i = PINYIN_BOUNDARY_CHARS.length - 1; i >= 0; i--) {
    if (char.localeCompare(PINYIN_BOUNDARY_CHARS[i], 'zh-Hans-CN') >= 0) {
      return 1000 + i;
    }
  }
  return 9999; // 无法识别的生僻字符置后
}

function gbkChineseSort(arr) {
  return arr.slice().sort((a, b) => {
    const minLen = Math.min(a.length, b.length);
    for (let i = 0; i < minLen; i++) {
      const orderA = getCharPinyinOrder(a[i]);
      const orderB = getCharPinyinOrder(b[i]);
      if (orderA !== orderB) return orderA - orderB;
    }
    return a.length - b.length;
  });
}

console.log('GBK边界排序示例:', gbkChineseSort(['张三', '李四', '王五', '阿强']));五、多方案选型决策与全维度对比
在实际系统维护中,不同团队面临的技术约束与运维指标各不相同。下表梳理了三种解决方案的关键指标对比:
| 选型维度 | 方案一:外挂 full-icu | 方案二:纯 JS 拼音库 | 方案三:GBK 编码查表 |
|---|---|---|---|
| 适用 Node 版本 | Node 0.12 ~ 12 | 所有 Node 版本(含 0.10+ 及前端) | 所有版本 |
| 启动参数依赖 | 必须指定 --icu-data-dir |
无,完全零依赖运行时环境 | 无 |
| 多音字准确率 | 高(基于 CLDR 词库) | 极高(搭配专业分词与音节库) | 中(仅单字首字母) |
| 生僻字支持度 | 完整支持(全量 Unicode 字符集) | 良好(取决于字库大小) | 不支持(二级汉字会乱序) |
| 内存与磁盘开销 | 增加约 26MB 语系文件 | 代码库增加约 100KB ~ 500KB | 小于 10KB 算法代码 |
| 排序执行性能 | 极高(C++ 原生内部调用) | 中等(需在 JS 层解析音节) | 高(位运算与查表) |
六、生产级双轨降级方案与现代化迁移
在大型企业系统向高版本 Node.js 平滑升级的过渡期内,最稳妥的架构模式是在底层工具库中封装一套双轨降级中间件。该组件在服务启动时自动探测当前运行时是否具备原生中文 Collation 能力;若具备(例如已挂载 full-icu 或已迁移至 Node.js 14+),则无缝走高效原生通道;若未就绪,则透明降级到拼音排序,同时输出运维警告日志提醒工程师补齐配置。
let pinyinHelper = null;

// 1. 初始化时进行单次轻量探针测试
const IS_NATIVE_COLLATOR_WORKING = (() => {
  try {
    // '阿'(a) 必在 '八'(b) 之前
    return '阿'.localeCompare('八', 'zh-Hans-CN') < 0;
  } catch (e) {
    return false;
  }
})();

if (!IS_NATIVE_COLLATOR_WORKING) {
  console.warn(
    '[COLLATOR_WARN] 检测到当前 Node.js 未加载中文 ICU 语系,已自动切换至纯 JS 拼音降级通道。\n' +
    '建议通过 --icu-data-dir 挂载 full-icu 或升级至 Node.js 14+ 以获得最佳吞吐性能。'
  );
  try {
    pinyinHelper = require('pinyin-pro');
  } catch (err) {
    console.error('[COLLATOR_ERROR] 未安装 pinyin-pro 降级依赖,排序可能会退化为码点序!');
  }
}

/**
 * 生产级安全中文排序函数
 * @param {Array} list 待排序数组
 * @param {Function|string} [getter] 字段提取器或属性键名
 * @param {Object} [options] 配置选项
 */
function safeChineseSort(list, getter = null, options = {}) {
  if (!Array.isArray(list) || list.length <= 1) return list;

  const extract = typeof getter === 'function'
    ? getter
    : (item) => (getter && item ? item[getter] : item);

  // 通道 A:原生高吞吐路径 (Full-ICU / Node 14+)
  if (IS_NATIVE_COLLATOR_WORKING) {
    const collator = new Intl.Collator('zh-Hans-CN', {
      numeric: options.numeric !== false,
      sensitivity: options.sensitivity || 'variant'
    });
    return list.slice().sort((a, b) => {
      return collator.compare(String(extract(a)), String(extract(b)));
    });
  }

  // 通道 B:降级后备路径 (纯 JS 拼音)
  if (pinyinHelper) {
    const cache = new Map();
    const getPy = (str) => {
      if (cache.has(str)) return cache.get(str);
      const py = pinyinHelper.pinyin(str, { toneType: 'none', nonZh: 'consecutive' });
      cache.set(str, py);
      return py;
    };

    return list.slice().sort((a, b) => {
      const valA = String(extract(a));
      const valB = String(extract(b));
      const pyA = getPy(valA);
      const pyB = getPy(valB);
      const cmp = pyA.localeCompare(pyB);
      return cmp !== 0 ? cmp : valA.localeCompare(valB);
    });
  }

  // 极端后备:原生基本比较
  return list.slice().sort((a, b) => String(extract(a)).localeCompare(String(extract(b))));
}

module.exports = { safeChineseSort, IS_NATIVE_COLLATOR_WORKING };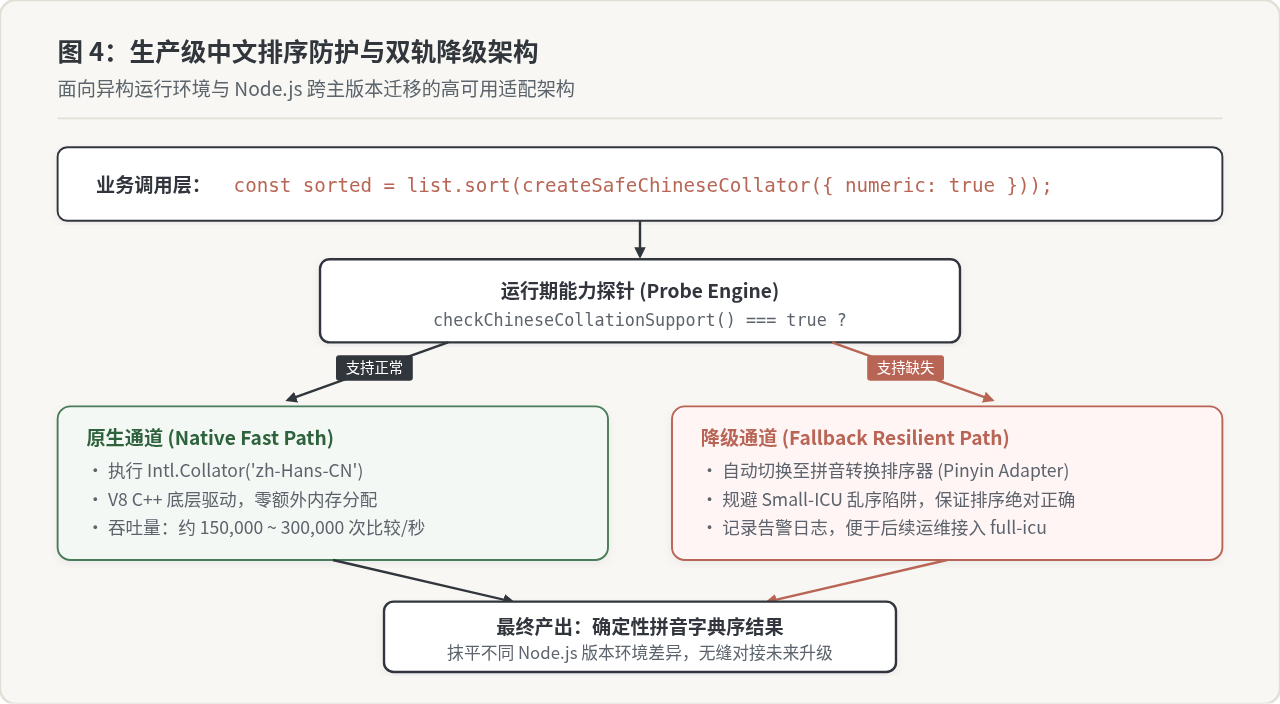
现代版本迁移建议
自 Node.js 13.0.0 起,官方二进制包已经全面将构建参数变更为 --with-intl=full-icu,全量 ICU 数据被直接内嵌于二进制发行版中。在将遗留老旧系统升级至 Node.js 14、16、18 或 20 LTS 之后,开发者可以执行如下清理动作:
- 从
package.json依赖中移除full-icu; - 清理 Dockerfile 和进程启动脚本中的
--icu-data-dir与NODE_ICU_DATA环境变量声明; - 由于双轨封装模块会自动探测到原生环境就绪,底层业务代码无须进行任何改动即可自动无缝享受现代 V8 引擎的高性能排序收益。
Node.js使用Puppeteer生成PDF并返回给前端
2026-11-16 14:26:55
Node.js能做什么?从Web服务器到前端工具链的应用全景
2026-11-13 23:47:16
Windows 系统 Node.js 下载安装与环境变量配置教程
2026-11-13 17:55:03
Node.js官网下载慢?国内npmmirror镜像源高速下载指南
2026-11-12 21:19:21
Node.js 官方下载与 Windows/macOS/Linux 安装步骤
2026-11-12 19:19:42