

Node.js中使用Buffer将字符串转为16进制
详细讲解在Node.js中利用Buffer对象将字符串转换为16进制编码的方法与底层机制,涵盖UTF-8字符编码原理、大小写与前缀格式化、逆向解码以及常见陷阱排查。
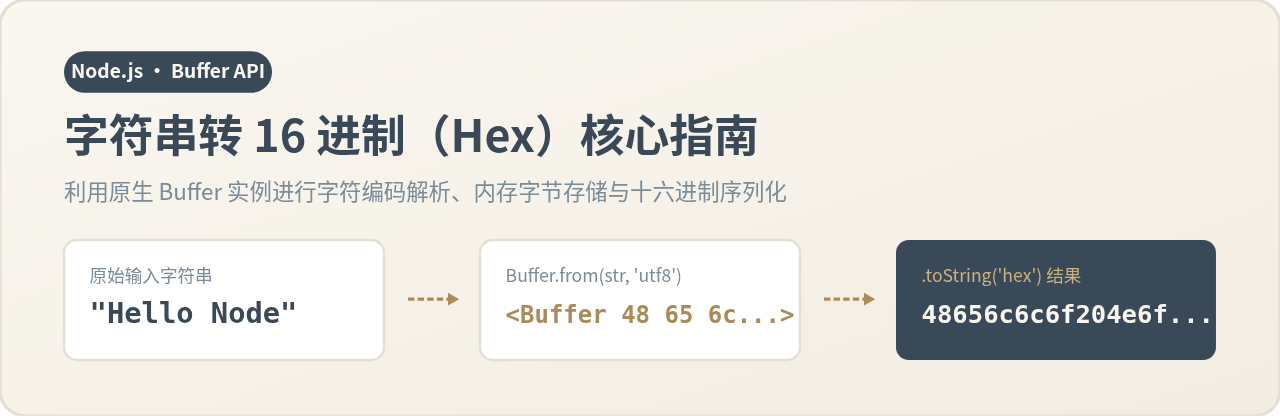
Buffer 对象:先通过 Buffer.from(str, 'utf8') 将源字符串按指定字符编码载入内存字节缓冲区,再链式调用 .toString('hex') 导出连续的十六进制字符序列。
一、核心方法与快速上手
Node.js 原生内置了全局 Buffer 类,无需通过 require 引入即可直接使用。Buffer 对象专门用于处理 TCP 流、文件系统读写及网络协议中常见的原始二进制数据。将字符串转换为十六进制编码的过程,实质上是“字符 → 二进制字节序列 → 十六进制文本展现”的标准化过程。
下面是一个最基础的执行示例,展示如何将英文句子转换为 Hex 字符串:
// 步骤 1:定义源字符串
const rawText = 'Hello Node.js';

// 步骤 2 & 3:通过 Buffer.from 写入字节,并转为 hex 字符串
const hexResult = Buffer.from(rawText, 'utf8').toString('hex');

console.log('16进制转换结果:', hexResult);在这段代码中,Buffer.from(rawText, 'utf8') 的第二个参数表示输入字符串的源字符集(若不填,Node.js 默认采用 UTF-8 编码)。生成的 Buffer 实例在内存中占据连续的 13 个字节;随后的 .toString('hex') 则遍历该缓冲区内的每一个字节,并将其转换为两位小写的十六进制 ASCII 字符,最终拼接为长度为 26 个字符的连续字符串。
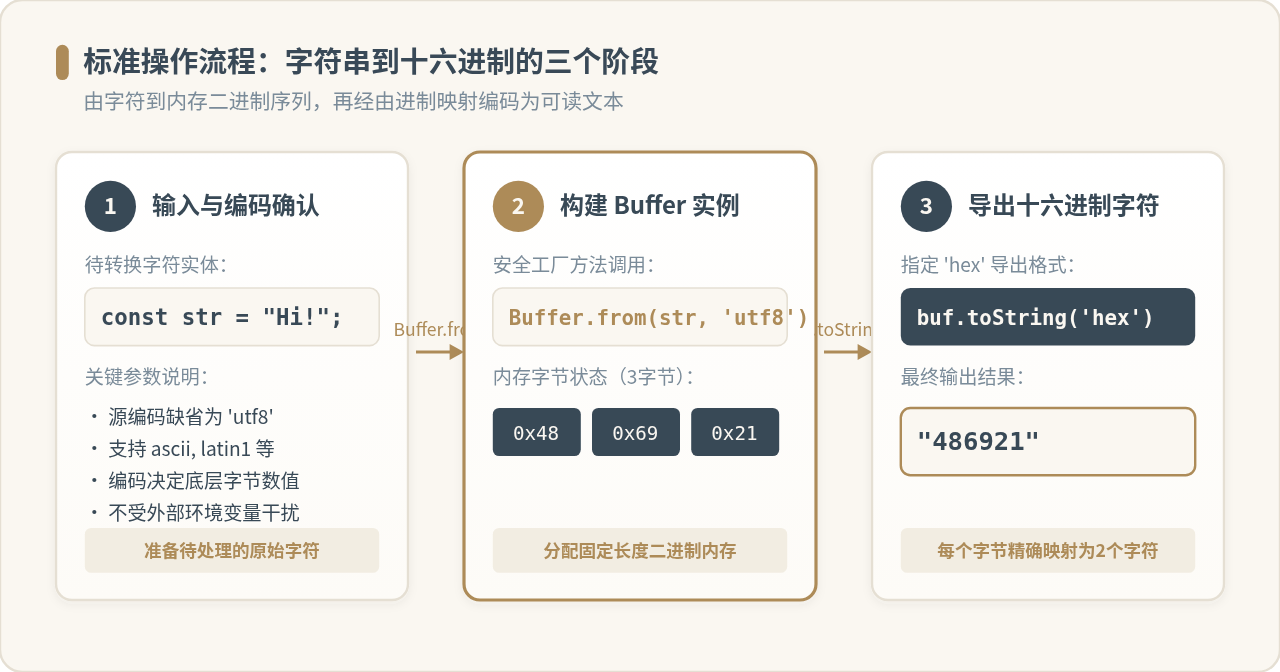
上述操作遵循确定性的三阶段流转:
- 确定源字符编码:明确源字符串在解析为二进制时所依据的字符集规范,避免由于隐式转码导致乱码。
- 分配与写入二进制内存:调用静态工厂方法
Buffer.from(),由 V8 引擎在堆外分配一块对应的字节内存空间。 - 格式化映射为 Hex:调用实例方法
.toString('hex'),将每个字节(Byte,范围 0~255)按高 4 位与低 4 位拆解为两枚十六进制符号并返回文本。
二、编码机制与底层原理:字符、字节与 16 进制
要透彻理解转换过程,必须明确“字符编码”与“进制表示”的本质区别。计算机底层只存储二进制数值,字符串本身无法直接运算,必须先经过编码表映射为字节。
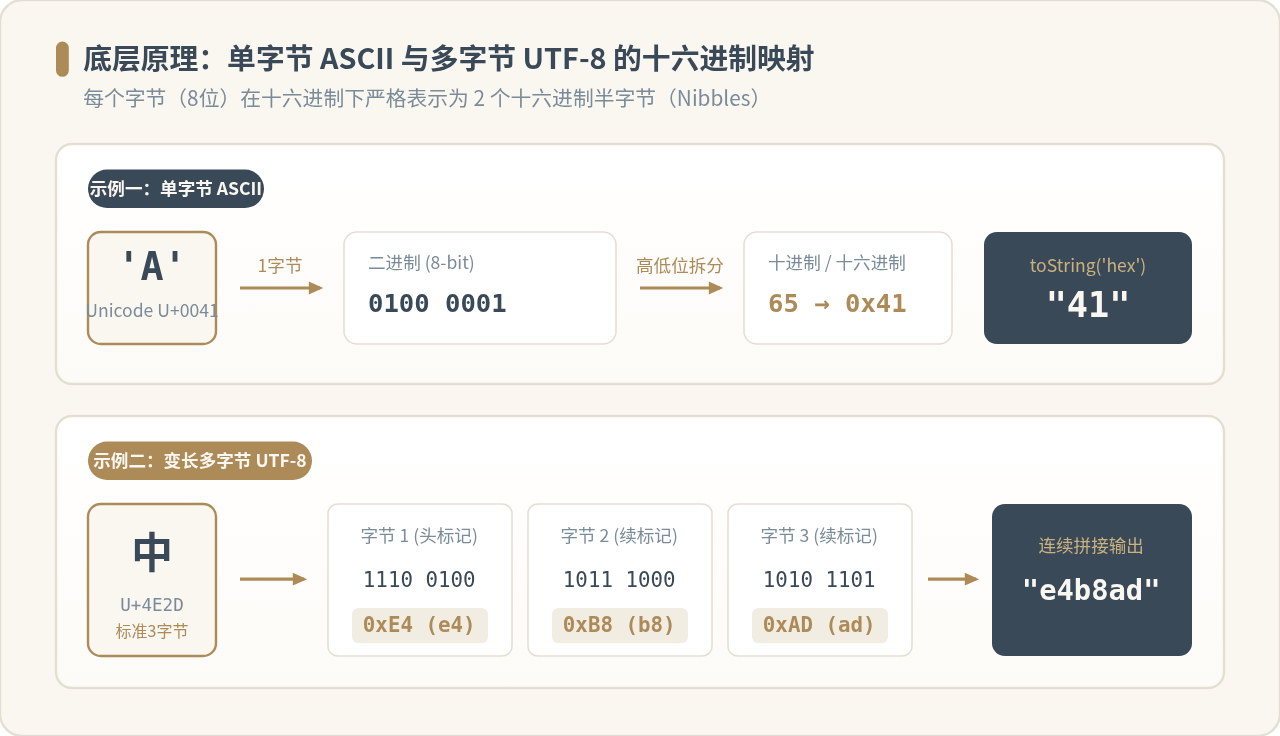
以 ASCII 字符为例,字符 'A' 在 Unicode 与 ASCII 编码中均为 65(二进制 01000001)。在十六进制下,高 4 位 0100 对应数值 4,低 4 位 0001 对应数值 1,因此该单字节在 16 进制下写作 41。
而对于中文字符或 Emoji,UTF-8 采用 1 至 4 个字节的变长编码方式。例如汉字 '中' 的 Unicode 码点是 U+4E2D,在 UTF-8 编码下被拆解为连续的 3 个字节:0xE4、0xB8 与 0xAD。转换代码如下:
const chineseText = '中文';
const chineseHex = Buffer.from(chineseText, 'utf8').toString('hex');

console.log('汉字 Buffer 字节长度:', Buffer.from(chineseText).length);
console.log('转换后 16 进制:', chineseHex);转换后 16 进制: e4b8ade69687
可以看到,字符串 '中文' 包含两个汉字,在 UTF-8 编码下每个字占 3 字节,共计 6 字节。经过 .toString('hex') 转换后,每个字节对应 2 个十六进制字符,最终输出了长度为 12 的字符串 e4b8ade69687(其中 e4b8ad 代表“中”,e69687 代表“文”)。
如果业务系统要求以其他编码(如 'latin1' 或 'utf16le')进行传输,则只需在 Buffer.from 中显式指定对应的编码名称。下表列出了不同字符编码对于转换字节数及 16 进制结果的直接影响:
| 源字符 | 指定编码 | 内存字节数 | 16 进制输出值 (Hex) | 说明 |
|---|---|---|---|---|
| 'A' | utf8 / ascii | 1 字节 | 41 |
标准 ASCII 单字节映射 |
| '中' | utf8 | 3 字节 | e4b8ad |
标准 UTF-8 变长编码 |
| '中' | utf16le | 2 字节 | 2d4e |
UCS-2/UTF-16 小端序(低字节在前) |
三、常见格式化扩展与逆向解码
Node.js 的 buf.toString('hex') 默认输出的是连续无分隔符的小写字母。然而在实际工程应用中,诸如网络报文调试、密钥查看或嵌入式协议对接等场景,通常需要大写展示、添加 0x 前缀或增加空格分隔符。
1. 大写展示与单字节分隔
由于导出的结果是标准 JavaScript 字符串,我们可以直接结合原生字符串方法或正则匹配完成格式化扩展:
const raw = 'Node';
const hex = Buffer.from(raw).toString('hex'); // "4e6f6465"

// 需求 A:全大写输出
const upperHex = hex.toUpperCase(); // "4E6F6465"

// 需求 B:按单字节加空格分隔(如 "4e 6f 64 65")
const spacedHex = hex.match(/.{1,2}/g).join(' ');

// 需求 C:数组形式加 0x 前缀(如 "0x4e, 0x6f, 0x64, 0x65")
const arrayHex = hex.match(/.{1,2}/g).map(b => `0x${b}`).join(', ');

console.log('大写形式:', upperHex);
console.log('空格分隔:', spacedHex);
console.log('带前缀序列:', arrayHex);空格分隔: 4e 6f 64 65
带前缀序列: 0x4e, 0x6f, 0x64, 0x65
2. 逆向还原:从 16 进制字符串恢复为原始文本
在接收方解析数据时,经常需要将十六进制文本逆向解码为原始字符。逆向还原的核心依然使用 Buffer.from(),但此时需将第二个参数显式指定为 'hex',随后调用 .toString('utf8'):
// 待解码的十六进制字符串
const incomingHex = 'e4b8ade69687';

// 校验长度是否为偶数
if (incomingHex.length % 2 !== 0) {
  throw new Error('非法的 Hex 字符串:字符长度必须为偶数');
}

// 恢复为 Buffer,再转回 UTF-8 字符串
const restoredBuffer = Buffer.from(incomingHex, 'hex');
const originalString = restoredBuffer.toString('utf8');

console.log('解码还原后的字符串:', originalString); // "中文"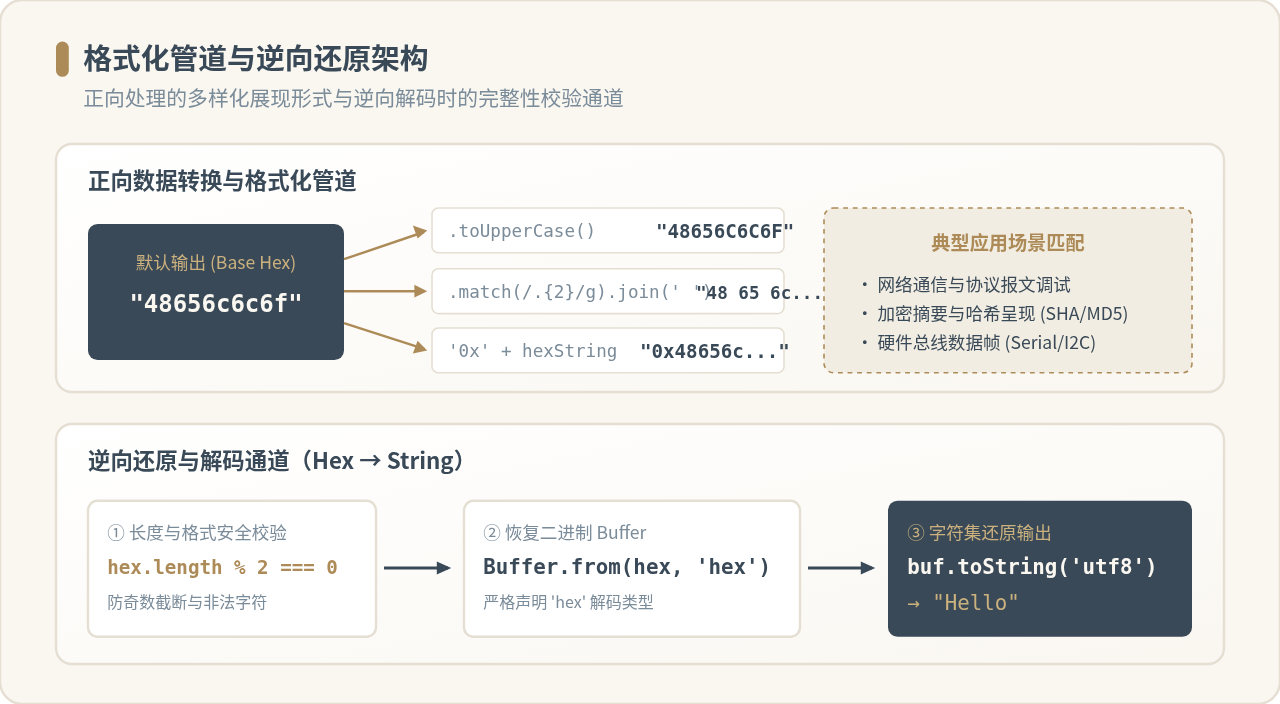
四、注意事项与避坑指南
虽然 Buffer API 的调用非常简洁,但在涉及底层字节与字符转换的生产代码中,仍有几个高频隐蔽错误需要特别注意:
每个字节必定由 2 个十六进制字符组成。如果向 Buffer.from(hexStr, 'hex') 传入了一个奇数位长度的字符串(例如 "486"),Node.js 不会抛出异常,而是会直接丢弃最后一个字符,只解析前两个字符 "48"!这容易导致严重的数据丢失隐患。因此,逆向解析前必须使用 hexStr.length % 2 === 0 进行防御性校验。
在较旧的教程或遗留代码中,常能见到 new Buffer(str) 这种写法。自 Node.js v6 起,该构造函数因存在潜在的堆内存未初始化泄漏风险已被全面废弃,并在后续版本中触发运行时警告。必须始终使用安全的静态工厂方法 Buffer.from() 或 Buffer.alloc()。
当试图把 16 进制字符串转回原始文本时,如果写成 Buffer.from(hexStr) 而漏写了第二个参数 'hex',Node.js 会把传入的十六进制字符当成普通 UTF-8 文本来创建 Buffer,从而导致错误的二次转码。逆向必须始终声明 Buffer.from(hexStr, 'hex')。
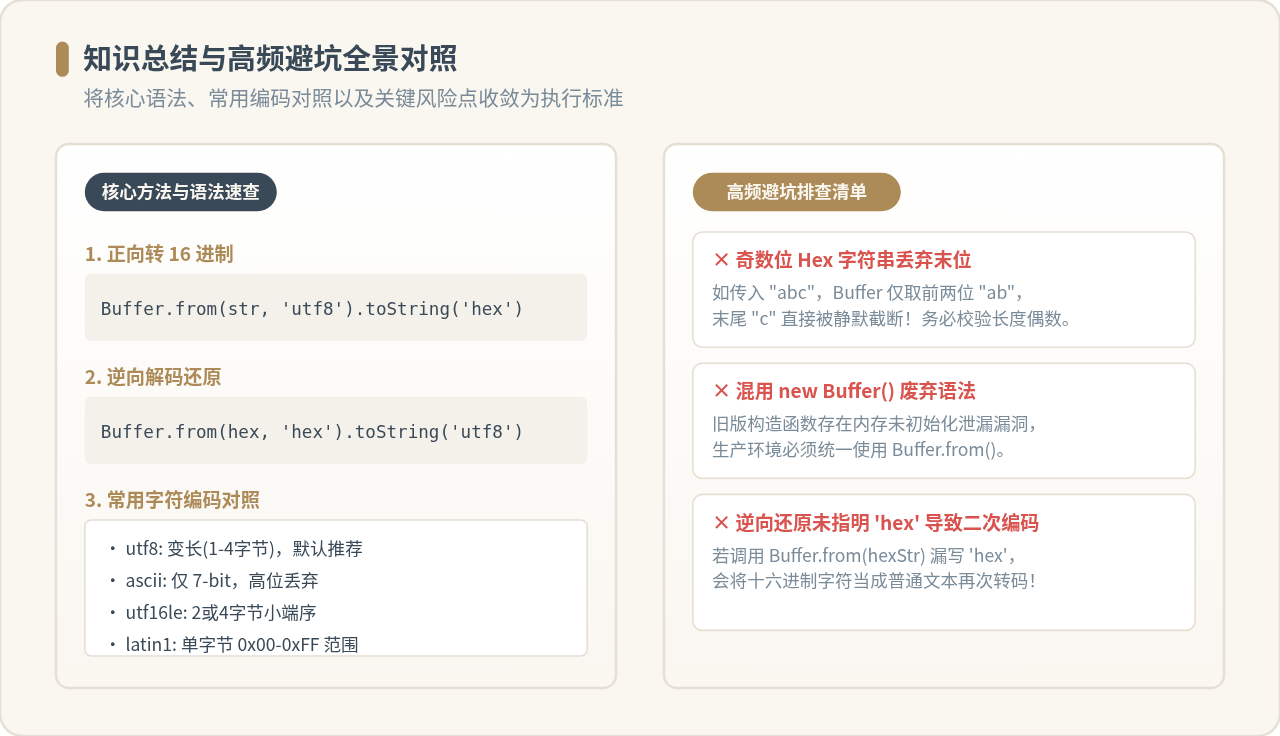
总结而言,在 Node.js 中处理字符串与 16 进制转换是一项基础且关键的操作。牢记 Buffer.from(str, 'utf8').toString('hex') 的正向法则与 Buffer.from(hex, 'hex').toString('utf8') 的逆向对偶法则,并在数据边界做好长度偶数校验,即可确保二进制数据流转的准确与安全。
Node.js官方下载地址在哪?怎么识别nodejs.org正版入口
2026-11-12 17:29:43
Windows系统安装Node.js:msi安装包使用与环境变量配置
2026-11-12 12:40:22
macOS 安装 Node.js:Homebrew 与官方 pkg 包怎么选
2026-11-12 11:49:24
Node.js Windows系统下载安装与环境变量配置教程
2026-11-12 08:48:13
Node.js安装完成后怎么配置npm国内镜像源加速
2026-11-12 08:26:25







