怎么将JS字符串的每个字符转为数组元素?
全面解析在JavaScript中将字符串的每个字符拆分为数组元素的方法,对比扩展运算符[...str]、Array.from()、split('')以及Intl.Segmenter的底层机制、Unicode支持与工程实践。
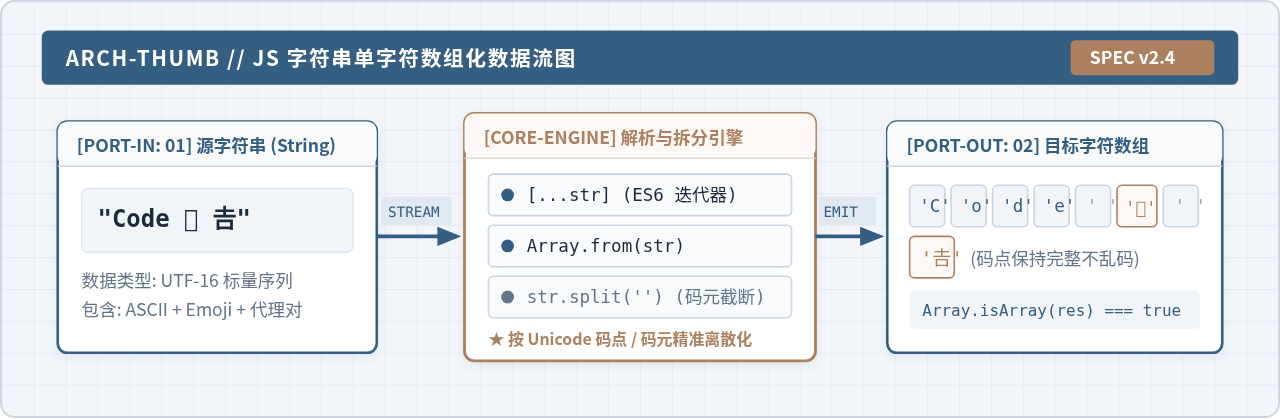
[...str]、调用 Array.from(str),以及传统方法 str.split('')。如果面对富文本、复杂组合 Emoji 或带音标的拉丁字符,还可以使用 ES2022 提供的 Intl.Segmenter。虽然常规英数与基础汉字在大部分方法下表现一致,但一旦涉及生僻字、Emoji 等超出基本多语言平面的字符,不同方法的底层切分机制就会产生本质差异。
一、核心解决方案与常规用法
日常业务开发中最常用的目标是将一个形如 "hello" 的字符串展开为 ['h', 'e', 'l', 'l', 'o']。以下是三种标准做法的代码实现与特性对比。
1. 扩展运算符(Spread Operator):现代首选
ES6 引入的展开语法 [...str] 是目前最简洁、直观的单字符拆解方式。它的底层依赖字符串的原生迭代器(Symbol.iterator),能自动识别合法的 Unicode 码点(Code Point)。
// 示例:使用扩展运算符拆分字符串
const str = "Hello";
const chars = [...str];

console.log(chars);
// 示例输出: ['H', 'e', 'l', 'l', 'o']
console.log(Array.isArray(chars));
// 示例输出: true
这种写法不产生额外的方法调用链,阅读清晰,且对于常规文本和单码点 Emoji 都能正确拆解。
2. Array.from():兼具转换与二次映射
Array.from() 同样遵循 ES6 迭代器协议,专门用于将类数组对象和可迭代对象转为真正的数组。与扩展运算符相比,它支持传入第二个参数 mapFn,能在拆分阶段同步对每个单字符进行映射处理,省去一次额外的 .map() 遍历。
// 示例:使用 Array.from() 拆分并同步转为大写
const text = "abc";
const upperChars = Array.from(text, char => char.toUpperCase());

console.log(upperChars);
// 示例输出: ['A', 'B', 'C']
3. str.split(''):传统方案及其局限
在 ES6 出现前,最广泛的做法是调用字符串对象的 split('') 方法,传入空字符串作为分隔符。
// 示例:使用 split('') 拆分常规字符串
const word = "JavaScript";
const list = word.split('');

console.log(list);
// 示例输出: ['J', 'a', 'v', 'a', 'S', 'c', 'r', 'i', 'p', 't']
split('') 能够在所有旧版本浏览器中运行,且在处理纯 ASCII 字符流时性能极高。但它的致命缺陷在于它是按 16 位的“UTF-16 码元”(Code Unit)直接截断的,后文将详细分析这一隐患。
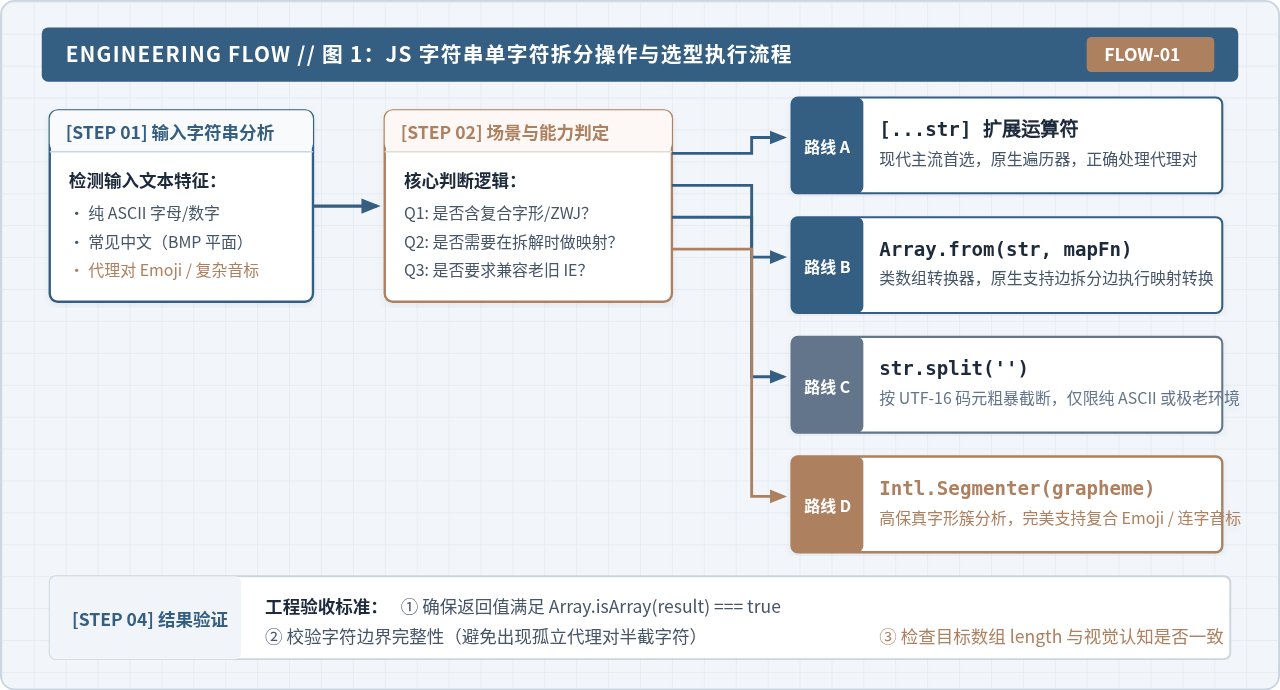
二、底层陷阱:为什么不能无脑使用 split('')?
许多初学者会误以为 str.split('') 与 [...str] 是完全等价的,但在多语言环境或包含 Emoji 的场景下,这种认知极易引发严重线上 Bug。
1. UTF-16 码元(Code Unit)与代理对(Surrogate Pairs)
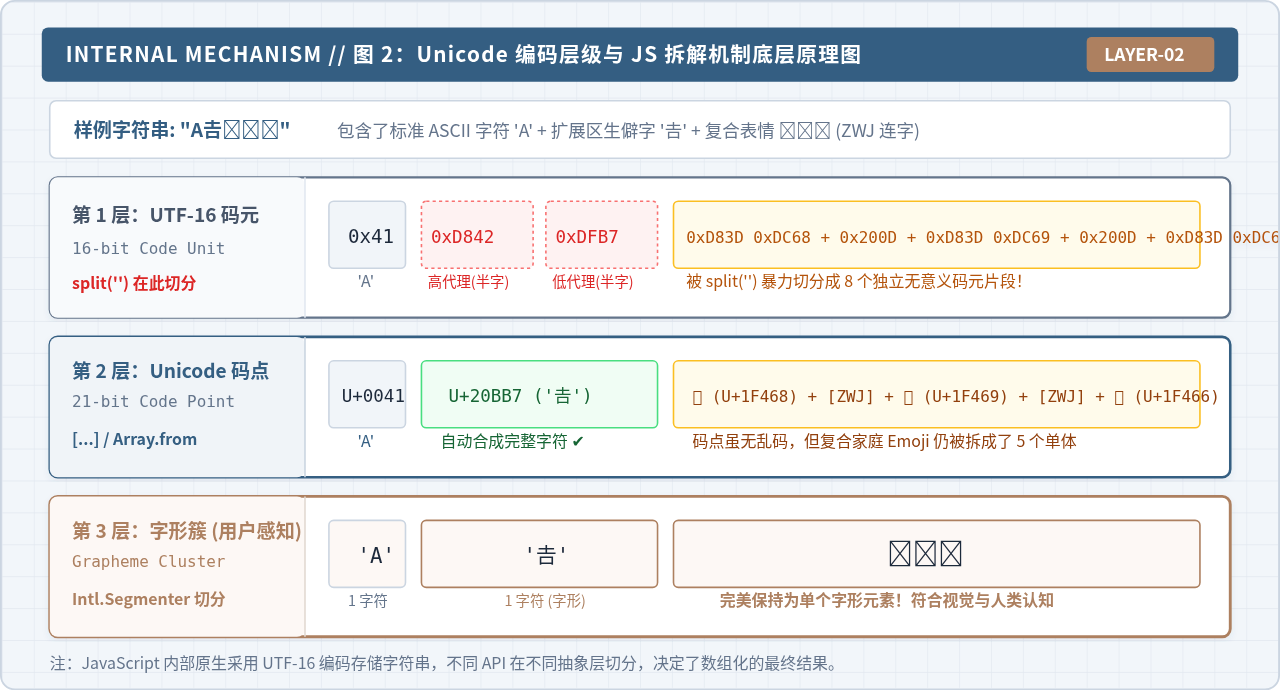
JavaScript 内部使用 UTF-16 编码表示字符串。每个 UTF-16 码元占据 16 位(2 字节),取值范围为 0x0000 到 0xFFFF。这足以容纳大多数常用西文字符和常用汉字(即 Unicode 的基本多语言平面 BMP)。
但对于超出该范围的字符——例如中日韩生僻字(如“𠮷” U+20BB7)或常见表情符号(如“🚀” U+1F680)——需要使用两个 16 位的码元组合表示,这被称为代理对(Surrogate Pair)。
// 示例:代理对字符在 split('') 与扩展运算符下的差异
const emojiStr = "Hi 🚀 𠮷";

// 使用 split('') 拆分
const splitResult = emojiStr.split('');
console.log(splitResult);
// 示例输出: ['H', 'i', ' ', '\uD83D', '\uDE80', ' ', '\uD842', '\uDFB7']
// 注意:单个 Emoji '🚀' 和汉字 '𠮷' 被生硬撕裂成了高代理与低代理两个乱码片段!

// 使用扩展运算符拆分
const spreadResult = [...emojiStr];
console.log(spreadResult);
// 示例输出: ['H', 'i', ' ', '🚀', ' ', '𠮷']
// 结果:Emoji 和生僻字保持完整,未出现乱码如果使用 split('') 将包含生僻字或 Emoji 的字符串存入数据库,拆出的半个代理字符(如 \uD83D)是无效的 Unicode 字符,不仅无法正常渲染,在经过 JSON 序列化、传输或数据库入库时,还会引发编码损坏甚至触发 URIError 异常。
三、进阶挑战:复杂复合字符与 Intl.Segmenter
即便使用了 [...str] 或 Array.from(str),我们依然会遇到更高的挑战:复合字形(Grapheme Clusters)。
1. 什么是用户感知字符(Grapheme Cluster)?
在人类视觉感知中,一个“字”可能由多个 Unicode 码点组合而成。最典型的例子包括:
- 复合家庭/职业 Emoji:如
👨👩👦,由父亲 (\u{1F468}) + 零宽连字 (\u200D) + 母亲 (\u{1F469}) + 零宽连字 + 儿子 (\u{1F466}) 组合而成。 - 带肤色修饰符的表情:如
👍🏽,由大拇指 (\u{1F44D}) 与中等深肤色码点 (\u{1F3FD}) 拼合。 - 重音字母:如
é,可以由字母e加上音标结合字符\u0301构成。
// 示例:扩展运算符面对复合 Emoji 时的局限
const family = "👨👩👦";
console.log([...family]);
// 示例输出: ['👨', '', '👩', '', '👦']
// 解释:虽然码点没有损坏,但视觉上的单一复合表情被拆散成了 5 个独立元素!2. 使用 Intl.Segmenter 精准按字形拆分
ECMAScript 2022 规范正式提供了国际化分段器 Intl.Segmenter。通过指定 granularity: 'grapheme'(字形粒度),可以在遵守 Unicode UAX #29 规范的前提下,将文本拆解为符合人类感官认知的完整字符。
// 示例:使用 Intl.Segmenter 实现高精度字形拆分
function splitToGraphemes(input) {
if (typeof input !== 'string') return [];
const segmenter = new Intl.Segmenter('zh-CN', { granularity: 'grapheme' });
return Array.from(segmenter.segment(input), seg => seg.segment);
}
const complexStr = "A𠮷👍🏽👨👩👦";
const graphemes = splitToGraphemes(complexStr);
console.log(graphemes);
// 示例输出: ['A', '𠮷', '👍🏽', '👨👩👦']
console.log(graphemes.length);
// 示例输出: 4 (完全契合用户直觉)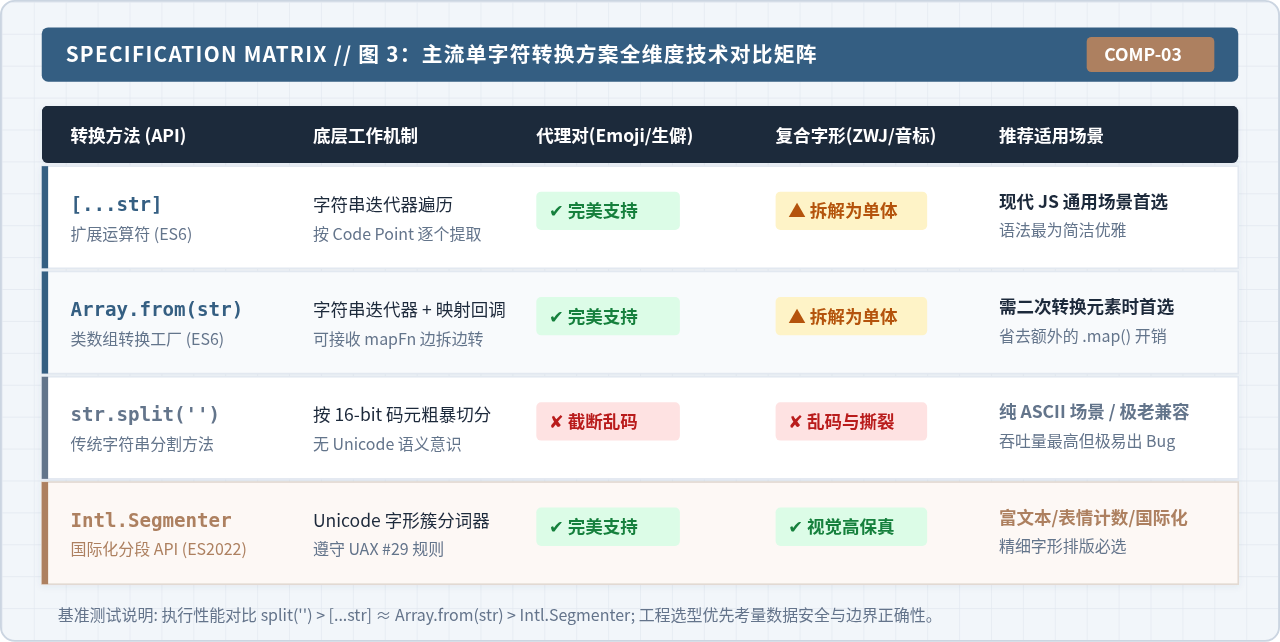
四、各方案技术特性与对比矩阵
为了在实际工程中做出权衡,下表汇总了四种主要方式的性能、兼容性与支持边界:
| 解决方案 | 规范版本 | 拆分层级 | 代理对 (𠮷/🚀) | 复合表情 (👨👩👦) | 适用场景建议 |
|---|---|---|---|---|---|
[...str] |
ES6 (2015) | Unicode 码点 | 完整支持 | 拆解为单体码点 | 现代项目默认首选,语法简洁直观 |
Array.from(str) |
ES6 (2015) | Unicode 码点 | 完整支持 | 拆解为单体码点 | 需要在拆解时同步执行映射变换的场景 |
str.split('') |
ES3 (1999) | UTF-16 码元 | 发生撕裂乱码 | 严重撕裂乱码 | 严格限制在纯 ASCII 编码或特定极速解析 |
Intl.Segmenter |
ES2022 | 字形簇 (Grapheme) | 完整支持 | 高保真保持整体 | 富文本编辑、字数统计限制、多语言排版 |
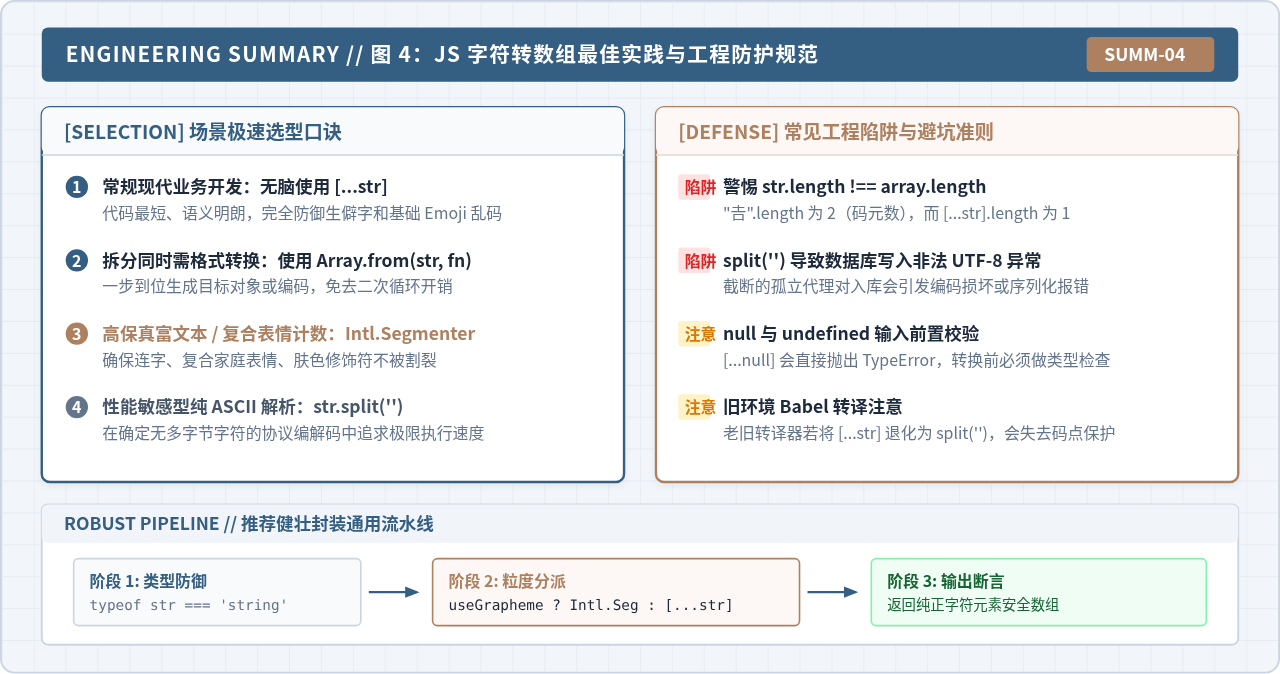
五、工程最佳实践与封装建议
在日常企业级项目中,为了兼顾性能、边界安全与运行环境的健壮性,建议采用防御性封装策略:
- 默认业务逻辑首选
[...str]:除非明确需要支持复合 Emoji 统计或运行于 IE 等淘汰环境,扩展运算符是综合代码可读性与鲁棒性的最佳平衡点。 - 防御非空与非字符串输入:直接执行
[...null]或[...undefined]会直接抛出运行时TypeError。在公共工具函数中务必增加前置校验或默认值兜底。 - 文本长度统计陷阱:在实现前端“限制输入不超过 10 个字”的业务时,万不可直接判断
str.length <= 10,因为一个👨👩👦的.length属性值为 8。应使用[...str].length或splitToGraphemes(str).length进行判定。
// 示例:企业级健壮单字符安全拆分函数
function safeSplitChars(str, options = { grapheme: false }) {
  if (typeof str !== 'string' || str.length === 0) {
    return [];
  }

  // 如果需要字形簇级别的严格匹配且环境支持 Intl.Segmenter
  if (options.grapheme && typeof Intl !== 'undefined' && Intl.Segmenter) {
    const segmenter = new Intl.Segmenter(undefined, { granularity: 'grapheme' });
    return Array.from(segmenter.segment(str), s => s.segment);
  }

  // 默认采用 ES6 迭代器展开,兼容绝大多数码点
  return [...str];
}

// 验证用例
console.log(safeSplitChars("Vue3 生态"));
// 示例输出: ['V', 'u', 'e', '3', ' ', '生', '态']

console.log(safeSplitChars("极速 🚀 体验"));
// 示例输出: ['极', '速', ' ', '🚀', ' ', '体', '验']

console.log(safeSplitChars(null));
// 示例输出: [] (安全兜底,不报错)JavaScript比较参数在TypeScript里类型怎么标
2026-11-08 08:13:37
为什么JS Set无法直接对对象数组去重
2026-11-06 20:47:44
为什么typeof null是object?JS数据类型判断的历史遗留问题解析
2026-11-06 17:57:44
JS ES6+新增数组方法解析:from、flat与flatMap
2026-11-06 15:07:06
JavaScript动态类型(弱类型)的特点及开发注意事项
2026-11-06 12:46:15