javascript下载安装手机版遇到编码问题怎么定位
针对在手机端下载、安装和运行JavaScript环境或脚本时出现的中文乱码与字符编码异常,本文详细梳理从传输下载、文件解压、编辑器打开到运行时终端输出的四层定位链路与排查方法。
一、澄清“JavaScript 手机版”场景与编码本质
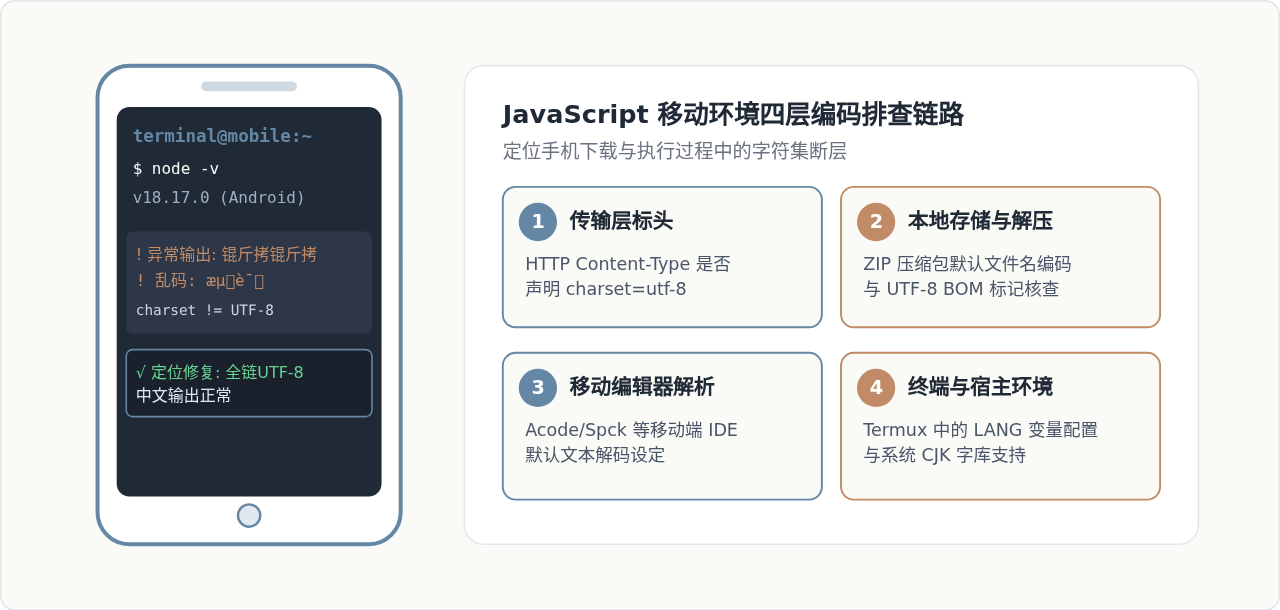
在探讨编码定位之前,需要明确一个技术事实:JavaScript 作为一种脚本语言,并没有名为“JavaScript 手机版”的单一安装包。用户在手机搜索并下载的,通常属于以下三类载体之一:
- 终端与原生运行环境:例如在 Android 平台安装终端模拟器(Termux),随后通过包管理器安装
nodejs运行时来执行.js脚本; - 移动端代码开发软件:例如从应用商店下载的 Acode、Spck Code Editor、Dcoder 或 QuickEdit 等兼具代码编辑与本地预览功能的手机 App;
- 离线前端项目与脚本包:通过移动端浏览器直接下载打包好的 ZIP 源码包、独立
.js文件,或运行于 WebView 容器中的混合应用(Hybrid App)。
无论是哪一种载体,计算机存储和传输文本的物理形式都是二进制字节(Bytes)。当一段 JavaScript 代码从远程网络进入手机,再被呈现到屏幕或控制台上时,必须经过“字节序列 → 字符集规则映射 → 字符字形呈现”这一过程。一旦某个环节假定了解码规则(如默认使用 Latin-1 或 GBK),而输入源实际采用的是 UTF-8,就会在对应界面中爆发编码乱码。
二、定位基础:数据流转中的四大编码节点
定位编码问题不能盲目修改代码或重装软件。在手机端,JavaScript 代码自外部流入至最终执行呈现,依次经过四个核心节点。任何一个节点出现字符集假设偏差,都会产生下游乱码:
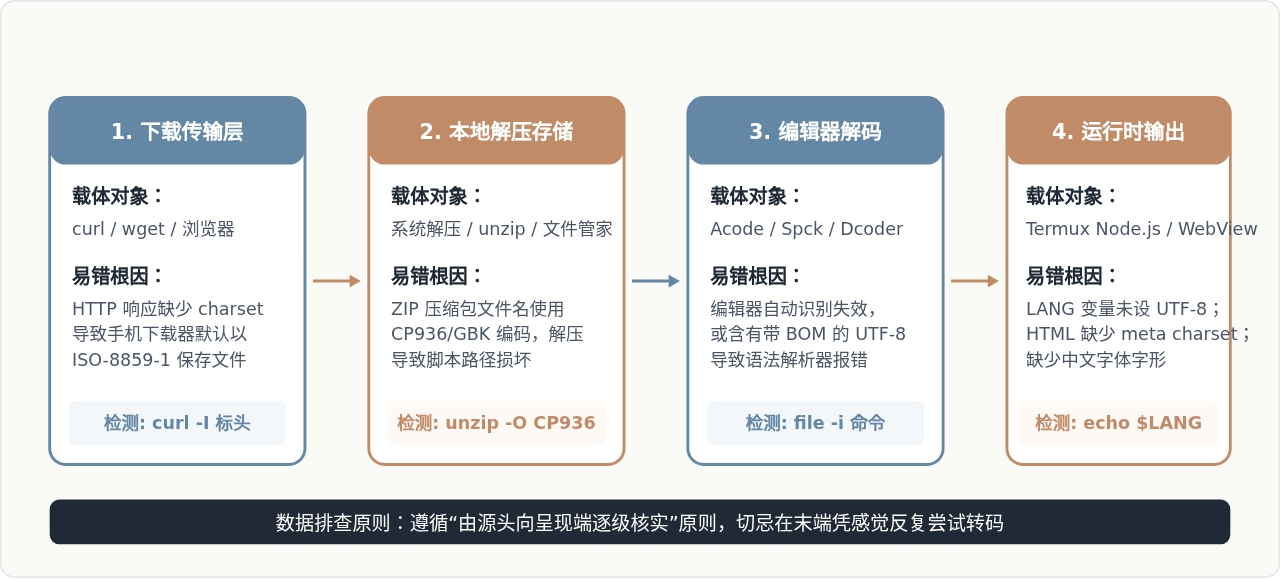
明确了这四大节点之后,定位思路就非常聚焦:先识别表面现象属于哪类编码冲突,再运用诊断命令或配置工具逐个校验节点,找出出现“不匹配”的具体环节。
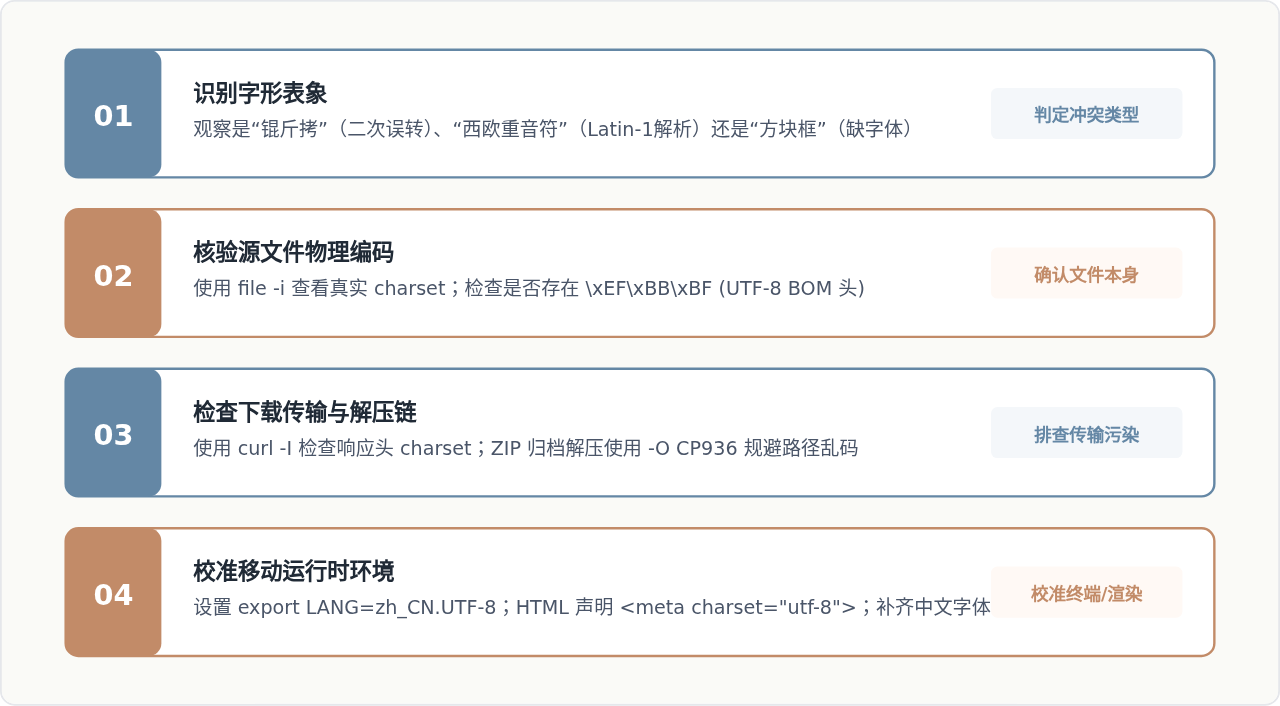
三、核心操作:四步定位法精准排查故障点
第一步:根据乱码特征判定冲突类型
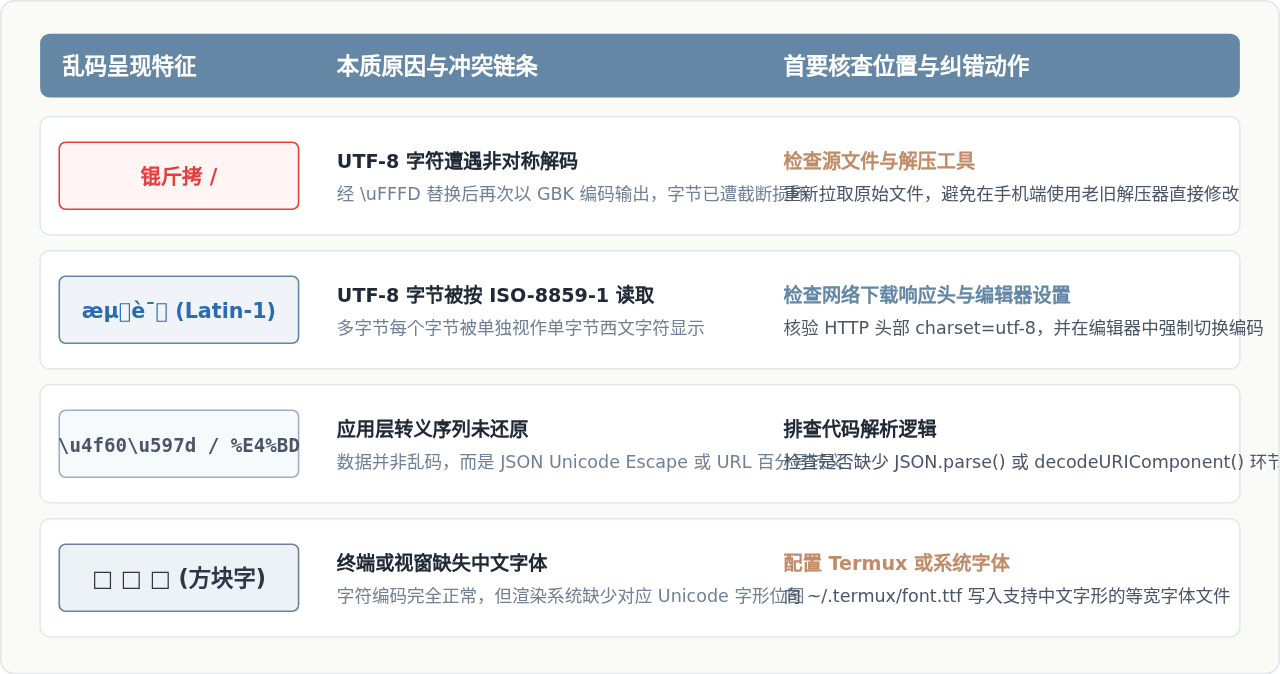
不同的字符集互转错误,会留下极具特征的字形特征。观察屏幕上的错误输出,能够直接缩小排查范围:
- 表现为“锟斤拷”或“”:这通常是 UTF-8 编码中的多字节中文(每个汉字占 3 字节)被按单字节或双字节错误解码后,遇到无法映射的字节时替换为了 Unicode 替换字符
\uFFFD;当包含该字符的数据再次被用 GBK 编码输出时,便组合成了“锟斤拷”。这说明数据在中途经历过至少一次破坏性的非 UTF-8 读写。 - 表现为“æµè¯”、“å¼€å”等西欧重音字母:这是最典型的“UTF-8 字符被直接按 ISO-8859-1(Latin-1)或 Windows-1252 解析”的现象。常见于通过网络请求下载
.js文件时,服务端未在响应头中返回字符集说明,手机端客户端默认以单字节字符集处理。 - 表现为连续的“\u4f60\u597d”或“%E4%BD%A0%E5%A5%BD”:这不属于严格意义上的底层字符集断裂,而是应用层编码(Unicode 转义或 URL 编码)未被执行
decodeURIComponent()或反序列化操作。 - 表现为“□□□”或空心方块:文件字符编码本身很可能是正确的,但手机端终端环境(如 Termux)未安装中文字体,导致终端无法找到汉字字形来绘制输出。
第二步:检测本地 JavaScript 文件的实际物理编码
不要仅凭肉眼在编辑器中看代码。如果手机中安装了 Termux,可以通过 Linux 标准诊断工具直接读取文件字节元数据。切换到脚本所在目录并执行以下命令:
# 查看文件的 MIME 类型及字符集声明
file -i app.js

# 查看文件开头的十六进制字节序列(用于排查是否存在 BOM 头)
head -c 16 app.js | xxdapp.js: text/plain; charset=utf-8ef bb bf(某些 JS 引擎会将 BOM 当作非法字符报 SyntaxError)app.js: text/plain; charset=iso-8859-1,则说明物理文件并非 UTF-8 编码
如果未安装 Termux,可以直接在手机编辑器(如 Acode)中打开该文件,观察状态栏右下角的编码标识。若显示为 GBK、Windows-1252 或 US-ASCII,应手动在编辑器菜单中选择“重新以 UTF-8 打开”,或“另存为 UTF-8 无 BOM 格式”。
第三步:排查下载源与解压缩过程中的损耗
若源文件在电脑上确认正常,下载到手机后却发生编码改变,问题必然出在下载工具或解压工具上:
-
检查 HTTP 响应头:在手机浏览器或 Termux 中使用
curl -I <下载链接>,观察服务器返回的Content-Type标头。如果仅为Content-Type: application/javascript而没有显式指定charset=utf-8,部分移动端内置下载引擎会沿用系统默认字符集进行文本保存,从而造成损坏。 -
检查 ZIP 解压过程:Windows 早期打包的 ZIP 文件名可能采用 GBK/CP936 编码。如果手机上的解压软件不支持跨平台编码探测,解压出来的目录名或
.js文件名就会变成乱码。在 Termux 中解压此类归档时,建议指定编码参数:# 使用指定编码解压 ZIP 源码包 unzip -O CP936 project-source.zip
第四步:检测手机端运行时与终端环境配置
若文件物理编码经核验确系 utf-8,但在 Termux 中执行 node app.js 时,控制台打印的中文仍然乱码,此时应重点排查 Termux 的语言环境变量。
# 检查当前终端环境变量
echo $LANG
echo $LC_ALL
如果返回为空,或显示为 C、POSIX,说明终端被置于原始无语言支持模式,无法正确将多字节字符提交给控制台渲染。可在 Termux 中执行以下命令快速修复:
# 临时生效
export LANG=zh_CN.UTF-8
export LC_ALL=zh_CN.UTF-8

# 永久写入终端配置文件(针对 bash)
echo "export LANG=zh_CN.UTF-8" >> ~/.bashrc
echo "export LC_ALL=zh_CN.UTF-8" >> ~/.bashrc
source ~/.bashrcfs.readFileSync(filePath) 读取本地文件时,如果未传入第二个编码参数,返回的是二进制 Buffer。如果直接拼接到字符串中,容易受到隐式类型转换影响。必须显式声明字符集:fs.readFileSync('data.txt', 'utf8')。
四、移动端常见实战场景与排查示例
场景 1:手机浏览器运行本地 HTML/JS 时中文变成乱码
现象描述:下载了包含 index.html 和 main.js 的压缩包,在手机浏览器或 Acode 内置浏览器中直接打开,页面中的静态中文全部变成问号或乱码。
定位步骤与解决:
- 检查
index.html的<head>区域是否在最前部显式声明了字符编码:<!DOCTYPE html> <html lang="zh-CN"> <head> <!-- 必须紧跟在 head 标签后,且在 title 之前 --> <meta charset="UTF-8"> <title>应用标题</title> <script src="main.js" charset="utf-8"></script> </head> - 移动端 WebView 在直接以
file:///协议加载本地文件时,如果 HTML 没有在首部声明<meta charset="UTF-8">,系统 WebView 默认会回退至Windows-1252处理,造成外链 JS 内的中文变量与页面元素乱码。
场景 2:Node.js 在手机 Termux 读写文件时的编码错位
现象描述:在 Termux 中运行 Node.js 爬虫或数据处理脚本,抓取外部数据或写入本地文件后,发现生成的 JSON 或文本全是乱码。
排查诊断脚本:编写如下简单的自检测试文件 charset-test.js 进行最小化验证:
// charset-test.js: 最小化字符编码与环境自检脚本
const fs = require('fs');

const testStr = '中文测试:JavaScript 编码自检';
console.log('1. 控制台直出测试:', testStr);

// 检查 Node.js 内部 Buffer 处理
const buf = Buffer.from(testStr, 'utf8');
console.log('2. UTF-8 字节长度:', buf.length, '(应为 37 字节)');

// 测试写入与读回
const testFile = './.charset-probe.tmp';
fs.writeFileSync(testFile, testStr, 'utf8');
const readBack = fs.readFileSync(testFile, 'utf8');
console.log('3. 本地落盘读回测试:', readBack === testStr ? '√ 读写一致' : '! 读写存在偏差');

// 清理临时测试文件
if (fs.existsSync(testFile)) {
  fs.unlinkSync(testFile);
}$ node charset-test.js
如果第 1 项控制台直出显示乱码,但第 2、3 项正常,说明 Node.js 本身数据处理完全正确,问题纯粹是 Termux 终端字体或 LANG 设置所致;如果第 3 项读写不一致,说明底层文件系统读写环节被注入了错误编码参数。
五、总结:建立全链路统一的 UTF-8 防御闭环
在移动设备相对受限的软件环境下开发或运行 JavaScript,字符编码问题的本质不是技术深度问题,而是环境异构导致的契约不一致。只要建立起从源端到呈现端的端到端闭环认知,即可在遇到问题时快速排查解决:
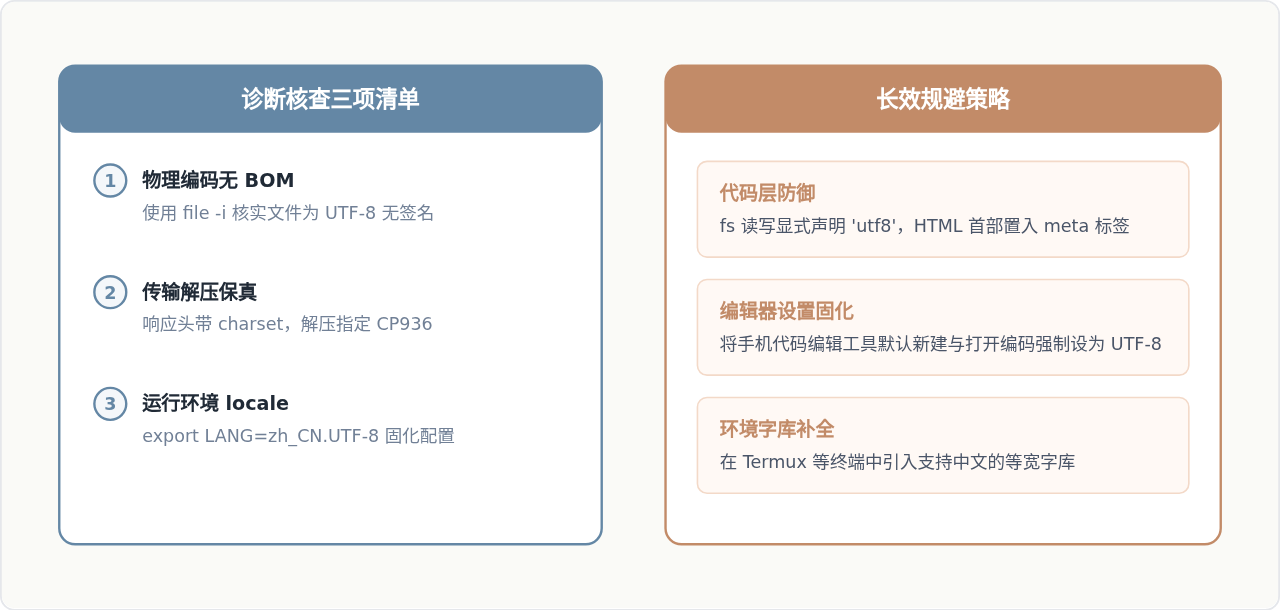
面对移动端出现的乱码,记住三个原则:先看形态辨特征、再用命令测文件、最后校验环境流。保持全链路一致采用“无 BOM 的 UTF-8 编码”,即可从源头上彻底消除编码断层。
JS隐式类型转换陷阱:怎么安全地将数字显式转为字符串
2026-11-06 19:23:53
JS控制台输出基础:console.log的正确用法与常见误区
2026-11-05 23:52:08
响应式JavaScript网站模板源码下载与结构解析
2026-11-05 23:21:47
Prettier和JS-Beautifier有什么区别?JS格式化工具选型建议
2026-11-05 21:53:08
JS 怎么使用 pako.js 解压 gzip 数据流
2026-11-05 15:54:33